異常検知
この機能は、該当するすべての AWS リージョンでのみ利用できます。Google Cloud および Microsoft Azure では利用できません。有効にするには、お問い合わせください。
異常検知は、ベクトル埋め込みがデータ全体の分布から大きく逸脱しているレコードを特定します。このジョブを使用して、データ品質の問題、まれなケース、処理エラー、または追加の確認が必要なサンプルを表す可能性のある、異常なレコードを見つけます。
概要
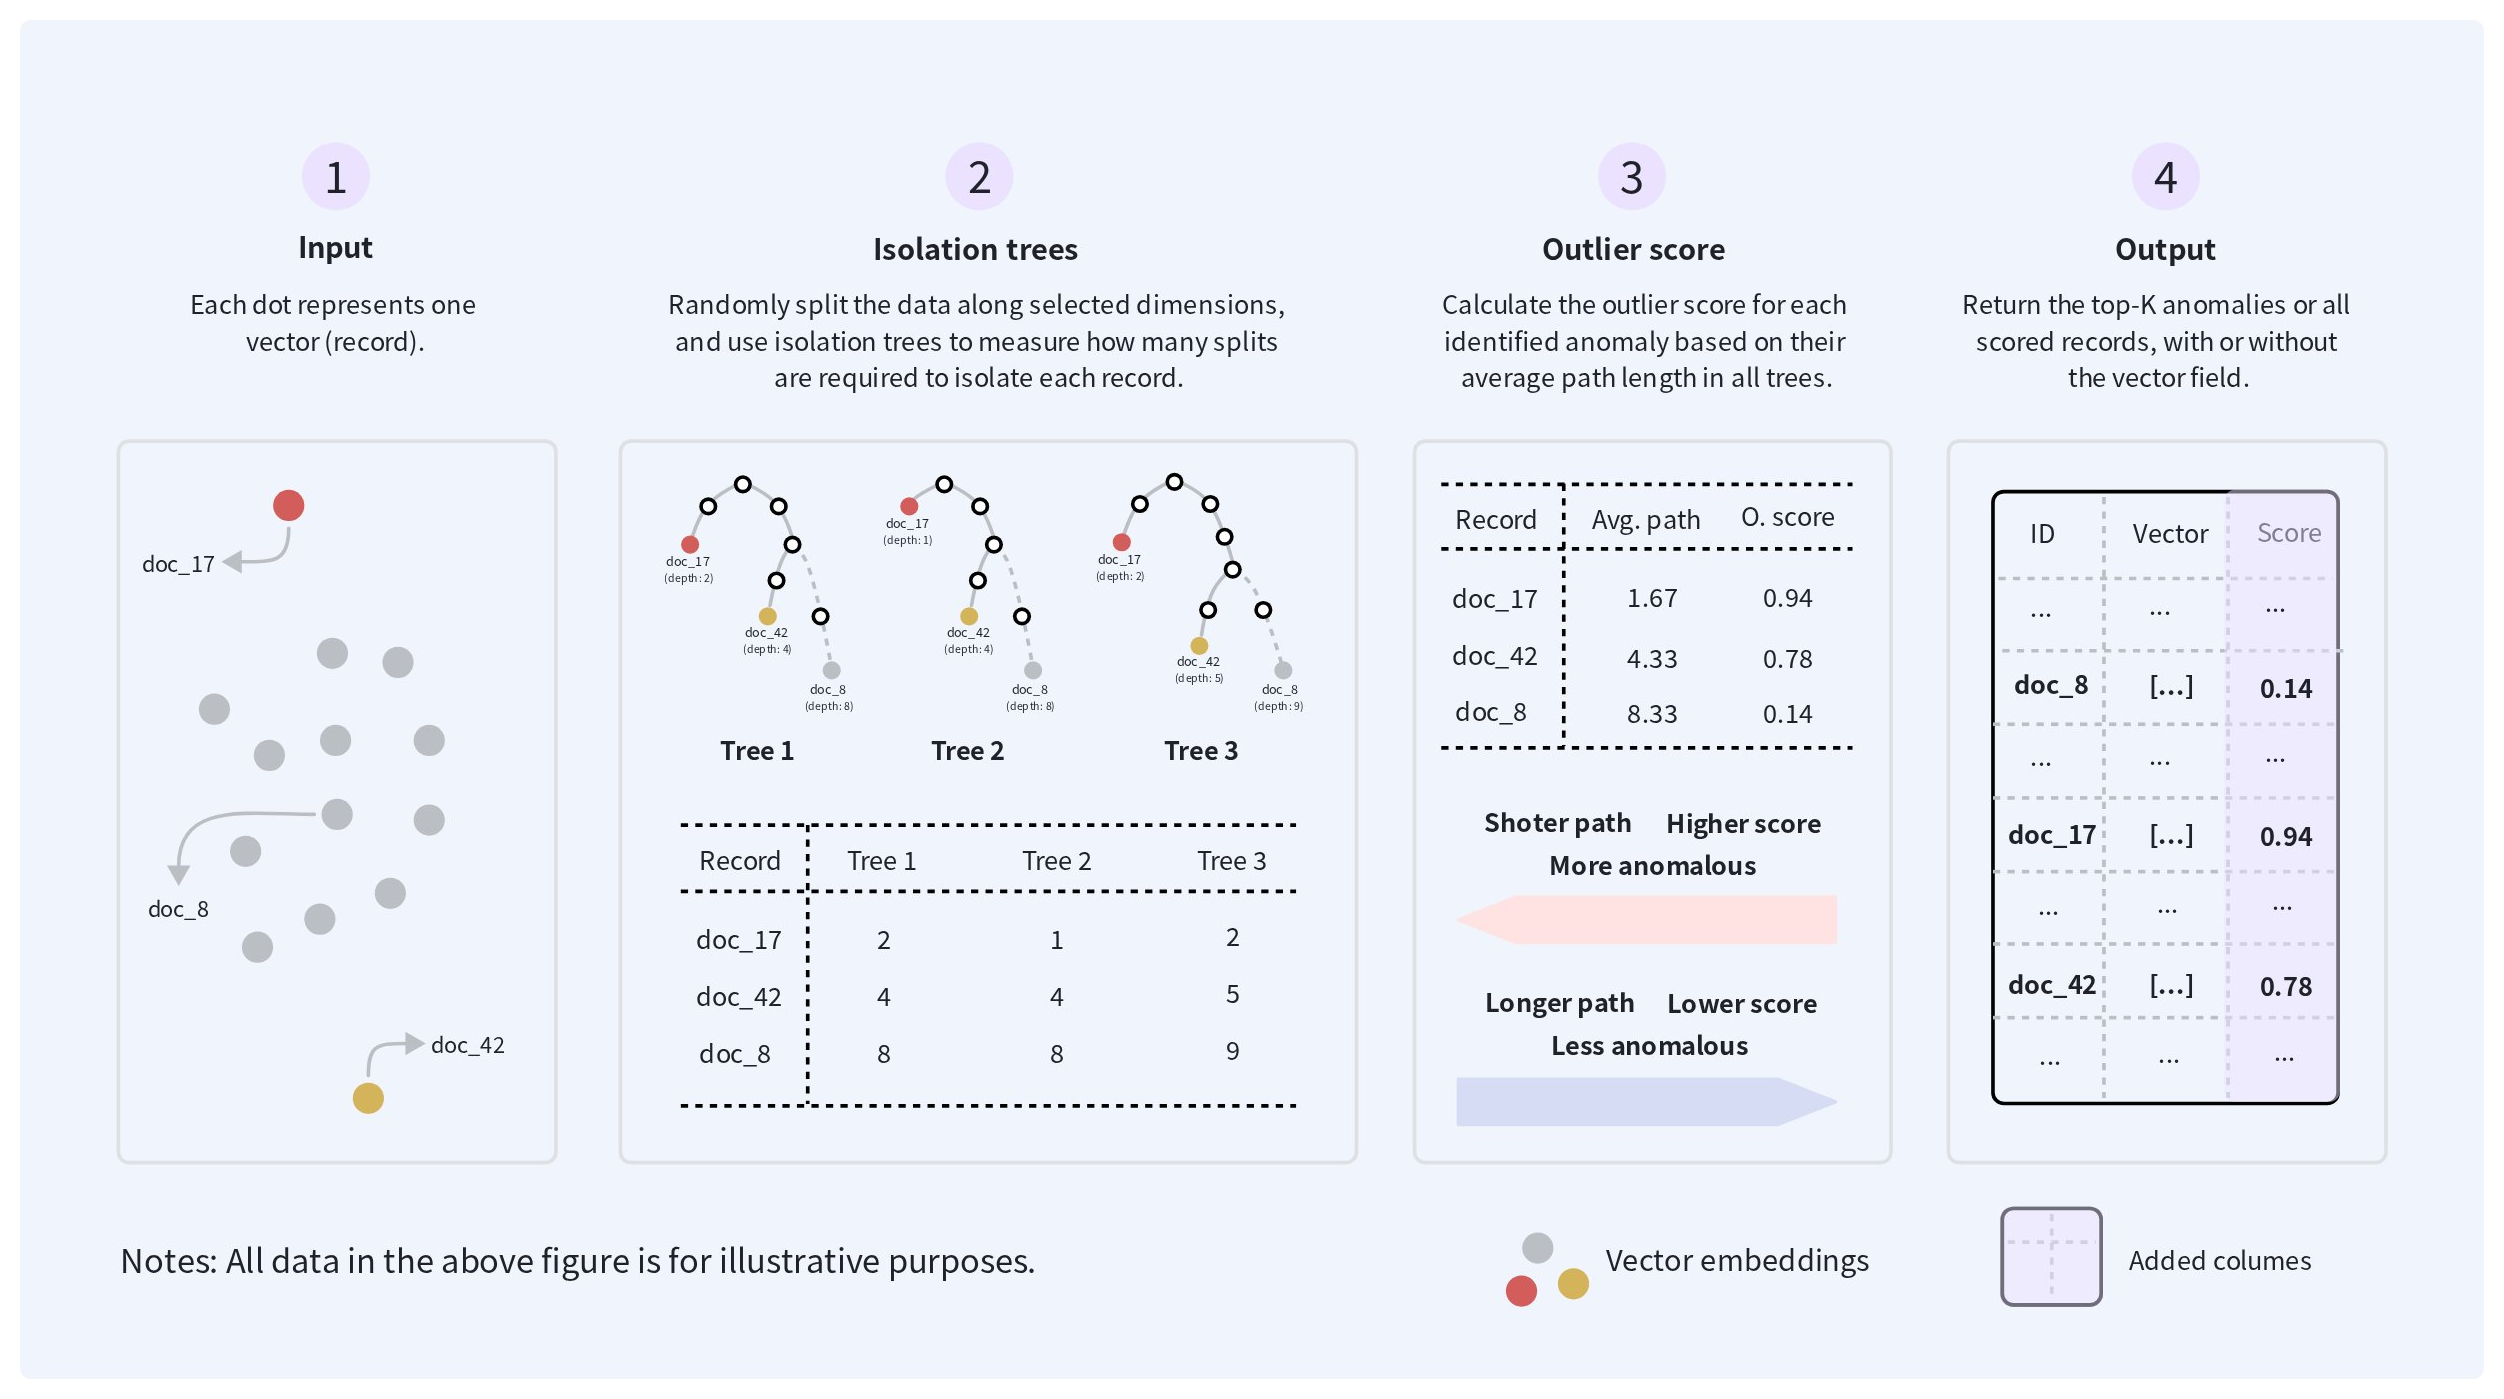
次の図は、異常検知ジョブが Isolation Forest を使用してベクトルレコードをスコアリングし、スコアが最も高いレコードまたはスコアリング済みのデータセット全体のいずれかを返す仕組みを示しています。
Isolation Forest では、検査対象のデータセットに最低 368 件のレコードが必要です。
異常が特定される仕組み
上の図に示すように、このジョブは Isolation Forest を使用して、ベクトル全体の分布と異なるレコードを特定します。各分離ツリーを構築するために、ランダムなベクトル次元とランダムな分割値を繰り返し選択し、レコードを徐々に小さなグループに分けていきます。密な領域から離れた位置にあるレコードは、リーフに到達するまでに必要な分割数が通常少なくなり、密な領域にあるレコードはパスが長くなる傾向があります。この動作により、このジョブは、わずかな分割で分離されるレコードと、ツリーのより深いレベルまで多数の近接レコードとグループ化されたままのレコードを区別できます。
異常スコアを理解する
各レコードについて、このジョブはすべての分離ツリーにわたる平均パス長を計算し、それを outlier_score に変換します。平均パスが短いほどスコアは高くなり、平均パスが長いほどスコアは低くなります。スコアが高いほど、そのレコードがデータセット内の他のレコードと比べてより異常であることを意味します。ただし、そのレコードが誤っている、または削除すべきであることを必ずしも意味するものではありません。
スコアが最も高いレコードを確認して、それらがデータ品質の問題、まれだが有効なケース、または想定される変動を表しているかどうかを判断します。
返すレコード数を選択する
topK を使用すると、outlier_score の値が最も高いレコードのみを返します。たとえば、topK を 100 に設定すると、スコアが最も高い 100 件のレコードが返されます。topK を省略した場合、出力にはすべてのレコードとその異常スコアが含まれます。
ベクトルフィールドを保持するかどうかを選択する
outputWithFeatures を使用して、分析対象のベクトルフィールドを出力に含めるかどうかを制御します。デフォルト値は true です。false に設定すると、ベクトルフィールドは除外されます。各出力レコードをソースデータまで引き続き追跡できるように、primaryKeyField を指定することをお勧めします。
事前準備
異常検知ジョブを作成する前に、以下の条件を満たしていることを確認してください。
-
すべての入力ファイルが互換性のあるスキーマを使用し、分析対象のベクトルフィールドが含まれていること。
-
そのフィールド内のすべてのベクトルが同じ型と次元を使用し、同じ埋め込みモデルと前処理方法を使用して生成されていること。
outputWithFeatures を false に設定する場合は、各出力レコードをソースデータまで追跡できるように、primaryKeyField を指定することを検討してください。
認証、サポートされているファイル形式、入力ファイル、出力の動作など、Spark バッチジョブの実行に関する一般的な要件については、Spark バッチジョブ を参照してください。
異常検知ジョブを作成する
入出力の場所、分析対象のベクトルフィールド、返すレコード数、およびベクトルフィールドを出力に保持するかどうかを指定して、異常検知ジョブを作成します。このジョブは非同期で実行され、ステータスの監視に使用できるジョブ ID を返します。
冪等性キーを準備します。
冪等性キーは、同じジョブリクエストを再試行するときに変更されない一意の文字列です。詳細については、冪等性のある送信 を参照してください。
リクエストペイロードを準備します。
export payload='{
  "description": "inspecting anomalous product",
  "regionId": "aws-us-west-2",
  "input": {
    "type": "volume",
    "volumeName": "product-data",
    "path": "input/products.parquet",
    "format": "parquet"
  },
  "output": {
    "type": "volume",
    "volumeName": "product-data",
    "path": "output/product-anomalies.parquet",
    "format": "parquet"
  },
  "primaryKeyField": "id",
  "vectorField": "embedding",
  "topK": 100,
  "outputWithFeatures": true,
  "resourceSize": "MEDIUM",
  "timeoutSeconds": 7200
}'
次の表に、ジョブ固有のパラメーターを示します。
| パラメーター | 必須 | 説明 |
|---|---|---|
vectorField | はい | 異常検知に使用するベクトルフィールドです。サポートされている表現には、array<float>、数値配列、Spark ベクトル、カンマ区切り文字列があります。 |
primaryKeyField | いいえ | 出力内のレコードを識別するために使用する入力フィールドです。outputWithFeatures を false に設定する場合に推奨されます。 |
topK | いいえ | 返すレコードの最大数です。outlier_score の高い順から低い順に並べられます。値は正の整数である必要があります。省略した場合、ジョブはスコアリングされたすべてのレコードを返します。 |
outputWithFeatures | いいえ | 出力にベクトルフィールドを保持するかどうかです。デフォルト: true。false に設定すると、ベクトルフィールドは除外されます。 |
ペイロードを送信します。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request POST \
    --url "https://api.cloud.zilliz.com/v2/projects/{projectId}/jobs/anomaly-detection" \
    --header "Authorization: Bearer ${API_KEY}" \
    --header "Idempotency-Key: spark-job-20260730-004" \
    --header "Content-Type: application/json" \
    --data "${payload}"
リクエストはジョブが作成された後に返されます。レスポンスには、進行状況を監視するために使用できるジョブ ID が含まれます。次の例は、成功したレスポンスを示しています。
{
  "code": 0,
  "data": {
    "jobId": "job-xxxxxxxx",
    "projectId": "proj-xxxxxxxx",
    "type": "SPARK",
    "description": "inspecting anomalous product",
    "status": "PENDING",
    "regionId": "aws-us-west-2",
    "clusterId": "in-xxxxxxxx",
    "createdAt": null,
    "startedAt": null,
    "finishedAt": null,
    "durationSeconds": null
  }
}
ジョブを監視する
リクエストを送信した後、返されたジョブ ID を使用して、ジョブが終了状態に達するまで監視します。ジョブのステータスと詳細を表示したり、既存のジョブを一覧表示したり、キャンセル可能な状態にある間にジョブをキャンセルしたりできます。
ジョブが成功したら、リクエストで指定したパスに想定どおりの出力が存在することを確認します。
手順、ジョブの状態、状態遷移については、Spark バッチジョブの管理 を参照してください。
出力を理解して検証する
異常検知ジョブの出力には、topK が指定されているかどうかに応じて、スコアが最も高いレコードまたはスコアリングされたすべてのレコードが含まれます。各出力レコードには outlier_score が含まれます。
| フィールド | 説明 |
|---|---|
outlier_score | レコードに割り当てられた異常スコアです。値が高いほど、そのレコードがデータセット内の他のレコードと比べてより異常であることを示します。 |
出力は、次の設定によっても異なります。
-
topKを指定した場合、出力にはoutlier_scoreの値が最も高いレコードが最大 topK 件含まれます。 -
topKを省略した場合、出力にはスコアリングされたすべてのレコードが含まれます。 -
outputWithFeaturesがtrueの場合、ベクトルフィールドは保持されます。 -
outputWithFeaturesがfalseの場合、ベクトルフィールドは除外されます。
ジョブが成功した後、以下を確認してください。
-
構成したボリュームパスに出力ファイルが存在します。
-
各出力レコードに
outlier_scoreが含まれています。 -
topKを指定した場合、出力に含まれるレコード数が要求した数を超えません。 -
topKを省略した場合、有効な入力レコードがすべて出力に含まれています。 -
ベクトルフィールドの有無が
outputWithFeaturesと一致します。 -
primaryKeyFieldを指定した場合、各出力レコードを対応する入力レコードまで追跡できます。 -
スコアが最も高いレコードのサンプルを確認して、それらがデータ品質の問題、まれだが有効なケース、または想定される変動を表しているかどうかを判断します。
次のステップ
スコアが最も高いレコードを確認して、それらがデータ品質の問題、まれだが有効なケース、または追加の処理が必要なレコードのいずれを表しているかを判断します。結果に基づいて、無効なデータを修正または削除したり、意味のあるエッジケースを保持したり、選択したレコードを手動レビューに回したりできます。
ベクトルデータの全体的な構造を調べるには、K-Means クラスタリング を使用します。意味的に重複するレコードを特定するには、ベクトル類似度重複排除 を使用します。