Boost Ranker
ベクトル距離に基づいて計算される意味的類似性だけに依存するのではなく、Boost Ranker を使用すると、検索結果を有意義な形で調整できます。メタデータフィルタリングを使用して検索結果をすばやく調整する場合に最適です。
検索リクエストに Boost Ranker 関数が含まれている場合、Milvus は関数内のオプションのフィルタリング条件を使用して検索結果の候補の中から一致するものを見つけ、指定された重みを適用して一致した候補のスコアを引き上げます。これにより、最終結果で一致したエンティティのランキングを上げたり下げたりできます。
Boost Ranker を使用する場面
クロスエンコーダーモデルやフュージョンアルゴリズムに依存する他のランカーとは異なり、Boost Ranker はオプションのメタデータ駆動ルールをランキングプロセスに直接注入するため、次のシナリオに適しています。
ユースケース | 例 | Boost Ranker が有効な理由 |
|---|---|---|
ビジネス主導のコンテンツ優先順位付け |
| インデックスを再構築したり、ベクトル埋め込みモデルを変更したりする必要はありません。これらの操作には時間がかかる場合がありますが、オプションのメタデータフィルターをリアルタイムで適用することで、検索結果の特定の項目を即座に昇格または降格できます。このメカニズムにより、変化するビジネス要件に容易に適応する、柔軟で動的な検索ランキングが可能になります。 |
戦略的なコンテンツのダウンランキング |
|
複数の Boost Ranker を組み合わせて、より動的で堅牢な重みベースのランキング戦略を実装することもできます。
Boost Ranker の仕組み
次の図は、Boost Ranker の主なワークフローを示しています。
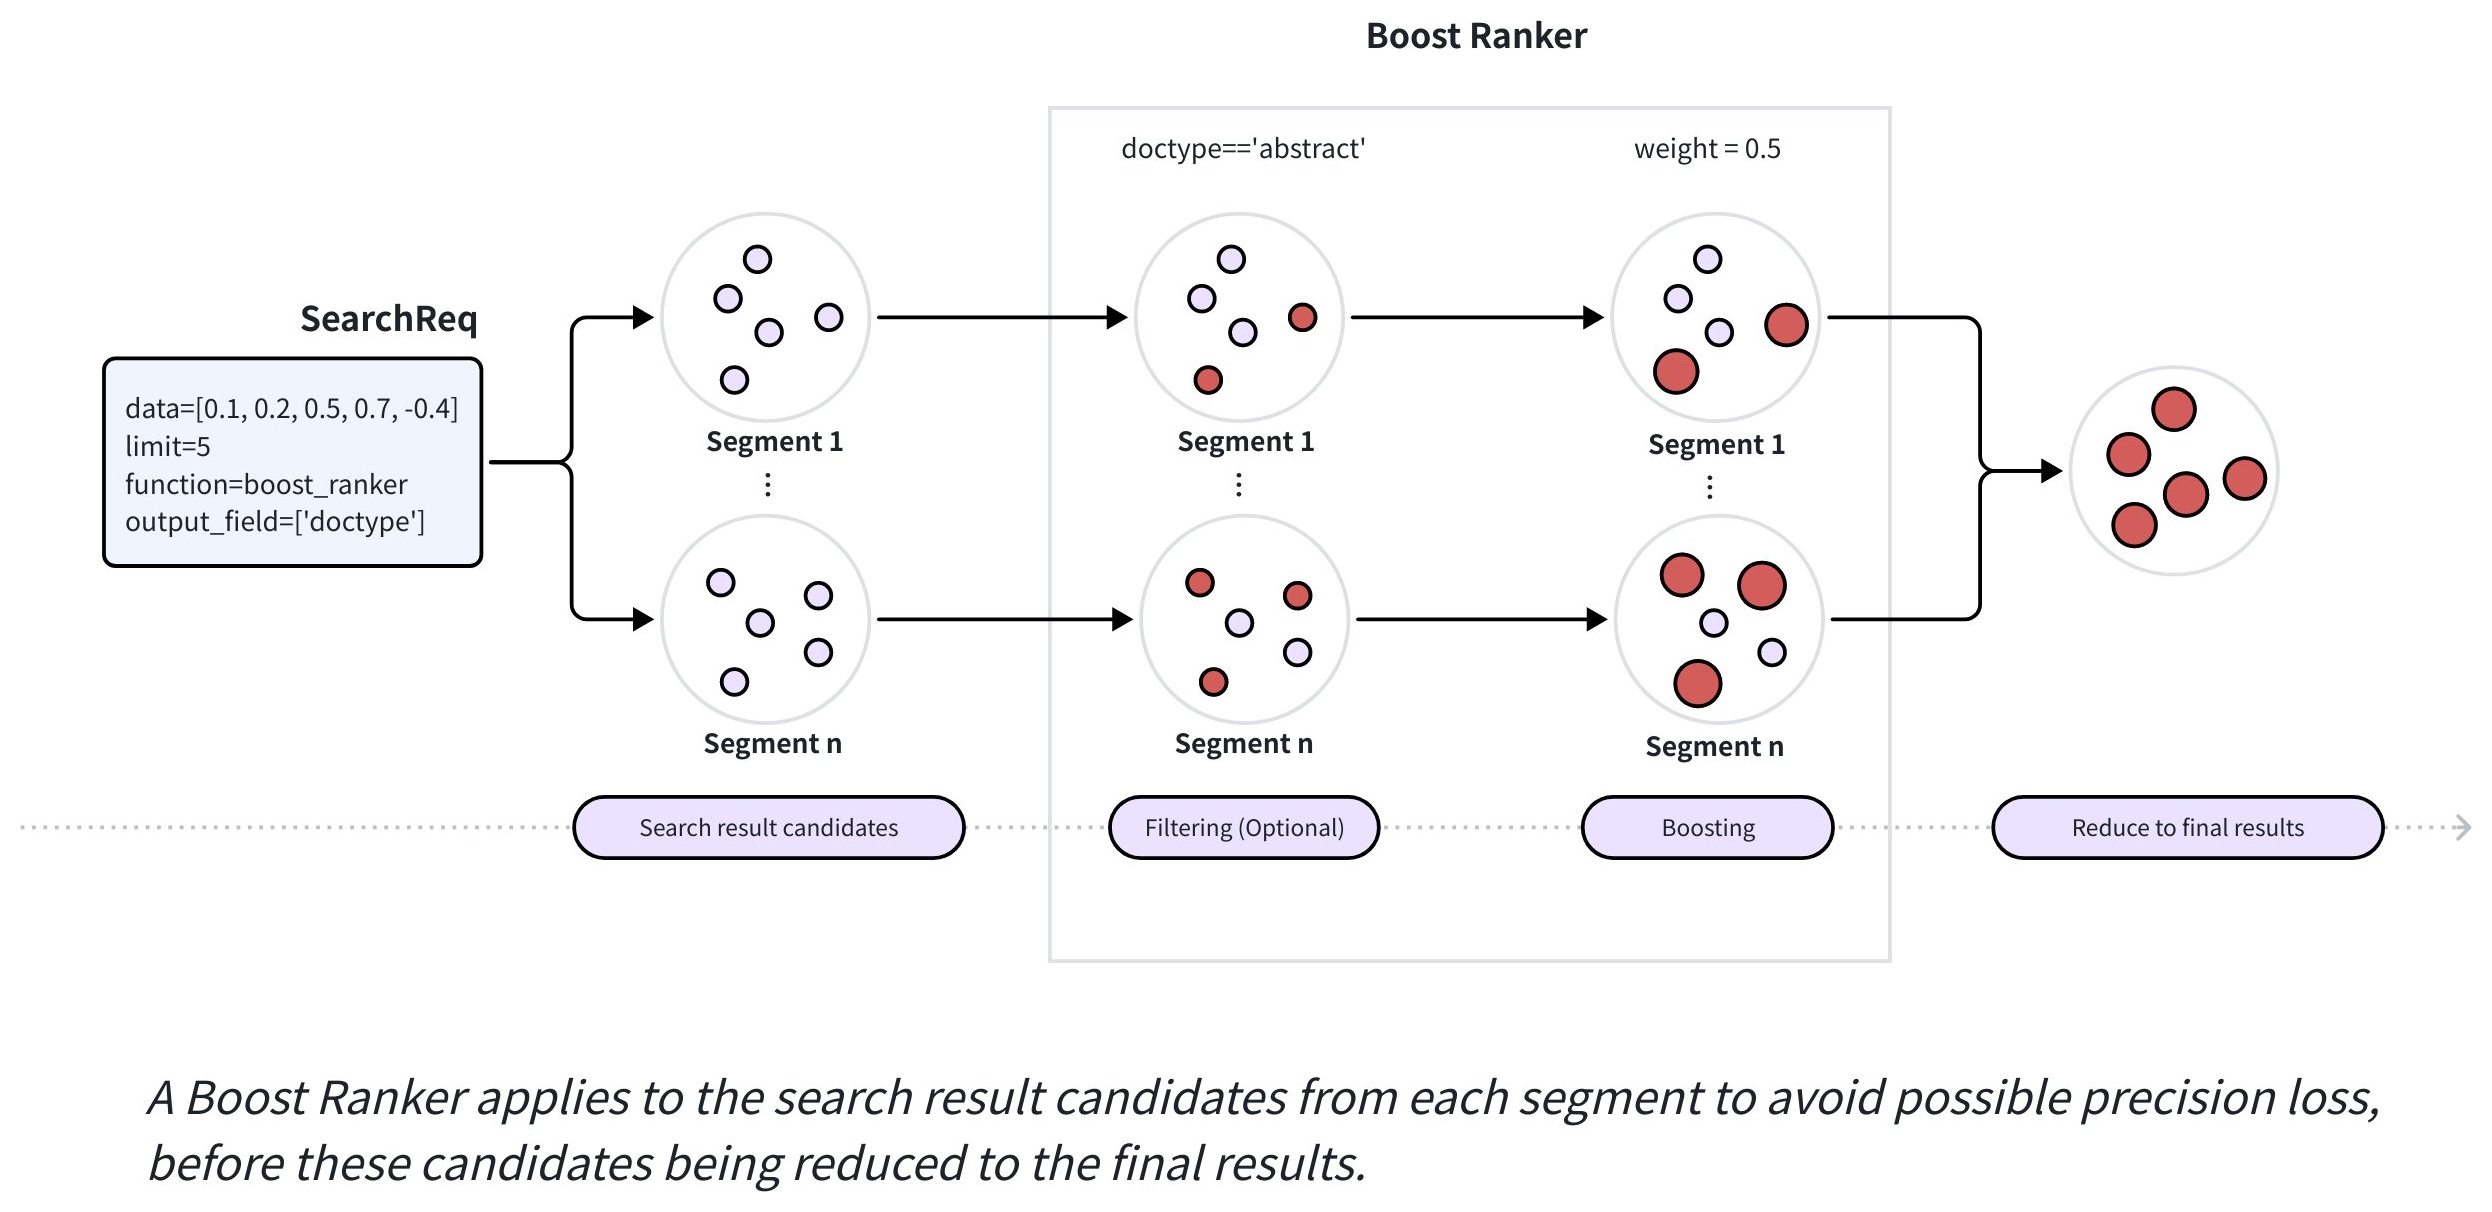
データを挿入すると、Zilliz Cloud はデータをセグメントに分散します。検索時には各セグメントが候補セットを返し、Zilliz Cloud がすべてのセグメントの候補をランク付けして最終結果を生成します。検索リクエストに Boost Ranker が含まれている場合、Zilliz Cloud は各セグメントの候補結果にそれを適用し、潜在的な精度の低下を防ぎ、再現率を向上させます。
最終結果を確定する前に、Milvus は Boost Ranker を使用してこれらの候補を次のように処理します。
-
Boost Ranker で指定されたオプションのフィルタリング式を適用して、式に一致するエンティティを特定します。
-
Boost Ranker で指定された重みを適用して、特定されたエンティティのスコアを引き上げます。
Boost Ranker はマルチベクトルハイブリッド検索では使用できません。
Boost Ranker の例
次の例は、上位 5 件の最も関連性の高いエンティティを返し、doc type が abstract のエンティティのスコアに重みを追加する必要がある単一ベクトル検索で Boost Ranker を使用する方法を示しています。
-
セグメント内の検索結果候補を収集します。
次の表では、Milvus がエンティティを 2 つのセグメント(0001 と 0002)に分散し、各セグメントが 5 つの候補を返すことを想定しています。
ID DocType スコア ランク セグメント 117 abstract 0.344 1 0001 89 abstract 0.456 2 0001 257 body 0.578 3 0001 358 title 0.788 4 0001 168 body 0.899 5 0001 46 body 0.189 1 0002 48 body 0265 2 0002 561 abstract 0.366 3 0002 344 abstract 0.444 4 0002 276 abstract 0.845 5 0002 -
Boost Ranker で指定されたフィルタリング式を適用します(
doctype='abstract')。次の表の
DocTypeフィールドに示すように、Milvus はdoctypeがabstractに設定されているすべてのエンティティを後続の処理対象としてマークします。ID DocType スコア ランク セグメント 117 abstract 0.344 1 0001 89 abstract 0.456 2 0001 257 body 0.578 3 0001 358 title 0.788 4 0001 168 body 0.899 5 0001 46 body 0.189 1 0002 48 body 0265 2 0002 561 abstract 0.366 3 0002 344 abstract 0.444 4 0002 276 abstract 0.845 5 0002 -
Boost Ranker で指定された重みを適用します(
weight=0.5)。前の手順で特定されたすべてのエンティティに、Boost Ranker で指定された重みが乗算され、ランクが変化します。
ID DocType スコア 重み付きスコア
(= スコア × 重み)ランク セグメント 117 abstract 0.344 0.172 1 0001 89 abstract 0.456 0.228 2 0001 257 body 0.578 0.578 3 0001 358 title 0.788 0.788 4 0001 168 body 0.899 0.899 5 0001 561 abstract 0.366 0.183 1 0002 46 body 0.189 0.189 2 0002 344 abstract 0.444 0.222 3 0002 48 body 0.265 0.265 4 0002 276 abstract 0.845 0.423 5 0002 Notes重みは、任意に選択する浮動小数点数である必要があります。上記の例のようにスコアが小さいほど関連性が高い場合は、1 より小さい重みを使用します。それ以外の場合は、1 より大きい重みを使用します。
-
重み付きスコアに基づいてすべてのセグメントの候補を集約し、結果を確定します。
ID DocType スコア 重み付きスコア ランク セグメント 117 abstract 0.344 0.172 1 0001 561 abstract 0.366 0.183 2 0002 46 body 0.189 0.189 3 0002 344 abstract 0.444 0.222 4 0002 89 abstract 0.456 0.228 5 0001
Boost Ranker の使用法
このセクションでは、Boost Ranker を使用して単一ベクトル検索の結果を調整する方法の例を示します。
Boost Ranker を作成する
検索リクエストの再ランカーとして Boost Ranker を渡す前に、次のように Boost Ranker を再ランキング関数として適切に定義する必要があります。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import Function, FunctionType

rerank = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "filter": "doctype == 'abstract'",
        "random_score": {
            "seed": 126,
            "field": "id"
        },
        "weight": 0.5
    }
)
import io.milvus.v2.service.vector.request.ranker.BoostRanker;

BoostRanker rerank = BoostRanker.builder()
        .name("boost")
        .filter("doctype == \"abstract\"")
        .weight(0.5f)
        .randomScoreField("id")
        .randomScoreSeed(126L)
        .build();
import "github.com/milvus-io/milvus/client/v3/entity"

rerank := entity.NewFunction().
    WithName("boost").
    WithType(entity.FunctionTypeRerank).
    WithParam("reranker", "boost").
    WithParam("filter", "doctype == 'abstract'").
    WithParam("random_score", "{\"seed\": 126, \"field\": \"id\"}").
    WithParam("weight", "0.5")
use milvus::v2::prelude::*;

let rerank = Function::new()
    .name("boost")
    .function_type(FunctionType::Rerank)
    .param("reranker", "boost")
    .param("filter", "doctype == 'abstract'")
    .param("random_score", "{\"seed\": 126, \"field\": \"id\"}")
    .param("weight", "0.5");
auto rerank = std::make_shared<milvus::BoostRerank>("boost");
rerank->SetFilter("doctype == 'abstract'");
rerank->SetWeight(0.5);
// Note: SetRandomScoreField()/SetRandomScoreSeed() are not usable as of
// milvus-sdk-cpp v3.0.3 - the SDK sends the seed as a string, which the
// server rejects (a numeric seed is required).
import {FunctionType} from '@zilliz/milvus2-sdk-node';

const rerank = {
  name: "boost",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "boost",
    filter: "doctype == 'abstract'",
    random_score: {
      seed: 126,
      field: "id",
    },
    weight: 0.5,
  },
};
# restful
export RANKER='{
    "name": "boost",
    "type": "Rerank",
    "inputFieldNames": [],
    "outputFieldNames": [],
    "params": {
        "reranker": "boost",
        "filter": "doctype == '\''abstract'\''",
        "random_score": {"seed": 126, "field": "id"},
        "weight": 0.5
    }
}'
パラメーター | 必須 | 説明 | 値/Example |
|---|---|---|---|
| はい | この Function の一意の識別子です。 |
|
| はい | 関数を適用するベクトルフィールドのリストです(Boost Ranker では、このベクトルフィールドのリストを空にする必要があります)。 |
|
| はい | 呼び出す Function のタイプです。再ランキング戦略を指定するには |
|
| はい | 再ランカーのタイプを指定します。 Boost Ranker を使用するには、 |
|
| はい | 生の検索結果で一致するエンティティのスコアに乗算される重みを指定します。 値は浮動小数点数である必要があります。
|
|
| いいえ | 検索結果のエンティティの中から一致するものを特定するために使用するフィルター式を指定します。Filtering Explained に記載されている任意の有効な基本フィルター式を使用できます。 注意: |
|
| いいえ |
同じシードとフィールド値を使用して生成間の一貫性を確保するために、 |
|
単一の Boost Ranker で検索する
Boost Ranker 関数の準備ができたら、検索リクエストでそれを参照できます。次の例では、id、vector、doctype のフィールドを持つコレクションをすでに作成していることを前提としています。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient

# Connect to the Milvus server
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# Assume you have a collection set up

# Conduct a similarity search using the created ranker
client.search(
    collection_name="my_collection",
    data=[[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
    anns_field="vector",
    params={},
    output_fields=["doctype"],
    ranker=rerank
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.FunctionScore;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new FloatVec(new float[]{-0.619954f, 0.447943f, -0.174938f, -0.424803f, -0.864845f})))
        .annsField("vector")
        .outputFields(Collections.singletonList("doctype"))
        .topK(10)
        .functionScore(FunctionScore.builder()
                .addFunction(rerank)
                .build())
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

resultSet, err := client.Search(ctx, milvusclient.NewSearchOption("my_collection", 10, []entity.Vector{
    entity.FloatVector{-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911},
}).
    WithANNSField("vector").
    WithOutputFields("doctype").
    WithFunctionScore(entity.NewFunctionScore().AddFunction(rerank)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println(resultSet)
use milvus::v2::prelude::*;

let client = ClientV2::new(&ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN")).await?;

let response = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection")
            .vector_field("vector")
            .vectors(SearchVectors::Float(vec![vec![-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]]))
            .output_fields(["doctype"])
            .limit(10)
            .rerank(FunctionScore::new().add_function(rerank.clone()))
            .build()?,
    )
    .await?;
println!("{:?}", response);
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

auto function_score = std::make_shared<milvus::FunctionScore>();
function_score->AddFunction(rerank);

std::vector<float> query_vector = {-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("vector")
                   .WithLimit(10)
                   .WithRerank(function_score)
                   .AddOutputField("doctype")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

// Connect to the Milvus server
const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN'
});

// Assume you have a collection set up

// Conduct a similarity search
const searchResults = await client.search({
  collection_name: 'my_collection',
  data: [-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911],
  anns_field: 'vector',
  output_fields: ['doctype'],
  limit: 10,
  rerank: rerank,
});

console.log('Search results:', searchResults);
# restful
export MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"
export MILVUS_TOKEN="YOUR_CLUSTER_TOKEN"
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/entities/search" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -H "Authorization: Bearer ${MILVUS_TOKEN}" \
  -d '{
    "collectionName": "my_collection",
    "data": [[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
    "annsField": "vector",
    "limit": 10,
    "outputFields": ["doctype"],
    "functionScore": {
        "functions": [
            {
                "name": "boost",
                "type": "Rerank",
                "inputFieldNames": [],
                "outputFieldNames": [],
                "params": {
                    "reranker": "boost",
                    "filter": "doctype == '\''abstract'\''",
                    "random_score": {"seed": 126, "field": "id"},
                    "weight": 0.5
                }
            }
        ]
    }
  }'
複数の Boost Ranker で検索する
1 回の検索で複数の Boost Ranker を組み合わせて、検索結果を調整できます。そのためには、複数の Boost Ranker を作成し、FunctionScore インスタンスでそれらを参照し、検索リクエストのランカーとして FunctionScore インスタンスを使用します。
次の例は、0.8 から 1.2 の間の重みを適用して、特定されたすべてのエンティティのスコアを変更する方法を示しています。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient, Function, FunctionType, FunctionScore

# Create a Boost Ranker with a fixed weight
fix_weight_ranker = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "weight": 0.8
    }
)

# Create a Boost Ranker with a randomly generated weight between 0 and 0.4
random_weight_ranker = Function(
    name="boost",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "boost",
        "random_score": {
            "seed": 126,
        },
        "weight": 0.4
    }
)

# Create a Function Score
ranker = FunctionScore(
    functions=[
        fix_weight_ranker,
        random_weight_ranker
    ],
    params={
        "boost_mode": "Multiply",
        "function_mode": "Sum"
    }
)

# Conduct a similarity search using the created Function Score
client.search(
    collection_name="my_collection",
    data=[[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
    anns_field="vector",
    params={},
    output_fields=["doctype"],
    ranker=ranker
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.vector.request.FunctionScore;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.*;

CreateCollectionReq.Function fixWeightRanker = CreateCollectionReq.Function.builder()
        .functionType(FunctionType.RERANK)
        .name("boost")
        .param("reranker", "boost")
        .param("weight", "0.8")
        .build();

CreateCollectionReq.Function randomWeightRanker = CreateCollectionReq.Function.builder()
        .functionType(FunctionType.RERANK)
        .name("boost")
        .param("reranker", "boost")
        .param("weight", "0.4")
        .param("random_score", "{\"seed\": 126}")
        .build();

Map<String, String> params = new HashMap<>();
params.put("boost_mode", "Multiply");
params.put("function_mode", "Sum");

FunctionScore ranker = FunctionScore.builder()
        .addFunction(fixWeightRanker)
        .addFunction(randomWeightRanker)
        .params(params)
        .build();

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new FloatVec(new float[]{-0.619954382375778f, 0.4479436794798608f, -0.17493894838751745f, -0.4248030059917294f, -0.8648452746018911f})))
        .annsField("vector")
        .outputFields(Collections.singletonList("doctype"))
        .topK(10)
        .functionScore(ranker)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

fixWeightRanker := entity.NewFunction().
    WithName("boost").
    WithType(entity.FunctionTypeRerank).
    WithParam("reranker", "boost").
    WithParam("weight", "0.8")

randomWeightRanker := entity.NewFunction().
    WithName("boost").
    WithType(entity.FunctionTypeRerank).
    WithParam("reranker", "boost").
    WithParam("random_score", "{\"seed\": 126}").
    WithParam("weight", "0.4")

ranker := entity.NewFunctionScore().
    AddFunction(fixWeightRanker).
    AddFunction(randomWeightRanker).
    WithParam("boost_mode", "Multiply").
    WithParam("function_mode", "Sum")

resultSet, err := client.Search(ctx, milvusclient.NewSearchOption("my_collection", 10, []entity.Vector{entity.FloatVector{-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911}}).
    WithANNSField("vector").
    WithOutputFields("doctype").
    WithFunctionScore(ranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println(resultSet)
use milvus::v2::prelude::*;
use std::collections::HashMap;

let client = ClientV2::new(&ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN")).await?;

let fix_weight_ranker = Function::new()
    .name("boost")
    .function_type(FunctionType::Rerank)
    .param("reranker", "boost")
    .param("weight", "0.8");

let random_weight_ranker = Function::new()
    .name("boost")
    .function_type(FunctionType::Rerank)
    .param("reranker", "boost")
    .param("random_score", "{\"seed\": 126}")
    .param("weight", "0.4");

let function_score = FunctionScore::new()
    .add_function(fix_weight_ranker)
    .add_function(random_weight_ranker)
    .params(HashMap::from([
        ("boost_mode".to_string(), "Multiply".into()),
        ("function_mode".to_string(), "Sum".into()),
    ]));

let response = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection")
            .vector_field("vector")
            .vectors(SearchVectors::Float(vec![vec![-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]]))
            .output_fields(["doctype"])
            .limit(10)
            .rerank(function_score)
            .build()?,
    )
    .await?;
println!("{:?}", response);
#include <iostream>
#include <vector>

auto fix_weight_ranker = std::make_shared<milvus::BoostRerank>("boost");
fix_weight_ranker->SetWeight(0.8);

auto random_weight_ranker = std::make_shared<milvus::BoostRerank>("boost");
random_weight_ranker->SetWeight(0.4);
// Note: SetRandomScoreSeed() is not usable as of milvus-sdk-cpp v3.0.3 —
// the SDK sends the seed as a string, which the server rejects.

auto function_score = std::make_shared<milvus::FunctionScore>();
function_score->AddFunction(fix_weight_ranker);
function_score->AddFunction(random_weight_ranker);

std::vector<float> query_vector = {-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("vector")
                   .WithLimit(10)
                   .WithRerank(function_score)
                   .AddOutputField("doctype")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import {FunctionType} from '@zilliz/milvus2-sdk-node';

const fix_weight_ranker = {
  name: "boost",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "boost",
    weight: 0.8,
  },
};

const random_weight_ranker = {
  name: "boost",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "boost",
    random_score: {
      seed: 126,
    },
    weight: 0.4,
  },
};

const ranker = {
  functions: [fix_weight_ranker, random_weight_ranker],
  params: {
    boost_mode: "Multiply",
    function_mode: "Sum",
  },
};

await client.search({
  collection_name: "my_collection",
  data: [[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
  anns_field: "vector",
  params: {},
  output_fields: ["doctype"],
  limit: 10,
  rerank: ranker
});
# restful
export MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"
export MILVUS_TOKEN="YOUR_CLUSTER_TOKEN"
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/entities/search" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -H "Authorization: Bearer ${MILVUS_TOKEN}" \
  -d '{
    "collectionName": "my_collection",
    "data": [[-0.619954382375778, 0.4479436794798608, -0.17493894838751745, -0.4248030059917294, -0.8648452746018911]],
    "annsField": "vector",
    "limit": 10,
    "outputFields": ["doctype"],
    "functionScore": {
        "functions": [
            {
                "name": "boost",
                "type": "Rerank",
                "inputFieldNames": [],
                "outputFieldNames": [],
                "params": {
                    "reranker": "boost",
                    "weight": 0.8
                }
            },
            {
                "name": "boost",
                "type": "Rerank",
                "inputFieldNames": [],
                "outputFieldNames": [],
                "params": {
                    "reranker": "boost",
                    "random_score": {"seed": 126},
                    "weight": 0.4
                }
            }
        ],
        "params": {
            "boost_mode": "Multiply",
            "function_mode": "Sum"
        }
    }
  }'
具体的には、2 つの Boost Ranker があります。1 つは見つかったすべてのエンティティに固定の重みを適用し、もう 1 つはそれらにランダムな重みを割り当てます。次に、これら 2 つのランカーを FunctionScore で参照します。FunctionScore は、重みが見つかったエンティティのスコアにどのように影響するかも定義します。
次の表は、FunctionScore インスタンスを作成するために必要なパラメーターを示しています。
パラメーター | 必須 | 説明 | 値/Example |
|---|---|---|---|
| はい | 対象のランカーの名前をリストで指定します。 |
|
| いいえ | 指定された重みが一致するエンティティのスコアにどのように影響するかを指定します。 使用可能な値は次のとおりです。
|
|
| いいえ | さまざまな Boost Ranker からの重み付き値がどのように処理されるかを指定します。 使用可能な値は次のとおりです。
|
|