アナライザーの概要
テキスト処理において、アナライザーは生のテキストを構造化され検索可能な形式に変換する重要なコンポーネントです。各アナライザーは通常、トークナイザーとフィルターという 2 つのコア要素で構成されます。これらが連携して入力テキストをトークンに変換し、トークンを調整して、効率的なインデックス作成と検索に備えます。
Zilliz Cloud では、コレクションのスキーマに VARCHAR フィールドを追加する際、コレクションの作成時にアナライザーを設定します。アナライザーが生成したトークンは、キーワードマッチング用のインデックスの構築、または全文検索用のスパースベクトルへの変換に使用できます。詳細は、全文検索 または テキスト一致 を参照してください。
アナライザーを使用すると、パフォーマンスに影響を与える可能性があります:
-
全文検索: 全文検索では、トークン化の完了を待つ必要があるため、DataNode と QueryNode のチャネルがデータを消費する速度が低下します。その結果、新しく取り込まれたデータが検索可能になるまでに時間がかかります。
-
キーワードマッチ: キーワードマッチングでは、インデックスを構築する前にトークン化を完了する必要があるため、インデックスの作成も遅くなります。
アナライザーの構成
Zilliz Cloud のアナライザーは、正確に 1 つのトークナイザーと0 個以上のフィルターで構成されます。
-
トークナイザー:トークナイザーは、入力テキストをトークンと呼ばれる個別の単位に分割します。これらのトークンは、トークナイザーの種類に応じて、単語またはフレーズになります。
-
フィルター:フィルターをトークンに適用して、トークンをさらに調整できます。たとえば、小文字に変換したり、一般的な単語を削除したりできます。
トークナイザーは UTF-8 形式のみをサポートしています。他の形式のサポートは将来のリリースで追加される予定です。
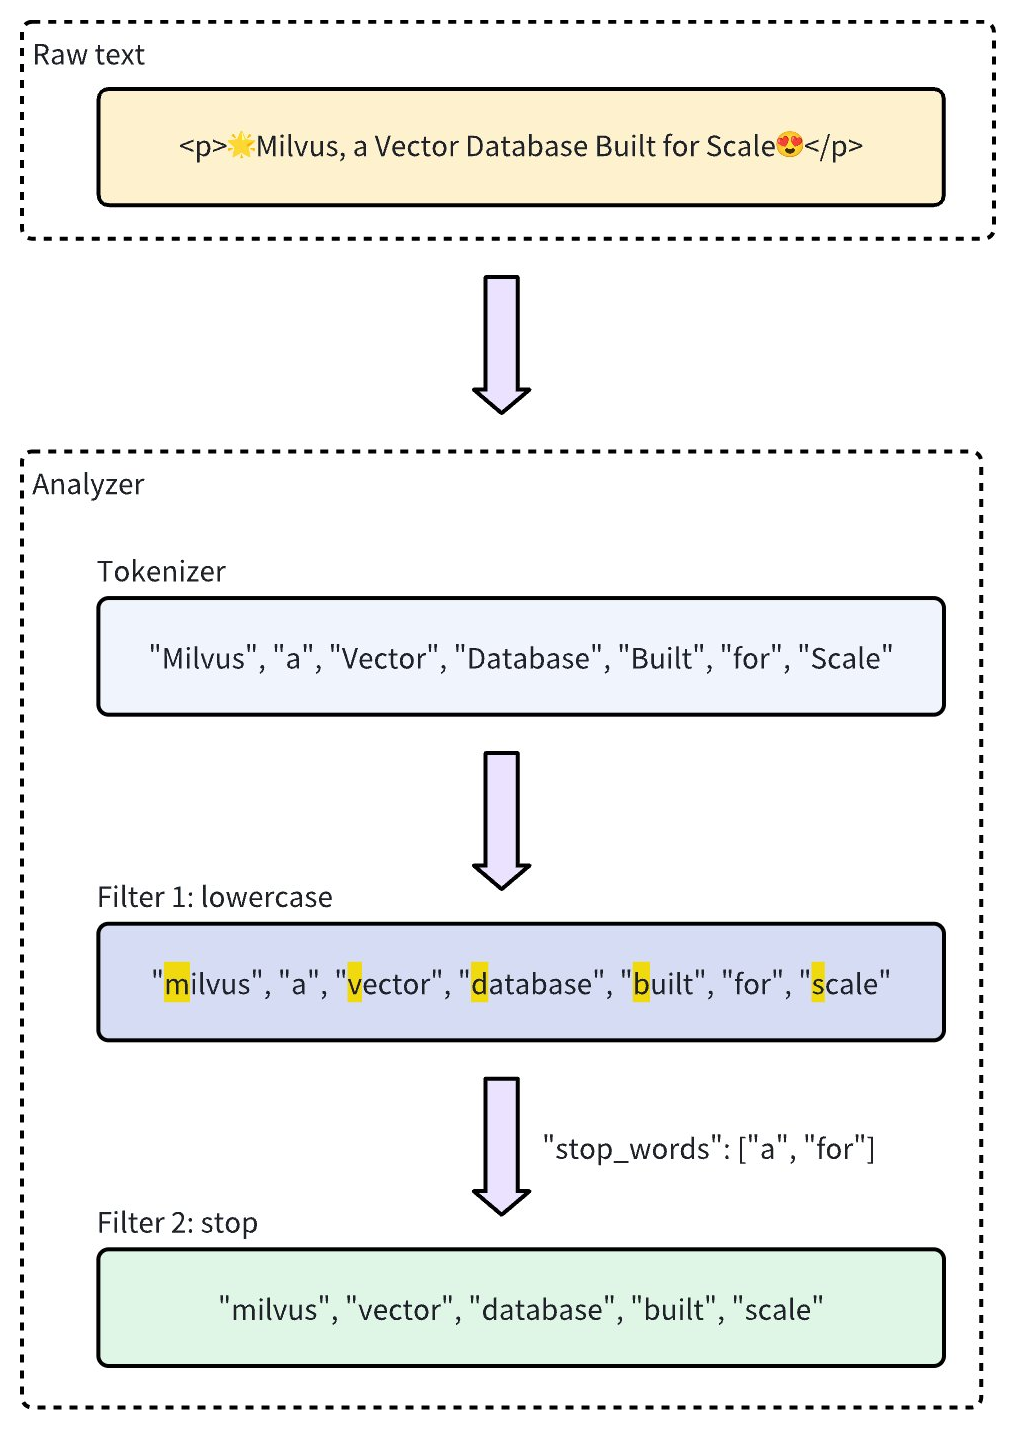
以下のワークフローは、アナライザーがテキストを処理する方法を示しています。
アナライザーの種類
Zilliz Cloud は、さまざまなテキスト処理のニーズに対応する 2 種類のアナライザーを提供しています:
-
組み込みアナライザー:これらは、最小限のセットアップで一般的なテキスト処理タスクをカバーする定義済みの構成です。組み込みアナライザーは複雑な構成が不要なため、汎用検索に最適です。
-
カスタムアナライザー:より高度な要件には、カスタムアナライザーを使用して、トークナイザーと 0 個以上のフィルターの両方を指定することで独自の構成を定義できます。このレベルのカスタマイズは、テキスト処理を正確に制御する必要がある専門的なユースケースに特に役立ちます。
-
コレクションの作成時にアナライザーの構成を省略した場合、Zilliz Cloud はデフォルトですべてのテキスト処理に
standardアナライザーを使用します。詳細は、Standard を参照してください。 -
最適な検索とクエリのパフォーマンスを実現するには、テキストデータの言語に一致するアナライザーを選択してください。たとえば、
standardアナライザーは汎用性がありますが、中国語、日本語、韓国語など、独自の文法構造を持つ言語には最適ではない場合があります。そのような場合は、chineseのような言語固有のアナライザー、または専用のトークナイザー(lindera、icuなど)とフィルターを備えたカスタムアナライザーを使用して、正確なトークン化とより良い検索結果を確保することを強くお勧めします。
組み込みアナライザー
Zilliz Cloud クラスターの組み込みアナライザーには、特定のトークナイザーとフィルターが事前に構成されているため、これらのコンポーネントを自分で定義することなくすぐに使用できます。各組み込みアナライザーは、事前設定されたトークナイザーとフィルターを含むテンプレートとして機能し、カスタマイズ用のオプションのパラメーターを備えています。
たとえば、standard 組み込みアナライザーを使用するには、その名前 standard を type として指定するだけで、必要に応じて stop_words など、このアナライザータイプに固有の追加構成を含めることができます:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
use milvus::v2::prelude::*;

let analyzer_params = serde_json::json!({
    "type": "standard",
    "stop_words": ["a", "an", "for"]
});
nlohmann::json analyzer_params = {
    {"type", "standard"},
    {"stop_words",  {"a", "an", "for"}},
};
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
アナライザーの実行結果を確認するには、run_analyzer メソッドを使用します:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts...).
    WithAnalyzerParams(analyzerParams)

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let sample_text = "An efficient system relies on a robust analyzer to correctly process text for various applications.";
let response = client
    .run_analyzer(
        RunAnalyzerRequest::builder()
            .texts([sample_text])
            .analyzer_params(analyzer_params.clone())
            .build()?,
    )
    .await?;
println!("{:?}", response);
std::string text = "An efficient system relies on a robust analyzer to correctly process text for various applications.";

auto request = milvus::RunAnalyzerRequest()
                       .AddText(text)
                       .WithAnalyzerParams(analyzer_params);

milvus::RunAnalyzerResponse response;
auto status = client->RunAnalyzer(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.runAnalyzer({
    text,
    analyzer_params
});
# restful
export MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"
export TEXT_TO_ANALYZE="An efficient system relies on a robust analyzer to correctly process text for various applications."
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/common/run_analyzer" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -d '{
    "text": ["'"${TEXT_TO_ANALYZE}"'"],
    "analyzerParams": "{\"type\":\"standard\",\"stop_words\":[\"a\",\"an\",\"for\"]}"
  }'
The output will be:
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
This demonstrates that the analyzer properly tokenizes the input text by filtering out the stop words "a", "an", and "for", while returning the remaining meaningful tokens.
The configuration of the standard built-in analyzer above is equivalent to setting up a custom analyzer with the following parameters, where tokenizer and filter options are explicitly defined to achieve similar functionality:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
let analyzer_params = serde_json::json!({
    "tokenizer": "standard",
    "filter": ["lowercase", {"type": "stop", "stop_words": ["a", "an", "for"]}]
});
nlohmann::json analyzer_params = {
    {"tokenizer", "standard"},
    {"filter", {"lowercase", {{"type", "stop"}, {"stop_words", {"a", "an", "for"}}}}},
};
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
export analyzerParams='{
       "tokenizer": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
Zilliz Cloud は、それぞれ特定のテキスト処理のニーズに合わせて設計された以下の組み込みアナライザーを提供しています:
-
standard:汎用テキスト処理に適しており、標準のトークン化と小文字フィルタリングを適用します。 -
english:英語のテキストに最適化されており、英語のストップワードをサポートします。 -
chinese:中国語のテキスト処理に特化しており、中国語の言語構造に適応したトークン化を含みます。
カスタムアナライザー
より高度なテキスト処理には、Zilliz Cloud のカスタムアナライザーを使用して、トークナイザーとフィルターの両方を指定することで、テキスト処理に合わせたパイプラインを構築できます。この設定は、正確な制御が必要な専門的なユースケースに最適です。
トークナイザー
トークナイザーはカスタムアナライザーの必須コンポーネントであり、入力テキストを個別の単位またはトークンに分割してアナライザーのパイプラインを開始します。トークン化は、トークナイザーの種類に応じて、空白や句読点で分割するなど、特定のルールに従います。このプロセスにより、各単語またはフレーズをより正確かつ独立して処理できます。
たとえば、トークナイザーはテキスト "Vector Database Built for Scale" を個別のトークンに変換します:
["Vector", "Database", "Built", "for", "Scale"]
トークナイザーを指定する例:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
analyzerParams = map[string]any{"tokenizer": "whitespace"}
let analyzer_params = serde_json::json!({"tokenizer": "whitespace"});
nlohmann::json analyzer_params = {
    {"tokenizer", "whitespace"}
};
const analyzer_params = {
    "tokenizer": "whitespace",
};
export analyzerParams='{
       "tokenizer": "whitespace"
    }'
フィルター
フィルターはオプションのコンポーネントであり、トークナイザーが生成したトークンを処理し、必要に応じて変換または調整します。たとえば、トークン化された用語 ["Vector", "Database", "Built", "for", "Scale"] に lowercase フィルターを適用した後の結果は、次のようになります:
["vector", "database", "built", "for", "scale"]
カスタムアナライザーのフィルターは、構成のニーズに応じて組み込みまたはカスタムのいずれかになります。
-
組み込みフィルター:Zilliz Cloud によって事前に構成されており、最小限のセットアップで済みます。名前を指定するだけで、これらのフィルターをすぐに使用できます。以下のフィルターは直接使用できる組み込みフィルターです:
-
lowercase:テキストを小文字に変換し、大文字と小文字を区別しないマッチングを確保します。詳細は、Lowercase を参照してください。 -
asciifolding:非 ASCII 文字を ASCII の同等文字に変換し、多言語テキストの処理を簡素化します。詳細は、ASCII folding を参照してください。 -
alphanumonly:英数字のみを保持し、それ以外を削除します。詳細は、Alphanumonly を参照してください。 -
cnalphanumonly:中国語の文字、英字、数字以外の文字を含むトークンを削除します。詳細は、Cnalphanumonly を参照してください。 -
cncharonly:中国語以外の文字を含むトークンを削除します。詳細は、Cncharonly を参照してください。 -
pinyin:中国語のトークンにピンイン形式のトークンを追加し、中国語テキストのピンインベースのマッチングを可能にします。詳細は、Pinyin を参照してください。
組み込みフィルターを使用する例:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
pythonanalyzer_params = {"tokenizer": "standard", # Mandatory: Specifies tokenizer"filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase}javaMap<String, Object> analyzerParams = new HashMap<>();analyzerParams.put("tokenizer", "standard");analyzerParams.put("filter", Collections.singletonList("lowercase"));goanalyzerParams = map[string]any{"tokenizer": "standard","filter": []any{"lowercase"}}rustlet analyzer_params = serde_json::json!({"tokenizer": "standard", "filter": ["lowercase"]});c++nlohmann::json analyzer_params = {{"tokenizer", "standard"},{"filter", {"lowercase"}},};javascriptconst analyzer_params = {"tokenizer": "standard", // Mandatory: Specifies tokenizer"filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase}bashexport analyzerParams='{"tokenizer": "standard","filter": ["lowercase"]}' -
-
カスタムフィルター:カスタムフィルターでは、専門的な構成が可能です。有効なフィルタータイプ(
filter.type)を選択し、フィルタータイプごとに固有の設定を追加することで、カスタムフィルターを定義できます。カスタマイズをサポートするフィルタータイプの例は次のとおりです:-
stop:ストップワードのリスト(例:"stop_words": ["of", "to"])を設定して、指定した一般的な単語を削除します。詳細は、Stop を参照してください。 -
length:最大トークン長の設定など、長さの基準に基づいてトークンを除外します。詳細は、Length を参照してください。 -
stemmer:単語を語根形に還元し、より柔軟なマッチングを実現します。詳細は、Stemmer を参照してください。
カスタムフィルターを構成する例:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
pythonanalyzer_params = {"tokenizer": "standard", # Mandatory: Specifies tokenizer"filter": [{"type": "stop", # Specifies 'stop' as the filter type"stop_words": ["of", "to"], # Customizes stop words for this filter type}]}javaMap<String, Object> analyzerParams = new HashMap<>();analyzerParams.put("tokenizer", "standard");analyzerParams.put("filter",Collections.singletonList(new HashMap<String, Object>() {{put("type", "stop");put("stop_words", Arrays.asList("of", "to"));}}));goanalyzerParams = map[string]any{"tokenizer": "standard","filter": []any{map[string]any{"type": "stop","stop_words": []string{"of", "to"},}}}rustlet analyzer_params = serde_json::json!({"tokenizer": "standard","filter": [{"type": "stop", "stop_words": ["of", "to"]}]});c++nlohmann::json analyzer_params = {{"tokenizer", "standard"},{"filter", {{{"type", "stop"}, {"stop_words", {"of", "to"}}}}},};javascriptconst analyzer_params = {"tokenizer": "standard", // Mandatory: Specifies tokenizer"filter": [{"type": "stop", // Specifies 'stop' as the filter type"stop_words": ["of", "to"], // Customizes stop words for this filter type}]};bashexport analyzerParams='{"tokenizer": "standard","filter": [{"type": "stop","stop_words": ["of", "to"]}]}' -
使用例
この例では、以下を含むコレクションスキーマを作成します:
-
埋め込み用のベクトルフィールド。
-
テキスト処理用の 2 つの
VARCHARフィールド:-
一方のフィールドは組み込みアナライザーを使用します。
-
もう一方はカスタムアナライザーを使用します。
-
これらの構成をコレクションに組み込む前に、run_analyzer メソッドを使用して各アナライザーを検証します。
ステップ 1:MilvusClient を初期化してスキーマを作成する
まず、Milvus クライアントを設定し、新しいスキーマを作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import java.util.*;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
use milvus::v2::prelude::*;

let client = ClientV2::new(&ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN")).await?;
let schema = CollectionSchema::new().enable_dynamic_field(false);
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(false);
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient({
    address: "YOUR_CLUSTER_ENDPOINT",
    token: "YOUR_CLUSTER_TOKEN"
});
# restful
export MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"
export MILVUS_TOKEN="YOUR_CLUSTER_TOKEN"
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/collections/create" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -H "Authorization: Bearer ${MILVUS_TOKEN}" \
  -d '{
    "collectionName": "my_collection",
    "dimension": 768,
    "schema": {
      "autoId": true,
      "enableDynamicField": false
    }
  }'
ステップ 2:アナライザーの構成を定義して検証する
-
組み込みアナライザー(
english)を構成して検証する:-
構成: 組み込み英語アナライザーのパラメーターを定義します。
-
検証:
run_analyzerを使用して、構成が期待どおりのトークン化を生成することを確認します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Built-in analyzer configuration for English text processinganalyzer_params_built_in = {"type": "english"}# Verify built-in analyzer configurationsample_text = "Milvus simplifies text analysis for search."result = client.run_analyzer(sample_text, analyzer_params_built_in)print("Built-in analyzer output:", result)# Expected output:# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']javaimport io.milvus.v2.service.vector.request.RunAnalyzerReq;import io.milvus.v2.service.vector.response.RunAnalyzerResp;import java.util.ArrayList;import java.util.HashMap;import java.util.List;import java.util.Map;Map<String, Object> analyzerParamsBuiltin = new HashMap<>();analyzerParamsBuiltin.put("type", "english");List<String> texts = new ArrayList<>();texts.add("Milvus simplifies text analysis for search.");RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder().texts(texts).analyzerParams(analyzerParamsBuiltin).build());List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();goimport ("fmt""github.com/milvus-io/milvus/client/v3/milvusclient")analyzerParamsBuiltin := map[string]any{"type": "english"}texts := []string{"Milvus simplifies text analysis for search."}option := milvusclient.NewRunAnalyzerOption(texts...).WithAnalyzerParams(analyzerParamsBuiltin)result, err := client.RunAnalyzer(ctx, option)if err != nil {fmt.Println(err.Error())// handle error}rustuse milvus::v2::prelude::*;let analyzer_params_built_in = serde_json::json!({"type": "english"});let sample_text = "Milvus simplifies text analysis for search.";let response = client.run_analyzer(RunAnalyzerRequest::builder().texts([sample_text]).analyzer_params(analyzer_params_built_in.clone()).build()?,).await?;println!("{:?}", response);c++nlohmann::json analyzer_params_built_in = {{"type", "english"}};std::string sample_text = "Milvus simplifies text analysis for search.";auto request = milvus::RunAnalyzerRequest().AddText(sample_text).WithAnalyzerParams(analyzer_params_built_in);milvus::RunAnalyzerResponse response;auto status = client->RunAnalyzer(request, response);if (!status.IsOk()) {std::cout << status.Message() << std::endl;}javascript// Use a built-in analyzer for VARCHAR field `title_en`const analyzer_params_built_in = {type: "english",};const sample_text = "Milvus simplifies text analysis for search.";const result = await client.runAnalyzer({text: sample_text,analyzer_params: analyzer_params_built_in});bash# restfulexport MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"export SAMPLE_TEXT="Milvus simplifies text analysis for search."curl -X POST "http://${MILVUS_HOST}/v2/vectordb/common/run_analyzer" \-H "Content-Type: application/json" \-H "Request-Timeout: 10" \-d '{"text": ["'"${SAMPLE_TEXT}"'"],"analyzerParams": "{\"type\":\"english\"}"}' -
-
カスタムアナライザーを構成して検証する:
-
構成: 標準トークナイザー、組み込みの小文字フィルター、およびトークン長とストップワード用のカスタムフィルターを使用するカスタムアナライザーを定義します。
-
検証:
run_analyzerを使用して、カスタム構成がテキストを意図どおりに処理することを確認します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Custom analyzer configuration with a standard tokenizer and custom filtersanalyzer_params_custom = {"tokenizer": "standard","filter": ["lowercase", # Built-in filter: convert tokens to lowercase{"type": "length", # Custom filter: restrict token length"max": 40},{"type": "stop", # Custom filter: remove specified stop words"stop_words": ["of", "for"]}]}# Verify custom analyzer configurationsample_text = "Milvus provides flexible, customizable analyzers for robust text processing."result = client.run_analyzer(sample_text, analyzer_params_custom)print("Custom analyzer output:", result)# Expected output:# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']javaimport io.milvus.v2.service.vector.request.RunAnalyzerReq;import io.milvus.v2.service.vector.response.RunAnalyzerResp;import java.util.ArrayList;import java.util.Arrays;import java.util.HashMap;import java.util.List;import java.util.Map;// Configure a custom analyzerMap<String, Object> analyzerParamsCustom = new HashMap<>();analyzerParamsCustom.put("tokenizer", "standard");analyzerParamsCustom.put("filter",Arrays.asList("lowercase",new HashMap<String, Object>() {{put("type", "length");put("max", 40);}},new HashMap<String, Object>() {{put("type", "stop");put("stop_words", Arrays.asList("of", "for"));}}));List<String> texts = new ArrayList<>();texts.add("Milvus provides flexible, customizable analyzers for robust text processing.");RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder().texts(texts).analyzerParams(analyzerParamsCustom).build());List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();goimport ("fmt""github.com/milvus-io/milvus/client/v3/milvusclient")analyzerParamsCustom := map[string]any{"tokenizer": "standard","filter": []any{"lowercase",map[string]any{"type": "length","max": 40,},map[string]any{"type": "stop","stop_words": []string{"of", "for"},}}}texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."}option := milvusclient.NewRunAnalyzerOption(texts...).WithAnalyzerParams(analyzerParamsCustom)result, err := client.RunAnalyzer(ctx, option)if err != nil {fmt.Println(err.Error())// handle error}rustuse milvus::v2::prelude::*;let analyzer_params_custom = serde_json::json!({"tokenizer": "standard","filter": ["lowercase", {"type": "length", "max": 40}, {"type": "stop", "stop_words": ["of", "for"]}]});let sample_text = "Milvus provides flexible, customizable analyzers for robust text processing.";let response = client.run_analyzer(RunAnalyzerRequest::builder().texts([sample_text]).analyzer_params(analyzer_params_custom.clone()).build()?,).await?;println!("{:?}", response);c++nlohmann::json analyzer_params_custom = {{"tokenizer", "standard"},{"filter", {"lowercase",{{"type", "length"}, {"max", 40}},{{"type", "stop"}, {"stop_words", {"of", "for"}}}}},};const std::vector<std::string> texts = {"Milvus provides flexible, customizable analyzers for robust text processing."};auto request = milvus::RunAnalyzerRequest().WithTexts(texts).WithAnalyzerParams(analyzer_params_custom);milvus::RunAnalyzerResponse response;auto status = client->RunAnalyzer(request, response);if (!status.IsOk()) {std::cout << status.Message() << std::endl;}javascript// Configure a custom analyzer for VARCHAR field `title`const analyzer_params_custom = {tokenizer: "standard",filter: ["lowercase",{type: "length",max: 40,},{type: "stop",stop_words: ["of", "for"],},],};const sample_text_custom = "Milvus provides flexible, customizable analyzers for robust text processing.";const result_custom = await client.runAnalyzer({text: sample_text_custom,analyzer_params: analyzer_params_custom});bash# curlexport MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"export SAMPLE_TEXT="Milvus provides flexible, customizable analyzers for robust text processing."curl -X POST "http://${MILVUS_HOST}/v2/vectordb/common/run_analyzer" \-H "Content-Type: application/json" \-H "Request-Timeout: 10" \-d '{"text": ["'"${SAMPLE_TEXT}"'"],"analyzerParams": "{\"tokenizer\":\"standard\",\"filter\":[\"lowercase\",{\"type\":\"length\",\"max\":40},{\"type\":\"stop\",\"stop_words\":[\"of\",\"for\"]}]}"}' -
ステップ 3:アナライザーをスキーマフィールドに追加する
アナライザーの構成を検証したので、それをスキーマフィールドに追加します:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("title_en")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParamsBuiltin)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParamsCustom)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title_en").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParamsBuiltin).
    WithEnableMatch(true),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParamsCustom).
    WithEnableMatch(true),
)
use milvus::v2::prelude::*;

let schema = schema
    .add_field(FieldSchema::new().name("id").data_type(DataType::Int64).primary_key(true).auto_id(true))
    .add_field(FieldSchema::new().name("title_en").data_type(DataType::VarChar).max_length(1000).enable_analyzer(true).enable_match(true).analyzer_params(analyzer_params_built_in))
    .add_field(FieldSchema::new().name("title").data_type(DataType::VarChar).max_length(1000).enable_analyzer(true).enable_match(true).analyzer_params(analyzer_params_custom))
    .add_field(FieldSchema::new().name("embedding").data_type(DataType::FloatVector).dimension(3));
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("title_en", milvus::DataType::VARCHAR).WithMaxLength(1000)
                    .EnableAnalyzer(true).EnableMatch(true).WithAnalyzerParams(analyzer_params_built_in));
schema->AddField(milvus::FieldSchema("title", milvus::DataType::VARCHAR).WithMaxLength(1000)
                    .EnableAnalyzer(true).EnableMatch(true).WithAnalyzerParams(analyzer_params_custom));
schema->AddField(milvus::FieldSchema("embedding", milvus::DataType::FLOAT_VECTOR).WithDimension(3));
import { DataType } from "@zilliz/milvus2-sdk-node";

// Create schema
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: true,
  },
  {
    name: "title_en",
    data_type: DataType.VarChar,
    max_length: 1000,
    enable_analyzer: true,
    analyzer_params: analyzer_params_built_in,
    enable_match: true,
  },
  {
    name: "title",
    data_type: DataType.VarChar,
    max_length: 1000,
    enable_analyzer: true,
    analyzer_params: analyzer_params_custom,
    enable_match: true,
  },
  {
    name: "embedding",
    data_type: DataType.FloatVector,
    dim: 3,
  },
];
# restful
export SCHEMA_CONFIG='{
  "autoId": true,
  "enableDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "title_en",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": "1000",
        "enable_analyzer": true,
        "analyzer_params": "{\"type\":\"english\"}",
        "enable_match": true
      }
    },
    {
      "fieldName": "title",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": "1000",
        "enable_analyzer": true,
        "analyzer_params": "{\"tokenizer\":\"standard\",\"filter\":[\"lowercase\",{\"type\":\"length\",\"max\":40},{\"type\":\"stop\",\"stop_words\":[\"of\",\"for\"]}]}",
        "enable_match": true
      }
    },
    {
      "fieldName": "embedding",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": "3"
      }
    }
  ]
}'
ステップ 4:インデックスパラメーターを準備してコレクションを作成する
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import java.util.ArrayList;
import java.util.List;

// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("my_collection")
            .schema(schema)
            .index_param(
                IndexParam::new()
                    .field_name("embedding")
                    .index_type(IndexType::AutoIndex)
                    .metric_type(MetricType::Cosine),
            )
            .build()?,
    )
    .await?;
std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("embedding", "", milvus::IndexType::AUTOINDEX, milvus::MetricType::COSINE)
};

auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                    .WithCollectionName("my_collection")
                                    .WithIndexes(std::move(indexes))
                                    .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// Set up index params for vector field
const indexParams = [
  {
    field_name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
export INDEX_PARAMS='[{"fieldName": "embedding", "metricType": "COSINE", "indexType": "AUTOINDEX"}]'
# restful
curl -X POST "YOUR_CLUSTER_ENDPOINT/v2/vectordb/collections/create" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -d "{
    \"collectionName\": \"my_collection\",
    \"schema\": ${SCHEMA_CONFIG},
    \"indexParams\": ${INDEX_PARAMS}
  }"
Zilliz Cloud コンソールでの使用例
上記の操作は、Zilliz Cloud コンソールを使用して実行することもできます。詳細は、以下のデモをご覧ください。
アナライザーの構成は、コレクションの作成後に変更できません。アナライザーの構成を変更するには、目的の設定で新しいコレクションを作成し、データを 移行 します。
次のステップ
アナライザーを構成する際は、ユースケースに最適な構成を決定するために、以下のベストプラクティス記事を読むことをお勧めします:
アナライザーを構成した後は、Zilliz Cloud が提供するテキスト検索機能と統合できます。詳細: