ユースケースに適したアナライザーを選択する
このガイドでは、Zilliz Cloud のテキストコンテンツに最適な アナライザー を選択して設定する方法を説明します。
実用的な意思決定 に焦点を当て、使用するアナライザー、カスタマイズのタイミング、設定の確認方法を説明します。アナライザーのコンポーネントとパラメーターの背景については、アナライザーの概要 を参照してください。
基本概念:アナライザーの仕組み
アナライザーはテキストデータを処理し、全文検索(BM25 ベース)、フレーズマッチ、テキストマッチ などの機能で検索できるようにします。2 段階のパイプラインを通じて、生のテキストを個別の検索可能なトークンに変換します。
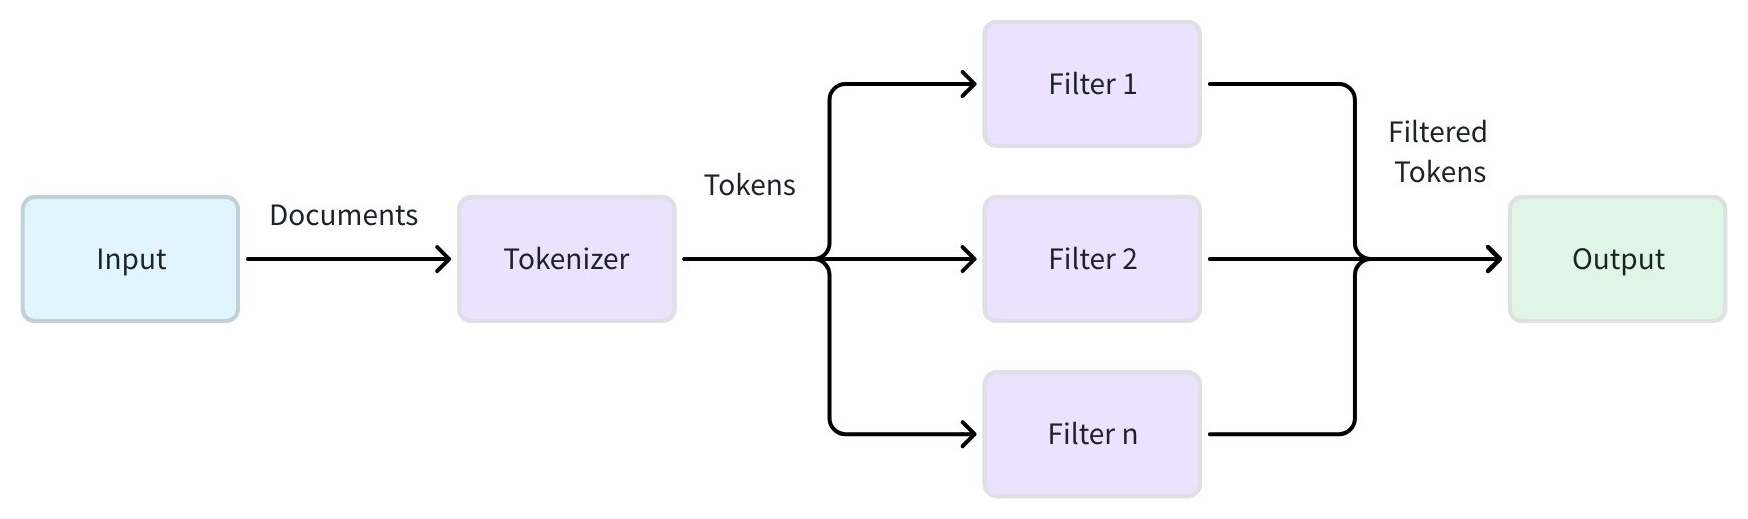
-
トークン化(必須): この最初の段階では、トークナイザー を適用して、連続するテキスト文字列をトークンと呼ばれる個別の意味のある単位に分割します。トークン化の方法は、言語とコンテンツの種類によって大きく異なります。
-
トークンフィルタリング(任意): トークン化の後、フィルター を適用してトークンを変更、削除、または絞り込みます。これらの操作には、すべてのトークンを小文字に変換する、一般的な無意味な単語(ストップワードなど)を削除する、単語を語根形に還元する(ステミング)などがあります。
例:
Input: "Hello World!"
       1. Tokenization → ["Hello", "World", "!"]
       2. Lowercase & Punctuation Filtering → ["hello", "world"]
アナライザーの選択が重要な理由
選択するアナライザーは、検索品質と関連性 に直接影響します。
不適切なアナライザーを使用すると、トークン化の不足または過剰、用語の欠落、無関係な結果などが発生する可能性があります。
問題 | 症状 | 例(入力と出力) | 原因(不適切なアナライザー) | 解決策(適切なアナライザー) |
|---|---|---|---|---|
トークン化の過剰 | 技術用語、識別子、URL が正しく分割されない |
|
|
|
トークン化の不足 | 複数語のフレーズが単一のトークンとして扱われる |
|
| |
言語の不一致 | 外国語の結果が意味をなさない | 中国語テキスト: |
|
|
入力方式の不一致 | ユーザーがピンインを入力する一方、インデックス済みテキストでは漢字が使用されている。 | 中国語テキスト: | 漢字のトークンのみを出力するアナライザー |
ステップ 1:アナライザーを選択する必要があるか
テキスト検索機能(全文検索、フレーズマッチ、テキストマッチ など)を使用しているものの、アナライザーを明示的に指定しない 場合、
Zilliz Cloud は standard アナライザー を自動的に適用します。
standard アナライザーの動作:
-
スペースと句読点でテキストを分割します。
-
すべてのトークンを小文字に変換します。
変換例:
Input:  "The Milvus vector database is built for scale!"
Output: ['the', 'milvus', 'vector', 'database', 'is', 'built', 'for', 'scale']
ステップ 2:standard アナライザーが要件を満たすか確認する
この表を使用して、デフォルトの standard アナライザー が要件を満たすかどうかをすばやく判断してください。満たさない場合は、別のパスを選択 する必要があります。
| コンテンツ | standard アナライザーで問題ないか | 理由 | 必要な対応 |
|---|---|---|---|
| 英語のブログ記事 | はい | デフォルトの動作で十分です。 | デフォルトを使用します(設定は不要です)。 |
| 中国語のドキュメント | いいえ | 中国語の単語にはスペースがないため、1 つのトークンとして扱われます。 | 組み込みの chinese アナライザーを使用します。 |
| テクニカルドキュメント | いいえ | C++ などの用語から句読点が削除されます。 | whitespace トークナイザーと alphanumonly フィルターを備えたカスタムアナライザーを作成します。 |
| French/Spanish のテキストなど、スペースで区切る言語 | ⚠️ 場合による | アクセント付き文字(café と cafe)が一致しない可能性があります。 | より良い結果を得るには、asciifolding を備えたカスタムアナライザーをお勧めします。 |
| 多言語または不明な言語 | いいえ | standard アナライザーには、異なる文字セットやトークン化ルールを処理するための言語固有のロジックがありません。 | Unicode 対応のトークン化には、icu トークナイザーを備えたカスタムアナライザーを使用します。または、多言語コンテンツをより正確に処理するために、多言語アナライザー または 言語識別子 の構成を検討してください。 |
ステップ 3:パスを選択する
デフォルトの standard アナライザー では不十分な場合は、次の 2 つのパスのいずれかを選択します。
-
パス A – 組み込みアナライザーを使用する(すぐに使用できる言語固有のアナライザー)
-
パス B – カスタムアナライザーを作成する(トークナイザーと一連のフィルターを手動で定義)
パス A:組み込みアナライザーを使用する
組み込みアナライザーは、一般的な言語向けに事前設定されたソリューションです。デフォルトの standard アナライザーが完全に適合しない場合に、最も簡単に始められる方法です。
使用可能な組み込みアナライザー
アナライザー | 言語サポート | コンポーネント | 備考 |
|---|---|---|---|
スペースで区切るほとんどの言語(英語、フランス語、ドイツ語、スペイン語など) |
| 初期のテキスト処理向けの汎用アナライザーです。単一言語のシナリオでは、言語固有のアナライザー( | |
英語専用(Dedicated)のアナライザーで、ステミングとストップワードの削除を適用し、英語の意味マッチングを向上させます。 |
| 英語のみのコンテンツでは、 | |
中国語 |
| 現在、デフォルトでは簡体字中国語の辞書を使用しています。 |
実装例
組み込みアナライザーを使用するには、フィールドスキーマを定義するときに analyzer_params でそのタイプを指定するだけです。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Using built-in English analyzer
analyzer_params = {
    "type": "english"
}

# Applying analyzer config to target VARCHAR field in your collection schema
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params=analyzer_params,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

analyzerParams := map[string]any{"type": "english"}

schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(200).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams))
use milvus::v2::prelude::*;
use serde_json::json;

let analyzer_params = serde_json::json!({"type": "english"});
let schema = CollectionSchema::new().add_field(FieldSchema::new()
    .name("text")
    .data_type(DataType::VarChar)
    .max_length(200)
    .enable_analyzer(true)
    .analyzer_params(analyzer_params));
nlohmann::json analyzer_params = {{"type", "english"}};
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)
                     .WithMaxLength(200)
                     .EnableAnalyzer(true)
                     .WithAnalyzerParams(analyzer_params));
import { DataType } from "@zilliz/milvus2-sdk-node";

const analyzer_params = { type: "english" };

const schema = [
  {
    name: "text",
    data_type: DataType.VarChar,
    max_length: 200,
    enable_analyzer: true,
    analyzer_params,
  },
];
export textField='{
  "fieldName": "text",
  "dataType": "VarChar",
  "elementTypeParams": {
    "max_length": 200,
    "enable_analyzer": true,
    "analyzer_params": "{\"type\":\"english\"}"
  }
}'
パス B:カスタムアナライザーを作成する
組み込み オプション が要件を満たさない場合は、トークナイザーと一連のフィルターを組み合わせてカスタムアナライザーを作成できます。これにより、テキスト処理パイプラインを完全に制御できます。
ステップ 1:言語に基づいてトークナイザーを選択する
コンテンツの主要言語に基づいてトークナイザーを選択します。
西洋言語
スペースで区切る言語では、次のオプションを使用できます。
トークナイザー | 動作 | 最適な用途 | 例 |
|---|---|---|---|
スペースと句読点に基づいてテキストを分割します。 | 一般的なテキスト、さまざまな句読点を含むテキスト |
| |
空白文字のみで分割します。 | 前処理済みのコンテンツ、ユーザーが書式設定したテキスト |
|
東アジア言語
辞書ベースの言語では、適切な単語分割のために専用のトークナイザーが必要です。
中国語
Tokenizer | How It Works | Best For | Examples |
|---|---|---|---|
インテリジェントアルゴリズムによる中国語の辞書ベースの分割 | 中国語コンテンツに推奨:辞書とインテリジェントアルゴリズムを組み合わせ、中国語向けに特別に設計されています |
| |
中国語辞書(cc-cedict)を使用した純粋な辞書ベースの形態素解析 |
|
|
日本語と韓国語
言語 | トークナイザー | 辞書のオプション | 最適な用途 | 例 |
|---|---|---|---|---|
日本語 | ipadic(汎用)、ipadic-neologd(現代語)、unidic(学術用) | 固有名詞を処理する形態素解析 |
| |
韓国語 | 韓国語の形態素解析 |
|
多言語または不明な言語
ドキュメント内で言語が予測できない、または混在しているコンテンツの場合:
Tokenizer | How It Works | Best For | Examples |
|---|---|---|---|
Unicode 対応のトークン化(International Components for Unicode) | 混在した文字体系、不明な言語、または単純なトークン化で十分な場合 |
|
icu を使用する場合:
-
言語の識別が現実的でない混在言語。
-
コンテンツの主要言語が明確で、全体的な意味にほとんど寄与しない外国語の単語がときどき含まれる場合(例:時折ブランド名や日本語・フランス語の技術用語が含まれる英語テキスト)。
代替アプローチ:多言語コンテンツをより正確に処理するには、多言語アナライザーまたは言語識別子の使用を検討してください。詳細については、多言語アナライザー または 言語識別子 を参照してください。
ステップ 2:精度を高めるフィルターを追加する
トークナイザーを選択 した後、具体的な検索要件とコンテンツの特性に基づいてフィルターを適用します。
一般的に使用されるフィルター
これらのフィルターは、スペースで区切るほとんどの言語構成(英語、フランス語、ドイツ語、スペイン語など)に不可欠であり、検索品質を大幅に向上させます。
フィルター | 動作 | 使用する場合 | 例 |
|---|---|---|---|
すべてのトークンを小文字に変換します。 | 汎用:大文字と小文字を区別するすべての言語に適用されます。 |
| |
単語を語根形に還元します。 | 語形変化のある言語(英語、フランス語、ドイツ語など) | 英語の場合:
| |
一般的な無意味な単語を削除します。 | ほとんどの言語:特にスペースで区切る言語に効果的です。 |
|
東アジア言語(中国語、日本語、韓国語など)の場合は、代わりに 言語固有のフィルター に注目してください。これらの言語は通常、テキスト処理に異なるアプローチを使用しており、ステミングの効果がほとんどない場合があります。
テキスト正規化フィルター
これらのフィルターはテキストのばらつきを標準化し、マッチングの一貫性を向上させます。
Filter | How It Works | When to Use | Examples |
|---|---|---|---|
アクセント付き文字を ASCII の同等文字に変換します。 | 国際的なコンテンツ、ユーザー生成コンテンツ |
|
トークンフィルタリング
文字の内容または長さに基づいて、保持するトークンを制御します。
Filter | How It Works | When to Use | Examples |
|---|---|---|---|
単独の句読点トークンを削除します。 | 句読点を単一のトークンとして返す |
| |
文字と数字のみを保持します。 | 技術的なコンテンツ、クリーンなテキスト処理 |
| |
指定した長さの範囲外のトークンを削除します。 | ノイズ(過度に長いトークン)をフィルタリングします。 |
| |
カスタムパターンベースのフィルタリング | ドメイン固有のトークン要件 |
|
言語固有のフィルター
これらのフィルターは、特定の言語特性を処理します。
フィルター | 言語 | 動作 | 例 |
|---|---|---|---|
ドイツ語 | 複合語を検索可能なコンポーネントに分割します。 |
| |
中国語 | 漢字と英数字を保持します。 |
| |
中国語 | 漢字のみを保持します。 |
| |
中国語 | 中国語トークンのピンイントークン形式を出力します。 |
|
ステップ 3:組み合わせて実装する
カスタムアナライザーを作成するには、analyzer_params ディクショナリーでトークナイザーとフィルターのリストを定義します。フィルターは、リストに記載された順序で適用されます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Example: A custom analyzer for technical content
analyzer_params = {
    "tokenizer": "whitespace",
    "filter": ["lowercase", "alphanumonly"]
}

# Applying analyzer config to target VARCHAR field in your collection schema
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params=analyzer_params,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import java.util.Arrays;
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
analyzerParams.put("filter", Arrays.asList("lowercase", "alphanumonly"));

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

analyzerParams := map[string]any{
    "tokenizer": "whitespace",
    "filter": []any{"lowercase", "alphanumonly"},
}

schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(200).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams))
use milvus::v2::prelude::*;
use serde_json::json;

let analyzer_params = serde_json::json!({
    "tokenizer": "whitespace",
    "filter": ["lowercase", "alphanumonly"]
});
let schema = CollectionSchema::new().add_field(FieldSchema::new()
    .name("text")
    .data_type(DataType::VarChar)
    .max_length(200)
    .enable_analyzer(true)
    .analyzer_params(analyzer_params));
nlohmann::json analyzer_params = {
    {"tokenizer", "whitespace"},
    {"filter", {"lowercase", "alphanumonly"}}
};
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)
                     .WithMaxLength(200)
                     .EnableAnalyzer(true)
                     .WithAnalyzerParams(analyzer_params));
import { DataType } from "@zilliz/milvus2-sdk-node";

const analyzer_params = {
  tokenizer: "whitespace",
  filter: ["lowercase", "alphanumonly"],
};

const schema = [
  {
    name: "text",
    data_type: DataType.VarChar,
    max_length: 200,
    enable_analyzer: true,
    analyzer_params,
  },
];
export textField='{
  "fieldName": "text",
  "dataType": "VarChar",
  "elementTypeParams": {
    "max_length": 200,
    "enable_analyzer": true,
    "analyzer_params": "{\"tokenizer\":\"whitespace\",\"filter\":[\"lowercase\",\"alphanumonly\"]}"
  }
}'
最終ステップ:run_analyzer でテストする
コレクションに適用する前に、必ず構成を検証してください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Sample text to analyze
sample_text = "The Milvus vector database is built for scale!"

# Run analyzer with the defined configuration
result = client.run_analyzer(sample_text, analyzer_params)
print("Analyzer output:", result)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;
import java.util.ArrayList;
import java.util.List;

ConnectConfig config = ConnectConfig.builder().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN").build();
MilvusClientV2 client = new MilvusClientV2(config);

List<String> texts = new ArrayList<>();
texts.add("The Milvus vector database is built for scale!");
RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
System.out.println(resp.getResults());
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
}

bs, _ := json.Marshal(analyzerParams)
texts := []string{"The Milvus vector database is built for scale!"}
option := milvusclient.NewRunAnalyzerOption(texts...).
    WithAnalyzerParamsStr(string(bs))
result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
}

for _, r := range result {
    for _, token := range r.Tokens {
        fmt.Println("Analyzer output:", token.Text)
    }
}
use milvus::v2::prelude::*;

    let resp = client.run_analyzer(RunAnalyzerRequest::builder()
        .texts(vec!["The Milvus vector database is built for scale!"])
        .analyzer_params(analyzer_params)
        .build()?).await?;
    println!("{:?}", resp.results());
#include "milvus/MilvusClientV2.h"
#include <iostream>

milvus::RunAnalyzerRequest request;
request.WithAnalyzerParams(analyzer_params);
request.AddText("The Milvus vector database is built for scale!");

milvus::RunAnalyzerResponse response;
status = client->RunAnalyzer(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({ address: "YOUR_CLUSTER_ENDPOINT", token: "YOUR_CLUSTER_TOKEN" });

const result = await client.runAnalyzer({
  text: "The Milvus vector database is built for scale!",
  analyzer_params,
});
console.log(result.results);
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data '{
  "text": ["The Milvus vector database is built for scale!"],
  "analyzerParams": "{\"type\": \"english\"}"
}'
確認すべき一般的な問題:
-
トークン化の過剰:技術用語が正しく分割されない
-
トークン化の不足:フレーズが適切に分割されない
-
トークンの欠落:重要な用語がフィルタリングによって除外される
詳細な使用方法については、run_analyzer を参照してください。
ユースケース別のクイックレシピ
このセクションでは、Zilliz Cloud でアナライザーを使用する際の一般的なユースケース向けに、推奨されるトークナイザーとフィルターの構成を示します。コンテンツの種類と検索要件に最も適合する組み合わせを選択してください。
アナライザーをコレクションに適用する前に、run_analyzer を使用してテキスト分析のパフォーマンスをテストし、検証することをお勧めします。
英語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "english"
        },
        {
            "type": "stop",
            "stop_words": [
                "_english_"
            ]
        }
    ]
}
中国語
{
    "tokenizer": "jieba",
    "filter": ["cnalphanumonly"]
}
アラビア語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "arabic"
        }
    ]
}
ベンガル語
{
    "tokenizer": "icu",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": []
    }]
}
フランス語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "french"
        },
        {
            "type": "stop",
            "stop_words": [
                "_french_"
            ]
        }
    ]
}
ドイツ語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "german"
        },
        {
            "type": "stop",
            "stop_words": [
                "_german_"
            ]
        }
    ]
}
ヒンディー語
{
    "tokenizer": "icu",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": []
    }]
}
韓国語
{
    "tokenizer": {
        "type": "lindera",
        "dict_kind": "ko-dic",
        "filter": [
            {
                "kind": "korean_stop_tags",
                "tags": ["SP", "SSC", "SSO", "SC", "SE", "SF", "JKS", "JKC", "JKG", "JKO", "JKB", "JKV", "JKQ", "JX", "JC", "UNK", "EP", "ETM"]
            }
        ]
    }
}
日本語
{
    "tokenizer": {
        "type": "lindera",
        "dict_kind": "ipadic"
    },
    "filter": [
        "removepunct"
    ]
}
ポルトガル語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "portuguese"
        },
        {
            "type": "stop",
            "stop_words": [
                "_portuguese_"
            ]
        }
    ]
}
ロシア語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "russian"
        },
        {
            "type": "stop",
            "stop_words": [
                "_russian_"
            ]
        }
    ]
}
スペイン語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "spanish"
        },
        {
            "type": "stop",
            "stop_words": [
                "_spanish_"
            ]
        }
    ]
}
スワヒリ語
{
    "tokenizer": "standard",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": []
    }]
}
トルコ語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "turkish"
        }
    ]
}
ウルドゥー語
{
    "tokenizer": "icu",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": []
    }]
}
混在または多言語コンテンツ
複数の言語にまたがるコンテンツや、文字体系が予測できないコンテンツを扱う場合は、icu アナライザーから始めてください。この Unicode 対応アナライザーは、混在した文字体系と記号を効果的に処理します。
基本的な多言語構成(ステミングなし):
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
analyzer_params = {
    "tokenizer": "icu",
    "filter": ["lowercase", "asciifolding"]
}
import java.util.Arrays;
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "icu");
analyzerParams.put("filter", Arrays.asList("lowercase", "asciifolding"));
analyzerParams := map[string]any{
    "tokenizer": "icu",
    "filter": []any{"lowercase", "asciifolding"},
}
use serde_json::json;

let analyzer_params = serde_json::json!({
    "tokenizer": "icu",
    "filter": ["lowercase", "asciifolding"]
});
nlohmann::json analyzer_params = {
    {"tokenizer", "icu"},
    {"filter", {"lowercase", "asciifolding"}}
};
const analyzer_params = {
  tokenizer: "icu",
  filter: ["lowercase", "asciifolding"],
};
export analyzerParams='{
  "tokenizer": "icu",
  "filter": ["lowercase", "asciifolding"]
}'
高度な多言語処理:
言語ごとのトークン動作をより細かく制御するには:
Zilliz Cloud でアナライザーを構成してプレビューする
Zilliz Cloud では、コードを書かずに Zilliz Cloud コンソール から直接テキストアナライザーを構成してテストできます。