Parquet ファイルからインポートする
Apache Parquet は、効率的なデータの保存と取得のために設計されたオープンソースの列指向データファイルフォーマットです。高性能な圧縮およびエンコーディング方式により複雑なデータを一括で管理でき、さまざまなプログラミング言語や分析ツールでサポートされています。
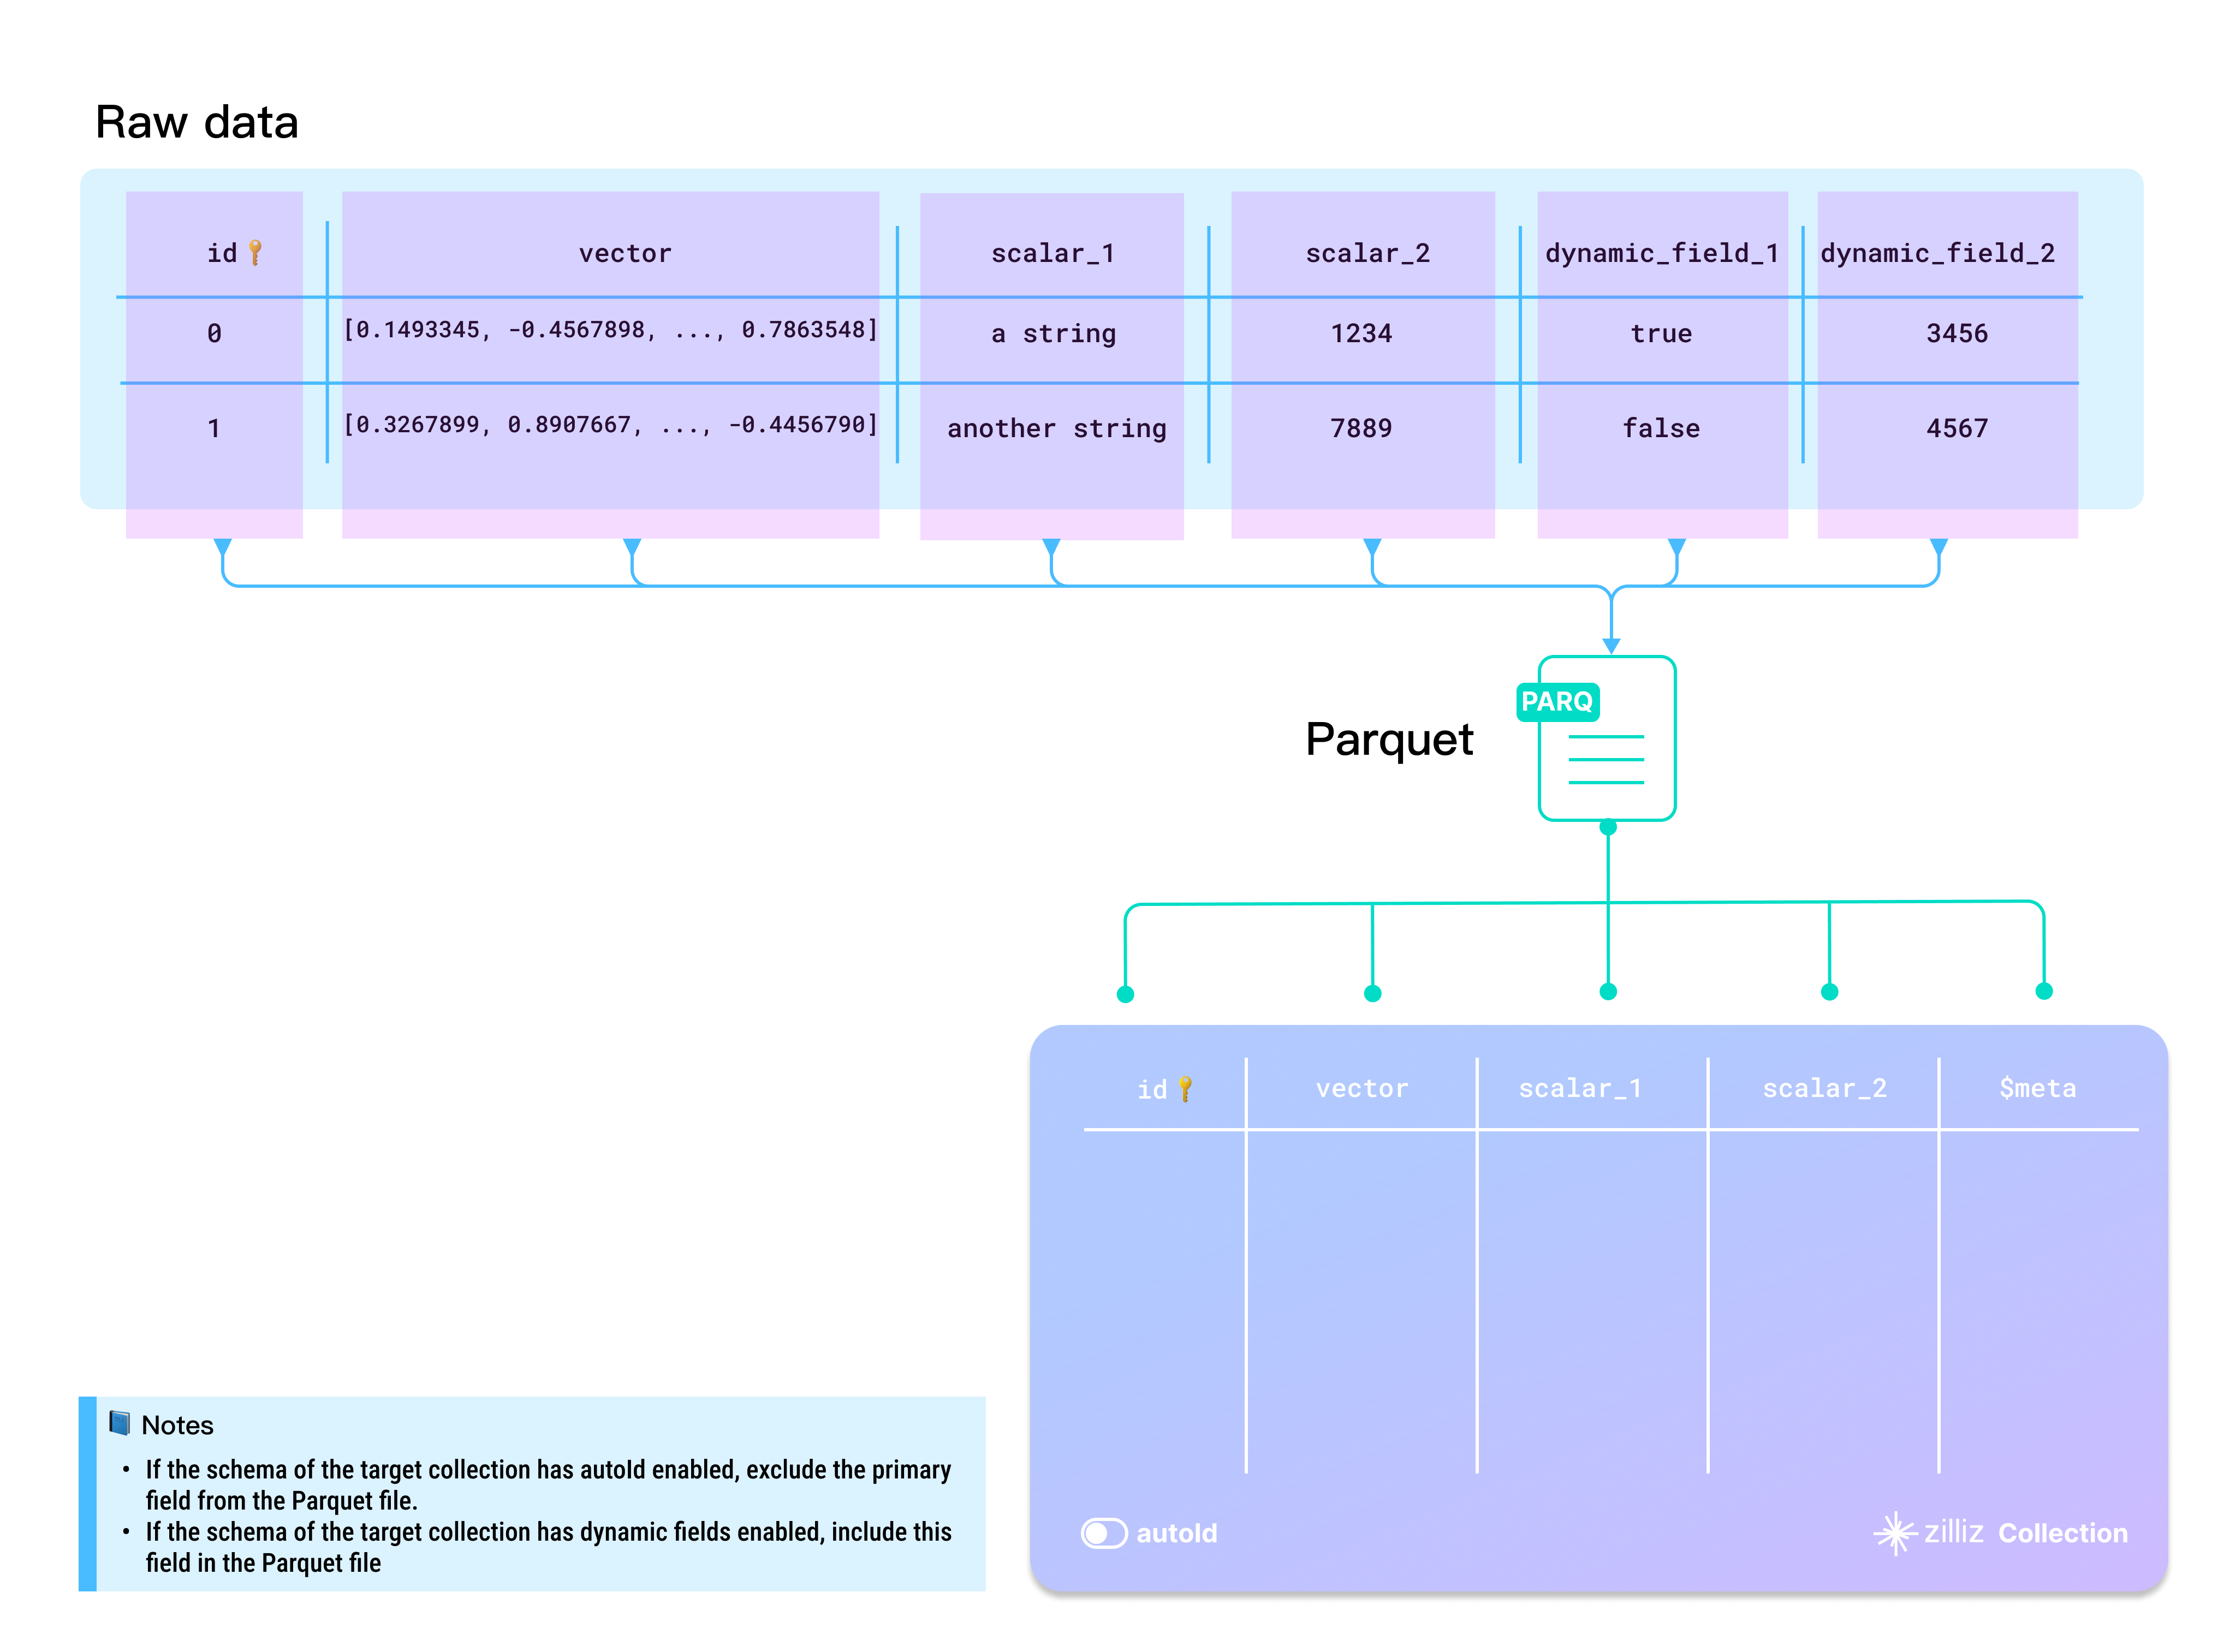
生データを Parquet ファイルに変換するには、BulkWriter ツール の使用をお勧めします。次の図は、生データを Parquet ファイルにどのようにマッピングできるかを示しています。
-
AutoID を有効にするか
id フィールドは、コレクションのプライマリフィールドとして機能します。プライマリフィールドを自動インクリメントにするには、スキーマで AutoID を有効にします。この場合、ソースデータの各行から id フィールドを除外する必要があります。
-
動的フィールドを有効にするか
ターゲットコレクションで動的フィールドが有効になっている場合、事前定義されたスキーマに含まれないフィールドを保存する必要があるときは、書き込み操作時に $meta 列を指定し、対応するキーと値のデータを提供します。
-
大文字と小文字の区別
辞書のキーとコレクションのフィールド名は大文字と小文字を区別します。データ内の辞書のキーがターゲットコレクションのフィールド名と完全に一致することを確認してください。ターゲットコレクションに id という名前のフィールドがある場合、各エンティティの辞書には id. という名前のキーが必要です。ID または Id を使用するとエラーになります。
ディレクトリ構造
データを Parquet ファイルとして準備する場合は、以下のツリー図に示すように、すべての Parquet ファイルをソースデータフォルダーに直接配置します。
├── parquet-folder
│       ├── 1.parquet
│       └── 2.parquet
データをインポートする
データの準備ができたら、次のいずれかの方法で Zilliz Cloud コレクションにインポートできます。
ファイルのサイズが比較的小さい場合は、フォルダーまたは複数パスの方法を使用して一度にすべてインポートすることをお勧めします。この方法では、インポートプロセス中に内部的な最適化が行われるため、その後のリソース消費を抑えられます。
Milvus SDK を使用して Zilliz Cloud コンソールでデータをインポートすることもできます。詳細については、データのインポート(コンソール) および データのインポート(SDK) を参照してください。
複数のパスからファイルをインポートする(推奨)
複数のパスからファイルをインポートする場合は、各 Parquet ファイルのパスを個別のリストに含め、次のコード例のように、すべてのリストを上位のリストにまとめます。
curl --request POST \
     --url "https://api.cloud.zilliz.com/v2/vectordb/jobs/import/create" \
     --header "Authorization: Bearer ${TOKEN}" \
     --header "Accept: application/json" \
     --header "Content-Type: application/json" \
     -d '{
        "clusterId": "inxx-xxxxxxxxxxxxxxx",
        "collectionName": "medium_articles",
        "partitionName": "",
        "objectUrls": [
            ["s3://bucket-name/parquet-folder-1/1.parquet"],
            ["s3://bucket-name/parquet-folder-2/1.parquet"],
            ["s3://bucket-name/parquet-folder-3/"]
         ],
        "accessKey": "",
        "secretKey": ""
    }'
フォルダーからファイルをインポートする
ソースフォルダーにインポート対象の Parquet ファイルのみが含まれている場合は、次のようにリクエストにソースフォルダーを含めるだけです。
curl --request POST \
     --url "https://api.cloud.zilliz.com/v2/vectordb/jobs/import/create" \
     --header "Authorization: Bearer ${TOKEN}" \
     --header "Accept: application/json" \
     --header "Content-Type: application/json" \
     -d '{
        "clusterId": "inxx-xxxxxxxxxxxxxxx",
        "collectionName": "medium_articles",
        "partitionName": "",
        "objectUrls": [
            ["s3://bucket-name/parquet-folder/"]
         ],
        "accessKey": "",
        "secretKey": ""
    }'
フォルダーに複数の形式のファイルが含まれている場合、リクエストは失敗します。
単一のファイルをインポートする
準備したデータファイルが単一の Parquet ファイルである場合は、次のコード例に示すようにインポートします。
curl --request POST \
     --url "https://api.cloud.zilliz.com/v2/vectordb/jobs/import/create" \
     --header "Authorization: Bearer ${TOKEN}" \
     --header "Accept: application/json" \
     --header "Content-Type: application/json" \
     -d '{
        "clusterId": "inxx-xxxxxxxxxxxxxxx",
        "collectionName": "medium_articles",
        "partitionName": "",
        "objectUrls": [
            ["s3://bucket-name/parquet-folder/1.parquet"]
         ],
        "accessKey": "",
        "secretKey": ""
    }'
ストレージパス
Zilliz Cloud は、クラウドストレージからのデータインポートをサポートしています。次の表に、データファイルに使用できるストレージパスを示します。
| クラウド | 簡単な例 |
|---|---|
| AWS S3 | s3://bucket-name/parquet-folder/ s3://bucket-name/parquet-folder/data.parquet |
| Google Cloud Storage | gs://bucket-name/parquet-folder/ gs://bucket-name/parquet-folder/data.parquet |
| Azure Bolb | https://myaccount.blob.core.windows.net/bucket-name/parquet-folder/ https://myaccount.blob.core.windows.net/bucket-name/parquet-folder/data.parquet |
制限事項
ローカルの Parquet ファイルまたはクラウドストレージの Parquet ファイルからデータをインポートする際には、いくつかの制限事項に注意する必要があります。
| インポート方法 | 1 回のインポートあたりの最大ファイル数 | 最大ファイルサイズ | 最大合計インポートサイズ |
|---|---|---|---|
| ローカルファイルから | 1 ファイル | 1 GB | 1 GB |
| オブジェクトストレージから | 1,000 ファイル | 10 GB | 1 TB |
生データを Parquet ファイルに変換するには、BulkWriter ツール の使用をお勧めします。上記の図のスキーマに基づいて準備されたサンプルデータは、こちらからダウンロードできます。