Function の概要
Zilliz Cloud は、semantic search、lexical search、hybrid search、インテリジェントな reranking を含む、モダンな検索システムを構築するための統合検索アーキテクチャを提供します。これらの機能を個別の機能として公開するのではなく、Zilliz Cloud はそれらを単一の中核抽象である Function を中心に構成しています。
Function とは何ですか?
Zilliz Cloud において、Function は、検索ワークフローの定義された段階で特定の操作を適用する、設定可能な実行ユニットです。
Function は、実用的には次の 3 つの質問に答えます。
-
この操作はいつ実行されますか? 検索前または検索後。
-
何を入力として処理しますか? 生テキスト、vector 表現、または取得された候補結果。
-
どのような出力を生成しますか? 検索に使用される vector embedding、またはユーザーに返される並べ替え済み結果。
ワークフローの観点では、Function は 2 つの異なる段階で検索に関与します。
-
Pre-search: Function は検索前に実行され、テキストを vector 表現に変換します。これらの vector が、どの候補が取得されるかを決定します。
-
Post-search: Function は候補取得後に実行され、候補セットを変更せずに結果の並び順を洗練します。
次の図は、検索ワークフローにおいて Function がどのように機能するかを抽象化して示しています。
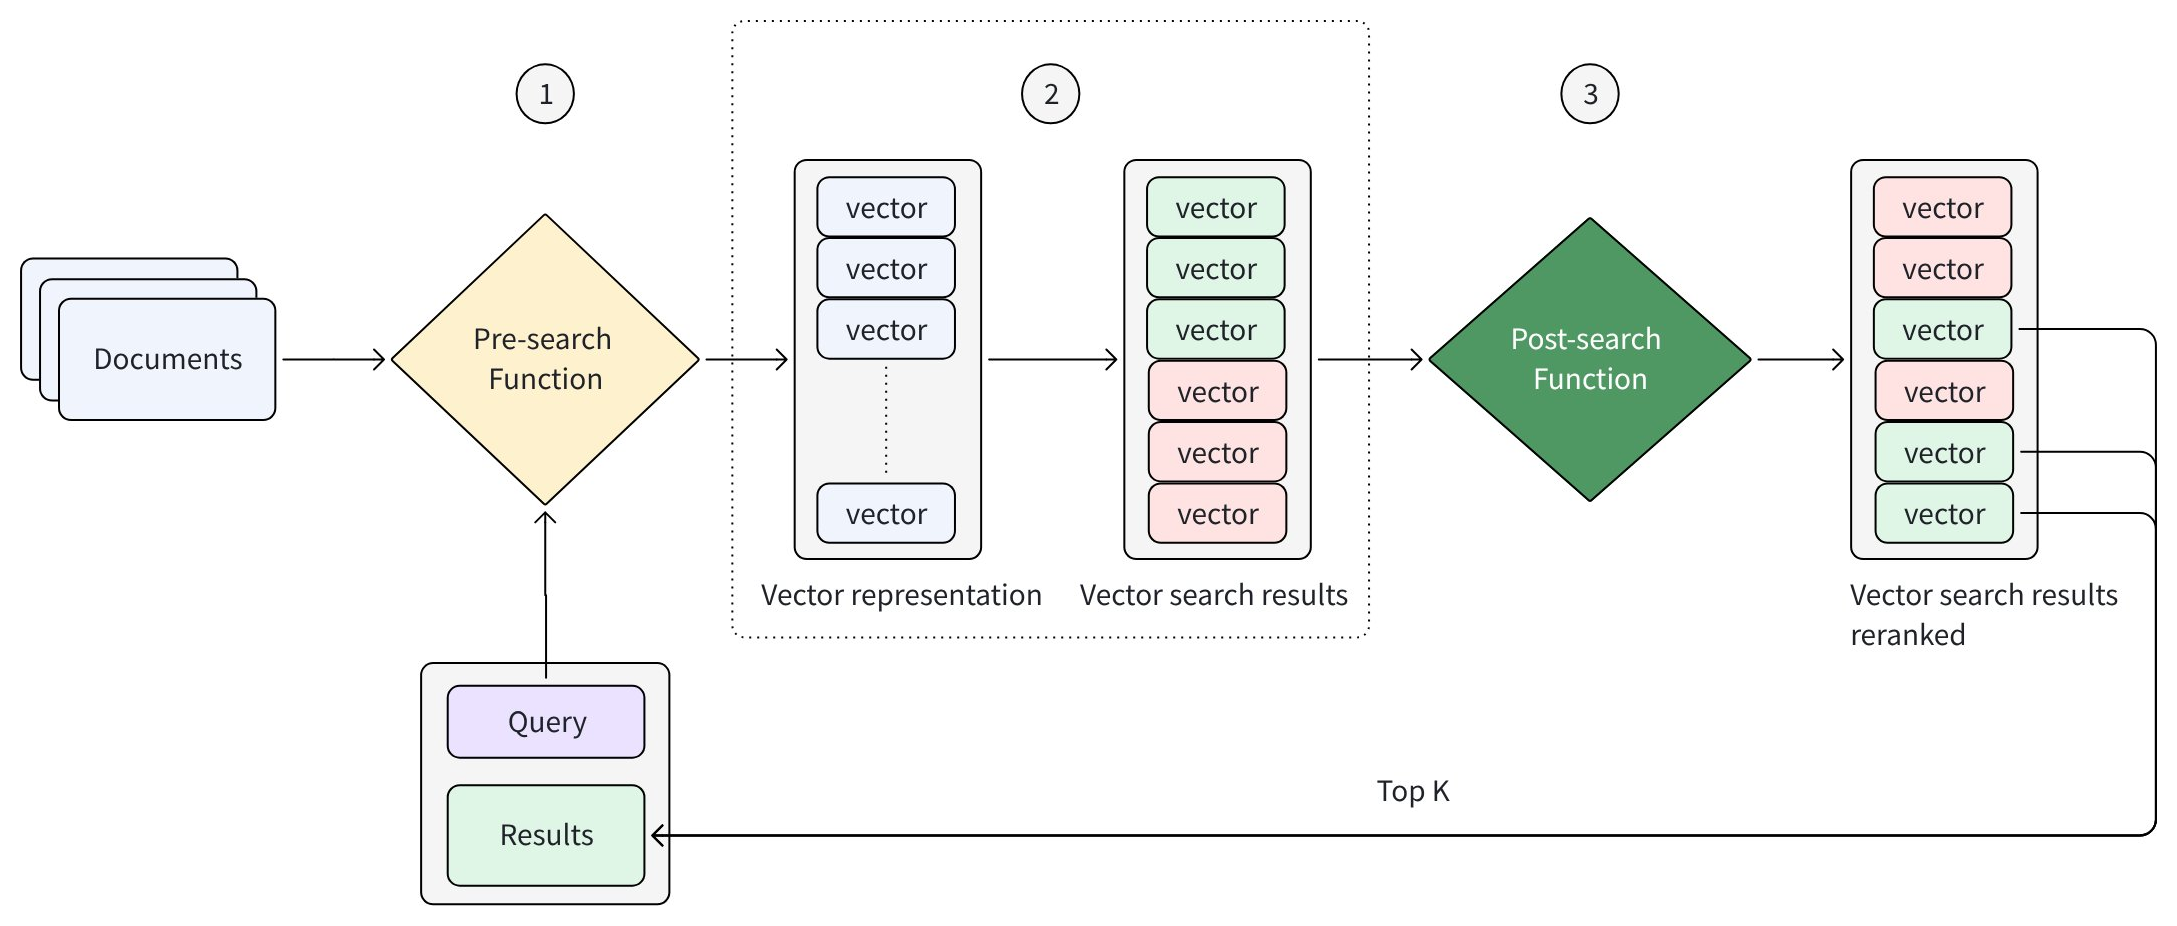
すべての検索リクエストは、同じ高レベルのフローに従います。
-
Pre-search Function が入力テキストから vector 表現を生成します
-
検索エンジンが、それらの vector に基づいて候補結果を取得します
-
(任意)Post-search Function が取得された候補を rerank します
Function のカテゴリ
Zilliz Cloud の Function は、検索ワークフロー内のどのタイミングで実行されるか と どのような役割を果たすか に基づいて分類されます。大まかには、Function は 2 つのグループに分かれます。
-
Pre-search Functions: テキストを vector embedding に変換し、候補の取得を決定する
-
Post-search Functions: 取得された候補の並び順を洗練する
Pre-search Functions: テキストを vector embedding に変換する
Pre-search Functions は候補取得の前に実行されます。その役割は、保存されたドキュメントと入力されるクエリの両方の生テキストを、検索エンジンが関連する候補を識別するために使用する vector 表現に変換することです。
異なる Pre-search Functions は異なる種類の embedding を生成し、それが検索の実行方法に直接影響します。
以下の表は、利用可能な Pre-search Functions をまとめたものです。
| Function Type | Vector Type | Description | Typical Scenarios |
|---|---|---|---|
| BM25 Function | Sparse embeddings | 用語一致、用語頻度、ドキュメント長の正規化に基づいて lexical relevance を計算します。 ローカルなメカニズムとしてデータベースエンジン内で完全に実行されます。model inference は不要です。 | キーワード主導の全文検索、ドキュメント検索やコード検索、および用語一致、低レイテンシー、決定論的な動作が重要なワークロード。 |
| Model-based Embedding Functions | Dense embeddings | 機械学習モデルを使用してテキストの意味的な意味をエンコードし、完全一致キーワードを超えた類似性ベースの検索を可能にします。 ホスト型モデルまたはサードパーティのモデルサービスを介した model inference が必要です。 | Semantic search、自然言語クエリ、Q&A や RAG パイプライン、および文字どおりの用語の重複よりも概念的な類似性が重要なユースケース。 |
すべての Pre-search Functions は、ドキュメントデータとクエリテキストの両方に一貫して適用されるため、同じ表現空間内で検索が実行されることが保証されます。
Post-search Functions: 候補結果を rerank する
Post-search Functions は 候補取得後 に適用されます。その目的は、候補セットに項目を追加したり削除したりすることなく、取得された候補のランキングを洗練すること です。
これらの Function は、検索段階から返された結果に対してのみ動作し、結果品質を向上させるために追加のランキングロジックや関連性シグナルを適用します。これらは、インデックス作成、取得、またはフィルタリングの動作には 影響せず、結果の最終的な並び順にのみ影響します。
以下の表は、利用可能な Post-search Functions をまとめたものです。
| Function Type | Operates On | Description | Typical Scenarios |
|---|---|---|---|
| Hybrid Search Rankers | hybrid search から取得された複数の結果セット | weighted ranking や reciprocal rank fusion(RRF)などの手法を使用して、異なる検索戦略から取得された結果を結合し、再バランスします。 | semantic 検索と lexical 検索を組み合わせ、バランスの取れた結果統合を必要とする hybrid search シナリオ。 |
| Rule-based Rankers | single-vector または hybrid search の候補結果 | boosting や decay-based スコアリングなど、事前定義されたルールや数値シグナルに基づいてランキングを調整します。 | ビジネス主導のランキングロジック、新しさや人気度のブースト、および予測可能で ML を使わない reranking が必要なシナリオ。 |
| Model-based Rankers | single-vector または hybrid search の候補結果 | 機械学習モデルを使用して関連性を評価し、学習済みまたは意味的シグナルに基づいて結果を並べ替えます。 | インテリジェントな reranking、semantic understanding を使用した関連性の洗練、および LLM ベースの関連性評価。 |
Post-search Functions は取得済み候補に対してのみ動作するため、これらは取得範囲ではなく結果の順序に影響する洗練ステップです。