マルチベクトルハイブリッド検索
多くのアプリケーションでは、オブジェクトをタイトルや説明などの豊富な情報、あるいはテキスト、画像、音声などの複数のモダリティで検索できます。たとえば、テキストと画像を含むツイートは、テキストまたは画像のいずれかが検索クエリのセマンティクスと一致した場合に検索対象となります。ハイブリッド検索は、これらの多様なフィールドにわたる検索を組み合わせることで、検索体験を向上させます。Zilliz Cloud は、複数のベクトルフィールドに対する検索を可能にし、複数の近似最近傍(ANN)検索を同時に実行することで、これをサポートします。マルチベクトルハイブリッド検索は、テキストと画像の両方、同じオブジェクトを表す複数のテキストフィールド、または検索品質を向上させるための密ベクトルと疎ベクトルを検索する場合に特に役立ちます。
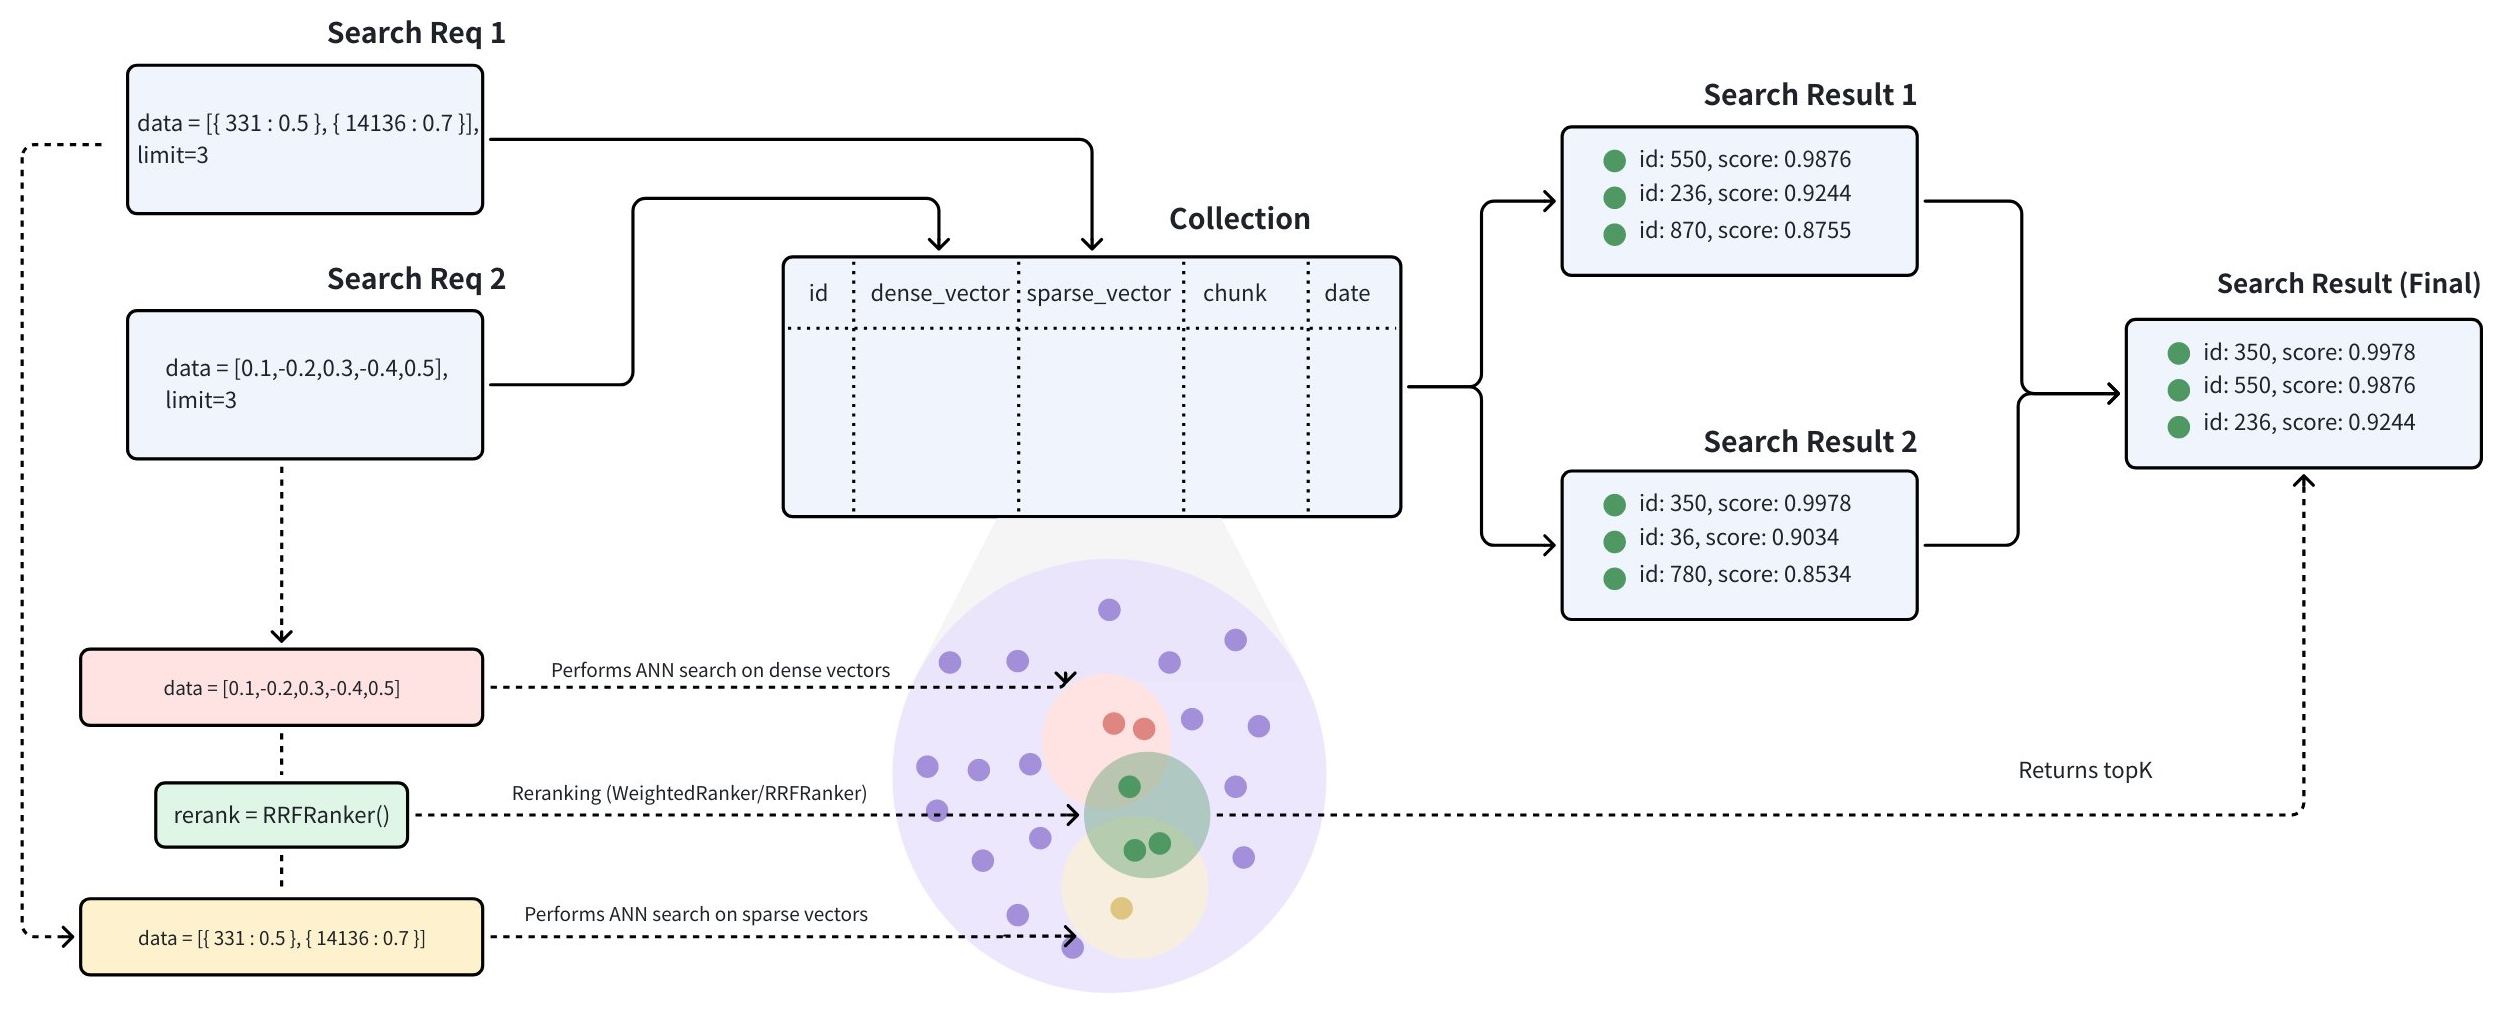
マルチベクトルハイブリッド検索は、異なる検索方法を統合するか、さまざまなモダリティからの埋め込みを横断します:
-
疎・密ベクトル検索: 密ベクトル は意味的な関係を捉えるのに優れており、疎ベクトル は正確なキーワードマッチングに非常に効果的です。ハイブリッド検索はこれらのアプローチを組み合わせ、広範な概念理解と正確な用語の関連性の両方を提供することで、検索結果を改善します。各手法の強みを活かすことで、ハイブリッド検索は個々のアプローチの限界を克服し、複雑なクエリに対して優れたパフォーマンスを提供します。セマンティック検索と全文検索を組み合わせたハイブリッド取得の詳細なガイドがあります。
-
マルチモーダルベクトル検索: マルチモーダルベクトル検索は、テキスト、画像、音声など、さまざまなデータ型を横断して検索できる強力な手法です。このアプローチの主な利点は、異なるモダリティをシームレスで一貫した検索体験に統合できることです。たとえば、商品検索では、ユーザーがテキストクエリを入力して、テキストと画像の両方で説明されている商品を探す場合があります。これらのモダリティをハイブリッド検索手法で組み合わせることで、検索精度を高めたり、検索結果を充実させたりできます。
例
各商品にテキストによる説明と画像が含まれる実際のユースケースを考えてみましょう。利用可能なデータに基づいて、次の 3 種類の検索を実行できます:
-
セマンティックテキスト検索: これは、密ベクトルを使用して商品のテキスト説明をクエリするものです。テキスト埋め込みは、BERT や Transformers などのモデル、または OpenAI などのサービスを使用して生成できます。
-
全文検索: ここでは、疎ベクトルによるキーワードマッチングを使用して商品のテキスト説明をクエリします。BM25 などのアルゴリズム、または BGE-M3 や SPLADE などの疎埋め込みモデルをこの目的に利用できます。
-
マルチモーダル画像検索: この方法では、密ベクトルを使用したテキストクエリで画像を検索します。画像埋め込みは、CLIP などのモデルで生成できます。
このガイドでは、商品の生のテキスト説明と画像埋め込みが与えられた場合に、上記の検索方法を組み合わせたマルチモーダルハイブリッド検索の例を順を追って説明します。マルチベクトルデータを保存し、リランキング戦略を使用してハイブリッド検索を実行する方法を説明します。
複数のベクトルフィールドを持つコレクションを作成する
コレクションの作成プロセスは、コレクションスキーマの定義、インデックスパラメーターの構成、コレクションの作成という 3つの重要なステップで構成されます。
スキーマを定義する
マルチベクトルハイブリッド検索では、コレクションスキーマ内に複数のベクトルフィールドを定義する必要があります。コレクションで許可されるベクトルフィールド数の制限の詳細については、Zilliz Cloud の制限 を参照してください。
この例では、次のフィールドをスキーマに組み込みます:
-
id: テキスト ID を格納するためのプライマリキーとして機能します。このフィールドのデータ型はINT64です。 -
text: テキストコンテンツを格納するために使用します。このフィールドのデータ型はVARCHARで、最大長は 1000 バイトです。enable_analyzerオプションは、全文検索を容易にするためにTrueに設定されています。 -
text_dense: テキストの密ベクトルを格納するために使用します。このフィールドのデータ型はFLOAT_VECTORで、ベクトル次元は 768 です。 -
text_sparse: テキストの疎ベクトルを格納するために使用します。このフィールドのデータ型はSPARSE_FLOAT_VECTORです。 -
image_dense: 商品画像の密ベクトルを格納するために使用します。このフィールドのデータ型はFLOAT_VETORで、ベクトル次元は 512 です。
テキストフィールドに対して全文検索を実行するために組み込みの BM25 アルゴリズムを使用するため、Milvus の Function をスキーマに追加する必要があります。詳細については、全文検索 を参照してください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# Init schema with auto_id disabled
schema = client.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/column"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
use milvus::v2::prelude::*;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

// Init schema with auto_id disabled
let schema = CollectionSchema::new()
    .add_field(
        FieldSchema::new()
            .name("id")
            .data_type(DataType::Int64)
            .primary_key(true)
            .description("product id"),
    )
    .add_field(
        FieldSchema::new()
            .name("text")
            .data_type(DataType::VarChar)
            .max_length(1000)
            .enable_analyzer(true)
            .description("raw text of product description"),
    )
    .add_field(
        FieldSchema::new()
            .name("text_dense")
            .data_type(DataType::FloatVector)
            .dimension(768)
            .description("text dense embedding"),
    )
    .add_field(
        FieldSchema::new()
            .name("text_sparse")
            .data_type(DataType::SparseFloatVector)
            .description("text sparse embedding auto-generated by the built-in BM25 function"),
    )
    .add_field(
        FieldSchema::new()
            .name("image_dense")
            .data_type(DataType::FloatVector)
            .dimension(512)
            .description("image dense embedding"),
    )
    // Add function to schema
    .add_function(
        Function::new()
            .name("text_bm25_emb")
            .input_fields(["text"])
            .output_fields(["text_sparse"])
            .function_type(FunctionType::Bm25),
    );
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25, "text bm25 function");
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse");

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField({"text_sparse", milvus::DataType::SPARSE_FLOAT_VECTOR});
schema->AddField(milvus::FieldSchema("image_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(512));
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

const address = "YOUR_CLUSTER_ENDPOINT";
const token = "YOUR_CLUSTER_TOKEN";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_analyzer: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SPARSE_FLOAT_VECTOR
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
using Milvus.Client.V2.Types;

CollectionSchema schema = new()
{
    Fields =
    {
        new FieldSchema("id", DataType.Int64, isPrimaryKey: true, description: "product id"),
        FieldSchema.CreateVarchar("text", 512, enableAnalyzer: true),
        new FieldSchema("text_dense", DataType.FloatVector) { Dimension = 768 },
        new FieldSchema("text_sparse", DataType.SparseFloatVector),
        new FieldSchema("image_dense", DataType.FloatVector) { Dimension = 512 }
    }
};
schema.Functions.Add(FunctionSchema.CreateBm25("text_bm25_emb", "text", "text_sparse", "text bm25 embedding"));
export bm25Function='{
    "name": "text_bm25_emb",
    "type": "BM25",
    "inputFieldNames": ["text"],
    "outputFieldNames": ["text_sparse"],
    "params": {}
}'

export schema='{
        "autoId": false,
        "functions": [$bm25Function],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
# Zilliz CLI
# Prerequisite: run `zilliz login` and select your cluster with `zilliz context set`.
# Save the schema to a file and use it in the next step:
cat > schema.json << 'EOF'
{
  "autoId": false,
  "functions": [
    {
      "name": "text_bm25_emb",
      "type": "BM25",
      "inputFieldNames": ["text"],
      "outputFieldNames": ["text_sparse"],
      "params": {}
    }
  ],
  "fields": [
    {"fieldName": "id", "dataType": "Int64", "isPrimary": true},
    {"fieldName": "text", "dataType": "VarChar", "elementTypeParams": {"max_length": 1000, "enable_analyzer": true}},
    {"fieldName": "text_dense", "dataType": "FloatVector", "elementTypeParams": {"dim": "768"}},
    {"fieldName": "text_sparse", "dataType": "SparseFloatVector"},
    {"fieldName": "image_dense", "dataType": "FloatVector", "elementTypeParams": {"dim": "512"}}
  ]
}
EOF
インデックスを作成する
コレクションスキーマを定義した後の次のステップは、ベクトルインデックスを構成し、類似度メトリックを指定することです。次の例では:
-
text_dense_index: テキストの密ベクトルフィールドに対して、AUTOINDEXタイプのIPメトリックタイプのインデックスが作成されます。 -
text_sparse_index: テキストの疎ベクトルフィールドには、SPARSE_INVERTED_INDEXタイプのBM25メトリックタイプのインデックスが使用されます。 -
image_dense_index: 画像の密ベクトルフィールドに対して、AUTOINDEXタイプのIPメトリックタイプのインデックスが作成されます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="AUTOINDEX",
    metric_type="BM25"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo": "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
)
use milvus::v2::prelude::*;
use std::collections::HashMap;

// Prepare index parameters
let index_params = vec![
    IndexParam::new()
        .field_name("text_dense")
        .index_name("text_dense_index")
        .index_type(IndexType::AutoIndex)
        .metric_type(MetricType::Ip),
    IndexParam::new()
        .field_name("text_sparse")
        .index_name("text_sparse_index")
        .index_type(IndexType::SparseInvertedIndex)
        .metric_type(MetricType::Bm25)
        .extra_params(HashMap::from([("inverted_index_algo".to_owned(), "DAAT_MAXSCORE".to_owned())])), // or "DAAT_WAND" or "TAAT_NAIVE"
    IndexParam::new()
        .field_name("image_dense")
        .index_name("image_dense_index")
        .index_type(IndexType::AutoIndex)
        .metric_type(MetricType::Ip),
];
std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("text_dense", "text_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
    milvus::IndexDesc("text_sparse", "text_sparse_index", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25),
    milvus::IndexDesc("image_dense", "image_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
};
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
using Milvus.Client.V2.Types;

IndexParam[] indexes =
[
    new("text_dense", "text_dense_index", IndexType.AutoIndex, MetricType.Ip),
    new("text_sparse", "text_sparse_index", IndexType.SparseInvertedIndex, MetricType.Bm25) { ExtraParams = { ["inverted_index_algo"] = "DAAT_MAXSCORE" } },
    new("image_dense", "image_dense_index", IndexType.AutoIndex, MetricType.Ip)
];
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
# Zilliz CLI
cat > indexes.json << 'EOF'
[
  {"fieldName": "text_dense", "indexName": "text_dense_index", "indexType": "AUTOINDEX", "metricType": "IP"},
  {"fieldName": "text_sparse", "indexName": "text_sparse_index", "indexType": "SPARSE_INVERTED_INDEX", "metricType": "BM25", "params": {"inverted_index_algo": "DAAT_MAXSCORE"}},
  {"fieldName": "image_dense", "indexName": "image_dense_index", "indexType": "AUTOINDEX", "metricType": "IP"}
]
EOF
コレクションを作成する
前の 2 つのステップで構成したコレクションスキーマとインデックスを使用して、demo という名前のコレクションを作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

client.create_collection(
    CreateCollectionRequest::builder()
        .collection_name("my_collection")
        .schema(schema)
        .index_params(index_params)
        .build()?,
)
.await?;
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                        .WithCollectionName("my_collection")
                                        .WithCollectionSchema(schema)
                                        .WithIndexes(std::move(indexes));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    index_params: index_params,
})
using Milvus.Client.V2.Requests.Collection;

await client.CreateCollectionAsync(new CreateCollectionReq
{
    CollectionName = "my_collection",
    Schema = schema,
    Indexes = indexes
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
# Zilliz CLI
cat > collection.json << 'EOF'
{
  "collectionName": "my_collection",
  "schema": {
    "autoId": false,
    "functions": [
      {"name": "text_bm25_emb", "type": "BM25", "inputFieldNames": ["text"], "outputFieldNames": ["text_sparse"], "params": {}}
    ],
    "fields": [
      {"fieldName": "id", "dataType": "Int64", "isPrimary": true},
      {"fieldName": "text", "dataType": "VarChar", "elementTypeParams": {"max_length": 1000, "enable_analyzer": true}},
      {"fieldName": "text_dense", "dataType": "FloatVector", "elementTypeParams": {"dim": "768"}},
      {"fieldName": "text_sparse", "dataType": "SparseFloatVector"},
      {"fieldName": "image_dense", "dataType": "FloatVector", "elementTypeParams": {"dim": "512"}}
    ]
  },
  "indexParams": [
    {"fieldName": "text_dense", "indexName": "text_dense_index", "indexType": "AUTOINDEX", "metricType": "IP"},
    {"fieldName": "text_sparse", "indexName": "text_sparse_index", "indexType": "SPARSE_INVERTED_INDEX", "metricType": "BM25", "params": {"inverted_index_algo": "DAAT_MAXSCORE"}},
    {"fieldName": "image_dense", "indexName": "image_dense_index", "indexType": "AUTOINDEX", "metricType": "IP"}
  ]
}
EOF

zilliz collection create --body file://collection.json
データを挿入する
このセクションでは、先に定義したスキーマに基づいて、my_collection コレクションにデータを挿入します。挿入時には、自動生成される値を除くすべてのフィールドに、正しい形式でデータが指定されていることを確認してください。この例では:
-
id: 商品 ID を表す整数 -
text: 商品の説明を含む文字列 -
text_dense: テキスト説明の密埋め込みを表す、768 個の浮動小数点値のリスト -
image_dense: 商品画像の密埋め込みを表す、512 個の浮動小数点値のリスト
各フィールドの密埋め込みを生成するには、同じモデルまたは異なるモデルを使用できます。この例では、2つの密埋め込みの次元が異なるため、異なるモデルによって生成されたことを示唆しています。後で各検索を定義するときは、対応するモデルを使用して適切なクエリ埋め込みを生成してください。
この例では、テキストフィールドから疎埋め込みを生成するために組み込みの BM25 関数を使用するため、疎ベクトルを手動で指定する必要はありません。ただし、BM25 を使用しない場合は、疎埋め込みを事前に計算して指定する必要があります。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
import random

# Generate example vectors
def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(text_dense1));
row1.add("image_dense", gson.toJsonTree(image_dense));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(text_dense2));
row2.add("image_dense", gson.toJsonTree(image_dense2));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(dense3));
row3.add("image_dense", gson.toJsonTree(sparse3));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }).
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
use milvus::v2::prelude::*;
use serde_json::json;

// Generate example vectors
fn generate_dense_vector(dim: usize) -> Vec<f32> {
    use rand::Rng;

    let mut rng = rand::thread_rng();
    (0..dim).map(|_| rng.gen_range(0.0f32..1.0f32)).collect()
}

let data = vec![
    json!({
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }),
    json!({
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }),
    json!({
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }),
];

let res = client.insert(
    InsertRequest::builder()
        .collection_name("my_collection")
        .rows(data)
        .build()?,
)
.await?;
#include <random>

std::vector<float>
GenerateFloatVector(int dimension) {
    std::random_device rd;
    std::mt19937 ran(rd());
    std::uniform_real_distribution<float> float_gen(0.0, 1.0);
    std::vector<float> vector(dimension);
    for (auto d = 0; d < dimension; ++d) {
        vector[d] = float_gen(ran);
    }
    return vector;
}

milvus::EntityRows data = {
    {{"id", 0}, {"text", "Red cotton t-shirt with round neck"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 0}, {"text", "Wireless noise-cancelling over-ear headphones"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 0}, {"text", "Stainless steel water bottle, 500ml"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data))
                                , response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835 /* ...remaining dims */], image_dense: [0.6366019600530924, -0.09323198122475052 /* ...remaining dims */]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597 /* ...remaining dims */], image_dense: [0.6414180010301553, 0.8976979978567611 /* ...remaining dims */]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682 /* ...remaining dims */], image_dense: [-0.6901259768402174, 0.6100500332193755 /* ...remaining dims */]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
using Milvus.Client.V2.Requests.Dml;

var textDense = Enumerable.Repeat(0.1f, 768).ToArray();
var imageDense = Enumerable.Repeat(0.1f, 512).ToArray();

await client.InsertAsync(new InsertReq
{
    CollectionName = "my_collection",
    RowsData =
    [
        new Dictionary<string, object?> { ["id"] = 0L, ["text"] = "Red cotton t-shirt with round neck", ["text_dense"] = textDense, ["image_dense"] = imageDense },
        new Dictionary<string, object?> { ["id"] = 1L, ["text"] = "Wireless noise-cancelling over-ear headphones", ["text_dense"] = textDense, ["image_dense"] = imageDense },
        new Dictionary<string, object?> { ["id"] = 2L, ["text"] = "Stainless steel water bottle, 500ml", ["text_dense"] = textDense, ["image_dense"] = imageDense }
    ]
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
# Zilliz CLI
zilliz vector insert --collection my_collection --body file://insert.json
ハイブリッド検索を実行する
ステップ 1:複数の AnnSearchRequest インスタンスを作成する
ハイブリッド検索は、AnnSearchRequest を複数作成して hybrid_search() 関数で実行することによって実装されます。各 AnnSearchRequest は、特定のベクトルフィールドに対する基本的な ANN 検索リクエストを表します。そのため、ハイブリッド検索を実行する前に、各ベクトルフィールドに対して AnnSearchRequest を作成する必要があります。
さらに、expr パラメーターを AnnSearchRequest に構成することで、ハイブリッド検索のフィルタリング条件を設定できます。フィルタリング検索 および フィルタリングの説明 を参照してください。
ハイブリッド検索では、各 AnnSearchRequest は 1 つのクエリデータのみをサポートします。
さまざまな検索ベクトルフィールドの機能を示すために、サンプルクエリを使用して 3つの AnnSearchRequest 検索リクエストを作成します。また、このプロセスでは事前に計算された密ベクトルを使用します。検索リクエストは次のベクトルフィールドを対象とします:
-
text_dense: セマンティックテキスト検索用。直接的なキーワードマッチングではなく、意味に基づく文脈理解と取得を可能にします。 -
text_sparse: 全文検索またはキーワードマッチング用。テキスト内の正確な単語またはフレーズの一致に焦点を当てます。 -
image_dense: マルチモーダルなテキストから画像への検索用。クエリのセマンティックコンテンツに基づいて関連する商品画像を取得します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "param": {},
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...}

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable");)
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .topK(2)
        .build());
queryText := entity.Text({"white headphones, quiet and comfortable"})
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
use milvus::v2::prelude::*;

let query_text = "white headphones, quiet and comfortable";
let query_dense_vector = generate_dense_vector(768);
let query_multimodal_vector = generate_dense_vector(512);

// text semantic search (dense)
let request_1 = SubSearchRequest::builder()
    .vector_field("text_dense")
    .vectors(SearchVectors::Float(vec![query_dense_vector]))
    .limit(2)
    .build()?;

// full-text search (sparse)
let request_2 = SubSearchRequest::builder()
    .vector_field("text_sparse")
    .vectors(SearchVectors::EmbeddedText(vec![query_text.to_owned()]))
    .limit(2)
    .build()?;

// text-to-image search (multimodal)
let request_3 = SubSearchRequest::builder()
    .vector_field("image_dense")
    .vectors(SearchVectors::Float(vec![query_multimodal_vector]))
    .limit(2)
    .build()?;

let reqs = vec![request_1, request_2, request_3];
auto query_text = "white headphones, quiet and comfortable";
auto query_dense_vector = generate_dense_vector(768);
auto query_multimodal_vector = generate_dense_vector(512);

auto sub_req1 = milvus::SubSearchRequest()
                    .AddFloatVector(query_dense_vector)
                    .WithAnnsField("text_dense")
                    .WithLimit(2);

auto sub_req2 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_text)
                    .WithAnnsField("text_sparse")
                    .WithLimit(2);

auto sub_req3 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_multimodal_vector)
                    .WithAnnsField("image_dense")
                    .WithLimit(2);
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835 /* ...remaining dims */]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488 /* ...remaining dims */]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "limit": 2
}
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Types;

float[] queryDenseVector = Enumerable.Repeat(0.1f, 768).ToArray();
float[] queryMultimodalVector = Enumerable.Repeat(0.1f, 512).ToArray();

// text semantic search (dense)
AnnSearchReq req1 = new()
{
    VectorFieldName = "text_dense",
    Vectors = [queryDenseVector],
    Limit = 2
};

// text semantic search (sparse / BM25)
AnnSearchReq req2 = new()
{
    VectorFieldName = "text_sparse",
    Texts = ["white headphones, quiet and comfortable"],
    MetricType = MetricType.Bm25,
    Limit = 2
};

// multimodal semantic search (dense)
AnnSearchReq req3 = new()
{
    VectorFieldName = "image_dense",
    Vectors = [queryMultimodalVector],
    Limit = 2
};
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "limit": 2
    }
 ]'
# Zilliz CLI
# Each sub-request is a JSON object in the --search array. Save it to a file:
cat > search_requests.json << 'EOF'
[
  {"data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835]], "annsField": "text_dense", "params": {"nprobe": 10}, "limit": 2},
  {"data": ["white headphones, quiet and comfortable"], "annsField": "text_sparse", "limit": 2},
  {"data": [[0.015829865178701663, 0.5264158340734488]], "annsField": "image_dense", "params": {"nprobe": 10}, "limit": 2}
]
EOF
パラメーター limit が 2 に設定されているため、各 AnnSearchRequest は 2つの検索結果を返します。この例では 3つの AnnSearchRequest インスタンスが作成されるため、合計 6つの検索結果が得られます。
ステップ 2:リランキング戦略を構成する
ANN 検索結果のセットをマージしてリランキングするには、適切なリランキング戦略を選択することが不可欠です。Zilliz Cloud は、いくつかのタイプのリランキング戦略を提供しています。これらのリランキングメカニズムの詳細については、Weighted Ranker または RRF Ranker を参照してください。
この例では、特定の検索クエリを特に重視しないため、RRFRanker 戦略を使用します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

Function ranker = Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build()
import (
    "github.com/milvus-io/milvus/client/v3/entity"
)

ranker := entity.NewFunction().
    WithName("rrf").
    WithType(entity.FunctionTypeRerank).
    WithParam("reranker", "rrf").
    WithParam("k", "100")
use milvus::v2::prelude::*;

let ranker = RRFRerank::new().k(100);
auto ranker = std::make_shared<milvus::RRFRerank>(100);
const ranker = {
  name: 'rrf',
  description: 'bm25 function',
  type: FunctionType.RERANK,
  input_field_names: [],
  params: {
      "reranker": "rrf",
      "k": 100
  },
};
using Milvus.Client.V2.Types;

RrfReranker ranker = new(100);
# Restful
export ranker='{
    "functions": [
        {
            "name": "rrf",
            "type": "Rerank",
            "inputFieldNames": [],
            "params": {
                "reranker": "rrf",
                "k": 100
            }
        }
    ]
}'
# Zilliz CLI
cat > rerank.json << 'EOF'
{"strategy": "rrf", "params": {"k": 100}}
EOF
ステップ 3:ハイブリッド検索を実行する
ハイブリッド検索を開始する前に、コレクションがロードされていることを確認してください。コレクション内のベクトルフィールドにインデックスがない場合、またはメモリにロードされていない場合、ハイブリッド検索メソッドの実行時にエラーが発生します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(ranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
use milvus::v2::prelude::*;

let res = client.hybrid_search(
    HybridSearchRequest::builder()
        .collection_name("my_collection")
        .sub_requests(reqs)
        .rerank(ranker)
        .limit(2)
        .build()?,
)
.await?;

for result in res.results() {
    println!("TopK results:");
    for row in result.rows()? {
        println!("{:?}", row.to_entity_row()?);
    }
}
auto request = milvus::HybridSearchRequest()
                .WithCollectionName("my_collection")
                .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req1)))
                .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req2)))
                .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req3)))
                .WithRerank(ranker)
                .WithLimit(2);

milvus::SearchResponse response;
auto status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

await client.loadCollection({
    collection_name: "my_collection"
})

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: ranker
});
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

SearchResp res = await client.HybridSearchAsync(new HybridSearchReq
{
    CollectionName = "my_collection",
    SearchRequests = [req1, req2, req3],
    Reranker = ranker,
    Limit = 2
});

foreach (long id in res.Ids.LongIds ?? [])
{
    Console.WriteLine(id);
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${ranker}
    },
    \"limit\": 2
}"
# Zilliz CLI
zilliz vector hybrid-search --collection my_collection --body file://hybrid.json
出力は次のとおりです:
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
ハイブリッド検索に limit=2 パラメーターを指定すると、Zilliz Cloud は 3つの検索から得られた 6つの結果をリランキングします。最終的に、最も類似した上位 2つの結果のみが返されます。