JSON Shredding
JSON shredding は、従来の行ベースストレージを最適化された列指向ストレージに変換することで JSON クエリを高速化します。JSON のデータモデリングにおける柔軟性を維持しながら、Zilliz Cloud はバックグラウンドで列指向の最適化を実行し、アクセス効率とクエリ効率を大幅に向上させます。
JSON shredding は、ほとんどの JSON クエリシナリオで有効です。特に次のような場合に、パフォーマンス上の利点がより顕著になります。
-
より大きく複雑な JSON ドキュメント - ドキュメントサイズが大きくなるほどパフォーマンス向上も大きくなります
-
読み取り中心のワークロード - JSON key に対する頻繁なフィルタリング、ソート、検索
-
混在するクエリパターン - 異なる JSON key にまたがるクエリは、ハイブリッドストレージアプローチの恩恵を受けます
仕組み
JSON shredding のプロセスは、高速な取得のためにデータを最適化する 3 つの明確なフェーズで行われます。
フェーズ 1: 取り込みと key 分類
新しい JSON ドキュメントが書き込まれると、Zilliz Cloud は継続的にそれらをサンプリングおよび分析し、各 JSON key の統計情報を構築します。この分析には、key の出現率や型の安定性(ドキュメント間でデータ型が一貫しているかどうか)が含まれます。
これらの統計に基づいて、JSON key は最適なストレージのために次のように分類されます。
JSON key のカテゴリ
| Key Type | Description |
|---|---|
| Typed keys | ほとんどのドキュメントに存在し、常に同じデータ型を持つ key(例: すべて整数またはすべて文字列)。 |
| Dynamic keys | 頻繁に現れるものの、データ型が混在している key(例: あるときは文字列、あるときは整数)。 |
| Shared keys | 設定可能な出現頻度しきい値を下回る、出現頻度の低い key またはネストされた key**。** |
分類例
次の JSON key を含むサンプル JSON データを考えてみましょう。
{"a": 10, "b": "str1", "f": 1}
{"a": 20, "b": "str2", "f": 2}
{"a": 30, "b": "str3", "f": 3}
{"a": 40, "b": 1, "f": 4}       // b becomes mixed type
{"a": 50, "b": 2, "e": "rare"}  // e appears infrequently
このデータに基づくと、key は次のように分類されます。
-
Typed keys:
aとf(常に整数) -
Dynamic keys:
b(文字列/整数の混在型) -
Shared keys:
e(出現頻度の低い key)
フェーズ 2: ストレージ最適化
フェーズ 1 での分類によってストレージレイアウトが決まります。Zilliz Cloud は、クエリ用に最適化された列指向フォーマットを使用します。
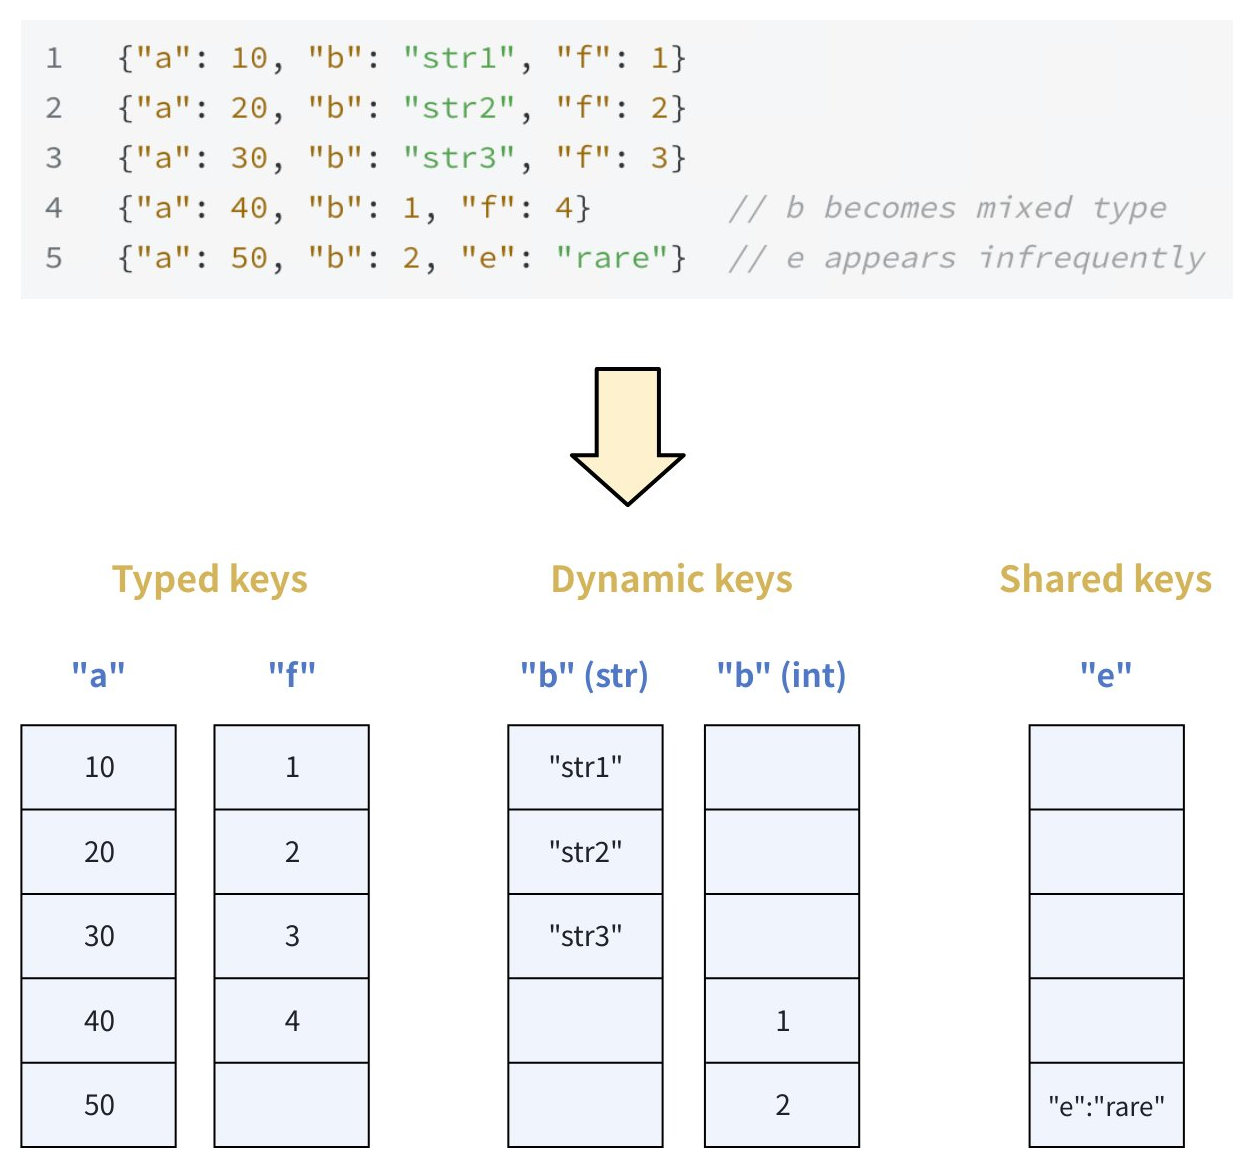
-
Shredded columns: typed key と dynamic key のデータは、専用の列に書き込まれます。この列指向ストレージにより、クエリ時の高速で直接的なスキャンが可能になります。Zilliz Cloud は、ドキュメント全体を処理することなく、特定の key に必要なデータだけを読み取れるためです。
-
Shared column: すべての shared key は、1 つのコンパクトなバイナリ JSON 列にまとめて保存されます。この列には shared-key の inverted index が構築されます。この index は、低頻度 key に対するクエリを高速化するうえで重要です。Zilliz Cloud はデータをすばやく絞り込み、指定された key を含む行だけに検索空間を効果的に限定できます。
フェーズ 3: クエリ実行
最後のフェーズでは、最適化されたストレージレイアウトを活用し、各クエリ述語に対して最も高速なパスをインテリジェントに選択します。
-
Fast path: typed/dynamic key に対するクエリ(例:
json['a'] < 100)は、専用列に直接アクセスします -
Optimized path: shared key に対するクエリ(例:
json['e'] = 'rare')は、inverted index を使用して関連ドキュメントをすばやく特定します
パフォーマンスベンチマーク
テストでは、異なる JSON key タイプおよびクエリパターン全体で大幅なパフォーマンス向上が確認されました。
テスト環境と方法論
-
ハードウェア: 1 core/8GB cluster
-
データセット: JSONBench の 100 万件のドキュメント
-
平均ドキュメントサイズ: 478.89 bytes
-
テスト時間: QPS とレイテンシを 100 秒間測定
結果: typed keys
このテストでは、ほとんどのドキュメントに存在する key に対するクエリ時のパフォーマンスを測定しました。
| Query Expression | Key Value Type | QPS (without shredding) | QPS (with shredding) | Performance Boost |
|---|---|---|---|---|
json['time_us'] > 0 | Integer | 8.69 | 287.50 | 33x |
json['kind'] == 'commit' | String | 8.42 | 126.1 | 14.9x |
結果: shared keys
このテストでは、「shared」カテゴリに分類される、まばらでネストされた key に対するクエリに焦点を当てました。
| Query Expression | Key Value Type | QPS (without shredding) | QPS (with shredding) | Performance Boost |
|---|---|---|---|---|
json['identity']['seq'] > 0 | Nested Integer | 4.33 | 385 | 88.9x |
json['identity']['did'] == 'xxxxx' | Nested String | 7.6 | 352 | 46.3x |
主な知見
-
Shared key クエリ は、最も劇的な改善を示します(最大 89 倍高速)
-
Typed key クエリ は、一貫して 15~30 倍のパフォーマンス向上をもたらします
-
すべてのクエリタイプ が JSON Shredding の恩恵を受け、パフォーマンス低下はありません
FAQ
-
JSON shredding と JSON indexing はどのように選べばよいですか?
-
JSON shredding は、ドキュメント内に頻繁に現れる key、特に複雑な JSON 構造に最適です。列指向ストレージと inverted indexing の利点を組み合わせており、多くの異なる key をクエリする読み取り中心のシナリオに適しています。ただし、非常に小さい JSON ドキュメントには推奨されません。パフォーマンス向上が最小限だからです。key の値が JSON ドキュメント全体のサイズに占める割合が小さいほど、shredding によるパフォーマンス最適化の効果は高くなります。
-
JSON indexing は、特定の key ベースクエリを対象とした最適化により適しており、ストレージオーバーヘッドも低くなります。よりシンプルな JSON 構造に適しています。なお、JSON shredding は配列内の key に対するクエリには対応していないため、それらを高速化するには JSON index が必要です。
詳細については、JSON Field Overview を参照してください。
-