言語識別子
language_identifier は、言語分析プロセスを自動化することで、Zilliz Cloud のテキスト検索機能を強化するために設計された専用のトークナイザーです。主な機能は、テキストフィールドの言語を検出し、その言語に最も適した事前設定済みのアナライザーを動的に適用することです。これは、さまざまな言語を扱うアプリケーションに特に役立ち、入力ごとに言語を手動で割り当てる必要をなくします。
テキストデータを適切な処理パイプラインにインテリジェントにルーティングすることで、language_identifier は多言語データの取り込みを効率化し、後続の検索および取得操作に正確なトークン化を保証します。
言語検出ワークフロー
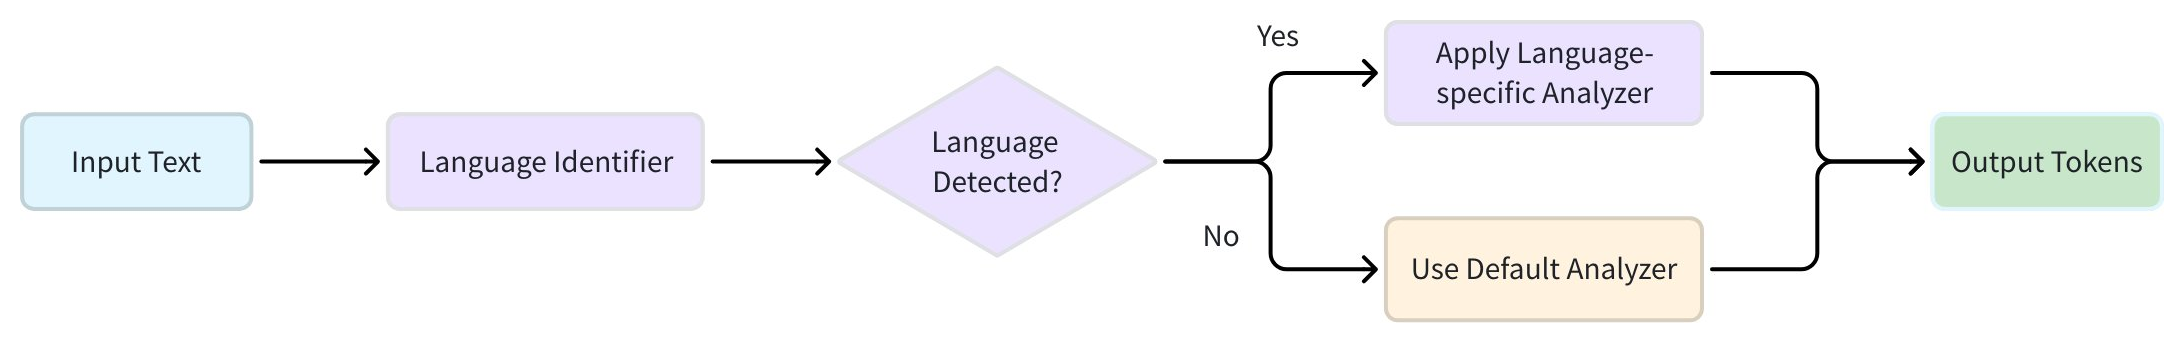
language_identifier は、テキスト文字列を処理するために一連のステップを実行します。このワークフローは、正しく構成する方法をユーザーが理解するうえで重要です。
-
入力: ワークフローは、テキスト文字列を入力として開始します。
-
言語検出: この文字列はまず言語検出エンジンに渡され、エンジンが言語の識別を試みます。Zilliz Cloud は
whatlangとlinguaの 2 つのエンジンをサポートしています。 -
アナライザーの選択:
-
成功: 言語が正常に検出された場合、システムは検出された言語名に対応するアナライザーが
analyzersディクショナリに構成されているかどうかを確認します。一致が見つかると、システムは指定されたアナライザーを入力テキストに適用します。たとえば、検出された "Mandarin" テキストはjiebaトークナイザーにルーティングされます。 -
フォールバック: 検出に失敗した場合、または言語は正常に検出されたもののその言語に対応するアナライザーを指定していない場合、システムは事前構成済みの
defaultアナライザー をデフォルトで使用します。これは明確にしておくべき重要な点です。defaultアナライザーは、検出の失敗と一致するアナライザーの欠如の両方に対するフォールバックです。
-
適切なアナライザーが選択されると、テキストはトークン化および処理され、ワークフローが完了します。
利用可能な言語検出エンジン
Zilliz Cloud では、2 つの言語検出エンジンから選択できます:
選択は、アプリケーションの具体的なパフォーマンスと精度の要件によって異なります。
| エンジン | 速度 | 精度 | 出力形式 | 最適な用途 |
|---|---|---|---|---|
whatlang | 高速 | ほとんどの言語で良好 | 言語名(例:"English"、"Mandarin"、"Japanese")リファレンス: Language column in supported languages table | 速度が重要なリアルタイムアプリケーション |
lingua | 低速 | より高い精度(特に短いテキスト) | 英語の言語名(例:"English"、"Chinese"、"Japanese")リファレンス: Supported languages list | 速度よりも精度が重要なアプリケーション |
エンジンの命名規則は重要な考慮事項です。両方のエンジンは言語名を英語で返しますが、一部の言語では異なる用語を使用します(例:whatlang は Mandarin を返し、lingua は Chinese を返します)。アナライザーのキーは、選択した検出エンジンが返す名前と完全に一致する必要があります。
構成
language_identifier トークナイザーを正しく使用するには、その構成を定義して適用するために次のステップを実行する必要があります。
ステップ 1: 言語とアナライザーを選択する
language_identifier の設定の中核は、サポートする予定の特定の言語にアナライザーを合わせて調整することです。システムは、検出された言語を正しいアナライザーと照合することで機能するため、このステップは正確なテキスト処理に不可欠です。
以下は、言語を適切な Zilliz Cloud アナライザーにマッピングするための推奨事項です。この表は、言語検出エンジンの出力と最適なツールをつなぐ役割を果たします。
| 言語(検出器の出力) | 推奨アナライザー | 説明 |
|---|---|---|
English | type: english | ステミングとストップワードフィルタリングを備えた標準の英語トークン化。 |
Mandarin(whatlang 経由)または Chinese(lingua 経由) | tokenizer: jieba | スペースで区切られていないテキストに対する中国語の単語分割。 |
Japanese | tokenizer: icu | 日本語を含む複雑な文字体系に対応する堅牢なトークナイザー。 |
French | type: standard, filter: ["lowercase", "asciifolding"] | フランス語のアクセントと文字を処理するカスタム構成。 |
-
一致が重要: アナライザーの名前は、検出エンジンの言語出力と完全に一致する必要があります。たとえば、
whatlangを使用している場合、中国語テキストのキーはMandarinである必要があります。 -
ベストプラクティス: 上の表には一般的な言語の推奨構成をいくつか示していますが、完全なリストではありません。アナライザーの選択に関するより包括的なガイドについては、ユースケースに適したアナライザーを選択する を参照してください。
-
検出器の出力:検出エンジンが返す言語名の完全なリストについては、Whatlang supported languages table と Lingua supported languages list を参照してください。
ステップ 2: analyzer_params を定義する
Zilliz Cloud で language_identifier トークナイザーを使用するには、次の主要なコンポーネントを含むディクショナリを作成します:
必須コンポーネント:
-
analyzers構成セット – すべてのアナライザー構成を含むディクショナリ。次のものを含める必要があります:-
default– 言語検出が失敗した場合、または一致するアナライザーが見つからない場合に使用されるフォールバックアナライザー -
言語固有のアナライザー – それぞれ
<analyzer_name>: <analyzer_config>として定義されます。ここで:-
analyzer_nameは、選択した検出エンジンの出力と一致します(例:"English"、"Japanese") -
analyzer_configは標準のアナライザーパラメーター形式に従います(アナライザーの概要 を参照)
-
-
オプションコンポーネント:
-
identifier– 使用する言語検出エンジン(whatlangまたはlingua)を指定します。指定しない場合、デフォルトはwhatlangです -
mapping– アナライザーのカスタムエイリアスを作成し、検出エンジンの正確な出力形式の代わりにわかりやすい名前を使用できるようにします
トークナイザーは、まず入力テキストの言語を検出し、次に構成から適切なアナライザーを選択することで動作します。検出に失敗した場合、または一致するアナライザーが存在しない場合は、自動的に default アナライザーにフォールバックします。
推奨: 名前の直接一致
アナライザー名は、選択した言語検出エンジンの出力と完全に一致している必要があります。この方法はより簡単で、潜在的な混乱を避けることができます。
whatlang と lingua の両方について、それぞれのドキュメントに示されている言語名を使用します:
-
whatlang supported languages(「Language」列を使用)
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",  # Must be `language_identifier`
        "identifier": "whatlang",  # or `lingua`
        "analyzers": {  # A set of analyzer configs
            "default": {
                "tokenizer": "standard"  # fallback if language detection fails
            },
            "English": {  # Analyzer name that matches whatlang output
                "type": "english"
            },
            "Mandarin": {  # Analyzer name that matches whatlang output
                "tokenizer": "jieba"
            }
        }
    }
}
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();

Map<String, Object> defaultAnalyzer = new HashMap<>();
defaultAnalyzer.put("tokenizer", "standard");

Map<String, Object> englishAnalyzer = new HashMap<>();
englishAnalyzer.put("type", "english");

Map<String, Object> mandarinAnalyzer = new HashMap<>();
mandarinAnalyzer.put("tokenizer", "jieba");

Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", defaultAnalyzer);
analyzers.put("English", englishAnalyzer);
analyzers.put("Mandarin", mandarinAnalyzer);

Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "whatlang");
tokenizer.put("analyzers", analyzers);

analyzerParams.put("tokenizer", tokenizer);
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "whatlang",
        "analyzers": map[string]any{
            "default":  map[string]any{"tokenizer": "standard"},
            "English":  map[string]any{"type": "english"},
            "Mandarin": map[string]any{"tokenizer": "jieba"},
        },
    },
}
let analyzer_params = serde_json::json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
});
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "whatlang"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"Mandarin", {{"tokenizer", "jieba"}}}
        }}
    }}
};
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
};
using System.Collections.Generic;

Dictionary<string, object> analyzerParams = new()
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier", // Must be `language_identifier`
        ["identifier"] = "whatlang", // or `lingua`
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object> { ["tokenizer"] = "standard" }, // fallback if language detection fails
            ["English"] = new Dictionary<string, object> { ["type"] = "english" },
            ["Mandarin"] = new Dictionary<string, object> { ["tokenizer"] = "jieba" }
        }
    }
};
# restful
analyzerParams='{
  "tokenizer": {
    "type": "language_identifier",
    "identifier": "whatlang",
    "analyzers": {
      "default": {
        "tokenizer": "standard"
      },
      "English": {
        "type": "english"
      },
      "Mandarin": {
        "tokenizer": "jieba"
      }
    }
  }
}'
代替方法: マッピングを使用したカスタム名
カスタムのアナライザー名を使用する場合、または既存の構成との互換性を維持する必要がある場合は、mapping パラメーターを使用できます。これによりアナライザーのエイリアスが作成され、元の検出エンジン名とカスタム名の両方が機能します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {
                "tokenizer": "standard"
            },
            "english_analyzer": {  # Custom analyzer name
                "type": "english"
            },
            "chinese_analyzer": {  # Custom analyzer name
                "tokenizer": "jieba"
            }
        },
        "mapping": {
            "English": "english_analyzer",   # Maps detection output to custom name
            "Chinese": "chinese_analyzer"
        }
    }
}
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();

Map<String, Object> defaultAnalyzer = new HashMap<>();
defaultAnalyzer.put("tokenizer", "standard");

Map<String, Object> englishAnalyzer = new HashMap<>();
englishAnalyzer.put("type", "english");

Map<String, Object> chineseAnalyzer = new HashMap<>();
chineseAnalyzer.put("tokenizer", "jieba");

Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", defaultAnalyzer);
analyzers.put("english_analyzer", englishAnalyzer);
analyzers.put("chinese_analyzer", chineseAnalyzer);

Map<String, Object> mapping = new HashMap<>();
mapping.put("English", "english_analyzer");
mapping.put("Chinese", "chinese_analyzer");

Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "lingua");
tokenizer.put("analyzers", analyzers);
tokenizer.put("mapping", mapping);

analyzerParams.put("tokenizer", tokenizer);
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "lingua",
        "analyzers": map[string]any{
            "default":           map[string]any{"tokenizer": "standard"},
            "english_analyzer":  map[string]any{"type": "english"},
            "chinese_analyzer":  map[string]any{"tokenizer": "jieba"},
        },
        "mapping": map[string]any{
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer",
        },
    },
}
let analyzer_params = serde_json::json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "english_analyzer": {"type": "english"},
            "chinese_analyzer": {"tokenizer": "jieba"}
        },
        "mapping": {
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer"
        }
    }
});
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "lingua"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"english_analyzer", {{"type", "english"}}},
            {"chinese_analyzer", {{"tokenizer", "jieba"}}}
        }},
        {"mapping", {
            {"English", "english_analyzer"},
            {"Chinese", "chinese_analyzer"}
        }}
    }}
};
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "english_analyzer": {"type": "english"},
            "chinese_analyzer": {"tokenizer": "jieba"}
        },
        "mapping": {
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer"
        }
    }
};
using System.Collections.Generic;

Dictionary<string, object> analyzerParams = new()
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier",
        ["identifier"] = "lingua",
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object> { ["tokenizer"] = "standard" },
            ["english_analyzer"] = new Dictionary<string, object> { ["type"] = "english" }, // Custom analyzer name
            ["chinese_analyzer"] = new Dictionary<string, object> { ["tokenizer"] = "jieba" }
        },
        ["mapping"] = new Dictionary<string, object>
        {
            ["English"] = "english_analyzer",
            ["Chinese"] = "chinese_analyzer"
        }
    }
};
# restful
analyzerParams='{
  "tokenizer": {
    "type": "language_identifier",
    "identifier": "lingua",
    "analyzers": {
      "default": {
        "tokenizer": "standard"
      },
      "english_analyzer": {
        "type": "english"
      },
      "chinese_analyzer": {
        "tokenizer": "jieba"
      }
    },
    "mapping": {
      "English": "english_analyzer",
      "Chinese": "chinese_analyzer"
    }
  }
}'
analyzer_params を定義した後、コレクションスキーマを定義する際に VARCHAR フィールドに適用できます。これにより、Zilliz Cloud は指定されたアナライザーを使用してそのフィールド内のテキストを処理し、効率的なトークン化とフィルタリングを実行できます。詳細については、Example use を参照してください。
例
一般的なシナリオですぐに使用できる構成をいくつか示します。各例には構成と検証コードの両方が含まれているため、セットアップをすぐにテストできます。
英語と中国語の検出
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient

# Configuration
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
}

# Test the configuration
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# English text
result_en = client.run_analyzer("The Milvus vector database is built for scale!", analyzer_params)
print("English:", result_en)
# Output:
# English: ['The', 'Milvus', 'vector', 'database', 'is', 'built', 'for', 'scale']

# Chinese text
result_cn = client.run_analyzer("Milvus向量数据库专为大规模应用而设计", analyzer_params)
print("Chinese:", result_cn)
# Output:
# Chinese: ['Milvus', '向量', '数据', '据库', '数据库', '专', '为', '大规', '规模', '大规模', '应用', '而', '设计']
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;
import java.util.ArrayList;
import java.util.Collections;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

// Configuration
Map<String, Object> analyzerParams = new HashMap<>();
Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", Collections.singletonMap("tokenizer", "standard"));
analyzers.put("English", Collections.singletonMap("type", "english"));
analyzers.put("Mandarin", Collections.singletonMap("tokenizer", "jieba"));
Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "whatlang");
tokenizer.put("analyzers", analyzers);
analyzerParams.put("tokenizer", tokenizer);

// Test the configuration
ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// English text
RunAnalyzerResp resultEn = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(Collections.singletonList("The Milvus vector database is built for scale!"))
        .analyzerParams(analyzerParams)
        .build());
System.out.println("English: " + resultEn.getResults());

// Chinese text
RunAnalyzerResp resultCn = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(Collections.singletonList("Milvus向量数据库专为大规模应用而设计"))
        .analyzerParams(analyzerParams)
        .build());
System.out.println("Chinese: " + resultCn.getResults());
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

// Configuration
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "whatlang",
        "analyzers": map[string]any{
            "default":  map[string]any{"tokenizer": "standard"},
            "English":  map[string]any{"type": "english"},
            "Mandarin": map[string]any{"tokenizer": "jieba"},
        },
    },
}

// Test the configuration
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

bs, _ := json.Marshal(analyzerParams)

// English text
resultEn, err := client.RunAnalyzer(ctx, milvusclient.NewRunAnalyzerOption(
    "The Milvus vector database is built for scale!").WithAnalyzerParamsStr(string(bs)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println("English:", resultEn)

// Chinese text
resultCn, err := client.RunAnalyzer(ctx, milvusclient.NewRunAnalyzerOption(
    "Milvus向量数据库专为大规模应用而设计").WithAnalyzerParamsStr(string(bs)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println("Chinese:", resultCn)
use milvus::v2::error::Result;
use milvus::v2::prelude::*;
use serde_json::json;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

// Configuration
let analyzer_params = json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
});

// English text
let result_en = client.run_analyzer(
    RunAnalyzerRequest::builder()
        .texts(["The Milvus vector database is built for scale!".to_string()])
        .analyzer_params(analyzer_params.clone())
        .build()?,
).await?;
println!("English: {:?}", result_en.results());

// Chinese text
let result_cn = client.run_analyzer(
    RunAnalyzerRequest::builder()
        .texts(["Milvus向量数据库专为大规模应用而设计".to_string()])
        .analyzer_params(analyzer_params)
        .build()?,
).await?;
println!("Chinese: {:?}", result_cn.results());
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <string>

// Configuration
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "whatlang"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"Mandarin", {{"tokenizer", "jieba"}}}
        }}
    }}
};

// Test the configuration
auto client = milvus::MilvusClientV2::Create();
milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

// English text
milvus::RunAnalyzerResponse response;
status = client->RunAnalyzer(milvus::RunAnalyzerRequest()
                                .AddText("The Milvus vector database is built for scale!")
                                .WithAnalyzerParams(analyzer_params),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
for (const auto& result : response.Results()) {
    for (const auto& token : result.Tokens()) {
        std::cout << token.token_ << " ";
    }
    std::cout << std::endl;
}

// Chinese text
status = client->RunAnalyzer(milvus::RunAnalyzerRequest()
                                .AddText("Milvus向量数据库专为大规模应用而设计")
                                .WithAnalyzerParams(analyzer_params),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
for (const auto& result : response.Results()) {
    for (const auto& token : result.Tokens()) {
        std::cout << token.token_ << " ";
    }
    std::cout << std::endl;
}
// javascript
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

// Configuration
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
};

// Test the configuration
const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN'
});

// English text
const resultEn = await client.runAnalyzer({
  text: 'The Milvus vector database is built for scale!',
  analyzer_params: analyzer_params
});
console.log('English:', resultEn);

// Chinese text
const resultCn = await client.runAnalyzer({
  text: 'Milvus向量数据库专为大规模应用而设计',
  analyzer_params: analyzer_params
});
console.log('Chinese:', resultCn);
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Utility;
using Milvus.Client.V2.Responses.Utility;
using Milvus.Client.V2.Types;

// Configuration
Dictionary<string, object> analyzerParams = new()
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier",
        ["identifier"] = "whatlang",
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object> { ["tokenizer"] = "standard" },
            ["English"] = new Dictionary<string, object> { ["type"] = "english" },
            ["Mandarin"] = new Dictionary<string, object> { ["tokenizer"] = "jieba" }
        }
    }
};

MilvusClientV2 client = new(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    Username = "root",
    Password = "Milvus"
});

// English text
RunAnalyzerResp resultEn = await client.RunAnalyzerAsync(new RunAnalyzerReq
{
    AnalyzerParams = analyzerParams,
    Texts = ["The Milvus vector database is built for scale!"]
});
Console.WriteLine("English: " + string.Join(", ", resultEn.Results.SelectMany(r => r.Tokens).Select(t => t.Token)));

// Chinese text
RunAnalyzerResp resultCn = await client.RunAnalyzerAsync(new RunAnalyzerReq
{
    AnalyzerParams = analyzerParams,
    Texts = ["Milvus向量数据库专为大规模应用而设计"]
});
Console.WriteLine("Chinese: " + string.Join(", ", resultCn.Results.SelectMany(r => r.Tokens).Select(t => t.Token)));
# restful
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"whatlang\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"Mandarin\":{\"tokenizer\":\"jieba\"}}}}",
    "text": ["The Milvus vector database is built for scale!"]
  }'

curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"whatlang\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"Mandarin\":{\"tokenizer\":\"jieba\"}}}}",
    "text": ["Milvus向量数据库专为大规模应用而设计"]
  }'
アクセント正規化を使用するヨーロッパ言語
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
# Configuration for French, German, Spanish, etc.
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
}

# Test with accented text
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

result_fr = client.run_analyzer("Café français très délicieux", analyzer_params)
print("French:", result_fr)
# Output:
# French: ['cafe', 'francais', 'tres', 'delicieux']
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;

// Configuration for French, German, Spanish, etc.
Map<String, Object> analyzerParams = new HashMap<>();
Map<String, Object> frenchAnalyzer = new HashMap<>();
frenchAnalyzer.put("tokenizer", "standard");
frenchAnalyzer.put("filter", Arrays.asList("lowercase", "asciifolding"));
Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", Collections.singletonMap("tokenizer", "standard"));
analyzers.put("English", Collections.singletonMap("type", "english"));
analyzers.put("French", frenchAnalyzer);
Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "lingua");
tokenizer.put("analyzers", analyzers);
analyzerParams.put("tokenizer", tokenizer);

// Test with accented text
ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

RunAnalyzerResp resultFr = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(Collections.singletonList("Café français très délicieux"))
        .analyzerParams(analyzerParams)
        .build());
System.out.println("French: " + resultFr.getResults());
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

// Configuration for French, German, Spanish, etc.
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "lingua",
        "analyzers": map[string]any{
            "default": map[string]any{"tokenizer": "standard"},
            "English": map[string]any{"type": "english"},
            "French": map[string]any{
                "tokenizer": "standard",
                "filter":    []any{"lowercase", "asciifolding"},
            },
        },
    },
}

// Test with accented text
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

bs, _ := json.Marshal(analyzerParams)

resultFr, err := client.RunAnalyzer(ctx, milvusclient.NewRunAnalyzerOption(
    "Café français très délicieux").WithAnalyzerParamsStr(string(bs)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println("French:", resultFr)
use milvus::v2::error::Result;
use milvus::v2::prelude::*;
use serde_json::json;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

// Configuration for French, German, Spanish, etc.
let analyzer_params = json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
});

// Test with accented text
let result_fr = client.run_analyzer(
    RunAnalyzerRequest::builder()
        .texts(["Café français très délicieux".to_string()])
        .analyzer_params(analyzer_params)
        .build()?,
).await?;
println!("French: {:?}", result_fr.results());
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <string>

// Configuration for French, German, Spanish, etc.
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "lingua"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"French", {
                {"tokenizer", "standard"},
                {"filter", {"lowercase", "asciifolding"}}
            }}
        }}
    }}
};

// Test with accented text
auto client = milvus::MilvusClientV2::Create();
milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::RunAnalyzerResponse response;
status = client->RunAnalyzer(milvus::RunAnalyzerRequest()
                                .AddText("Café français très délicieux")
                                .WithAnalyzerParams(analyzer_params),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
for (const auto& result : response.Results()) {
    for (const auto& token : result.Tokens()) {
        std::cout << token.token_ << " ";
    }
    std::cout << std::endl;
}
// javascript
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

// Configuration for French, German, Spanish, etc.
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
};

// Test with accented text
const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN'
});

const resultFr = await client.runAnalyzer({
  text: 'Café français très délicieux',
  analyzer_params: analyzer_params
});
console.log('French:', resultFr);
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Utility;
using Milvus.Client.V2.Responses.Utility;
using Milvus.Client.V2.Types;

// Configuration for French, German, Spanish, etc.
Dictionary<string, object> analyzerParams = new()
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier",
        ["identifier"] = "lingua",
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object> { ["tokenizer"] = "standard" },
            ["English"] = new Dictionary<string, object> { ["type"] = "english" },
            ["French"] = new Dictionary<string, object>
            {
                ["tokenizer"] = "standard",
                ["filter"] = new List<object> { "lowercase", "asciifolding" }
            }
        }
    }
};

MilvusClientV2 client = new(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    Username = "root",
    Password = "Milvus"
});

// Test with accented text
RunAnalyzerResp resultFr = await client.RunAnalyzerAsync(new RunAnalyzerReq
{
    AnalyzerParams = analyzerParams,
    Texts = ["Café français très délicieux"]
});
Console.WriteLine("French: " + string.Join(", ", resultFr.Results.SelectMany(r => r.Tokens).Select(t => t.Token)));
# restful
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"lingua\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"French\":{\"tokenizer\":\"standard\",\"filter\":[\"lowercase\",\"asciifolding\"]}}}}",
    "text": ["Café français très délicieux"]
  }'
使用上の注意
-
フィールドごとに単一言語: フィールドを単一の均質なテキスト単位として処理します。異なるデータレコード間で異なる言語を処理できるように設計されています。たとえば、あるレコードに英語の文が含まれ、次のレコードにフランス語の文が含まれる場合です。
-
混合言語の文字列には非対応: 複数の言語のテキストを含む単一の文字列を処理するようには設計されていません。たとえば、英語の文と引用された日本語のフレーズの両方を含む単一の
VARCHARフィールドは、単一の言語として処理されます。 -
支配的な言語の処理: 混合言語のシナリオでは、検出エンジンは支配的な言語を識別する可能性が高く、対応するアナライザーがテキスト全体に適用されます。その結果、埋め込まれた外国語のテキストはトークン化が不十分になるか、まったく行われなくなります。