MINHASH_LSH
大規模な機械学習データセット、特に大規模言語モデル(LLM)のトレーニングコーパスをクリーニングするようなタスクでは、効率的な重複排除と類似性検索が重要です。数百万または数十億のドキュメントを扱う場合、従来の完全一致検索は遅すぎてコストが高くなります。
Zilliz Cloud の MINHASH_LSH インデックスは、2 つの強力な手法を組み合わせることで、高速でスケーラブルかつ正確な近似重複排除を可能にします。
-
MinHash: ドキュメントの類似性を推定するためのコンパクトなシグネチャ(「フィンガープリント」)をすばやく生成します。
-
Locality-Sensitive Hashing(LSH): MinHash シグネチャに基づいて、類似するドキュメントのグループをすばやく見つけます。
このガイドでは、Zilliz Cloud で MINHASH_LSH を使用するための概念、事前準備、セットアップ、ベストプラクティスについて説明します。
概要
展開して仕組みを確認する
Jaccard 類似度
Jaccard 類似度は、2 つの集合 A と B の重なりを測定するもので、次のように定義されます。
値の範囲は 0(完全に重複がない状態)から 1(同一)です。
ただし、大規模なデータセット内のすべてのドキュメントペア間で Jaccard 類似度を正確に計算するには、計算コストが高くなります。n が大きい場合、時間とメモリの両方で O(n²) となります。そのため、LLM トレーニングコーパスのクリーニングや Web 規模のドキュメント分析などのユースケースには適していません。
MinHash シグネチャ: Jaccard 類似度の近似
MinHash は、Jaccard 類似度を効率的に推定するための確率的な手法です。各集合をコンパクトな シグネチャベクトル に変換し、集合の類似性を効率的に近似するのに十分な情報を保持します。
基本的な考え方:
2 つの集合が類似しているほど、それらの MinHash シグネチャが同じ位置で一致する可能性が高くなります。この性質により、MinHash は集合間の Jaccard 類似度を近似できます。
この性質により、MinHash は集合全体を直接比較することなく、集合間の Jaccard 類似度を近似 できます。
MinHash のプロセスは次のとおりです。
-
シングリング: ドキュメントを、重複するトークンシーケンス(シングル)の集合に変換します。
-
ハッシュ: 各シングルに複数の独立したハッシュ関数を適用します。
-
最小値の選択: 各ハッシュ関数について、すべてのシングルにわたる 最小 ハッシュ値を記録します。
プロセス全体を以下に示します。
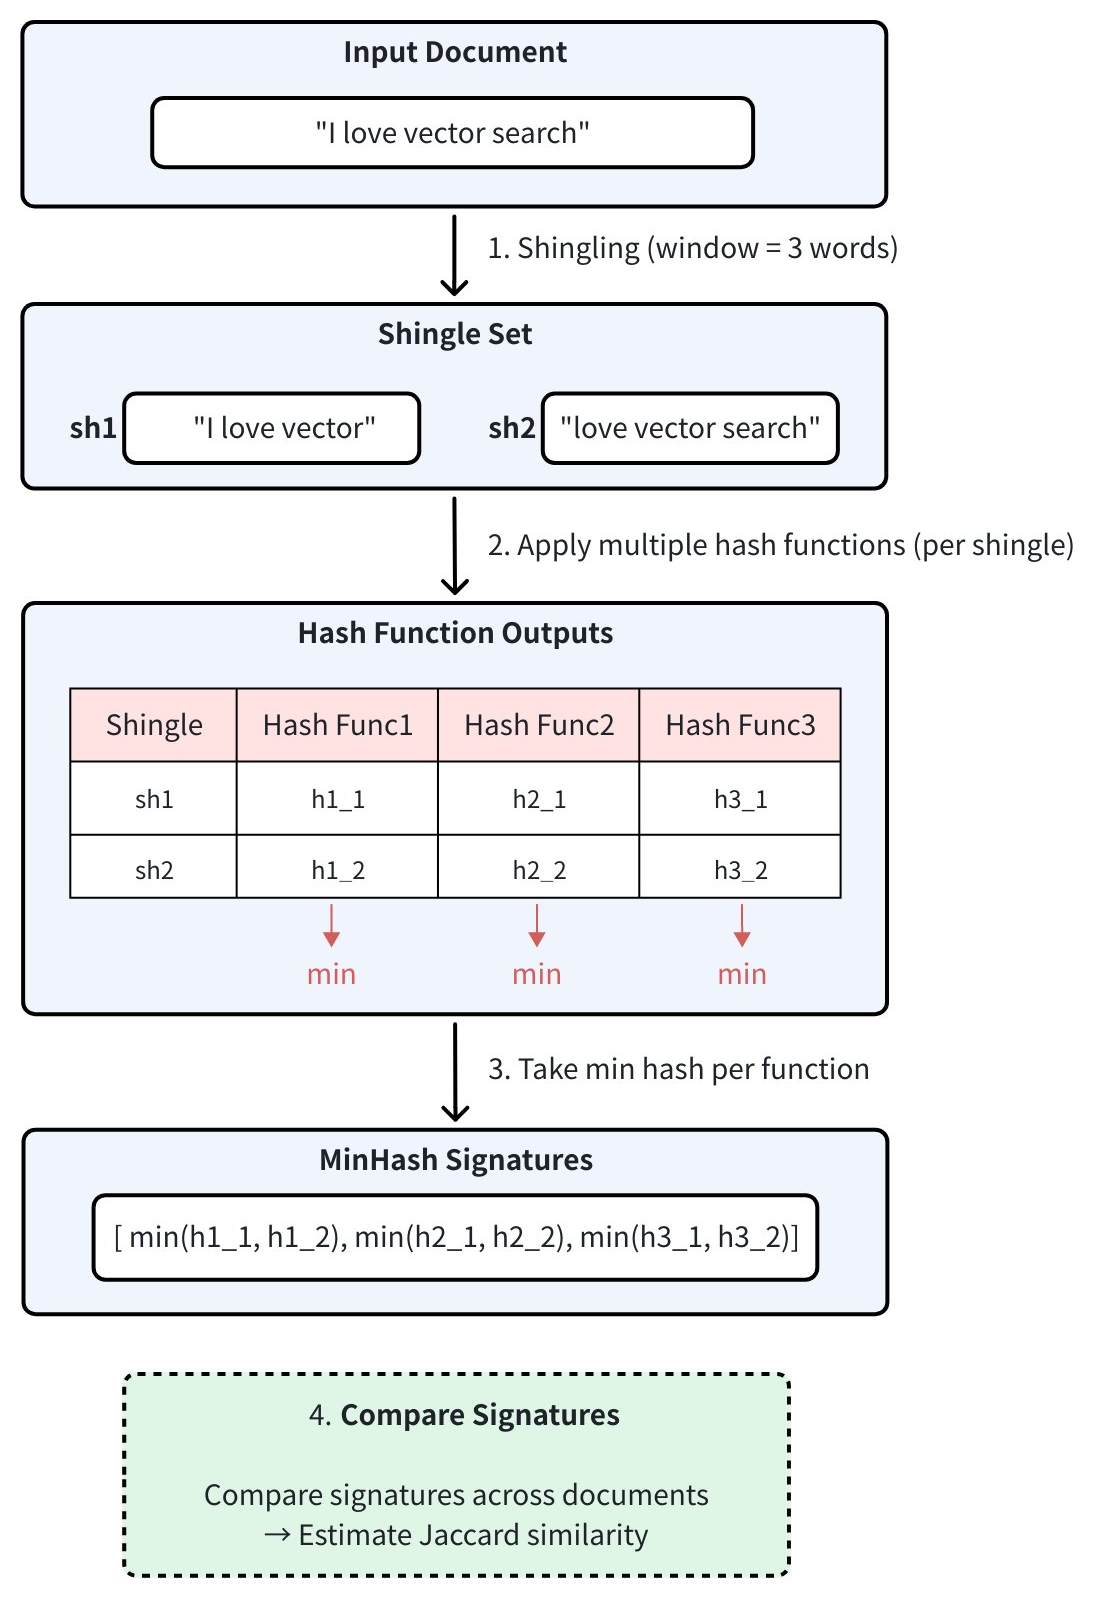
使用するハッシュ関数の数によって、MinHash シグネチャの次元数が決まります。次元数が大きいほど近似精度は向上しますが、ストレージと計算のコストが増加します。
MinHash 用の LSH
MinHash シグネチャは、ドキュメント間で正確な Jaccard 類似度を計算するコストを大幅に削減しますが、すべてのシグネチャベクトルのペアを網羅的に比較すると、大規模な環境では依然として非効率です。
この問題を解決するために、LSH を使用します。LSH は、類似するアイテムが高い確率で同じ「バケット」にハッシュされるようにすることで、すべてのペアを直接比較する必要をなくし、高速な近似類似性検索を可能にします。
プロセスは次のとおりです。
-
シグネチャの分割:
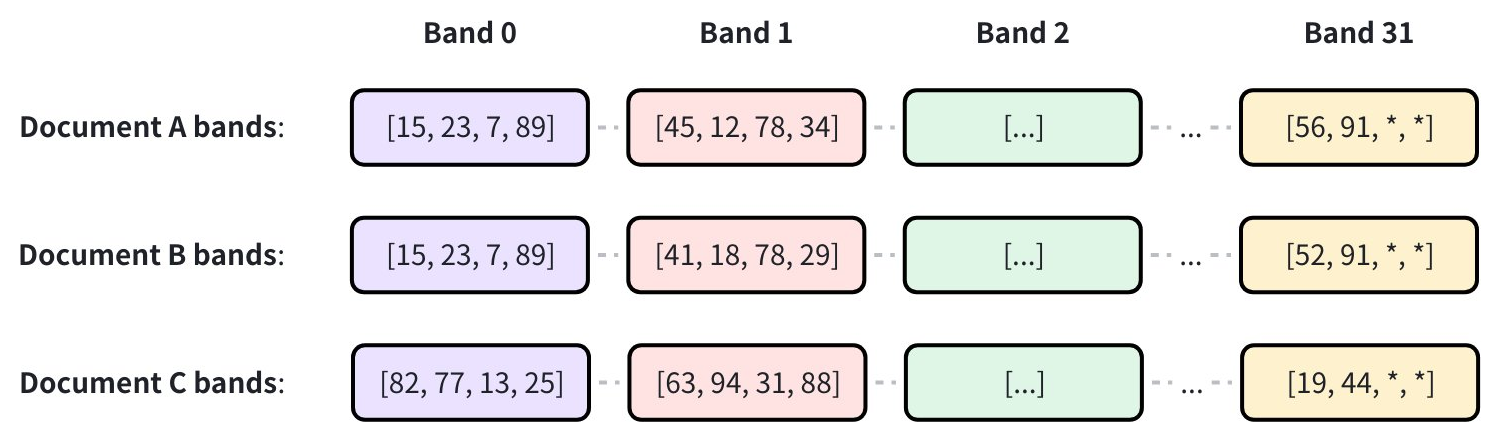
n 次元の MinHash シグネチャを b 個のバンドに分割します。各バンドには r 個の連続するハッシュ値が含まれるため、シグネチャの全長は n = b × r を満たします。
たとえば、128 次元の MinHash シグネチャ(n = 128)を 32 個のバンド(b = 32)に分割すると、各バンドには 4 個のハッシュ値(r = 4)が含まれます。
-
バンド単位のハッシュ:
分割後、各バンドは標準のハッシュ関数を使用して個別に処理され、バケットに割り当てられます。2 つのシグネチャが同じバンド内で同じハッシュ値を生成する場合、つまり同じバケットに分類される場合、それらは一致候補と見なされます。
-
候補の選択:
少なくとも 1 つのバンドで衝突するペアが、類似性の候補として選択されます。
なぜ機能するのか
数学的には、2 つのシグネチャの Jaccard 類似度が である場合、次のようになります。
-
1 つの行(ハッシュ位置)で一致する確率は です。
-
1 つのバンドの r 個の行すべてで一致する確率は です。
-
少なくとも 1 つのバンド で一致する確率は $1 - (1 - s^r)^b$ です。
詳細は、Locality-sensitive hashing を参照してください。
128 次元の MinHash シグネチャを持つ 3 つのドキュメントを考えます。
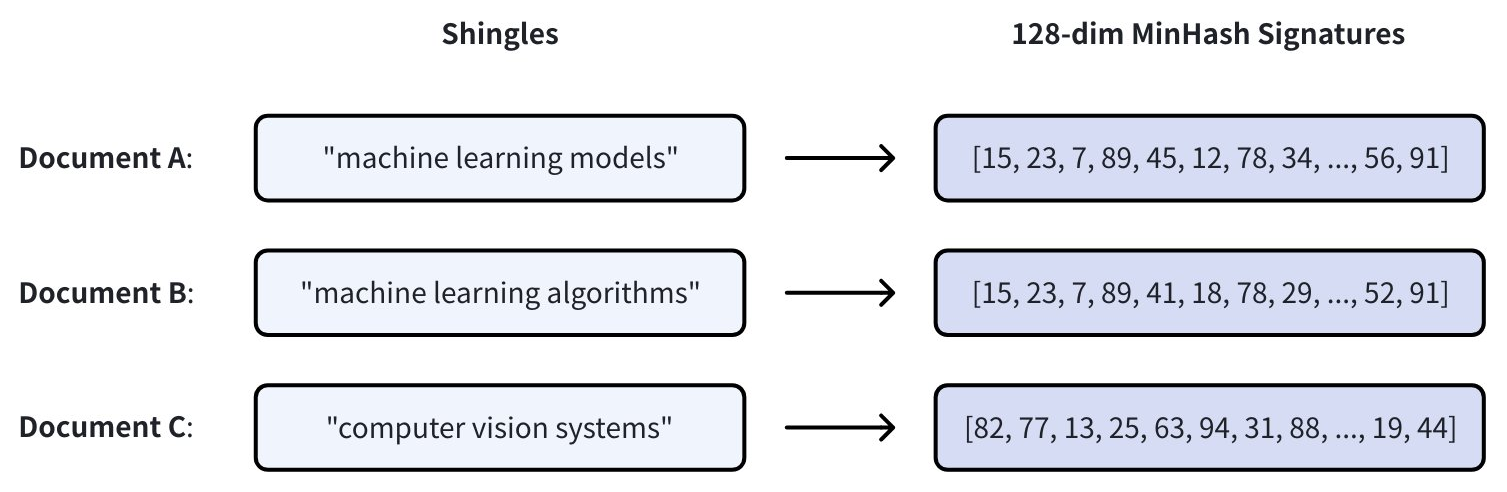
まず、LSH は 128 次元のシグネチャを、それぞれ 4 個の連続する値からなる 32 個のバンドに分割します。
次に、各バンドはハッシュ関数を使用して異なるバケットにハッシュされます。同じバケットを共有するドキュメントペアが類似性の候補として選択されます。次の例では、ドキュメント A とドキュメント B のハッシュ結果が Band 0 で衝突するため、両者が類似性の候補として選択されます。
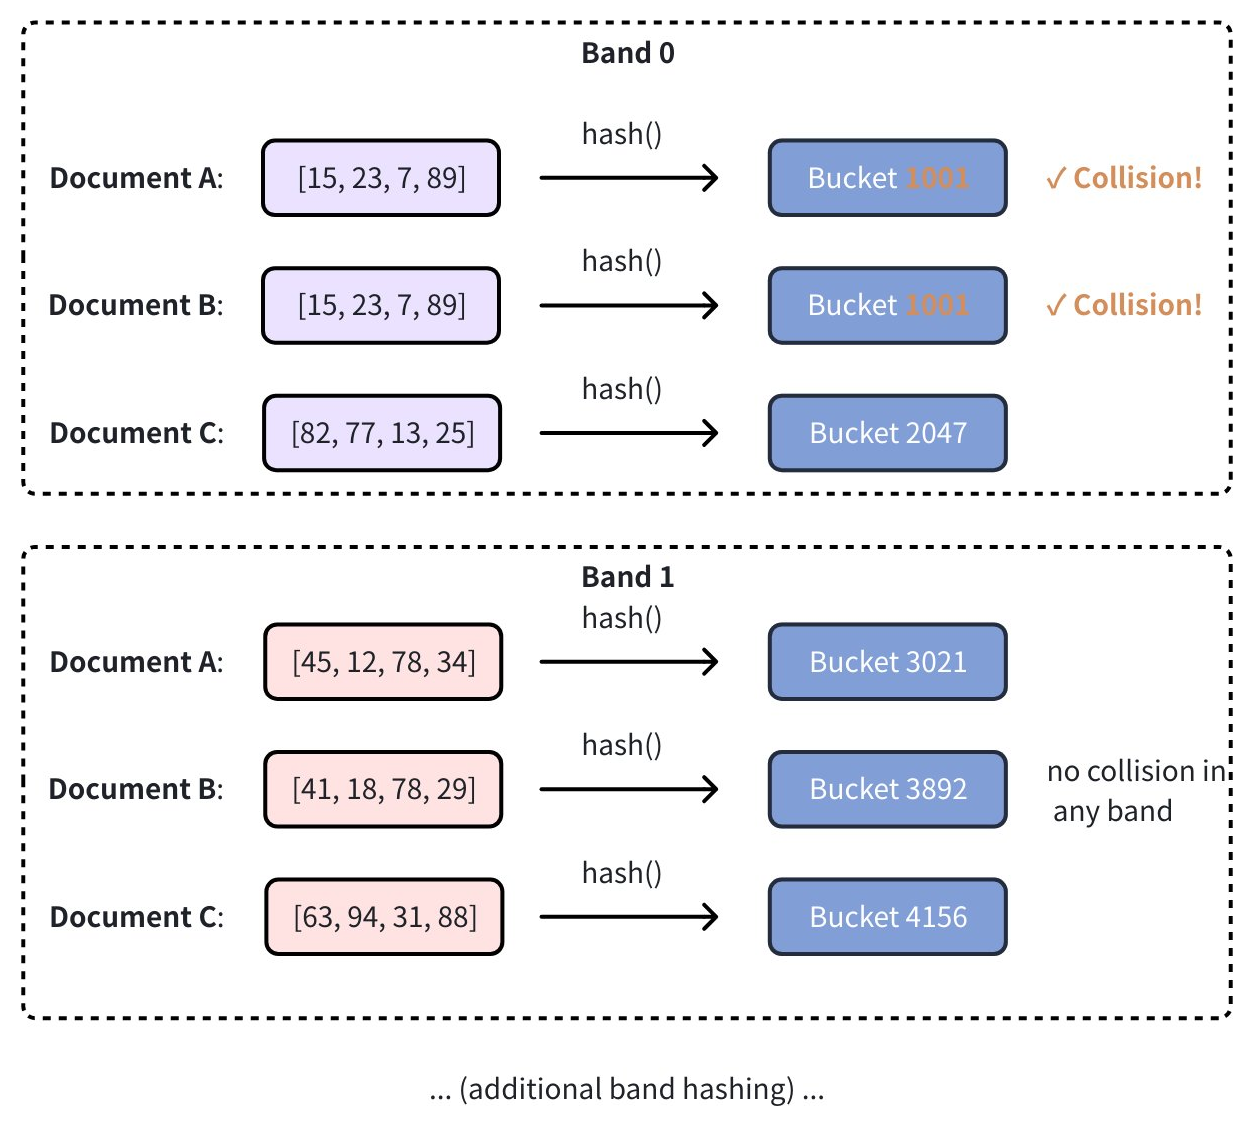
バンドの数は mh_lsh_band パラメーターで制御されます。詳細は、インデックス構築パラメーター を参照してください。
MHJACCARD: MinHash シグネチャの比較
MinHash シグネチャは、固定長のバイナリベクトルを使用して集合間の Jaccard 類似度を近似します。ただし、これらのシグネチャは元の集合を保持しないため、JACCARD、L2、COSINE などの標準的なメトリクスを直接適用して比較することはできません。
この問題に対応するため、Zilliz Cloud では、MinHash シグネチャの比較専用に設計された MHJACCARD という特殊なメトリクスタイプを導入しています。
Zilliz Cloud で MinHash を使用する場合は、次の点に注意してください。
-
ベクトルフィールドの型は
BINARY_VECTORである必要があります。 -
index_typeはMINHASH_LSH(またはBIN_FLAT)である必要があります。 -
metric_typeはMHJACCARDに設定する必要があります。
他のメトリクスを使用すると、無効になるか、誤った結果が生成されます。
このメトリクスタイプの詳細は、MHJACCARD を参照してください。
重複排除のワークフロー
MinHash LSH を活用した重複排除プロセスにより、Zilliz Cloud はコレクションに挿入する前に、ほぼ重複するテキストや構造化レコードを効率的に特定して除外できます。

-
チャンク分割と前処理: 受信したテキストデータまたは構造化データ(レコード、フィールドなど)をチャンクに分割し、テキストを正規化(小文字化、句読点の削除)して、必要に応じてストップワードを削除します。
-
特徴量の構築: MinHash に使用するトークンセットを構築します(テキストからはシングル、構造化データからは連結されたフィールドトークンなど)。
-
MinHash シグネチャの生成: 各チャンクまたはレコードの MinHash シグネチャを計算します。
-
バイナリベクトルへの変換: シグネチャを Milvus と互換性のあるバイナリベクトルに変換します。
-
挿入前の検索: MinHash LSH インデックスを使用して、対象のコレクション内で受信アイテムのほぼ重複を検索します。
-
挿入と保存: 一意のアイテムのみをコレクションに挿入します。これらのアイテムは、今後の重複チェックで検索可能になります。
事前準備
Zilliz Cloud で MinHash LSH を使用する前に、まず MinHash シグネチャ を生成する必要があります。このコンパクトなバイナリシグネチャは集合間の Jaccard 類似度を近似するものであり、Zilliz Cloud で MHJACCARD ベースの検索を行うために必要です。
MINHASH_LSH インデックス用の MinHash シグネチャは、次の 2 つの方法で準備できます。
-
外部ツールを使用してシグネチャを生成し、BINARY_VECTOR フィールドに挿入する、または
-
組み込みの MinHash 関数を使用して、テキストから互換性のあるバイナリベクトルを自動的に生成します。MinHash 関数のエンドツーエンドのワークフローと構成オプションについては、MinHash Function を参照してください。
MinHash シグネチャの生成方法を選択する
ワークロードに応じて、次の方法から選択できます。
-
シンプルにするために Python の
datasketchを使用します(プロトタイピングに推奨)。 -
大規模なデータセットには分散ツール(Spark、Ray など)を使用します。
-
パフォーマンスのチューニングが重要な場合は、カスタムロジック(NumPy、C++ など)を実装します。
このガイドでは、シンプルさと Zilliz Cloud の入力形式との互換性のため、datasketch を使用します。
必要なライブラリをインストールする
この例に必要なパッケージをインストールします。
pip install pymilvus datasketch numpy
MinHash シグネチャを生成する
256 次元の MinHash シグネチャを生成します。各ハッシュ値は 64 ビット整数で表されます。これは、MINHASH_LSH で想定されるベクトル形式と一致します。
from datasketch import MinHash
import numpy as np

MINHASH_DIM = 256
HASH_BIT_WIDTH = 64

def generate_minhash_signature(text, num_perm=MINHASH_DIM) -> bytes:
    m = MinHash(num_perm=num_perm)
    for token in text.lower().split():
        m.update(token.encode("utf8"))
    return m.hashvalues.astype('>u8').tobytes()  # Returns 2048 bytes
各シグネチャは 256 × 64 ビット = 2048 バイトです。このバイト文字列は、BINARY_VECTOR フィールドに直接挿入できます。Zilliz Cloud で使用されるバイナリベクトルの詳細は、Binary ベクトル を参照してください。
(オプション)生のトークンセットを準備する(詳細検索用)
デフォルトでは、Zilliz Cloud は MinHash シグネチャと LSH インデックスのみを使用して近似近傍を検索します。これは高速ですが、誤検出が返されたり、近い一致が見逃されたりする可能性があります。
正確な Jaccard 類似度 が必要な場合、Zilliz Cloud は元のトークンセットを使用する詳細検索をサポートしています。これを有効にするには、次のようにします。
-
トークンセットを別の
VARCHARフィールドに保存します。 -
インデックスパラメーターを構築する ときに
"with_raw_data": Trueを設定します。 -
また、類似性検索を実行する ときに
"mh_search_with_jaccard": Trueを有効にします。
トークンセット抽出の例:
def extract_token_set(text: str) -> str:
    tokens = set(text.lower().split())
    return " ".join(tokens)
MinHash LSH を使用する
MinHash ベクトルと元のトークンセットを準備したら、Zilliz Cloud で MINHASH_LSH を使用して保存、インデックス作成、検索を行うことができます。
クラスターに接続する
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")  # Update if your URI is different
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .build();
MilvusClientV2 client = new MilvusClientV2(connectConfig);
import (
    "context"
    "log"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
})
if err != nil {
    log.Fatal(err)
}
defer cli.Close(ctx)
use milvus::v2::prelude::*;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT");
let client = ClientV2::new(&config).await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

const client = new MilvusClient({ address: 'YOUR_CLUSTER_ENDPOINT' });
using Milvus.Client.V2;
using Milvus.Client.V2.Types;

MilvusClientV2 client = new(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT", // Update if your URI is different
    Username = "root",
    Password = "Milvus"
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"
コレクションスキーマを定義する
次の項目を含むスキーマを定義します。
-
プライマリキー
-
MinHash シグネチャ用の
BINARY_VECTORフィールド -
元のトークンセット用の
VARCHARフィールド(詳細検索が有効な場合) -
オプションで、元のテキスト用の
documentフィールド
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import DataType

VECTOR_DIM = MINHASH_DIM * HASH_BIT_WIDTH  # 256 × 64 = 16384 bits

schema = client.create_schema(auto_id=False, enable_dynamic_field=False)
schema.add_field("doc_id", DataType.INT64, is_primary=True)
schema.add_field("minhash_signature", DataType.BINARY_VECTOR, dim=VECTOR_DIM)
schema.add_field("token_set", DataType.VARCHAR, max_length=1000)  # required for refinement
schema.add_field("document", DataType.VARCHAR, max_length=1000)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

int VECTOR_DIM = 256 * 64;  // 256 × 64 = 16384 bits

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("doc_id").dataType(DataType.Int64).isPrimaryKey(true).build());
schema.addField(AddFieldReq.builder()
        .fieldName("minhash_signature").dataType(DataType.BinaryVector).dimension(VECTOR_DIM).build());
schema.addField(AddFieldReq.builder()
        .fieldName("token_set").dataType(DataType.VarChar).maxLength(1000).build());
schema.addField(AddFieldReq.builder()
        .fieldName("document").dataType(DataType.VarChar).maxLength(1000).build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"
)

// 256 × 64 = 16384 bits
schema := entity.NewSchema().
    WithField(entity.NewField().WithName("doc_id").WithDataType(entity.FieldTypeInt64).WithIsPrimaryKey(true)).
    WithField(entity.NewField().WithName("minhash_signature").WithDataType(entity.FieldTypeBinaryVector).WithDim(256 * 64)).
    WithField(entity.NewField().WithName("token_set").WithDataType(entity.FieldTypeVarChar).WithMaxLength(1000)).
    WithField(entity.NewField().WithName("document").WithDataType(entity.FieldTypeVarChar).WithMaxLength(1000))
use milvus::v2::prelude::*;

// 256 × 64 = 16384 bits
let schema = CollectionSchema::new()
    .enable_dynamic_field(false)
    .add_field(FieldSchema::new().name("doc_id").data_type(DataType::Int64).primary_key(true))
    .add_field(FieldSchema::new().name("minhash_signature").data_type(DataType::BinaryVector).dimension(256 * 64))
    .add_field(FieldSchema::new().name("token_set").data_type(DataType::VarChar).max_length(1000))
    .add_field(FieldSchema::new().name("document").data_type(DataType::VarChar).max_length(1000));
const int VECTOR_DIM = 256 * 64;  // 256 × 64 = 16384 bits

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"doc_id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("minhash_signature", milvus::DataType::BINARY_VECTOR).WithDimension(VECTOR_DIM));
schema->AddField(milvus::FieldSchema("token_set", milvus::DataType::VARCHAR).WithMaxLength(1000));
schema->AddField(milvus::FieldSchema("document", milvus::DataType::VARCHAR).WithMaxLength(1000));
import { DataType } from '@zilliz/milvus2-sdk-node';

const VECTOR_DIM = 256 * 64; // 256 × 64 = 16384 bits

const schema = [
  { name: 'doc_id', data_type: DataType.Int64, is_primary_key: true },
  { name: 'minhash_signature', data_type: DataType.BinaryVector, dim: VECTOR_DIM },
  { name: 'token_set', data_type: DataType.VarChar, max_length: 1000 },
  { name: 'document', data_type: DataType.VarChar, max_length: 1000 },
];
using Milvus.Client.V2.Types;

// 256 × 64 = 16384 bits
int vectorDim = 256 * 64;

CollectionSchema schema = new()
{
    Fields =
    {
        new FieldSchema("doc_id", DataType.Int64, isPrimaryKey: true),
        new FieldSchema("minhash_signature", DataType.BinaryVector) { Dimension = vectorDim },
        FieldSchema.CreateVarchar("token_set", 1000), // required for refinement
        FieldSchema.CreateVarchar("document", 1000)
    }
};
SCHEMA='{
  "autoId": false,
  "enableDynamicField": false,
  "fields": [
    {"fieldName": "doc_id", "dataType": "Int64", "isPrimary": true},
    {"fieldName": "minhash_signature", "dataType": "BinaryVector", "elementTypeParams": {"dim": "16384"}},
    {"fieldName": "token_set", "dataType": "VarChar", "elementTypeParams": {"max_length": "1000"}},
    {"fieldName": "document", "dataType": "VarChar", "elementTypeParams": {"max_length": "1000"}}
  ]
}'
インデックスパラメーターを構築してコレクションを作成する
Jaccard リファインメントを有効にして MINHASH_LSH インデックスを構築します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
index_params = client.prepare_index_params()
index_params.add_index(
    field_name="minhash_signature",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_element_bit_width": HASH_BIT_WIDTH,  # Must match signature bit width
        "mh_lsh_band": 16,                       # Band count (256/16 = 16 hashes per band)
        "with_raw_data": True                    # Required for Jaccard refinement
    }
)

client.create_collection("minhash_demo", schema=schema, index_params=index_params)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import java.util.Collections;

IndexParam indexParam = IndexParam.builder()
        .fieldName("minhash_signature")
        .indexType(IndexParam.IndexType.MINHASH_LSH)
        .metricType(IndexParam.MetricType.MHJACCARD)
        .extraParams(new java.util.HashMap<String, Object>() {{
            put("mh_element_bit_width", 64);
            put("mh_lsh_band", 16);
            put("with_raw_data", true);
        }})
        .build();

client.createCollection(CreateCollectionReq.builder()
        .collectionName("minhash_demo")
        .collectionSchema(schema)
        .indexParams(Collections.singletonList(indexParam))
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

idx := index.NewMinHashLSHIndex(entity.MHJACCARD, 16).
    WithElementBitWidth(64).
    WithRawData(true)

err = cli.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("minhash_demo", schema).
    WithIndexOptions(milvusclient.NewCreateIndexOption("minhash_demo", "minhash_signature", idx)))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;
use std::collections::HashMap;

let index_param = IndexParam::new()
    .field_name("minhash_signature")
    .index_type(IndexType::MinhashLsh)
    .metric_type(MetricType::MhJaccard)
    .extra_params(HashMap::from([
        ("mh_element_bit_width".into(), "64".into()),
        ("mh_lsh_band".into(), "16".into()),
        ("with_raw_data".into(), "true".into()),
    ]));

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("minhash_demo")
            .schema(schema)
            .index_param(index_param)
            .build()?,
    )
    .await?;
milvus::IndexDesc index_vector("minhash_signature", "", milvus::IndexType::MINHASH_LSH, milvus::MetricType::MHJACCARD);
index_vector.AddExtraParam("mh_element_bit_width", "64");
index_vector.AddExtraParam("mh_lsh_band", "16");
index_vector.AddExtraParam("with_raw_data", "true");

auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                .WithCollectionName("minhash_demo")
                                .WithCollectionSchema(schema)
                                .AddIndex(std::move(index_vector)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createCollection({
  collection_name: 'minhash_demo',
  fields: schema,
  index_params: [{
    field_name: 'minhash_signature',
    index_type: 'MINHASH_LSH',
    metric_type: 'MHJACCARD',
    params: { mh_element_bit_width: 64, mh_lsh_band: 16, with_raw_data: true },
  }],
});
using Milvus.Client.V2.Requests.Collection;
using Milvus.Client.V2.Types;

IndexParam indexParam = new("minhash_signature", "vector_index", IndexType.MinHashLsh, MetricType.MhJaccard)
{
    ExtraParams =
    {
        ["mh_element_bit_width"] = 64, // Must match signature bit width
        ["mh_lsh_band"] = 16,          // Band count (256/16 = 16 hashes per band)
        ["with_raw_data"] = true       // Required for Jaccard refinement
    }
};

await client.CreateCollectionAsync(new CreateCollectionReq
{
    CollectionName = "minhash_demo",
    Schema = schema,
    Indexes = [indexParam]
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"schema\": ${SCHEMA},
    \"indexParams\": [
        {
            \"fieldName\": \"minhash_signature\",
            \"indexType\": \"MINHASH_LSH\",
            \"metricType\": \"MHJACCARD\",
            \"params\": {\"mh_element_bit_width\": \"64\", \"mh_lsh_band\": \"16\", \"with_raw_data\": \"true\"}
        }
    ]
}"
インデックス構築パラメーターの詳細は、インデックス構築パラメーター を参照してください。
データを挿入する
各ドキュメントについて、次の項目を準備します。
-
バイナリの MinHash シグネチャ
-
シリアル化されたトークンセット文字列
-
(オプション)元のテキスト
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
documents = [
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns"
]

insert_data = []
for i, doc in enumerate(documents):
    sig = generate_minhash_signature(doc)
    token_str = extract_token_set(doc)
    insert_data.append({
        "doc_id": i,
        "minhash_signature": sig,
        "token_set": token_str,
        "document": doc
    })

client.insert("minhash_demo", insert_data)
client.flush("minhash_demo")
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import java.util.ArrayList;
import java.util.List;

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
String[] documents = {
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns"
};
String[] tokenSets = {
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns"
};
byte[][] signatures = { signature0, signature1 };

Gson gson = new Gson();
List<JsonObject> rows = new ArrayList<>();
for (int i = 0; i < documents.length; i++) {
    JsonObject row = new JsonObject();
    row.addProperty("doc_id", i);
    row.add("minhash_signature", gson.toJsonTree(signatures[i]));
    row.addProperty("token_set", tokenSets[i]);
    row.addProperty("document", documents[i]);
    rows.add(row);
}

client.insert(InsertReq.builder()
        .collectionName("minhash_demo")
        .data(rows)
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/column"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
documents := []string{
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns",
}
tokenSets := []string{
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns",
}
signatures := [][]byte{signature0, signature1}

result, err := cli.Insert(ctx, milvusclient.NewColumnBasedInsertOption("minhash_demo").
    WithInt64Column("doc_id", []int64{0, 1}).
    WithColumns(
        column.NewColumnBinaryVector("minhash_signature", 16384, signatures),
        column.NewColumnVarChar("token_set", tokenSets),
        column.NewColumnVarChar("document", documents),
    ))
if err != nil {
    log.Fatal(err)
}
log.Println("insert count:", result.InsertCount)
use milvus::v2::prelude::*;
use serde_json::json;

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
let documents = [
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns",
];
let token_sets = [
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns",
];
let signatures: [Vec<u8>; 2] = [signature0, signature1];

for i in 0..documents.len() {
    client
        .insert(
            InsertRequest::builder()
                .collection_name("minhash_demo")
                .row(json!({
                    "doc_id": i,
                    "minhash_signature": signatures[i],
                    "token_set": token_sets[i],
                    "document": documents[i],
                }))
                .build()?,
        )
        .await?;
}
// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
std::vector<std::vector<uint8_t>> signatures = {signature0, signature1};

milvus::EntityRows data = {
    {{"doc_id", 0}, {"minhash_signature", signatures[0]},
     {"token_set", "automatically learning data machine algorithms process"},
     {"document", "machine learning algorithms process data automatically"}},
    {{"doc_id", 1}, {"minhash_signature", signatures[1]},
     {"token_set", "learning uses deep neural networks to model patterns"},
     {"document", "deep learning uses neural networks to model patterns"}},
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("minhash_demo")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
const documents = [
  'machine learning algorithms process data automatically',
  'deep learning uses neural networks to model patterns',
];
const tokenSets = [
  'automatically learning data machine algorithms process',
  'learning uses deep neural networks to model patterns',
];
const signatures = [signature0, signature1]; // Buffer(2048) each

const rows = documents.map((doc, i) => ({
  doc_id: i,
  minhash_signature: signatures[i],
  token_set: tokenSets[i],
  document: doc,
}));

await client.insert({
  collection_name: 'minhash_demo',
  data: rows,
});
using Milvus.Client.V2.Requests.Dml;
using Milvus.Client.V2.Types;

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
string[] documents =
{
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns"
};
string[] tokenSets =
{
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns"
};
ReadOnlyMemory<byte>[] signatures = { signature0, signature1 }; // 2048 bytes each

await client.InsertAsync(new InsertReq
{
    CollectionName = "minhash_demo",
    ColumnsData =
    [
        FieldData.Create("doc_id", new long[] { 0, 1 }),
        new BinaryVectorFieldData("minhash_signature", signatures),
        FieldData.Create("token_set", tokenSets),
        FieldData.Create("document", documents)
    ]
});
# MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch,
# and base64-encoded for the REST insert.
SIGNATURE_0="<base64 of the 2048-byte MinHash signature>"
SIGNATURE_1="<base64 of the 2048-byte MinHash signature>"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"data\": [
        {
            \"doc_id\": 0,
            \"minhash_signature\": \"${SIGNATURE_0}\",
            \"token_set\": \"automatically learning data machine algorithms process\",
            \"document\": \"machine learning algorithms process data automatically\"
        },
        {
            \"doc_id\": 1,
            \"minhash_signature\": \"${SIGNATURE_1}\",
            \"token_set\": \"learning uses deep neural networks to model patterns\",
            \"document\": \"deep learning uses neural networks to model patterns\"
        }
    ]
}"
類似性検索を実行する
Zilliz Cloud は、MinHash LSH を使用した 2 つのモードの類似性検索をサポートしています。
-
近似検索 — MinHash シグネチャと LSH のみを使用し、高速ですが確率的な結果を返します。
-
詳細検索 — 元のトークンセットを使用して Jaccard 類似度を再計算し、精度を向上させます。
5.1 クエリを準備する
類似性検索を実行するには、クエリドキュメントの MinHash シグネチャを生成します。このシグネチャは、データ挿入時に使用したものと同じ次元数とエンコード形式に一致する必要があります。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
query_text = "deep learning uses neural networks to model patterns"
query_sig = generate_minhash_signature(query_text)
String queryText = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
byte[] querySignature = querySignatureBytes;
queryText := "deep learning uses neural networks to model patterns"
// MinHash signature of the query text, generated externally (e.g., via datasketch).
querySignature := querySignatureBytes
let query_text = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
let query_signature: Vec<u8> = query_signature_bytes;
std::string query_text = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
std::vector<uint8_t> query_signature = query_signature_bytes;
const queryText = 'deep learning uses neural networks to model patterns';
// MinHash signature of the query text, generated externally (e.g., via datasketch).
const querySignature = querySignatureBytes; // Buffer(2048)
string queryText = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
byte[] querySignature = querySignatureBytes; // 2048 bytes
# MinHash signature of the query text, generated externally (e.g., via datasketch),
# and base64-encoded for the REST search request.
QUERY_SIGNATURE="<base64 of the query MinHash signature>"

# Load the collection before searching (REST does not auto-load).
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/load" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data '{"collectionName": "minhash_demo"}'
5.2 近似検索(LSH のみ)
これは高速でスケーラブルですが、近い一致が見逃されたり、誤検出が含まれたりする可能性があります。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
search_params={
    "metric_type": "MHJACCARD",
    "params": {}
}

approx_results = client.search(
    collection_name="minhash_demo",
    data=[query_sig],
    anns_field="minhash_signature",
    search_params=search_params,
    limit=3,
    output_fields=["doc_id", "document"],
    consistency_level="Strong"
)

for i, hit in enumerate(approx_results[0]):
    sim = hit['distance']
    print(f"{i+1}. Similarity: {sim:.3f} | {hit['entity']['document']}")
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Collections;

// Approximate search (LSH-only): uses only MinHash signatures and LSH.
SearchResp approxResp = client.search(SearchReq.builder()
        .collectionName("minhash_demo")
        .annsField("minhash_signature")
        .data(Collections.singletonList(new BinaryVec(querySignature)))
        .metricType(IndexParam.MetricType.MHJACCARD)
        .searchParams(Collections.emptyMap())
        .limit(3)
        .outputFields(Collections.singletonList("document"))
        .build());

for (SearchResp.SearchResult hit : approxResp.getSearchResults().get(0)) {
    double sim = hit.getScore();
    System.out.printf("Similarity: %.3f | %s%n", sim, hit.getEntity().get("document"));
}
import (
    "github.com/milvus-io/milvus/client/v3/entity"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Approximate search (LSH-only): uses only MinHash signatures and LSH.
resultSets, err := cli.Search(ctx, milvusclient.NewSearchOption("minhash_demo", 3, []entity.Vector{entity.BinaryVector(querySignature)}).
    WithANNSField("minhash_signature").
    WithAnnParam(index.NewMinHashLSHAnnParam()).
    WithOutputFields("doc_id", "document"))
if err != nil {
    log.Fatal(err)
}
for _, resultSet := range resultSets {
    docCol := resultSet.GetColumn("document")
    for i := 0; i < resultSet.ResultCount; i++ {
        doc, _ := docCol.GetAsString(i)
        log.Printf("Similarity: %.3f | %s", resultSet.Scores[i], doc)
    }
}
// Approximate search (LSH-only): uses only MinHash signatures and LSH.
let response = client
    .search(
        SearchRequest::builder()
            .collection_name("minhash_demo")
            .vector_field("minhash_signature")
            .vectors(SearchVectors::Binary(vec![query_signature]))
            .metric_type(MetricType::MhJaccard)
            .limit(3)
            .output_fields(["doc_id", "document"])
            .build()?,
    )
    .await?;

for result in response.results() {
    for row in result.rows()? {
        let entity = row.to_entity_row()?;
        let sim = entity.get("distance").unwrap_or_default();
        println!("{:?}", entity);
    }
}
// Approximate search (LSH-only): uses only MinHash signatures and LSH.
auto request = milvus::SearchRequest()
                    .WithCollectionName("minhash_demo")
                    .WithAnnsField("minhash_signature")
                    .WithMetricType(milvus::MetricType::MHJACCARD)
                    .WithLimit(3)
                    .AddOutputField("doc_id")
                    .AddOutputField("document")
                    .AddBinaryVector(query_signature);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    for (const auto& row : rows) {
        std::cout << row << std::endl;
    }
}
// Approximate search (LSH-only): uses only MinHash signatures and LSH.
const approx_results = await client.search({
  collection_name: 'minhash_demo',
  data: [querySignature],
  anns_field: 'minhash_signature',
  metric_type: 'MHJACCARD',
  params: {},
  limit: 3,
  output_fields: ['doc_id', 'document'],
  consistency_level: 'Strong',
});
for (const hit of approx_results.results) {
  const sim = hit.score;
  console.log(`Similarity: ${sim.toFixed(3)} | ${hit.document}`);
}
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// Approximate search (LSH-only): uses only MinHash signatures and LSH.
SearchResp resp = await client.SearchAsync(new SearchReq
{
    CollectionName = "minhash_demo",
    VectorFieldName = "minhash_signature",
    BinaryVectors = [querySignature],
    MetricType = MetricType.MhJaccard,
    Limit = 3,
    Parameters = new SearchParameters
    {
        OutputFields = { "doc_id", "document" }
    }
});

for (int i = 0; i < resp.Scores.Count; i++)
{
    Console.WriteLine($"{i + 1}. Similarity: {resp.Scores[i]:F3}");
}
# Approximate search (LSH-only): uses only MinHash signatures and LSH.
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"data\": [\"${QUERY_SIGNATURE}\"],
    \"annsField\": \"minhash_signature\",
    \"metricType\": \"MHJACCARD\",
    \"limit\": 3,
    \"outputFields\": [\"doc_id\", \"document\"]
}"
5.3 詳細検索(精度重視の場合に推奨)
これにより、Zilliz Cloud に保存された元のトークンセットを使用して、正確な Jaccard 比較が可能になります。やや低速ですが、品質が重要なタスクに推奨されます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,  # Enable real Jaccard computation
        "refine_k": 5                    # Refine top 5 candidates
    }
}

refined_results = client.search(
    collection_name="minhash_demo",
    data=[query_sig],
    anns_field="minhash_signature",
    search_params=search_params,
    limit=3,
    output_fields=["doc_id", "document"],
    consistency_level="Strong"
)

for i, hit in enumerate(refined_results[0]):
    sim = hit['distance']
    print(f"{i+1}. Similarity: {sim:.3f} | {hit['entity']['document']}")
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Collections;

// Refined search: re-computes the exact Jaccard similarity on the candidates.
SearchResp refinedResp = client.search(SearchReq.builder()
        .collectionName("minhash_demo")
        .annsField("minhash_signature")
        .data(Collections.singletonList(new BinaryVec(querySignature)))
        .metricType(IndexParam.MetricType.MHJACCARD)
        .searchParams(new java.util.HashMap<String, Object>() {{
            put("mh_search_with_jaccard", true);
            put("refine_k", 5);
        }})
        .limit(3)
        .outputFields(Collections.singletonList("document"))
        .build());

for (SearchResp.SearchResult hit : refinedResp.getSearchResults().get(0)) {
    double sim = hit.getScore();
    System.out.printf("Similarity: %.3f | %s%n", sim, hit.getEntity().get("document"));
}
import (
    "github.com/milvus-io/milvus/client/v3/entity"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Refined search: re-computes the exact Jaccard similarity on the candidates.
resultSets, err := cli.Search(ctx, milvusclient.NewSearchOption("minhash_demo", 3, []entity.Vector{entity.BinaryVector(querySignature)}).
    WithANNSField("minhash_signature").
    WithSearchParam("params", `{"mh_search_with_jaccard":true,"refine_k":5}`).
    WithOutputFields("doc_id", "document"))
if err != nil {
    log.Fatal(err)
}
for _, resultSet := range resultSets {
    docCol := resultSet.GetColumn("document")
    for i := 0; i < resultSet.ResultCount; i++ {
        doc, _ := docCol.GetAsString(i)
        log.Printf("Similarity: %.3f | %s", resultSet.Scores[i], doc)
    }
}
// Note: Refined search (`mh_search_with_jaccard` / `refine_k`) is not supported
// in milvus-sdk-rust as of v3.0.2 — search params are string-typed, and the
// server rejects the string form for MINHASH refinement. Use the approximate
// LSH search above instead; refined Jaccard search is available in the
// Python, Java, Go, and Node.js SDKs.
// Refined search: re-computes the exact Jaccard similarity on the candidates.
auto request = milvus::SearchRequest()
                    .WithCollectionName("minhash_demo")
                    .WithAnnsField("minhash_signature")
                    .WithMetricType(milvus::MetricType::MHJACCARD)
                    .WithExtraParams({{"mh_search_with_jaccard", "true"}, {"refine_k", "5"}})
                    .WithLimit(3)
                    .AddOutputField("doc_id")
                    .AddOutputField("document")
                    .AddBinaryVector(query_signature);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    for (const auto& row : rows) {
        std::cout << row << std::endl;
    }
}
// Refined search: re-computes the exact Jaccard similarity on the candidates.
const refined_results = await client.search({
  collection_name: 'minhash_demo',
  data: [querySignature],
  anns_field: 'minhash_signature',
  metric_type: 'MHJACCARD',
  params: {
    mh_search_with_jaccard: true,
    refine_k: 5,
  },
  limit: 3,
  output_fields: ['doc_id', 'document'],
  consistency_level: 'Strong',
});
for (const hit of refined_results.results) {
  const sim = hit.score;
  console.log(`Similarity: ${sim.toFixed(3)} | ${hit.document}`);
}
// Note: Refined search (`mh_search_with_jaccard` / `refine_k`) is not supported
// in milvus-sdk-csharp as of v3.0.0 — search params are string-typed, and the
// server rejects the string form for MINHASH refinement. Use the approximate
// LSH search above instead; refined Jaccard search is available in the
// Python, Java, Go, and Node.js SDKs.
# The REST API accepts only numeric values in search `params`, so the boolean
# `mh_search_with_jaccard` cannot be expressed. Use the approximate LSH search
# (refined Jaccard search is available via the SDKs).
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"data\": [\"${QUERY_SIGNATURE}\"],
    \"annsField\": \"minhash_signature\",
    \"metricType\": \"MHJACCARD\",
    \"limit\": 3,
    \"outputFields\": [\"doc_id\", \"document\"]
}"
インデックスパラメーター
このセクションでは、インデックスの構築とインデックスに対する検索に使用するパラメーターの概要を説明します。
インデックス構築パラメーター
次の表は、インデックスを構築する ときに params で設定できるパラメーターを一覧にしたものです。
| パラメーター | 説明 | 値の範囲 | チューニングの推奨事項 |
|---|---|---|---|
mh_element_bit_width | MinHash シグネチャ内の各ハッシュ値のビット幅です。8 で割り切れる必要があります。 | 8, 16, 32, 64 | パフォーマンスと精度のバランスを取るには 32 を使用します。大規模なデータセットで高い精度を得るには 64 を使用します。許容できる精度低下と引き換えにメモリを節約するには 16 を使用します。 |
mh_lsh_band | LSH のために MinHash シグネチャを分割するバンド数です。再現率とパフォーマンスのトレードオフを制御します。 | [1, signature_length] | 128 次元のシグネチャの場合は、32 個のバンド(4 個の値/band). から始めます。再現率を高めるには 64 に増やし、パフォーマンスを向上させるには 16 に減らします。シグネチャの長さを均等に分割できる必要があります。 |
mh_lsh_code_in_mem | LSH ハッシュコードを匿名メモリに保存する(true)か、メモリマッピングを使用する(false)かを指定します。 | true, false | 大規模なデータセット(100 万セット超)では、メモリ使用量を削減するために false を使用します。最大の検索速度が必要な小規模なデータセットでは true を使用します。 |
with_raw_data | リファインメントのために、LSH コードと一緒に元の MinHash シグネチャを保存するかどうかを指定します。 | true, false | 高い精度が必要で、ストレージコストを許容できる場合は true を使用します。わずかな精度低下と引き換えにストレージのオーバーヘッドを最小限に抑える場合は false を使用します。 |
mh_lsh_bloom_false_positive_prob | LSH バケットの最適化に使用されるブルームフィルターの偽陽性確率です。 | [0.001, 0.1] | メモリ使用量と精度のバランスを取るには 0.01 を使用します。値を小さくする(0.001)と偽陽性は減少しますが、メモリ使用量が増加します。値を大きくする(0.05)とメモリを節約できますが、精度が低下する可能性があります。 |
インデックス固有の検索パラメーター
次の表は、インデックスを検索する ときに search_params.params で設定できるパラメーターを一覧にしたものです。
| パラメーター | 説明 | 値の範囲 | チューニングの推奨事項 |
|---|---|---|---|
mh_search_with_jaccard | リファインメントのために、候補結果に対して正確な Jaccard 類似度計算を実行するかどうかを指定します。 | true, false | 高い精度が必要なアプリケーション(重複排除など)には true を使用します。わずかな精度低下を許容できる場合に高速な近似検索を行うには false を使用します。 |
refine_k | Jaccard リファインメントの前に取得する候補の数です。mh_search_with_jaccard が true の場合にのみ有効です。 | [top_k, top_k * 10] | 再現率とパフォーマンスのバランスを取るには、希望する top_k の 2〜5 倍に設定します。値を大きくすると再現率は向上しますが、計算コストが増加します。 |
mh_lsh_batch_search | 同時に複数のクエリを実行する場合のバッチ最適化を有効にするかどうかを指定します。 | true, false | 複数のクエリを同時に検索してスループットを向上させる場合は true を使用します。メモリのオーバーヘッドを削減するため、単一クエリのシナリオでは false を使用します。 |