多言語アナライザー
Zilliz Cloud がテキスト分析を実行する際、通常は collection 内のテキストフィールド全体に単一のアナライザーを適用します。そのアナライザーが英語向けに最適化されている場合、中国語、スペイン語、フランス語など他の言語で必要となる大きく異なるトークン化やステミングのルールにうまく対応できず、結果として再現率が低下します。たとえば、スペイン語の "teléfono"("phone" を意味する)を検索すると、英語中心のアナライザーでは適切に処理できない場合があります。アクセントを落としてしまい、スペイン語固有のステミングも適用されないため、関連する結果が見落とされる可能性があります。
多言語アナライザーは、単一の collection 内のテキストフィールドに対して複数のアナライザーを設定できるようにすることで、この問題を解決します。これにより、多言語ドキュメントを1つのテキストフィールドに保存でき、Zilliz Cloud は各ドキュメントに対して適切な言語ルールに従ってテキストを分析します。
制限事項
-
この機能は、BM25 ベースのテキスト検索と sparse vector でのみ動作します。詳細については、Full Text Search を参照してください。
-
単一の collection 内の各ドキュメントで使用できるアナライザーは1つだけであり、それは言語識別子フィールドの値によって決まります。
-
パフォーマンスは、アナライザーの複雑さやテキストデータのサイズによって異なる場合があります。
概要
次の図は、Zilliz Cloud で多言語アナライザーを設定して使用するワークフローを示しています。
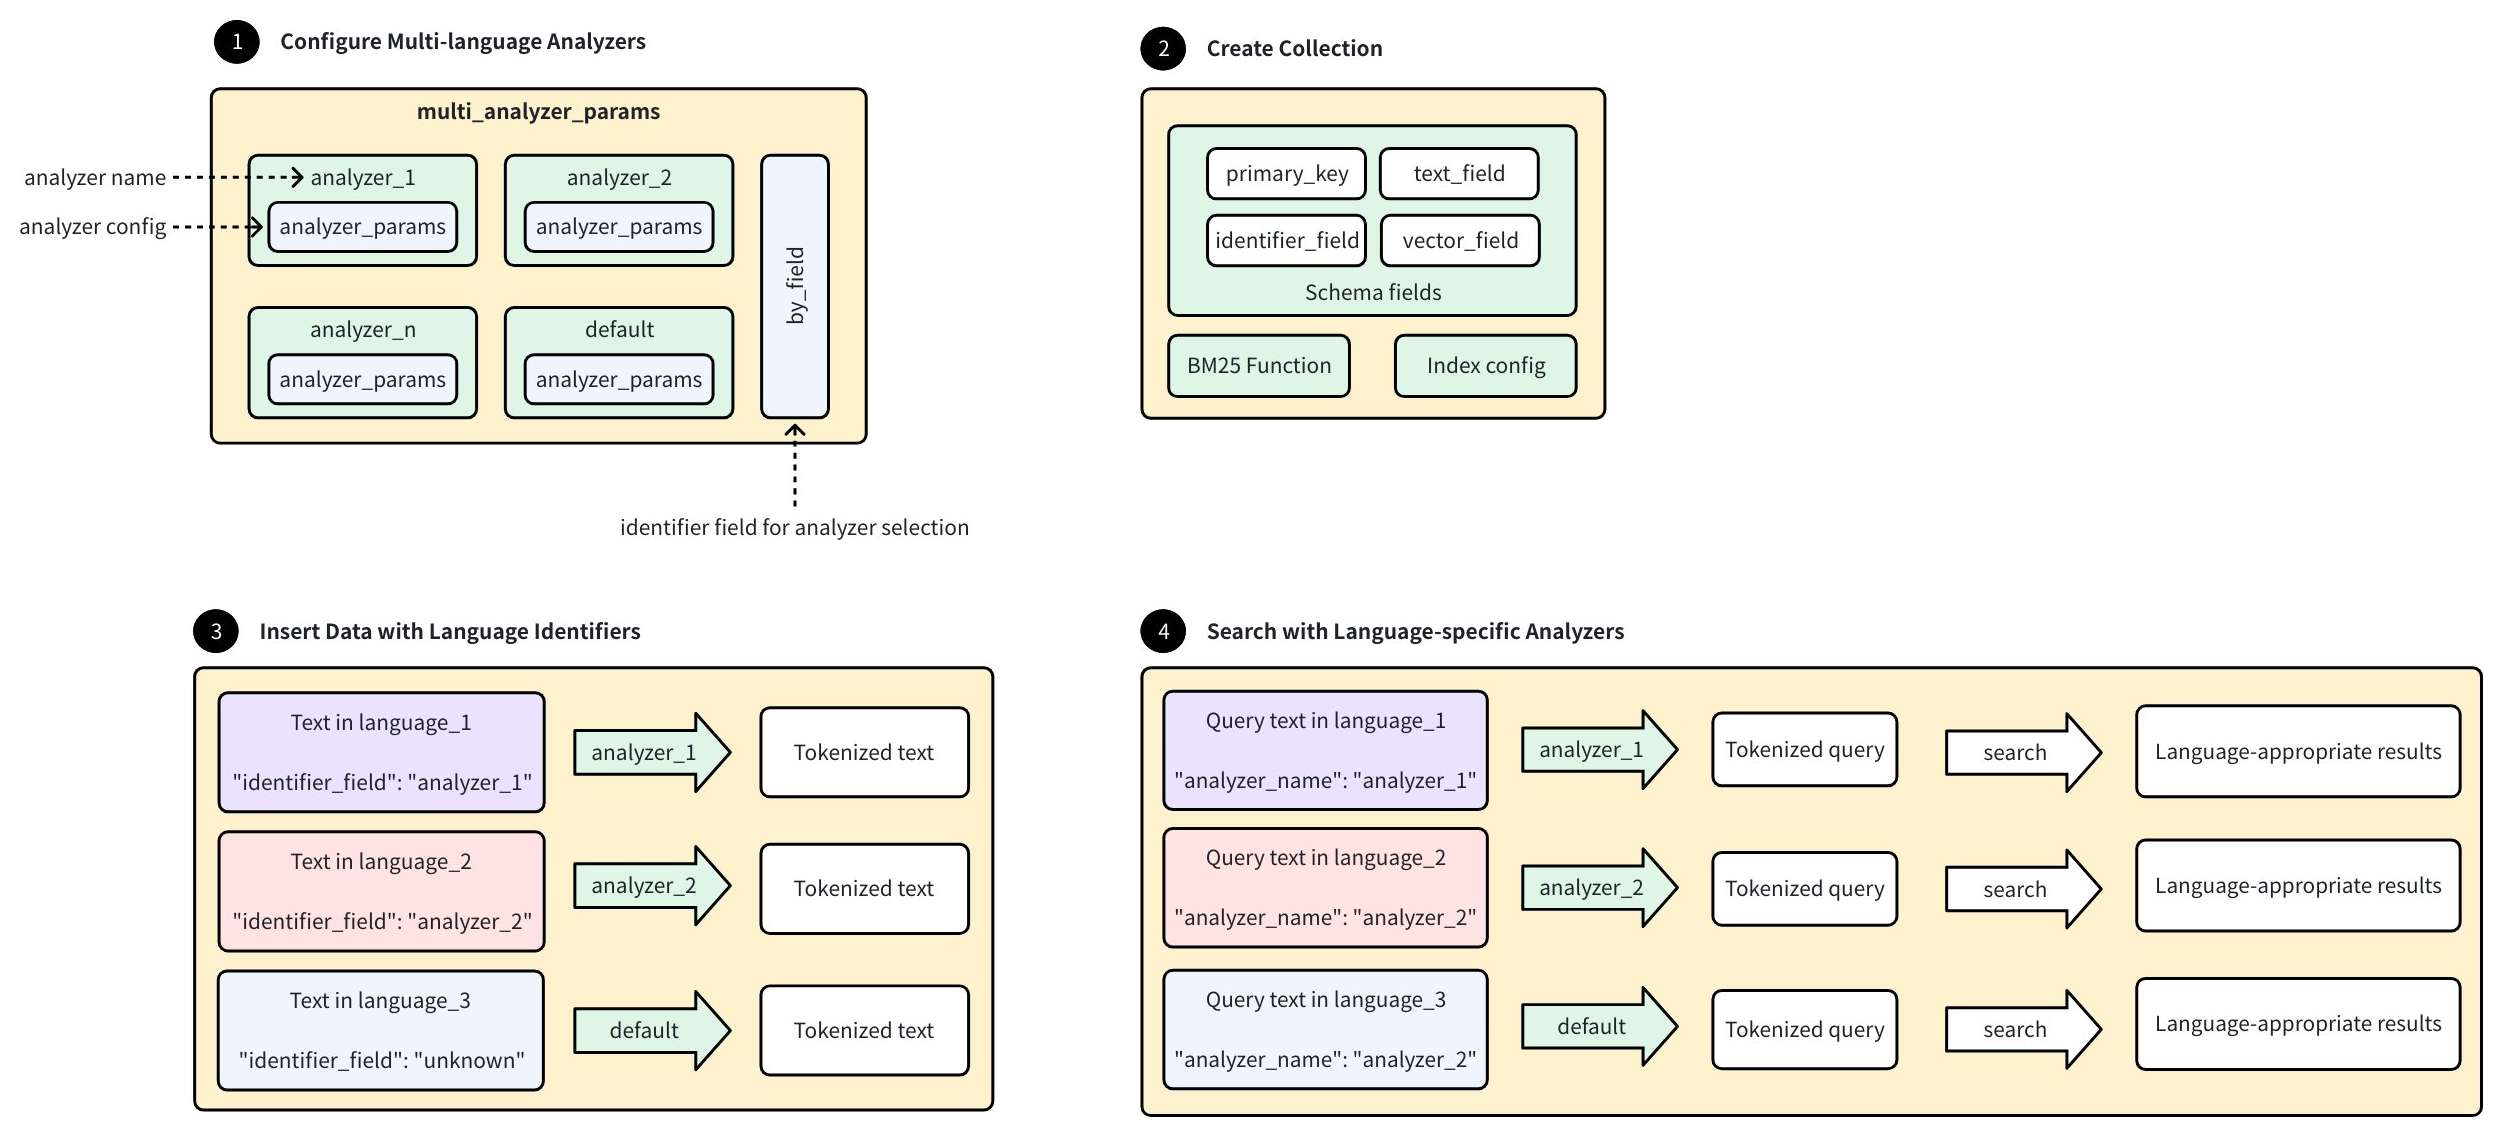
-
多言語アナライザーを設定:
-
<analyzer_name>: <analyzer_config>形式で複数の言語別アナライザーを設定します。各analyzer_configは、Analyzer Overview で説明されている標準のanalyzer_params設定に従います。 -
各ドキュメントに対するアナライザー選択を決定する特別な識別子フィールドを定義します。
-
不明な言語を処理するための
defaultアナライザーを設定します。
-
-
Collection を作成:
-
必須フィールドを含むスキーマを定義します:
-
primary_key: 一意のドキュメント識別子。
-
text_field: 元のテキスト内容を保存します。
-
identifier_field: 各ドキュメントにどのアナライザーを使用するかを示します。
-
vector_field: BM25 関数によって生成される sparse embedding を保存します。
-
-
BM25 関数と indexing パラメータを設定します。
-
-
言語識別子付きでデータを挿入:
-
さまざまな言語のテキストを含むドキュメントを追加します。各ドキュメントには、使用するアナライザーを指定する識別子の値が含まれます。
-
Zilliz Cloud は識別子フィールドに基づいて適切なアナライザーを選択し、不明な識別子を持つドキュメントには
defaultアナライザーを使用します。
-
-
言語固有のアナライザーで検索:
-
アナライザー名を指定したクエリテキストを提供すると、Zilliz Cloud は指定されたアナライザーを使用してクエリを処理します。
-
トークン化は言語固有のルールに従って行われ、検索では類似性に基づいてその言語に適した結果が返されます。
-
ステップ 1: multi_analyzer_params を設定する
multi_analyzer_params は、Zilliz Cloud が各 entity に対して適切なアナライザーをどのように選択するかを決定する単一の JSON オブジェクトです。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
multi_analyzer_params = {
  # Define language-specific analyzers
  # Each analyzer follows this format: <analyzer_name>: <analyzer_params>
  "analyzers": {
    "english": {"type": "english"},          # English-optimized analyzer
    "chinese": {"type": "chinese"},          # Chinese-optimized analyzer
    "default": {"tokenizer": "icu"}          # Required fallback analyzer
  },
  "by_field": "language",                    # Field determining analyzer selection
  "alias": {
    "cn": "chinese",                         # Use "cn" as shorthand for Chinese
    "en": "english"                          # Use "en" as shorthand for English
  }
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("analyzers", new HashMap<String, Object>() {{
    put("english", new HashMap<String, Object>() {{
        put("type", "english");
    }});
    put("chinese", new HashMap<String, Object>() {{
        put("type", "chinese");
    }});
    put("default", new HashMap<String, Object>() {{
        put("tokenizer", "icu");
    }});
}});
analyzerParams.put("by_field", "language");
analyzerParams.put("alias", new HashMap<String, Object>() {{
    put("cn", "chinese");
    put("en", "english");
}});
const multi_analyzer_params = {
  // Define language-specific analyzers
  // Each analyzer follows this format: <analyzer_name>: <analyzer_params>
  "analyzers": {
    "english": {"type": "english"},          # English-optimized analyzer
    "chinese": {"type": "chinese"},          # Chinese-optimized analyzer
    "default": {"tokenizer": "icu"}          # Required fallback analyzer
  },
  "by_field": "language",                    # Field determining analyzer selection
  "alias": {
    "cn": "chinese",                         # Use "cn" as shorthand for Chinese
    "en": "english"                          # Use "en" as shorthand for English
  }
}
multiAnalyzerParams := map[string]any{
    "analyzers": map[string]any{
        "english": map[string]string{"type": "english"},
        "chinese": map[string]string{"type": "chinese"},
        "default": map[string]string{"tokenizer": "icu"},
    },
    "by_field": "language",
    "alias": map[string]string{
        "cn": "chinese",
        "en": "english",
    },
}
# restful
export multi_analyzer_params='{
  "analyzers": {
    "english": {
      "type": "english"
    },
    "chinese": {
      "type": "chinese"
    },
    "default": {
      "tokenizer": "icu"
    }
  },
  "by_field": "language",
  "alias": {
    "cn": "chinese",
    "en": "english"
  }
}'
nlohmann::json multi_analyzer_params = {
    {"analyzers", {
        {"english", {{"type", "english"}}},
        {"chinese", {{"type", "chinese"}}},
        {"default", {{"tokenizer", "icu"}}}
    }},
    {"by_field", "language"},
    {"alias", {{"cn", "chinese"}, {"en", "english"}}}
};
パラメータ | 必須? | 説明 | ルール |
|---|---|---|---|
| Yes | Zilliz Cloud がテキスト処理に使用できる、言語別の各アナライザーを一覧化します。
|
|
| Yes | 各ドキュメントについて、Zilliz Cloud が適用すべき言語(つまりアナライザー名)を保存するフィールド名です。 |
|
| No | アナライザーのショートカット名や別名を作成し、コード内で参照しやすくします。各アナライザーには1つ以上の alias を設定できます。 | 各 alias は既存のアナライザーキーにマッピングされている必要があります。 |
ステップ 2: collection を作成する
多言語対応の collection を作成するには、特定のフィールドと index を設定する必要があります。
ステップ 1: フィールドを追加する
このステップでは、4つの必須フィールドを持つ collection スキーマを定義します。
-
Primary Key Field (
id): collection 内の各 entity の一意な識別子です。auto_id=Trueを設定すると、Zilliz Cloud がこれらの ID を自動生成します。 -
Language Indicator Field (
language): この VARCHAR フィールドは、multi_analyzer_paramsで指定したby_fieldに対応します。各 entity の言語識別子を保存し、Zilliz Cloud にどのアナライザーを使用するかを伝えます。 -
Text Content Field (
text): この VARCHAR フィールドには、分析および検索したい実際のテキストデータを保存します。enable_analyzer=Trueの設定は重要で、このフィールドのテキスト分析機能を有効にします。multi_analyzer_params設定はこのフィールドに直接関連付けられ、テキストデータと言語別アナライザーの接続を確立します。 -
Vector Field (
sparse): このフィールドには、BM25 関数によって生成された sparse vector を保存します。これらのベクトルは、テキストデータの検索可能な形式を表し、Zilliz Cloud が実際に検索対象とするものです。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
# Import required modules
from pymilvus import MilvusClient, DataType, Function, FunctionType

# Initialize client
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
)

# Initialize a new schema
schema = client.create_schema()

# Step 2.1: Add a primary key field for unique document identification
schema.add_field(
    field_name="id",                  # Field name
    datatype=DataType.INT64,          # Integer data type
    is_primary=True,                  # Designate as primary key
    auto_id=True                      # Auto-generate IDs (recommended)
)

# Step 2.2: Add language identifier field
# This MUST match the "by_field" value in language_analyzer_config
schema.add_field(
    field_name="language",       # Field name
    datatype=DataType.VARCHAR,   # String data type
    max_length=255               # Maximum length (adjust as needed)
)

# Step 2.3: Add text content field with multi-language analysis capability
schema.add_field(
    field_name="text",                           # Field name
    datatype=DataType.VARCHAR,                   # String data type
    max_length=8192,                             # Maximum length (adjust based on expected text size)
    enable_analyzer=True,                        # Enable text analysis
    multi_analyzer_params=multi_analyzer_params  # Connect with our language analyzers
)

# Step 2.4: Add sparse vector field to store the BM25 output
schema.add_field(
    field_name="sparse",                   # Field name
    datatype=DataType.SPARSE_FLOAT_VECTOR  # Sparse vector data type
)
import com.google.gson.JsonObject;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.DropCollectionReq;
import io.milvus.v2.service.utility.request.FlushReq;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .build());

CreateCollectionReq.CollectionSchema collectionSchema = CreateCollectionReq.CollectionSchema.builder()
        .build();

collectionSchema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());

collectionSchema.addField(AddFieldReq.builder()
        .fieldName("language")
        .dataType(DataType.VarChar)
        .maxLength(255)
        .build());

collectionSchema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(8192)
        .enableAnalyzer(true)
        .multiAnalyzerParams(analyzerParams)
        .build());

collectionSchema.addField(AddFieldReq.builder()
        .fieldName("sparse")
        .dataType(DataType.SparseFloatVector)
        .build());
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

// Initialize client
const client = new MilvusClient({
  address: "YOUR_CLUSTER_ENDPOINT",
});

// Initialize schema array
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
    auto_id: true,
  },
  {
    name: "language",
    data_type: DataType.VarChar,
    max_length: 255,
  },
  {
    name: "text",
    data_type: DataType.VarChar,
    max_length: 8192,
    enable_analyzer: true,
    analyzer_params: multi_analyzer_params,
  },
  {
    name: "sparse",
    data_type: DataType.SparseFloatVector,
  },
];
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("language").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(255),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(8192).
    WithEnableAnalyzer(true).
    WithMultiAnalyzerParams(multiAnalyzerParams),
).WithField(entity.NewField().
    WithName("sparse").
    WithDataType(entity.FieldTypeSparseVector),
)
# restful
export TOKEN="YOUR_CLUSTER_TOKEN"
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"

export idField='{
  "fieldName": "id",
  "dataType": "Int64",
  "isPrimary": true,
  "autoID": true
}'

export languageField='{
  "fieldName": "language",
  "dataType": "VarChar",
  "elementTypeParams": {
    "max_length": 255
  }
}'

export textField='{
  "fieldName": "text",
  "dataType": "VarChar",
  "elementTypeParams": {
    "max_length": 8192,
    "enable_analyzer": true,
    "multiAnalyzerParam": '"$multi_analyzer_params"'
  },
}'

export sparseField='{
  "fieldName": "sparse",
  "dataType": "SparseFloatVector"
}'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("language", milvus::DataType::VARCHAR)
                    .WithMaxLength(255))
                    .EnableAnalyzer(true)
                    .WithMultiAnalyzerParams(multi_analyzer_params));
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(255));
schema->AddField(milvus::FieldSchema("sparse", milvus::DataType::SPARSE_FLOAT_VECTOR));
ステップ 2: BM25 関数を定義する
生のテキストデータから疎ベクトル表現を生成するために、BM25 関数を定義します。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
# Create the BM25 function
bm25_function = Function(
    name="text_to_vector",            # Descriptive function name
    function_type=FunctionType.BM25,  # Use BM25 algorithm
    input_field_names=["text"],       # Process text from this field
    output_field_names=["sparse"]     # Store vectors in this field
)

# Add the function to our schema
schema.add_function(bm25_function)
CreateCollectionReq.Function function = CreateCollectionReq.Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_to_vector")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("sparse"))
        .build();
collectionSchema.addFunction(function);
const functions = [
  {
    name: "text_bm25_emb",
    description: "bm25 function",
    type: FunctionType.BM25,
    input_field_names: ["text"],
    output_field_names: ["sparse"],
    params: {},
  },
];
function := entity.NewFunction()
schema.WithFunction(function.WithName("text_to_vector").
    WithType(entity.FunctionTypeBM25).
    WithInputFields("text").
    WithOutputFields("sparse"))
# restful
export function='{
  "name": "text_to_vector",
  "type": "BM25",
  "inputFieldNames": ["text"],
  "outputFieldNames": ["sparse"]
}'

export schema="{
  \"autoID\": true,
  \"fields\": [
    $idField,
    $languageField,
    $textField,
    $sparseField
  ],
  \"functions\": [
    $function
  ]
}"
milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_to_vector", milvus::FunctionType::BM25);
function->AddInputFieldName("text");
function->AddOutputFieldName("sparse");
schema->AddFunction(function);
この関数は、言語識別子に基づいて各テキストエントリに適切なアナライザーを自動的に適用します。BM25 ベースのテキスト検索の詳細については、Full Text Search を参照してください。
ステップ 3: インデックスパラメーターを設定する
効率的な検索を可能にするために、疎ベクトルフィールドにインデックスを作成します。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
# Configure index parameters
index_params = client.prepare_index_params()

# Add index for sparse vector field
index_params.add_index(
    field_name="sparse",        # Field to index (our vector field)
    index_type="AUTOINDEX",     # Let Milvus choose optimal index type
    metric_type="BM25"          # Must be BM25 for this feature
)
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("sparse")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.BM25)
        .build());
const index_params = [{
    field_name: "sparse",
    index_type: "AUTOINDEX",
    metric_type: "BM25"
}];
idx := index.NewAutoIndex(index.MetricType(entity.BM25))
indexOption := milvusclient.NewCreateIndexOption("multilingual_documents", "sparse", idx)
# restful
export IndexParams='[
  {
    "fieldName": "sparse",
    "indexType": "AUTOINDEX",
    "metricType": "BM25",
    "params": {}
  }
]'
milvus::IndexDesc index_vector("sparse", "", milvus::IndexType::AUTOINDEX, milvus::MetricType::BM25);
このインデックスは、疎ベクトルを整理して効率的な BM25 類似度計算を可能にすることで、検索性能を向上させます。
ステップ 4: コレクションを作成する
この最後の作成ステップでは、これまでの設定をすべてまとめます。
-
collection_name="multilang_demo"は、今後参照するためのコレクション名を指定します。 -
schema=schemaは、定義したフィールド構造と関数を適用します。 -
index_params=index_paramsは、効率的な検索のためのインデックス作成戦略を実装します。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
# Create collection
COLLECTION_NAME = "multilingual_documents"

# Check if collection already exists
if client.has_collection(COLLECTION_NAME):
    client.drop_collection(COLLECTION_NAME)  # Remove it for this example
    print(f"Dropped existing collection: {COLLECTION_NAME}")

# Create the collection
client.create_collection(
    collection_name=COLLECTION_NAME,       # Collection name
    schema=schema,                         # Our multilingual schema
    index_params=index_params              # Our search index configuration
)
client.dropCollection(DropCollectionReq.builder()
        .collectionName("multilingual_documents")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("multilingual_documents")
        .collectionSchema(collectionSchema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
const COLLECTION_NAME = "multilingual_documents";

// Create the collection
await client.createCollection({
  collection_name: COLLECTION_NAME,
  schema: schema,
  index_params: index_params,
  functions: functions
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("multilingual_documents", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data "{
  \"collectionName\": \"multilingual_documents\",
  \"schema\": $schema,
  \"indexParams\": $IndexParams
}"
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                        .WithCollectionName("multilingual_documents")
                                        .AddIndex(std::move(index_vector))
                                        .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
この時点で、Zilliz Cloud は多言語アナライザーをサポートする空のコレクションを作成し、データを受け取る準備が整います。
ステップ 3: サンプルデータを挿入する
多言語コレクションにドキュメントを追加する際は、それぞれにテキスト内容と言語識別子の両方を含める必要があります。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
# Prepare multilingual documents
documents = [
    # English documents
    {
        "text": "Artificial intelligence is transforming technology",
        "language": "english",  # Using full language name
    },
    {
        "text": "Machine learning models require large datasets",
        "language": "en",  # Using our defined alias
    },
    # Chinese documents
    {
        "text": "人工智能正在改变技术领域",
        "language": "chinese",  # Using full language name
    },
    {
        "text": "机器学习模型需要大型数据集",
        "language": "cn",  # Using our defined alias
    },
]

# Insert the documents
result = client.insert(COLLECTION_NAME, documents)

# Print results
inserted = result["insert_count"]
print(f"Successfully inserted {inserted} documents")
print("Documents by language: 2 English, 2 Chinese")

# Expected output:
# Successfully inserted 4 documents
# Documents by language: 2 English, 2 Chinese
List<String> texts = Arrays.asList(
        "Artificial intelligence is transforming technology",
        "Machine learning models require large datasets",
        "人工智能正在改变技术领域",
        "机器学习模型需要大型数据集"
);
List<String> languages = Arrays.asList(
        "english", "en", "chinese", "cn"
);

List<JsonObject> rows = new ArrayList<>();
for (int i = 0; i < texts.size(); i++) {
    JsonObject row = new JsonObject();
    row.addProperty("text", texts.get(i));
    row.addProperty("language", languages.get(i));
    rows.add(row);
}
client.insert(InsertReq.builder()
        .collectionName("multilingual_documents")
        .data(rows)
        .build());
// Prepare multilingual documents
const documents = [
  // English documents
  {
    text: "Artificial intelligence is transforming technology",
    language: "english",
  },
  {
    text: "Machine learning models require large datasets",
    language: "en",
  },
  // Chinese documents
  {
    text: "人工智能正在改变技术领域",
    language: "chinese",
  },
  {
    text: "机器学习模型需要大型数据集",
    language: "cn",
  },
];

// Insert the documents
const result = await client.insert({
  collection_name: COLLECTION_NAME,
  data: documents,
});

// Print results
const inserted = result.insert_count;
console.log(`Successfully inserted ${inserted} documents`);
console.log("Documents by language: 2 English, 2 Chinese");

// Expected output:
// Successfully inserted 4 documents
// Documents by language: 2 English, 2 Chinese
column1 := column.NewColumnVarChar("text",
    []string{
        "Artificial intelligence is transforming technology",
        "Machine learning models require large datasets",
        "人工智能正在改变技术领域",
        "机器学习模型需要大型数据集",
    })
column2 := column.NewColumnVarChar("language",
    []string{"english", "en", "chinese", "cn"})

_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("multilingual_documents").
    WithColumns(column1, column2),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data '{
  "collectionName": "multilingual_documents",
  "data": [
    {
      "text": "Artificial intelligence is transforming technology",
      "language": "english"
    },
    {
      "text": "Machine learning models require large datasets",
      "language": "en"
    },
    {
      "text": "人工智能正在改变技术领域",
      "language": "chinese"
    },
    {
      "text": "机器学习模型需要大型数据集",
      "language": "cn"
    }
  ]
}'
std::vector<milvus::EntityRow> documents = {
    {{"text", "Artificial intelligence is transforming technology"}, {"language", "english"}},
    {{"text", "Machine learning models require large datasets"}, {"language", "en"}},
    {{"text", "人工智能正在改变技术领域"}, {"language", "chinese"}},
    {{"text", "机器学习模型需要大型数据集"}, {"language", "cn"}}
};

milvus::InsertResponse resp_insert;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("multilingual_documents")
                                .WithRowsData(std::move(documents)),
                            resp_insert);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
挿入時に、Zilliz Cloud は次の処理を行います。
-
各ドキュメントの
languageフィールドを読み取る -
対応するアナライザーを
textフィールドに適用する -
BM25 関数を介して疎ベクトル表現を生成する
-
元のテキストと生成された疎ベクトルの両方を保存する
疎ベクトルを直接指定する必要はありません。BM25 関数が、テキストと指定されたアナライザーに基づいて自動的に生成します。
ステップ 4: 検索操作を実行する
英語アナライザーを使用する
多言語アナライザーで検索する場合、search_params には重要な設定が含まれます。
-
metric_type="BM25"はインデックス設定と一致している必要があります。 -
analyzer_name="english"は、クエリテキストに適用するアナライザーを指定します。これは保存済みドキュメントに使用されたアナライザーとは独立しています。 -
params={"drop_ratio_search": "0"}は BM25 固有の動作を制御します。ここでは、検索内のすべての用語を保持します。詳細については、Sparse Vector を参照してください。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
search_params = {
    "metric_type": "BM25",            # Must match index configuration
    "analyzer_name": "english",  # Analyzer that matches the query language
    "drop_ratio_search": "0",     # Keep all terms in search (tweak as needed)
}

# Execute the search
english_results = client.search(
    collection_name=COLLECTION_NAME,  # Collection to search
    data=["artificial intelligence"],                # Query text
    anns_field="sparse",              # Field to search against
    search_params=search_params,      # Search configuration
    limit=3,                      # Max results to return
    output_fields=["text", "language"],  # Fields to include in the output
    consistency_level="Bounded",       # Data‑consistency guarantee
)

# Display English search results
print("\n=== English Search Results ===")
for i, hit in enumerate(english_results[0]):
    print(f"{i+1}. [{hit.score:.4f}] {hit.entity.get('text')} "
          f"(Language: {hit.entity.get('language')})")

# Expected output (English Search Results):
# 1. [2.7881] Artificial intelligence is transforming technology (Language: english)
Map<String,Object> searchParams = new HashMap<>();
searchParams.put("metric_type", "BM25");
searchParams.put("analyzer_name", "english");
searchParams.put("drop_ratio_search", 0);
SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("multilingual_documents")
        .data(Collections.singletonList(new EmbeddedText("artificial intelligence")))
        .annsField("sparse")
        .topK(3)
        .searchParams(searchParams)
        .outputFields(Arrays.asList("text", "language"))
        .build());

System.out.println("\n=== English Search Results ===");
List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    for (SearchResp.SearchResult result : results) {
        System.out.printf("Score: %f, %s\n", result.getScore(), result.getEntity().toString());
    }
}
// Execute the search
const english_results = await client.search({
  collection_name: COLLECTION_NAME,
  data: ["artificial intelligence"],
  anns_field: "sparse",
  params: {
    metric_type: "BM25",
    analyzer_name: "english",
    drop_ratio_search: "0",
  },
  limit: 3,
  output_fields: ["text", "language"],
  consistency_level: "Bounded",
});

// Display English search results
console.log("\n=== English Search Results ===");
english_results.results.forEach((hit, i) => {
  console.log(
    `${i + 1}. [${hit.score.toFixed(4)}] ${hit.entity.text} ` +
      `(Language: ${hit.entity.language})`
  );
});
annSearchParams := index.NewCustomAnnParam()
annSearchParams.WithExtraParam("metric_type", "BM25")
annSearchParams.WithExtraParam("analyzer_name", "english")
annSearchParams.WithExtraParam("drop_ratio_search", 0)

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "multilingual_documents", // collectionName
    3,                        // limit
    []entity.Vector{entity.Text("artificial intelligence")},
).WithANNSField("sparse").
    WithAnnParam(annSearchParams).
    WithOutputFields("text", "language"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    for i := 0; i < len(resultSet.Scores); i++ {
        text, _ := resultSet.GetColumn("text").GetAsString(i)
        lang, _ := resultSet.GetColumn("language").GetAsString(i)
        fmt.Println("Score: ", resultSet.Scores[i], "Text: ", text, "Language:", lang)
    }
}
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data '{
  "collectionName": "multilingual_documents",
  "data": ["artificial intelligence"],
  "annsField": "sparse",
  "limit": 3,
  "searchParams": {
    "metric_type": "BM25",
    "analyzer_name": "english",
    "drop_ratio_search": "0"
  },
  "outputFields": ["text", "language"],
  "consistencyLevel": "Strong"
}'
auto request = milvus::SearchRequest()
                   .WithCollectionName("multilingual_documents")
                   .AddEmbeddedText("artificial intelligence");
                   .WithAnnsField("sparse")
                   .WithLimit(3)
                   .AddExtraParam("metric_type", "BM25")
                   .AddExtraParam("analyzer_name", "english")
                   .AddExtraParam("drop_ratio_search", "9")
                   .AddOutputField("text")
                   .AddOutputField("language")
                   .WithConsistencyLevel(milvus::ConsistencyLevel::STRONG);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
中国語アナライザーを使用する
この例では、異なるクエリテキストに対して中国語アナライザー(エイリアス "cn" を使用)へ切り替える方法を示します。その他のすべてのパラメータは同じままですが、クエリテキストは中国語固有のトークン化ルールを使用して処理されます。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
search_params["analyzer_name"] = "cn"

chinese_results = client.search(
    collection_name=COLLECTION_NAME,  # Collection to search
    data=["人工智能"],                # Query text
    anns_field="sparse",              # Field to search against
    search_params=search_params,      # Search configuration
    limit=3,                      # Max results to return
    output_fields=["text", "language"],  # Fields to include in the output
    consistency_level="Bounded",       # Data‑consistency guarantee
)

# Display Chinese search results
print("\n=== Chinese Search Results ===")
for i, hit in enumerate(chinese_results[0]):
    print(f"{i+1}. [{hit.score:.4f}] {hit.entity.get('text')} "
          f"(Language: {hit.entity.get('language')})")

# Expected output (Chinese Search Results):
# 1. [3.3814] 人工智能正在改变技术领域 (Language: chinese)
searchParams.put("analyzer_name", "cn");
searchResp = client.search(SearchReq.builder()
        .collectionName("multilingual_documents")
        .data(Collections.singletonList(new EmbeddedText("人工智能")))
        .annsField("sparse")
        .topK(3)
        .searchParams(searchParams)
        .outputFields(Arrays.asList("text", "language"))
        .build());

System.out.println("\n=== Chinese Search Results ===");
searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    for (SearchResp.SearchResult result : results) {
        System.out.printf("Score: %f, %s\n", result.getScore(), result.getEntity().toString());
    }
}
// Execute the search
const cn_results = await client.search({
  collection_name: COLLECTION_NAME,
  data: ["人工智能"],
  anns_field: "sparse",
  params: {
    metric_type: "BM25",
    analyzer_name: "cn",
    drop_ratio_search: "0",
  },
  limit: 3,
  output_fields: ["text", "language"],
  consistency_level: "Bounded",
});

// Display Chinese search results
console.log("\n=== Chinese Search Results ===");
cn_results.results.forEach((hit, i) => {
  console.log(
    `${i + 1}. [${hit.score.toFixed(4)}] ${hit.entity.text} ` +
      `(Language: ${hit.entity.language})`
  );
});
annSearchParams.WithExtraParam("analyzer_name", "cn")

resultSets, err = client.Search(ctx, milvusclient.NewSearchOption(
    "multilingual_documents", // collectionName
    3,                        // limit
    []entity.Vector{entity.Text("人工智能")},
).WithANNSField("sparse").
    WithAnnParam(annSearchParams).
    WithOutputFields("text", "language"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    for i := 0; i < len(resultSet.Scores); i++ {
        text, _ := resultSet.GetColumn("text").GetAsString(i)
        lang, _ := resultSet.GetColumn("language").GetAsString(i)
        fmt.Println("Score: ", resultSet.Scores[i], "Text: ", text, "Language:", lang)
    }
}
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data '{
  "collectionName": "multilingual_documents",
  "data": ["人工智能"],
  "annsField": "sparse",
  "limit": 3,
  "searchParams": {
    "analyzer_name": "cn"
  },
  "outputFields": ["text", "language"],
  "consistencyLevel": "Strong"
}'
auto request = milvus::SearchRequest()
                   .WithCollectionName("multilingual_documents")
                   .AddEmbeddedText("人工智能");
                   .WithAnnsField("sparse")
                   .WithLimit(3)
                   .AddExtraParam("metric_type", "BM25")
                   .AddExtraParam("analyzer_name", "cn")
                   .AddExtraParam("drop_ratio_search", "0")
                   .AddOutputField("text")
                   .AddOutputField("language")
                   .WithConsistencyLevel(milvus::ConsistencyLevel::STRONG);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}