Weighted Ranker
Weighted Ranker は、各検索パスに異なる重要度の重みを割り当てることで、複数の検索パスから得られた結果をインテリジェントに統合して優先順位を付けます。熟練したシェフが複数の材料を調整して完璧な料理を作るのと同じように、Weighted Ranker は異なる検索結果のバランスを取り、最も関連性の高い統合結果を実現します。このアプローチは、複数のベクトルフィールドやモダリティを横断して検索し、特定のフィールドを最終順位で他のフィールドよりも大きく貢献させる必要がある場合に最適です。
Weighted Ranker を使用する場合
Weighted Ranker は、複数のベクトル検索パスから得られた結果を統合する必要があるハイブリッド検索シナリオ向けに特別に設計されています。特に次のような場合に効果的です。
ユースケース | 例 | Weighted Ranker が有効な理由 |
|---|---|---|
E コマース検索 | 画像の類似度とテキストの説明を組み合わせた商品検索 | ファッション商品では視覚的な類似度を優先し、技術系商品ではテキストの説明を重視できるようにします。 |
メディアコンテンツ検索 | 視覚的特徴と音声文字起こしの両方を使用した動画検索 | クエリの意図に基づいて、視覚コンテンツと会話の重要度のバランスを取ります。 |
ドキュメント検索 | セクションごとに複数の埋め込みを使用した企業ドキュメント検索 | 全文の埋め込みも考慮しつつ、タイトルと要約の埋め込みに高い重みを割り当てます。 |
ハイブリッド検索アプリケーションで、複数の検索パスを組み合わせつつ、それらの相対的な重要度を制御する必要がある場合は、Weighted Ranker が理想的な選択肢です。
Weighted Ranker の仕組み
WeightedRanker 戦略の主なワークフローは次のとおりです。
-
検索スコアの収集: ベクトル検索の各パスから結果とスコア(score_1、score_2)を収集します。
-
スコアの正規化: 各検索では異なる類似度メトリックを使用する可能性があるため、スコア分布が異なります。たとえば、類似度タイプとして内積(IP)を使用するとスコアの範囲が [−∞,+∞] になる可能性がある一方、ユークリッド距離(L2)を使用するとスコアの範囲は [0,+∞] になります。異なる検索のスコア範囲は異なり、直接比較できないため、各検索パスのスコアを正規化する必要があります。通常は
arctan関数を適用してスコアを [0, 1] の範囲に変換します(score_1_normalized、score_2_normalized)。1 に近いスコアほど、類似度が高いことを示します。 -
重みの割り当て: 異なるベクトルフィールドに割り当てられた重要度に基づいて、正規化されたスコア(score_1_normalized、score_2_normalized)に重み(wi)を割り当てます。各パスの重みは [0,1] の範囲にする必要があります。得られる重み付きスコアは score_1_weighted と score_2_weighted です。
-
スコアの統合: 重み付きスコア(score_1_weighted、score_2_weighted)を高い順にランク付けし、最終的なスコアセット(score_final)を生成します。
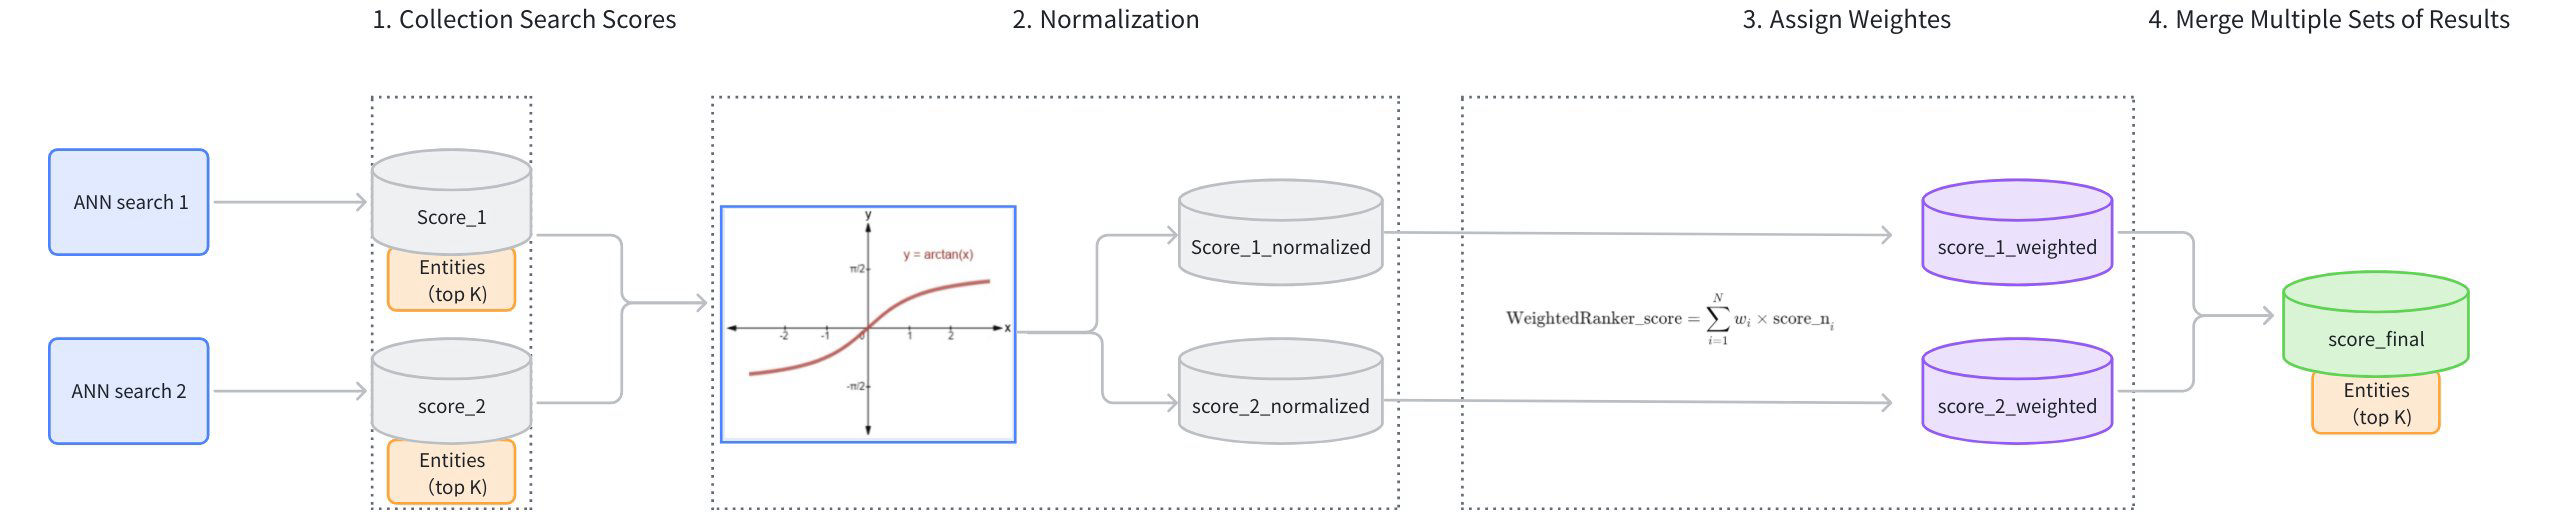
Weighted Ranker の例
この例では、画像とテキストを対象とするマルチモーダルハイブリッド検索(topK=5)を示し、WeightedRanker 戦略が 2 つの ANN 検索の結果をどのように再ランキングするかを説明します。
-
画像に対する ANN 検索の結果(topK=5):
ID
スコア(画像)
101
0.92
203
0.88
150
0.85
198
0.83
175
0.8
-
テキストに対する ANN 検索の結果(topK=5):
ID
スコア(テキスト)
198
0.91
101
0.87
110
0.85
175
0.82
250
0.78
-
WeightedRanker を使用して、画像検索とテキスト検索の結果に重みを割り当てます。画像 ANN 検索の重みを 0.6、テキスト検索の重みを 0.4 とします。
ID
スコア(画像)
スコア(テキスト)
重み付きスコア
101
0.92
0.87
0.6×0.92+0.4×0.87=0.90
203
0.88
N/A
0.6×0.88+0.4×0=0.528
150
0.85
N/A
0.6×0.85+0.4×0=0.51
198
0.83
0.91
0.6×0.83+0.4×0.91=0.86
175
0.80
0.82
0.6×0.80+0.4×0.82=0.81
110
画像に存在しない
0.85
0.6×0+0.4×0.85=0.34
250
画像に存在しない
0.78
0.6×0+0.4×0.78=0.312
-
再ランキング後の最終結果(topK=5):
順位
ID
最終スコア
1
101
0.90
2
198
0.86
3
175
0.81
4
203
0.528
5
150
0.51
Weighted Ranker の使用方法
WeightedRanker 戦略を使用する場合、重みの値を入力する必要があります。入力する重みの値の数は、ハイブリッド検索の基本 ANN 検索リクエストの数に対応している必要があります。入力する重みの値は [0,1] の範囲内である必要があり、1 に近い値ほど重要度が高いことを示します。
Weighted Ranker の作成
たとえば、ハイブリッド検索にテキスト検索と画像検索という 2 つの基本 ANN 検索リクエストがあるとします。テキスト検索の重要度が高いと見なされる場合は、より大きな重みを割り当てる必要があります。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import Function, FunctionType

rerank = Function(
    name="weight",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "weighted",
        "weights": [0.1, 0.9],
        "norm_score": True  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.Function rerank = CreateCollectionReq.Function.builder()
                .name("weight")
                .functionType(FunctionType.RERANK)
                .param("reranker", "weighted")
                .param("weights", "[0.1, 0.9]")
                .param("norm_score", "true")
                .build();
import "github.com/milvus-io/milvus/client/v3/entity"

rerank := entity.NewFunction().
    WithName("weight").
    WithType(entity.FunctionTypeRerank).
    WithInputFields().
    WithParam("reranker", "weighted").
    WithParam("weights", "[0.1, 0.9]").
    WithParam("norm_score", "true")
use milvus::v2::prelude::*;
use std::collections::HashMap;

let rerank = Function::new()
    .name("weight")
    .function_type(FunctionType::Rerank)
    .input_fields(Vec::<String>::new())
    .params(HashMap::from([
        ("reranker".into(), "weighted".into()),
        ("weights".into(), "[0.1, 0.9]".into()),
        ("norm_score".into(), "true".into()),
    ]));
#include <memory>
#include "milvus/MilvusClientV2.h"

auto rerank = std::make_shared<milvus::Function>("weight", milvus::FunctionType::RERANK);
rerank->AddParam("reranker", "weighted");
rerank->AddParam("weights", "[0.1, 0.9]");
rerank->AddParam("norm_score", "true");
import { FunctionType } from '@zilliz/milvus2-sdk-node';

const rerank = {
    name: "weight",
    input_field_names: [],
    type: FunctionType.RERANK,
    params: {
        reranker: "weighted",
        weights: [0.1, 0.9],
        norm_score: true
    }
};
using Milvus.Client.V2;

// Note: defining a weighted rerank function with FunctionSchema params
// (reranker/weights/norm_score) is not yet supported in milvus-sdk-csharp as of v3.0.0
// (FunctionSchema.Params cannot be populated externally). Use WeightedReranker instead.
# Restful
export rerank='{
  "name": "weight",
  "inputFieldNames": [],
  "functionType": "RERANK",
  "params": {
    "reranker": "weighted",
    "weights": "[0.1, 0.9]",
    "norm_score": "true"
  }
}'
パラメーター | 必須 | 説明 | 値/Example |
|---|---|---|---|
| はい | この Function の一意の識別子 |
|
| はい | 関数を適用するベクトルフィールドのリストです(Weighted Ranker の場合は空にする必要があります)。 | [] |
| はい | 呼び出す Function のタイプです。再ランキング戦略を指定するには |
|
| はい | 使用する再ランキング方法を指定します。 Weighted Ranker を使用するには、 |
|
| はい | 各検索パスに対応する重みの配列です。値は [0,1] の範囲です。 詳細については、Weighted Ranker の仕組み を参照してください。 |
|
| いいえ | 重み付けの前に生のスコアを正規化するかどうか(arctan を使用)。 詳細については、Weighted Ranker の仕組み を参照してください。 |
|
ハイブリッド検索に適用する
Weighted Ranker は、複数のベクトルフィールドを組み合わせるハイブリッド検索操作向けに特別に設計されています。ハイブリッド検索を実行する際は、各検索パスの重みを指定する必要があります:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient, AnnSearchRequest

# Connect to your cluster
milvus_client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# Assume you have a collection setup

# Define text vector search request
text_search = AnnSearchRequest(
    data=["modern dining table"],
    anns_field="text_vector",
    param={},
    limit=10
)

# Define image vector search request
image_search = AnnSearchRequest(
    data=[image_embedding],  # Image embedding vector
    anns_field="image_vector",
    param={},
    limit=10
)

# Apply Weighted Ranker to product hybrid search
# Text search has 0.8 weight, image search has 0.3 weight
hybrid_results = milvus_client.hybrid_search(
    collection_name,
    [text_search, image_search],  # Multiple search requests
    ranker=rerank,  # Apply the weighted ranker
    limit=10,
    output_fields=["product_name", "price", "category"]
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.request.data.FloatVec;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_vector")
        .vectors(Collections.singletonList(new EmbeddedText("modern dining table")))
        .limit(10)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_vector")
        .vectors(Collections.singletonList(new FloatVec(imageEmbedding)))
        .limit(10)
        .build());

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
                .collectionName(COLLECTION_NAME)
                .searchRequests(searchRequests)
                .ranker(rerank)
                .limit(10)
                .outputFields(Arrays.asList("product_name", "price", "category"))
                .build();
SearchResp searchResp = client.hybridSearch(hybridSearchReq);
import (
    "context"
    "log"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

// Define two ANN sub-search requests
textSearch := milvusclient.NewAnnRequest("text_vector", 10, []entity.Vector{textEmbedding}...).WithSearchParam("metric_type", "COSINE")
imageSearch := milvusclient.NewAnnRequest("image_vector", 10, []entity.Vector{imageEmbedding}...).WithSearchParam("metric_type", "IP")

// Apply Weighted Ranker: text search has 0.8 weight, image search has 0.3 weight
rerank := milvusclient.NewWeightedReranker([]float64{0.8, 0.3})

hybridResults, err := cli.HybridSearch(ctx, milvusclient.NewHybridSearchOption(collectionName, 10, textSearch, imageSearch).
    WithReranker(rerank).
    WithOutputFields("product_name", "price", "category"))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;

// Define two ANN sub-search requests
let text_search = SubSearchRequest::builder()
    .vector_field("text_vector")
    .vectors(SearchVectors::Float(vec![text_embedding]))
    .metric_type(MetricType::Cosine)
    .limit(10)
    .build()?;
let image_search = SubSearchRequest::builder()
    .vector_field("image_vector")
    .vectors(SearchVectors::Float(vec![image_embedding]))
    .metric_type(MetricType::Ip)
    .limit(10)
    .build()?;

// Apply Weighted Ranker: text search has 0.8 weight, image search has 0.3 weight
let rerank = WeightedRerank::new().weights(vec![0.8, 0.3]);

let response = client
    .hybrid_search(
        HybridSearchRequest::builder()
            .collection_name(collection_name)
            .sub_requests(vec![text_search, image_search])
            .rerank(rerank)
            .limit(10)
            .output_fields(["product_name", "price", "category"])
            .build()?,
    )
    .await?;
#include <iostream>
#include <memory>
#include <utility>
#include "milvus/MilvusClientV2.h"

auto text_search = milvus::SubSearchRequest()
                    .WithLimit(10)
                    .WithAnnsField("text_vector")
                    .AddEmbeddedText("modern dining table");

auto image_search = milvus::SubSearchRequest()
                    .WithLimit(10)
                    .WithAnnsField("image_vector")
                    .AddFloatVector(image_embedding);

auto request = milvus::HybridSearchRequest()
                    .WithCollectionName(collection_name)
                    .WithLimit(10)
                    .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(text_search)))
                    .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(image_search)))
                    .WithRerank(rerank)
                    .AddOutputField("product_name")
                    .AddOutputField("price")
                    .AddOutputField("category");

milvus::SearchResponse response;
auto status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const milvusClient = new MilvusClient({
  address: "YOUR_CLUSTER_ENDPOINT",
  token: "YOUR_CLUSTER_TOKEN",
});

const text_search = {
  data: ["modern dining table"],
  anns_field: "text_vector",
  params: {},
};

const image_search = {
  data: [image_embedding],
  anns_field: "image_vector",
  params: {},
};

const search = await milvusClient.search({
  collection_name: collection_name,
  limit: 10,
  data: [text_search, image_search],
  rerank: rerank,
  output_fields: ["product_name", "price", "category"],
});
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Collection;
using Milvus.Client.V2.Requests.Dml;
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Requests.Index;
using Milvus.Client.V2.Types;

var client = new MilvusClientV2(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    ApiKey = "YOUR_CLUSTER_TOKEN"
});

// Define text vector search request
var textSearch = new AnnSearchReq
{
    VectorFieldName = "text_vector",
    Texts = new[] { "modern dining table" },
    Limit = 10
};

// Define image vector search request
var imageSearch = new AnnSearchReq
{
    VectorFieldName = "image_vector",
    Vectors = new[] { new ReadOnlyMemory<float>(imageEmbedding) },  // Image embedding vector
    Limit = 10
};

// Apply Weighted Ranker to product hybrid search
// Text search has 0.8 weight, image search has 0.3 weight
var hybridResults = await client.HybridSearchAsync(new HybridSearchReq
{
    CollectionName = collectionName,
    SearchRequests = new[] { textSearch, imageSearch },  // Multiple search requests
    Reranker = rerank,  // Apply the weighted ranker
    Limit = 10,
    Parameters = new SearchParameters { OutputFields = { "product_name", "price", "category" } }
});
# restful
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"${COLLECTION_NAME}\",
    \"search\": [
        {
            \"annsField\": \"text_vector\",
            \"data\": [\"modern dining table\"],
            \"params\": { \"metric_type\": \"COSINE\" },
            \"limit\": 10
        },
        {
            \"annsField\": \"image_vector\",
            \"data\": [${IMAGE_EMBEDDING}],
            \"params\": { \"metric_type\": \"IP\" },
            \"limit\": 10
        }
    ],
    \"rerank\": ${rerank},
    \"limit\": 10,
    \"outputFields\": [\"product_name\", \"price\", \"category\"]
}"
ハイブリッド検索の詳細については、マルチベクトルハイブリッド検索 を参照してください。