検索のためのデータモデル設計
情報検索システムは検索エンジンとも呼ばれ、検索拡張生成(RAG)、画像検索、商品レコメンデーションなど、さまざまな AI アプリケーションに不可欠です。こうしたシステムの中核となるのが、情報を整理、インデックス化、検索するための慎重に設計されたデータモデルです。
Zilliz Cloud では、コレクションスキーマを通じて検索データモデルを指定でき、非構造化データ、その密ベクトルまたは疎ベクトル表現、構造化メタデータを整理できます。テキスト、画像、その他のデータ型を扱う場合でも、このハンズオンガイドは、主要なスキーマの概念を理解し、実際に検索データモデルを設計するために適用するのに役立ちます。
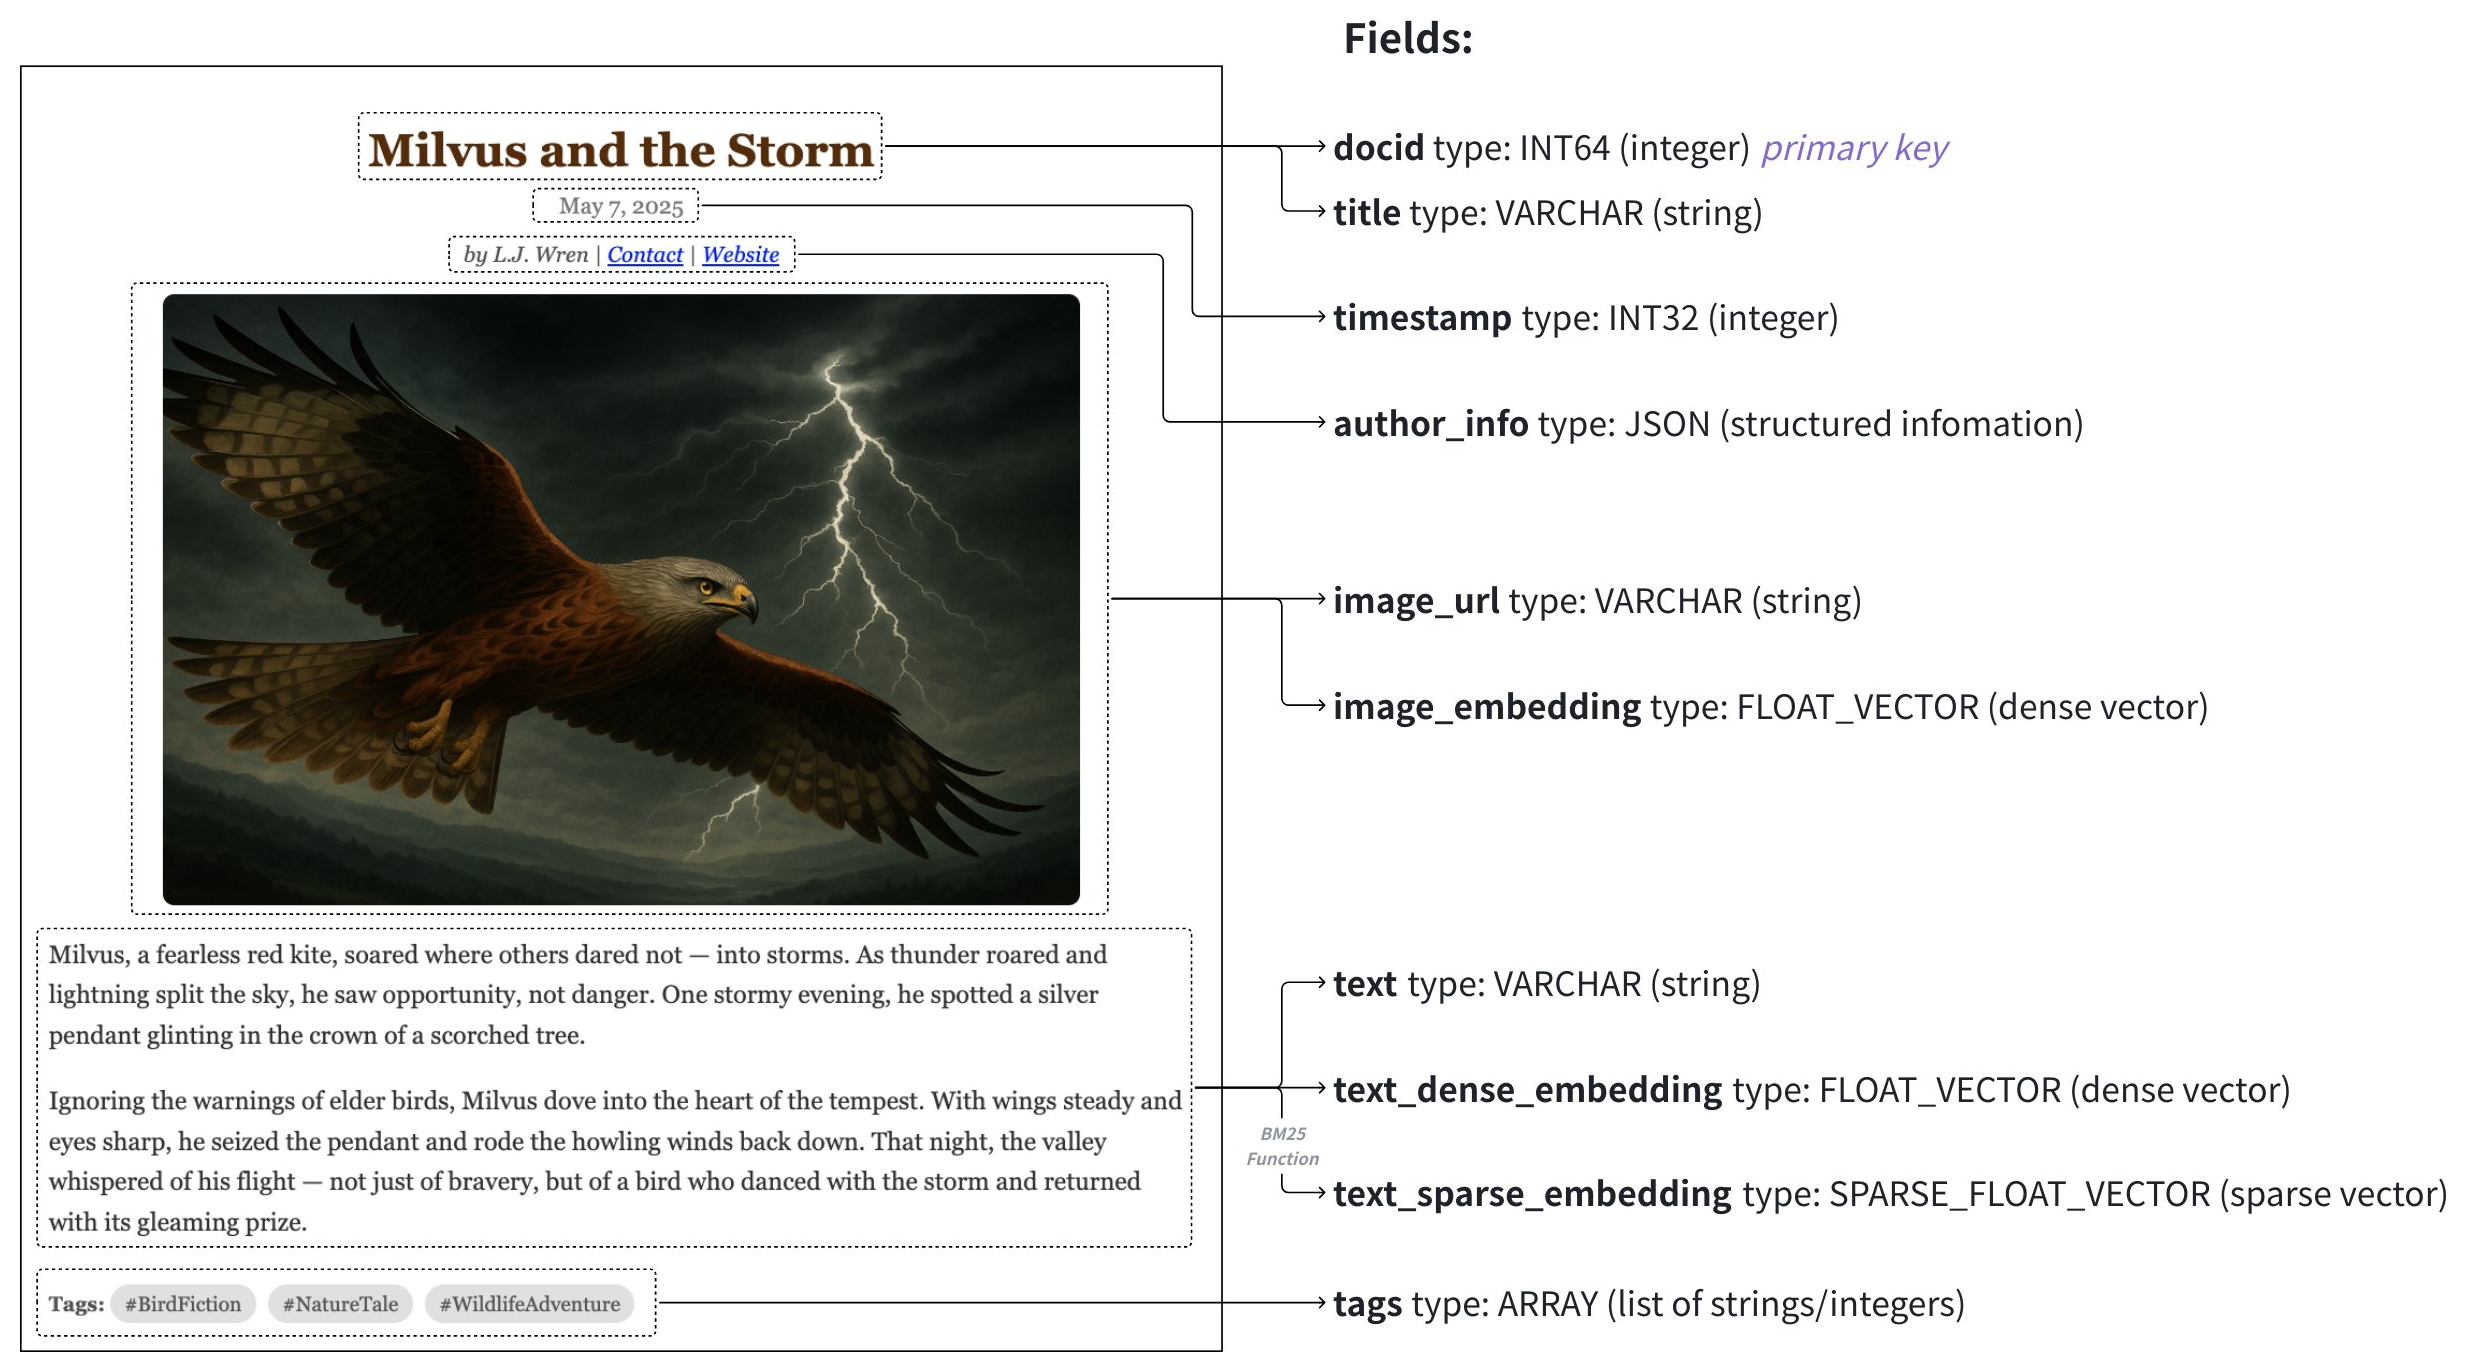
データモデル
検索システムのデータモデル設計では、ビジネスニーズを分析し、情報をスキーマで表現されたデータモデルに抽象化します。適切に定義されたスキーマは、データモデルをビジネス目標に合わせ、データの整合性とサービス品質を確保するうえで重要です。また、適切なデータ型とインデックスを選択することは、ビジネス目標を経済的に達成するうえで重要です。
ビジネスニーズの分析
ビジネスニーズに効果的に対応するには、まずユーザーが実行するクエリの種類を分析し、最も適切な検索方法を決定します。
-
ユーザークエリ: ユーザーが実行すると想定されるクエリの種類を特定します。これにより、スキーマが実際のユースケースをサポートし、検索パフォーマンスを最適化できるようになります。クエリには次のようなものがあります。
-
自然言語クエリに一致するドキュメントを取得する
-
参照画像に類似する画像を検索する、またはテキストの説明に一致する画像を検索する
-
名前、カテゴリ、ブランドなどの属性で商品を検索する
-
構造化メタデータ(公開日、タグ、評価など)に基づいて項目をフィルタリングする
-
ハイブリッドクエリで複数の条件を組み合わせる(例: 画像検索で、画像とそのキャプションの両方の意味的類似性を考慮する)
-
-
検索方法: ユーザーが実行するクエリの種類に合った適切な検索手法を選択します。それぞれの方法は異なる目的を果たし、多くの場合、組み合わせることでより強力な結果を得られます。
-
セマンティック検索: 密ベクトルの類似性を使用して、意味が類似する項目を検索します。テキストや画像などの非構造化データに適しています。
-
全文検索: キーワードマッチングによってセマンティック検索を補完します。全文検索では字句解析を利用して、長い単語を断片化されたトークンに分割しないようにし、検索時に特殊な用語を把握できます。
-
メタデータフィルタリング: ベクトル検索に加えて、日付範囲、カテゴリ、タグなどの制約を適用します。
-
ビジネス要件を検索データモデルに変換する
次のステップでは、情報の主要な構成要素とその検索方法を特定することで、ビジネス要件を具体的なデータモデルに変換します。
-
保存する必要があるデータを定義します。たとえば、生のコンテンツ(テキスト、画像、音声)、関連するメタデータ(タイトル、タグ、著者情報)、コンテキスト属性(タイムスタンプ、ユーザー行動など)です。
-
各要素に適切なデータ型と形式を決定します。たとえば、次のとおりです。
-
テキストの説明 → string
-
画像またはドキュメントの埋め込み → 密ベクトルまたは疎ベクトル
-
カテゴリ、タグ、フラグ → string、array、bool
-
価格や評価などの数値属性 → integer または float
-
著者情報などの構造化情報 -> json
-
これらの要素を明確に定義することで、データの整合性、正確な検索結果、および下流のアプリケーションロジックとの統合の容易さが確保されます。
スキーマ設計
Zilliz Cloud では、データモデルはコレクションスキーマを通じて表現されます。コレクションスキーマ内で適切なフィールドを設計することが、効果的な取得を実現する鍵となります。各フィールドはコレクションに保存される特定の種類のデータを定義し、検索プロセスにおいて独自の役割を果たします。大まかに言うと、Zilliz Cloud は ベクトルフィールド と スカラーフィールド という 2 つの主要なフィールドタイプをサポートしています。
データモデルは、ベクトルと補助的なスカラーフィールドを含むフィールドのスキーマにマッピングできます。各フィールドがデータモデルの属性と対応していることを確認し、特にベクトルタイプ(密または疎)とその次元に注意してください。
ベクトルフィールド
ベクトルフィールドには、テキスト、画像、音声などの非構造化データ型の埋め込みが保存されます。これらの埋め込みは、データ型と使用する取得方法に応じて、密、疎、またはバイナリになります。通常、密ベクトルはセマンティック検索に使用され、疎ベクトルは全文一致または字句一致に適しています。バイナリベクトルは、ストレージと計算リソースが限られている場合に役立ちます。コレクションには複数のベクトルフィールドを含めることができ、マルチモーダルまたはハイブリッドな取得戦略を可能にします。このトピックの詳細なガイドについては、マルチベクトルハイブリッド検索 を参照してください。
Zilliz Cloud では、FLOAT_VECTOR(密ベクトル)、SPARSE_FLOAT_VECTOR(疎ベクトル)、BINARY_VECTOR(バイナリベクトル)のベクトルデータ型をサポートしています。
スカラーおよび複合フィールド
スカラーフィールドには、数値、文字列、日付などのプリミティブで構造化された値(一般にメタデータと呼ばれます)が保存されます。これらの値はベクトル検索結果とともに返すことができ、フィルタリングと並べ替えに不可欠です。これにより、特定の属性に基づいて検索結果を絞り込めます。たとえば、ドキュメントを特定のカテゴリや定義された期間に限定できます。
Zilliz Cloud では、BOOL、INT8/16/32/64、FLOAT、DOUBLE、VARCHAR などのスカラー型に加え、JSON や ARRAY などの複合型をサポートしており、非ベクトルデータの保存とフィルタリングに使用できます。これらの型により、検索操作の精度とカスタマイズ性が向上します。
スキーマ設計で高度な機能を活用する
スキーマを設計する際、サポートされているデータ型を使用してデータをフィールドにマッピングするだけでは十分ではありません。フィールド間の関係と、構成に利用できる戦略を十分に理解することが重要です。設計フェーズで主要な機能を念頭に置くことで、スキーマが当面のデータ処理要件を満たすだけでなく、将来のニーズに対してスケーラブルかつ適応可能になります。これらの機能を慎重に統合することで、Zilliz Cloud の機能を最大化し、より広範なデータ戦略と目標をサポートする強固なデータアーキテクチャを構築できます。コレクションスキーマを作成する主要な機能の概要は次のとおりです。
プライマリキー
プライマリキーフィールドは、コレクション内の各エンティティを一意に識別するため、スキーマの基本的な構成要素です。プライマリキーの定義は必須です。整数型または文字列型のスカラーフィールドであり、is_primary=True とマークする必要があります。オプションで、プライマリキーに auto_id を有効にできます。この場合、コレクションに取り込まれるデータが増えるにつれて単調に増加する整数値が自動的に割り当てられます。
詳細は、Primary Field & AutoID を参照してください。
パーティショニング
検索を高速化するには、オプションでパーティショニングを有効にできます。特定のスカラーフィールドをパーティショニングに指定し、検索時にこのフィールドに基づくフィルタリング条件を指定することで、検索範囲を関連するパーティションのみに効果的に制限できます。この方法は、検索対象の領域を減らすことで、取得操作の効率を大幅に向上させます。
詳細は、Use Partition Key を参照してください。
アナライザー
アナライザーは、テキストデータを処理および変換するための不可欠なツールです。その主な機能は、生のテキストをトークンに変換し、インデックス作成と取得のために構造化することです。文字列をトークン化し、ストップワードを削除し、個々の単語をステミングしてトークンに変換することで、これを実現します。
詳細は、Analyzer Overview を参照してください。
関数
Zilliz Cloud では、スキーマの一部として組み込み関数を定義し、特定のフィールドを自動的に導出できます。たとえば、VARCHAR フィールドから疎ベクトルを生成して全文検索をサポートする組み込みの BM25 関数を追加できます。これらの関数から導出されるフィールドは前処理を合理化し、コレクションが自己完結的でクエリ可能な状態に保たれることを保証します。
詳細は、Full Text Search を参照してください。
実際の例
このセクションでは、上図に示すマルチメディアドキュメント検索アプリケーションのスキーマ設計とコード例を説明します。このスキーマは、記事を含むデータセットを管理するように設計されており、データは次のフィールドにマッピングされます。
| フィールド | データソース | 検索方法での使用 | プライマリキー | パーティションキー | アナライザー | 関数の入力/Output |
|---|---|---|---|---|---|---|
article_id (INT64) | auto_id を有効にして自動生成 | Get を使用するクエリ | Y | N | N | N |
title (VARCHAR) | 記事のタイトル | テキスト一致 | N | N | Y | N |
timestamp (INT32) | 公開日 | パーティションキーによるフィルタリング | N | Y | N | N |
text (VARCHAR) | 記事の生テキスト | マルチベクトルハイブリッド検索 | N | N | Y | 入力 |
text_dense_vector (FLOAT_VECTOR) | テキスト埋め込みモデルによって生成された密ベクトル | 基本的なベクトル検索 | N | N | N | N |
text_sparse_vector (SPARSE_FLOAT_VECTOR) | 組み込み BM25 関数によって自動生成された疎ベクトル | 全文検索 | N | N | N | 出力 |
スキーマの詳細と、さまざまな種類のフィールドを追加する方法の詳細なガイダンスについては、スキーマ Explained を参照してください。
ステップ 1: スキーマを初期化する
まず、空のスキーマを作成する必要があります。このステップでは、データモデルを定義するための基盤構造を確立します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient

schema = MilvusClient.create_schema()
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// 1. Connect to Milvus server
ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();

MilvusClientV2 client = new MilvusClientV2(connectConfig);

// 2. Create an empty schema
CreateCollectionReq.CollectionSchema schema = client.createSchema();
import "github.com/milvus-io/milvus/client/v3/entity"

schema := entity.NewSchema()
use milvus::v2::prelude::*;

let schema = CollectionSchema::new();
#include <iostream>
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

//Skip this step using JavaScript
# Skip this step using cURL
ステップ 2: フィールドを追加する
スキーマを作成したら、次のステップでは、データを構成するフィールドを指定します。各フィールドには、それぞれのデータ型と属性が関連付けられています。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import DataType

schema.add_field(field_name="article_id", datatype=DataType.INT64, is_primary=True, auto_id=True, description="article id")
schema.add_field(field_name="title", datatype=DataType.VARCHAR, enable_analyzer=True, enable_match=True, max_length=200, description="article title")
schema.add_field(field_name="timestamp", datatype=DataType.INT32, description="publish date")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=2000, enable_analyzer=True, description="article text content")
schema.add_field(field_name="text_dense_vector", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense vector")
schema.add_field(field_name="text_sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse vector")
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("article_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("timestamp")
        .dataType(DataType.Int32)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(2000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text_dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse_vector")
        .dataType(DataType.SparseFloatVector)
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

schema.WithField(entity.NewField().
    WithName("article_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithDescription("article id"),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(200).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithDescription("article title"),
).WithField(entity.NewField().
    WithName("timestamp").
    WithDataType(entity.FieldTypeInt32).
    WithDescription("publish date"),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(2000).
    WithEnableAnalyzer(true).
    WithDescription("article text content"),
).WithField(entity.NewField().
    WithName("text_dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768).
    WithDescription("text dense vector"),
).WithField(entity.NewField().
    WithName("text_sparse_vector").
    WithDataType(entity.FieldTypeSparseVector).
    WithDescription("text sparse vector"),
)
use milvus::v2::prelude::*;

let schema = schema
    .add_field(FieldSchema::new()
        .name("article_id")
        .data_type(DataType::Int64)
        .primary_key(true)
        .auto_id(true)
        .description("article id"))
    .add_field(FieldSchema::new()
        .name("title")
        .data_type(DataType::VarChar)
        .max_length(200)
        .enable_analyzer(true)
        .enable_match(true)
        .description("article title"))
    .add_field(FieldSchema::new()
        .name("timestamp")
        .data_type(DataType::Int32)
        .description("publish date"))
    .add_field(FieldSchema::new()
        .name("text")
        .data_type(DataType::VarChar)
        .max_length(2000)
        .enable_analyzer(true)
        .description("article text content"))
    .add_field(FieldSchema::new()
        .name("text_dense_vector")
        .data_type(DataType::FloatVector)
        .dimension(768)
        .description("text dense vector"))
    .add_field(FieldSchema::new()
        .name("text_sparse_vector")
        .data_type(DataType::SparseFloatVector)
        .description("text sparse vector"));
schema->AddField({"article_id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("title", milvus::DataType::VARCHAR)
                    .WithMaxLength(200).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("timestamp", milvus::DataType::INT32));
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)
                    .WithMaxLength(2000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense_vector", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField(milvus::FieldSchema("text_sparse_vector", milvus::DataType::SPARSE_FLOAT_VECTOR));
import { DataType } from "@zilliz/milvus2-sdk-node";

const fields = [
    {
        name: "article_id",
        data_type: DataType.Int64,
        is_primary_key: true,
        autoID: true
    },
    {
        name: "title",
        data_type: DataType.VarChar,
        max_length: 200,
        enable_analyzer: true,
        enable_match: true
    },
    {
        name: "timestamp",
        data_type: DataType.Int32
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 2000,
        enable_analyzer: true
    },
    {
        name: "text_dense_vector",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse_vector",
        data_type: DataType.SparseFloatVector
    }
]
export fields='[
    {
        "fieldName": "article_id",
        "dataType": "Int64",
        "isPrimary": true
    },
    {
        "fieldName": "title",
        "dataType": "VarChar",
        "elementTypeParams": {
            "max_length": 200,
            "enable_analyzer": true,
            "enable_match": true
        }
    },
    {
        "fieldName": "timestamp",
        "dataType": "Int32"
    },
    {
       "fieldName": "text",
       "dataType": "VarChar",
       "elementTypeParams": {
            "max_length": 2000,
            "enable_analyzer": true
        }
    },
    {
       "fieldName": "text_dense_vector",
       "dataType": "FloatVector",
       "elementTypeParams": {
            "dim": 768
        }
    },
    {
       "fieldName": "text_sparse_vector",
       "dataType": "SparseFloatVector"
    }
]'

export schema="{
    \"autoID\": true,
    \"fields\": $fields
}"
この例では、フィールドに次の属性が指定されています。
-
プライマリキー:
article_idがプライマリキーとして使用され、受信するエンティティにプライマリキーを自動的に割り当てられます。 -
パーティションキー:
timestampがパーティションキーとして割り当てられ、パーティションによるフィルタリングが可能になります。 -
テキストアナライザー: 2 つの文字列フィールド
titleとtextにテキストアナライザーが適用され、それぞれテキスト一致と全文検索をサポートします。
ステップ 3: (オプション)関数を追加する
データクエリ機能を強化するために、関数をスキーマに組み込むことができます。たとえば、特定のフィールドに関連する処理を行う関数を作成できます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import Function, FunctionType

bm25_function = Function(
    name="text_bm25",
    input_field_names=["text"],
    output_field_names=["text_sparse_vector"],
    function_type=FunctionType.BM25,
)

schema.add_function(bm25_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;
import java.util.*;

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse_vector"))
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

function := entity.NewFunction().
    WithName("text_bm25").
    WithInputFields("text").
    WithOutputFields("text_sparse_vector").
    WithType(entity.FunctionTypeBM25)
schema.WithFunction(function)
use milvus::v2::prelude::*;

let schema = schema.add_function(
    Function::new()
        .name("text_bm25")
        .function_type(FunctionType::Bm25)
        .input_fields(["text"])
        .output_fields(["text_sparse_vector"]),
);
milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25", milvus::FunctionType::BM25);
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse_vector");
schema->AddFunction(function);
import { FunctionType } from "@zilliz/milvus2-sdk-node";

const functions = [
    {
      name: 'text_bm25',
      description: 'bm25 function',
      type: FunctionType.BM25,
      input_field_names: ['text'],
      output_field_names: ['text_sparse_vector'],
      params: {},
    },
];
export myFunctions='[
    {
        "name": "text_bm25",
        "type": "BM25",
        "inputFieldNames": ["text"],
        "outputFieldNames": ["text_sparse_vector"],
        "params": {}
    }
]'

export schema="{
    \"autoID\": true,
    \"fields\": $fields,
    \"functions\": $myFunctions
}"
この例では、text フィールドを入力として使用し、生成された疎ベクトルを text_sparse_vector フィールドに保存する組み込み BM25 関数をスキーマに追加します。