メトリクスタイプ
類似度メトリクスは、ベクトル間の類似性を測定するために使用されます。適切な距離メトリクスを選択することは、分類とクラスタリングの性能を大幅に向上させるのに役立ちます。
現在、Zilliz Cloud は次の種類の類似度メトリクスをサポートしています:ユークリッド距離(L2)、内積(IP)、コサイン類似度(COSINE)、JACCARD、HAMMING、および BM25(スパースベクトルに対する全文検索用に特別に設計されています)。
以下の表は、異なるフィールドタイプと、それらに対応するメトリクスタイプとのマッピングをまとめたものです。
| フィールドタイプ | 次元範囲 | サポートされるメトリクスタイプ | デフォルトのメトリクスタイプ |
|---|---|---|---|
FLOAT_VECTOR | 2-32,768 | COSINE, L2, IP | COSINE |
FLOAT16_VECTOR | 2-32,768 | COSINE, L2, IP | COSINE |
BFLOAT16_VECTOR | 2-32,768 | COSINE, L2, IP | COSINE |
INT8_VECTOR | 2-32,768 | COSINE, L2, IP | COSINE |
SPARSE\_FLOAT\_VECTOR | 次元を指定する必要はありません。 | IP, BM25(全文検索でのみ使用) | IP |
BINARY_VECTOR | 8-32,768*8 | HAMMING, JACCARD, MHJACCARD | HAMMING |
-
SPARSE\_FLOAT\_VECTORタイプのベクトルフィールドでは、全文検索を実行する場合にのみBM25メトリクスタイプを使用してください。詳細については、全文検索 を参照してください。 -
BINARY_VECTORタイプのベクトルフィールドでは、次元値(dim)は 8 の倍数である必要があります。
以下の表は、サポートされているすべてのメトリクスタイプの類似度距離値の特性と、その値の範囲をまとめたものです。
| メトリクスタイプ | 類似度距離値の特性 | 類似度距離値の範囲 |
|---|---|---|
L2 | 値が小さいほど類似度が高くなります。 | [0, ∞) |
IP | 値が大きいほど類似度が高くなります。 | [-1, 1] |
COSINE | 値が大きいほど類似度が高くなります。 | [-1, 1] |
JACCARD | 値が小さいほど類似度が高くなります。 | [0, 1] |
MHJACCARD | MinHash シグネチャのビットから Jaccard 類似度を推定します。距離が小さいほど類似しています。 | [0, 1] |
HAMMING | 値が小さいほど類似度が高くなります。 | [0, dim(vector)] |
BM25 | 用語頻度、逆文書頻度、および文書長の正規化に基づいて関連性をスコア化します。 | [0, ∞) |
ユークリッド距離(L2)
基本的に、ユークリッド距離は 2 点を結ぶ線分の長さを測定します。
ユークリッド距離の計算式は次のとおりです。

ここで、a = (a0, a1,..., an-1) と b = (b0, b1,..., bn-1) は、n 次元ユークリッド空間内の 2 点です。
これは最も一般的に使用される距離メトリクスであり、データが連続値である場合に非常に役立ちます。
ユークリッド距離を距離メトリクスとして選択した場合、Zilliz Cloud は平方根を適用する前の値のみを計算します。
内積(IP)
2 つの埋め込み間の IP 距離は、次のように定義されます。
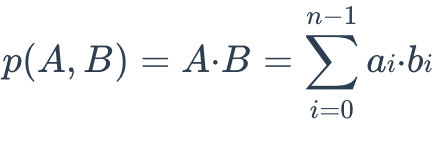
IP は、正規化されていないデータを比較する必要がある場合や、大きさと角度を重視する場合に、より有用です。
IP を使用して埋め込み間の類似度を計算する場合は、埋め込みを正規化する必要があります。正規化後、内積はコサイン類似度と等しくなります。
X' が埋め込み X を正規化したものであるとします。
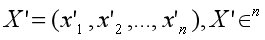
2 つの埋め込み間の相関は次のとおりです。
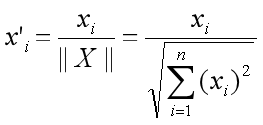
コサイン類似度
コサイン類似度は、2 組のベクトル間の角度のコサインを使用して、それらがどの程度類似しているかを測定します。2 組のベクトルは、[0,0,...] のような同じ点から始まり、異なる方向を向く線分と考えることができます。
2 組のベクトル A = (a0, a1,..., an-1) と B = (b0, b1,..., bn-1) の間のコサイン類似度を計算するには、次の式を使用します。

コサイン類似度は常に [-1, 1] の区間内にあります。たとえば、比例する 2 つのベクトルのコサイン類似度は 1、直交する 2 つのベクトルの類似度は 0、反対方向を向く 2 つのベクトルの類似度は -1 です。コサインが大きいほど 2 つのベクトル間の角度は小さくなり、これら 2 つのベクトルが互いに類似していることを示します。
コサイン類似度を 1 から引くことで、2 つのベクトル間のコサイン距離を求めることができます。
JACCARD 距離
JACCARD 距離係数は、2 つのサンプル集合間の類似性を測定し、定義された集合の共通部分の要素数を、それらの和集合の要素数で割ったものとして定義されます。これは有限のサンプル集合にのみ適用できます。
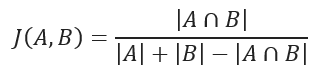
JACCARD 距離はデータ集合間の非類似性を測定し、JACCARD 類似度係数を 1 から引くことで得られます。二値変数の場合、JACCARD 距離は Tanimoto 係数と等価です。
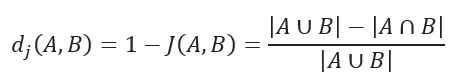
MHJACCARD
MinHash Jaccard(MHJACCARD)は、文書の単語集合、ユーザーのタグ集合、ゲノムの k-mer 集合など、大規模な集合に対する効率的な近似類似検索に使用されるメトリクスタイプです。MHJACCARD は生の集合を直接比較する代わりに、MinHash シグネチャを比較します。これは Jaccard 類似度を効率的に推定するために設計されたコンパクトな表現です。
このアプローチは、正確な Jaccard 類似度を計算するよりも大幅に高速であり、大規模または高次元のシナリオで特に役立ちます。
適用可能なベクトルタイプ
BINARY_VECTOR。各ベクトルには MinHash シグネチャが格納されます。各要素は、元の集合に適用された独立したハッシュ関数の 1 つにおける最小ハッシュ値に対応します。
距離の定義
MHJACCARD は、2 つの MinHash シグネチャにおいて一致する位置の数を測定します。一致率が高いほど、基になる集合はより類似しています。
Zilliz Cloud は以下を報告します。
- 距離 = 1 - 推定類似度(一致率)
距離値の範囲は 0 から 1 です。
-
0 は MinHash シグネチャが同一であること(推定 Jaccard 類似度 = 1)を意味します
-
1 はどの位置にも一致がないこと(推定 Jaccard 類似度 = 0)を意味します
技術的な詳細については、MINHASH_LSH を参照してください。
HAMMING 距離
HAMMING 距離はバイナリデータ文字列を測定します。同じ長さの 2 つの文字列間の距離は、ビットが異なるビット位置の数です。
たとえば、1101 1001 と 1001 1101 という 2 つの文字列があるとします。
11011001 ⊕ 10011101 = 01000100。これには 1 が 2 つ含まれるため、HAMMING 距離 d (11011001, 10011101) = 2 となります。
BM25 類似度
BM25 は、広く使用されているテキスト関連性の測定手法であり、全文検索 用に特別に設計されています。BM25 は、次の 3 つの主要な要素を組み合わせます。
-
用語頻度(TF): 用語が文書に出現する頻度を測定します。頻度が高いほど重要度が高いことを示すことが多いですが、BM25 は飽和パラメータ を使用して、出現頻度が高すぎる用語が関連性スコアを支配しないようにします。
-
逆文書頻度(IDF): コーパス全体における用語の重要度を反映します。出現する文書が少ない用語ほど高い IDF 値を受け取り、関連性への寄与が大きいことを示します。
-
文書長の正規化: 長い文書はより多くの用語を含むため、スコアが高くなる傾向があります。BM25 は文書長を正規化することでこの偏りを軽減し、パラメータ がこの正規化の強さを制御します。
BM25 スコアは次のように計算されます。
パラメータの説明:
-
: ユーザーが指定したクエリテキスト。
-
: 評価対象の文書。
-
: 用語頻度。用語 が文書 に出現する頻度を表します。
-
: 逆文書頻度。次のように計算されます:
ここで、 はコーパス内の文書の総数、 は用語 を含む文書の数です。
-
: 文書 の長さ(用語の総数)。
-
: コーパス内のすべての文書の平均長。
-
: スコアに対する用語頻度の影響を制御します。値が大きいほど用語頻度の重要度が高まります。一般的な範囲は [1.2, 2.0] ですが、Zilliz Cloud では [0, 3] の範囲が許可されています。
-
: 長さの正規化の度合いを制御し、0 から 1 の範囲を取ります。値が 0 の場合は正規化が適用されず、値が 1 の場合は完全な正規化が適用されます。
最大類似度
最大類似度(MAX_SIM とも呼ばれます)は、通常のベクトル埋め込みではなく、ベクトル埋め込みのリスト間の類似度を測定します。基本的な考え方は、各文書をコンテキストチャンクまたはトークンに分割し、それぞれのベクトル埋め込みを作成して、文書ごとに埋め込みのリストとして格納することです。クエリを受信すると、クエリもトークンに分割され、それに応じて埋め込みリストが生成されます。
クエリと文書の間の距離または類似度スコアは、最大類似度(MAX_SIM)として知られる上記の式を使用して計算されます。式中の引数は次のとおりです。
-
: ユーザーが指定したクエリテキストで、 のようなベクトル埋め込みリストに分割されています。
-
: 評価対象の文書で、 のようなベクトル埋め込みリストに分割されています。
-
: クエリ埋め込みリスト内の i 番目 のベクトル埋め込み。
-
: 文書内の j 番目 のベクトル埋め込み。
クエリと文書の間の類似度スコアを求めるには、各クエリトークンのベクトル埋め込みを文書内のベクトル埋め込みと比較して、類似度スコアのリストを取得します。次に、すべてのスコアリストから最も高いスコアを合計して、最終スコアを生成します。
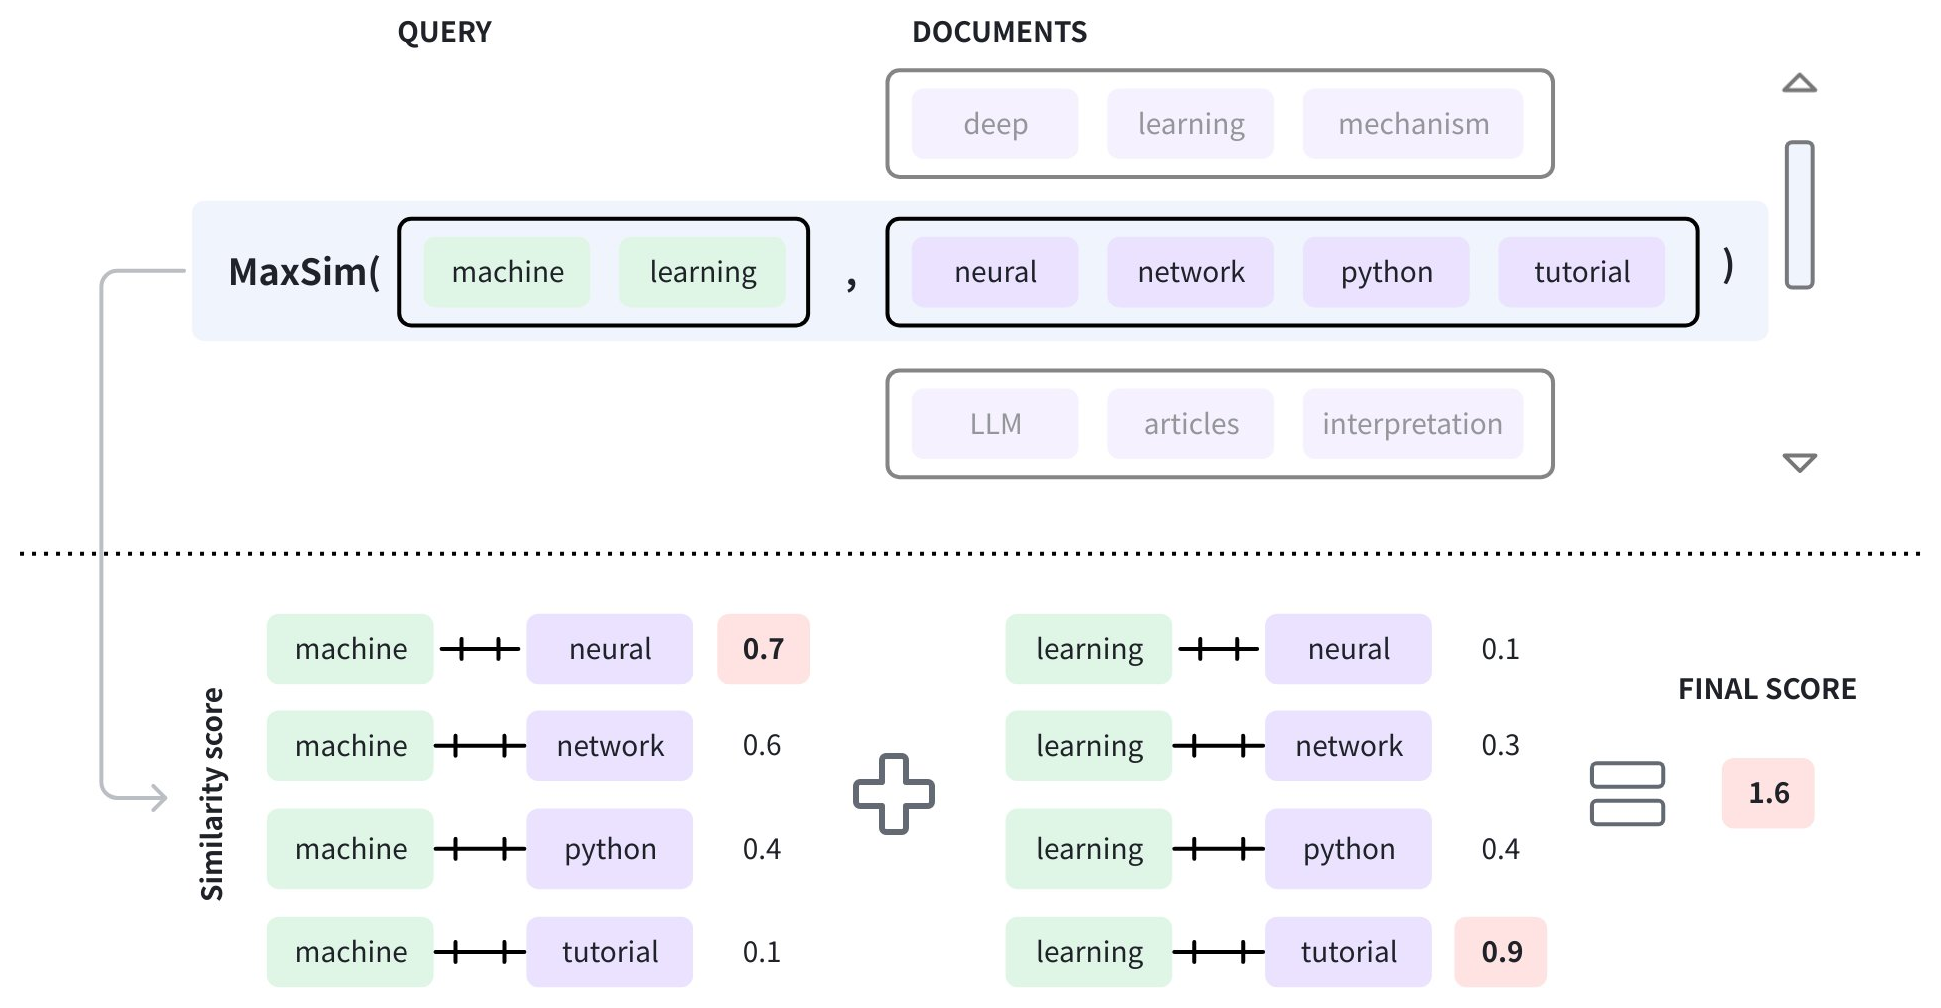
Zilliz Cloud では、MAX_SIM を使用して、クエリと、構造体の配列に格納された文書との間の類似度を測定できます。
以下の表は、MAX_SIM シリーズで適用可能なメトリクスタイプを一覧にしたものです。
| メトリクスタイプ | 説明 |
|---|---|
| MAX_SIM_L2 | 各クエリトークンと各文書トークンの間の距離を計算するために L2 が使用され、複数のスコアリストが生成されます。一方、MAX_SIM は、すべてのスコアリストにわたる最高スコアを合計して最終スコアを決定します。 |
| MAX_SIM_IP | 各クエリトークンと各文書トークンの間の距離を計算するために IP が使用され、複数のスコアリストが生成されます。一方、MAX_SIM は、すべてのスコアリストから最高スコアを合計して最終スコアを決定します。 |
| MAX_SIM_COSINE | 各クエリトークンと各文書トークンの間の距離を計算するために COSINE が使用され、複数のスコアリストが生成されます。一方、MAX_SIM は、すべてのスコアリストから最高スコアを合計して最終スコアを決定します。 |