テキストマッチ
Zilliz Cloud のテキストマッチでは、特定の用語に基づいてドキュメントを正確に取得できます。この機能は主に、特定の条件を満たすためのフィルタ付き検索に使用され、クエリ結果を絞り込むためのスカラーフィルタリングを組み合わせることができます。これにより、スカラー条件を満たすベクトル内で類似検索を実行できます。
テキストマッチは、一致したドキュメントの関連性をスコアリングすることなく、クエリ用語の完全一致箇所を見つけることに重点を置きます。クエリ用語の意味や重要度に基づいて最も関連性の高いドキュメントを取得したい場合は、全文検索 の使用を推奨します。
Zilliz Cloud では、プログラムまたは Web コンソールからテキストマッチを有効にできます。このページでは、プログラムでテキストマッチを有効にする方法について説明します。Web コンソールでの操作の詳細については、コレクションの管理(コンソール) を参照してください。
概要
Zilliz Cloud は、基盤となる転置インデックスと用語ベースのテキスト検索を実現するために Tantivy を統合しています。各テキストエントリについて、Zilliz Cloud は次の手順に従ってインデックスを作成します。
-
アナライザー: アナライザーは、入力テキストを個々の単語(トークン)にトークン化し、必要に応じてフィルターを適用して処理します。これにより、Zilliz Cloud はこれらのトークンに基づいてインデックスを構築できます。
-
インデックス作成: テキスト解析後、Zilliz Cloud は各一意のトークンを、それを含むドキュメントに対応付ける転置インデックスを作成します。
ユーザーがテキストマッチを実行すると、転置インデックスを使用して、その用語を含むすべてのドキュメントをすばやく取得します。これは、各ドキュメントを個別に走査するよりもはるかに高速です。
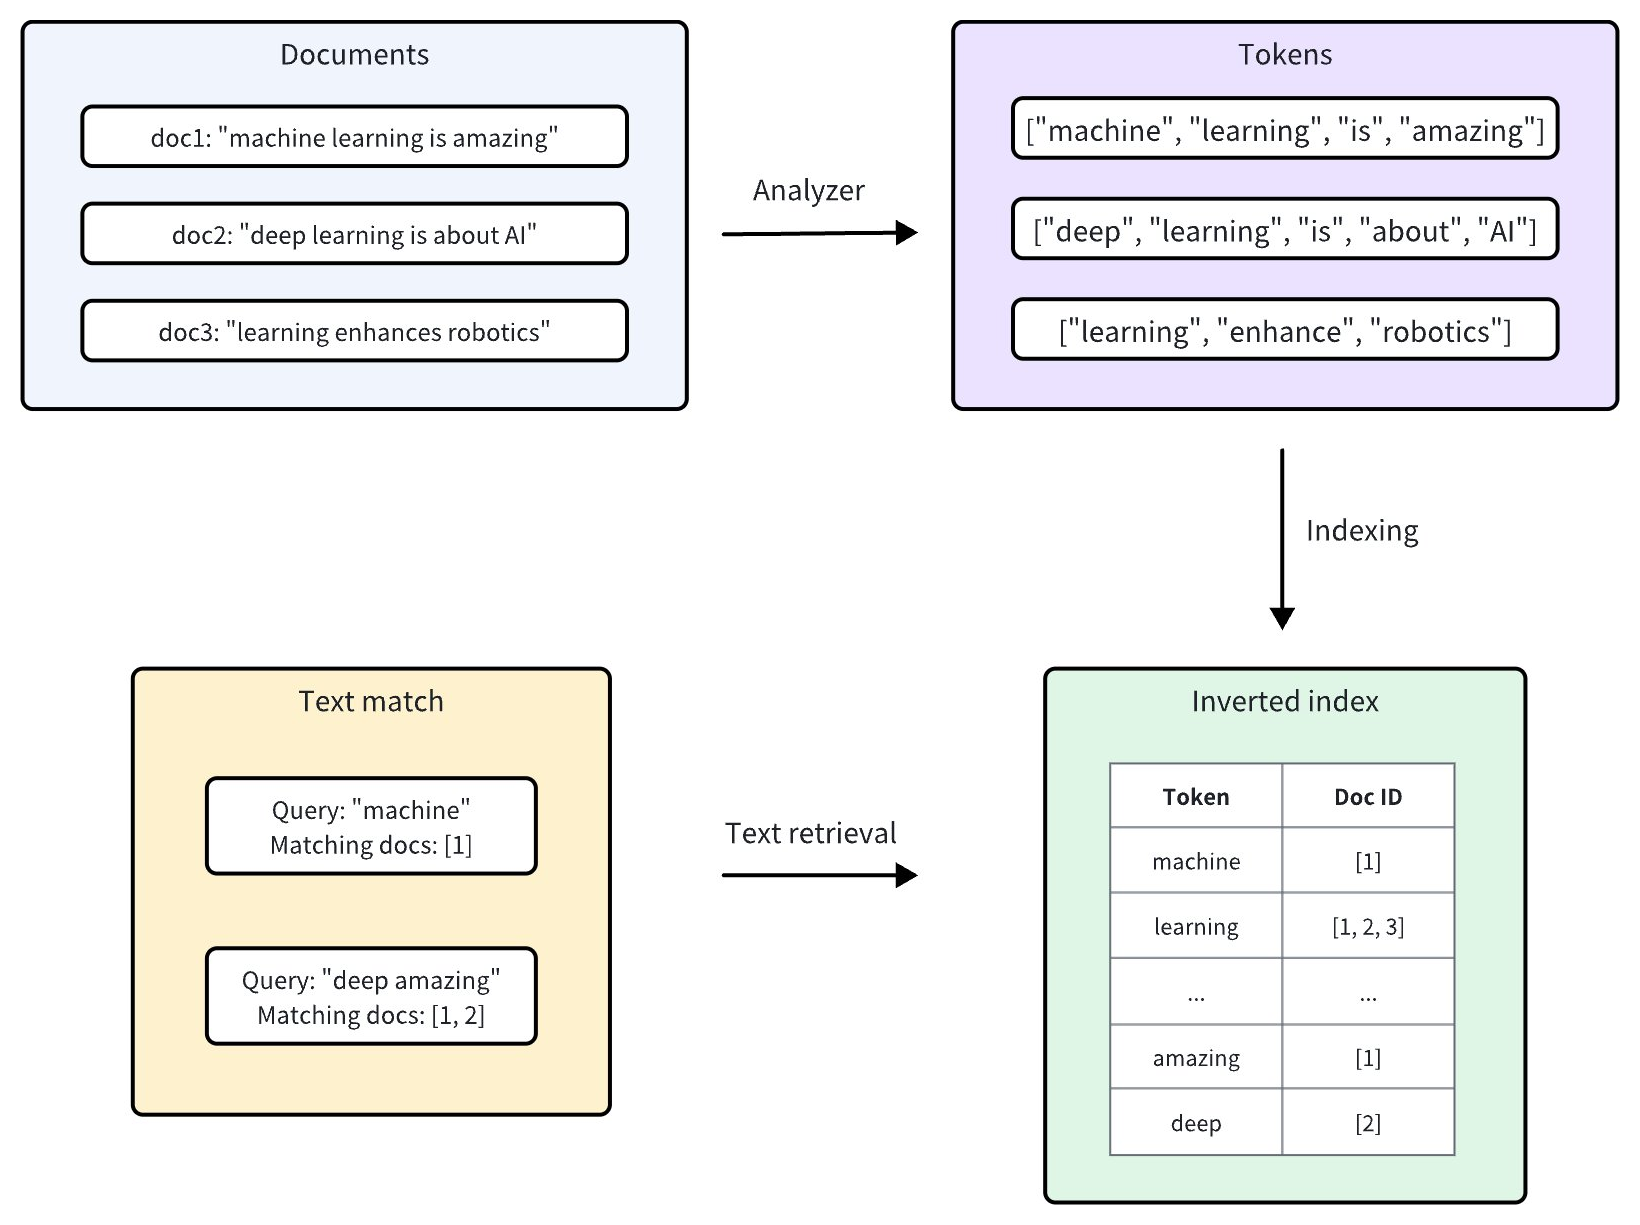
テキストマッチを有効にする
テキストマッチは、Zilliz Cloud の文字列データ型である VARCHAR フィールド型で動作します。テキストマッチを有効にするには、コレクションスキーマを定義する際に enable_analyzer と enable_match の両方を True に設定し、必要に応じてテキスト解析用の アナライザー を構成します。
enable_analyzer と enable_match を設定する
特定の VARCHAR フィールドでテキストマッチを有効にするには、フィールドスキーマを定義する際に enable_analyzer と enable_match の両方のパラメーターを True に設定します。これにより、Zilliz Cloud はテキストをトークン化し、指定されたフィールドの転置インデックスを作成するため、高速で効率的なテキストマッチが可能になります。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Create a collection with a VARCHAR field configured for text matching
zilliz collection create --collection-name my_collection --schema '{
  "autoId": true,
  "enabledDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "text",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": 1000,
        "enable_analyzer": true,
        "enable_match": true
      }
    },
    {
      "fieldName": "embeddings",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": 5
      }
    }
  ]
}'
オプション: アナライザーを構成する
キーワードマッチングのパフォーマンスと精度は、選択したアナライザーによって異なります。アナライザーは言語やテキスト構造に応じてそれぞれ適した設計になっているため、適切なものを選択することが、特定のユースケースにおける検索結果に大きく影響する可能性があります。
デフォルトでは、Zilliz Cloud は standard アナライザーを使用します。これは、空白と句読点に基づいてテキストをトークン化し、40 文字を超えるトークンを削除して、テキストを小文字に変換します。このデフォルト設定を適用するために追加のパラメーターは必要ありません。詳細については、Standard を参照してください。
別のアナライザーが必要な場合は、analyzer_params パラメーターを使用して構成できます。たとえば、英語のテキストを処理するために english アナライザーを適用するには、次のようにします。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
nlohmann::json analyzer_params = {{"type", "english"}};

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000)
                    .EnableAnalyzer(true).EnableMatch(true).WithAnalyzerParams(analyzer_params));
schema->AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Create a collection with English analyzer for text matching
zilliz collection create --collection-name my_collection --schema '{
  "autoId": true,
  "enabledDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "text",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": 1000,
        "enable_analyzer": true,
        "enable_match": true,
        "analyzer_params": {
          "type": "english"
        }
      }
    },
    {
      "fieldName": "embeddings",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": 5
      }
    }
  ]
}'
Zilliz Cloud は、さまざまな言語やシナリオに適した他のアナライザーも提供しています。詳細については、アナライザーの概要 を参照してください。
テキストマッチを使用する
コレクションスキーマで VARCHAR フィールドのテキストマッチを有効にすると、TEXT_MATCH 式を使用してテキストマッチを実行できます。
TEXT_MATCH 式の構文
TEXT_MATCH 式は、検索対象のフィールドと用語を指定するために使用します。構文は次のとおりです。
TEXT_MATCH(field_name, text)
-
field_name: 検索対象の VARCHAR フィールドの名前。 -
text: 検索対象の用語。言語および構成されたアナライザーに応じて、複数の用語をスペースまたはその他の適切な区切り文字で区切ることができます。
デフォルトでは、TEXT_MATCH は OR マッチングロジックを使用します。つまり、指定された用語のいずれかを含むドキュメントを返します。たとえば、text フィールドに machine または deep という用語を含むドキュメントを検索するには、次の式を使用します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
const auto filter = R"(TEXT_MATCH(text, "machine deep"))";
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents containing both "machine" and "deep"
zilliz collection query --collection-name my_collection --filter "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')" --output-fields "id,text"
論理演算子を使用して複数の TEXT_MATCH 式を組み合わせ、AND マッチングを実行することもできます。
-
machineとdeepの両方をtextフィールドに含むドキュメントを検索するには、次の式を使用します。- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
pythonfilter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"javaString filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";gofilter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"javascriptconst filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"bashexport filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""c++const auto filter = R"(TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep'))";shell# Zilliz CLI# Prerequisite: run zilliz login and select your cluster with zilliz context set.# Query documents containing "machine" and "learning" but not "deep"zilliz collection query --collection-name my_collection --filter "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')" --output-fields "id,text" -
deepを含まず、machineとlearningの両方をtextフィールドに含むドキュメントを検索するには、次の式を使用します。- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
pythonfilter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"javaString filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";gofilter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"javascriptconst filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";bashexport filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""c++const auto filter = R"(not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning'))";shell# Zilliz CLI# Prerequisite: run zilliz login and select your cluster with zilliz context set.# Query documents containing "keyword1" or "keyword2"zilliz collection query --collection-name my_collection --filter "TEXT_MATCH(text, 'keyword1 keyword2')" --output-fields "id,text"
TEXT_MATCH_FUZZY 式の構文
TEXT_MATCH_FUZZY を使用すると、クエリトークンとインデックスされたトークンの間のスペルの違いを許容できます。Milvus は、フィールドのアナライザーでクエリテキストを解析し、得られた各トークンにファジーマッチングを適用します。クエリが複数のトークンを生成する場合、いずれかのトークンが構成された編集距離を満たすと、式はエンティティに一致します。
構文は次のとおりです。
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
-
field_name: 検索対象の、マッチングが有効なVARCHARまたはTEXTフィールドの名前。 -
text: 解析し、インデックスされたトークンと照合するクエリテキスト。 -
max_edit_distance: 各クエリトークンに許可される最大編集距離。オプション名は正確にmax_edit_distanceである必要があり、その値は0、1、または2のいずれかである必要があります。値0は完全一致のトークンマッチングを実行し、TEXT_MATCHと同等です。
たとえば、次の式は、machne から編集距離 1 以内のトークン(machine を含む)に一致します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
std::string filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
# Zilliz CLI
テキストマッチを使用した検索
テキストマッチは、ベクトル類似検索と組み合わせて使用することで、検索範囲を絞り込み、検索パフォーマンスを向上させることができます。ベクトル類似検索の前にテキストマッチでコレクションをフィルタリングすると、検索対象のドキュメント数を減らすことができ、クエリ時間を短縮できます。
この例では、filter 式によって、指定された用語 keyword1 または keyword2 に一致するドキュメントのみが検索結果に含まれるように絞り込まれます。その後、このフィルタリングされたドキュメントのサブセットに対してベクトル類似検索が実行されます。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector)))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search(
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
);
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
const auto filter = R"(TEXT_MATCH(text, 'keyword1 keyword2'))";
std::vector<float> query_vector = {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("embeddings")
                   .WithFilter(filter)
                   .WithLimit(10)
                   .AddOutputField("text")
                   .AddOutputField("id")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents with fuzzy matching (tolerates spelling differences)
zilliz collection query --collection-name my_collection --filter "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)" --output-fields "id,text"
テキストマッチを使用したクエリ
テキストマッチは、クエリ操作におけるスカラーフィルタリングにも使用できます。query() メソッドの expr パラメーターで TEXT_MATCH 式を指定すると、指定された用語に一致するドキュメントを取得できます。
以下の例では、text フィールドに keyword1 と keyword2 の両方の用語を含むドキュメントを取得します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query(
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
)
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
const auto filter = R"(TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2'))";

auto request = milvus::QueryRequest()
                       .WithCollectionName("my_collection")
                       .WithFilter(filter)
                       .AddOutputField("id")
                       .AddOutputField("text");

milvus::QueryResponse response;
auto status = client->Query(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Search documents containing "machine deep" with vector similarity
zilliz collection search --collection-name my_collection --vector-field embeddings --vectors '[[0.1,0.2,0.3,0.4,0.5]]' --filter "TEXT_MATCH(text, 'machine deep')" --limit 10 --output-fields "id,text"
考慮事項
-
フィールドの用語マッチングを有効にすると転置インデックスが作成され、ストレージリソースを消費します。この機能を有効にするかどうかを判断する際は、テキストのサイズ、一意のトークン、および使用するアナライザーによって影響が異なるため、ストレージへの影響を考慮してください。
-
スキーマでアナライザーを定義すると、その設定はそのコレクションに対して永続的になります。別のアナライザーの方がニーズに適していると判断した場合は、既存のコレクションを削除し、目的のアナライザー構成で新しいコレクションを作成することを検討してください。
-
フレーズ一致のパフォーマンスは、テキストがどのようにトークン化されるかによって異なります。アナライザーをコレクション全体に適用する前に、
run_analyzerメソッドを使用してトークン化の出力を確認してください。詳細については、アナライザーの概要 を参照してください。 -
filter式のエスケープルール:-
式内で二重引用符または一重引用符で囲まれた文字は、文字列定数として解釈されます。文字列定数にエスケープ文字が含まれる場合は、エスケープ文字をエスケープシーケンスで表現する必要があります。たとえば、
\\は\を表すために使用し、\\tはタブ\tを表すために、\\nは改行を表すために使用します。 -
文字列定数を一重引用符で囲む場合、定数内の一重引用符は
\\'として表現し、二重引用符は"または\\"のいずれかで表現できます。例:'It\\'s milvus'。 -
文字列定数を二重引用符で囲む場合、定数内の二重引用符は
\\"として表現し、一重引用符は'または\\'のいずれかで表現できます。例:"He said \\"Hi\\""。
-