バイナリベクトル
バイナリベクトルは、従来の高次元浮動小数点ベクトルを、0 と 1 のみを含むバイナリベクトルに変換する特殊なデータ表現形式です。この変換は、ベクトルのサイズを圧縮するだけでなく、意味情報を保持しながらストレージと計算コストも削減します。重要度の低い特徴に高い精度が不要な場合、バイナリベクトルは元の浮動小数点ベクトルの完全性と有用性の大部分を効果的に維持できます。
バイナリベクトルは幅広い用途があり、特に計算効率とストレージ最適化が重要となる場面で役立ちます。検索エンジンやレコメンデーションシステムといった大規模な AI システムでは、膨大なデータをリアルタイムで処理することが鍵となります。ベクトルのサイズを削減することで、バイナリベクトルは精度を大きく犠牲にすることなく、レイテンシと計算コストの低減に役立ちます。さらに、バイナリベクトルは、モバイルデバイスや組み込みシステムのようにメモリや処理能力が限られたリソース制約の厳しい環境でも有用です。バイナリベクトルを利用することで、こうした制約のある環境でも高いパフォーマンスを維持しながら複雑な AI 機能を実装できます。
概要
バイナリベクトルは、複雑なオブジェクト(画像、テキスト、音声など)を固定長のバイナリ値にエンコードする方法です。Zilliz Cloud クラスターでは、バイナリベクトルは通常、ビット配列またはバイト配列として表現されます。たとえば、8 次元のバイナリベクトルは [1, 0, 1, 1, 0, 0, 1, 0] のように表現できます。
以下の図は、バイナリベクトルがテキストコンテンツ内のキーワードの有無をどのように表現するかを示しています。この例では、10 次元のバイナリベクトルを使用して 2 つの異なるテキスト(Text 1 と Text 2)を表現しており、各次元は語彙内の単語に対応しています。1 はその単語がテキスト内に存在することを示し、0 は存在しないことを示します。
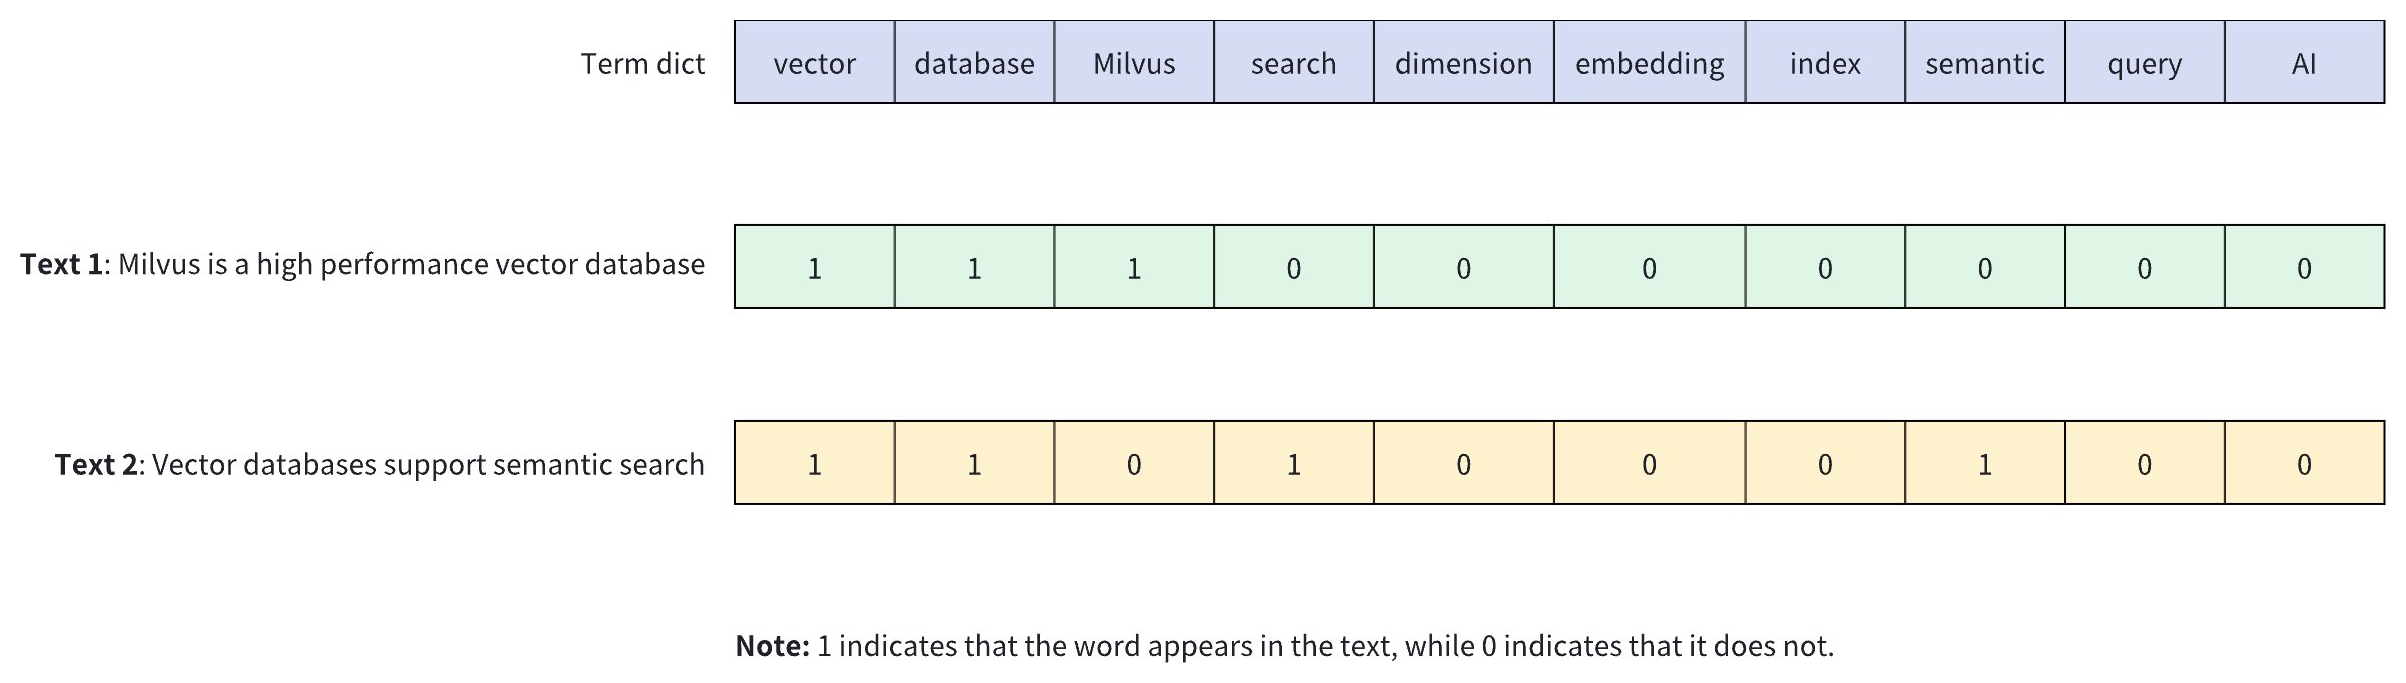
バイナリベクトルには、以下の特徴があります。
-
効率的なストレージ: 各次元に必要なストレージはわずか 1 ビットで、ストレージ容量を大幅に削減できます。
-
高速な計算: ベクトル間の類似度は、XOR のようなビット演算を使用してすばやく計算できます。
-
固定長: ベクトルの長さは元のテキストの長さに関係なく一定であるため、インデックス作成や検索が容易になります。
-
シンプルで直感的: キーワードの存在を直接反映するため、特定の専門的な検索タスクに適しています。
バイナリベクトルは、さまざまな方法で生成できます。テキスト処理では、事前定義された語彙を使用し、単語の有無に応じて対応するビットを設定できます。画像処理では、知覚ハッシュアルゴリズム(pHash など)によって画像のバイナリ特徴を生成できます。機械学習アプリケーションでは、モデルの出力を二値化してバイナリベクトル表現を取得できます。
バイナリベクトル化後、データは管理とベクトル検索のために Zilliz Cloud クラスターに保存できます。以下の図は、基本的なプロセスを示しています。
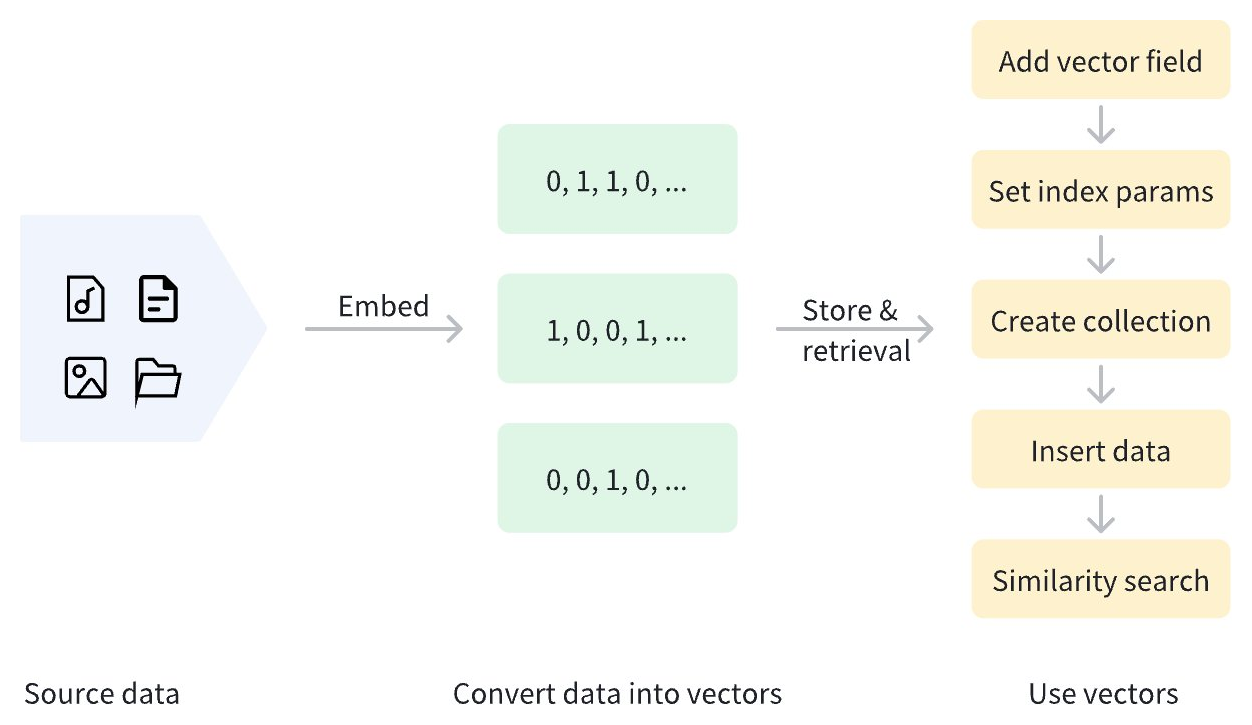
バイナリベクトルを使用する
ベクトルフィールドの追加
Zilliz Cloud クラスターでバイナリベクトルを使用するには、まずコレクションの作成時に、バイナリベクトルを保存するためのベクトルフィールドを定義します。このプロセスには、以下が含まれます。
-
datatypeを、サポートされているバイナリベクトルデータ型であるBINARY_VECTORに設定します。 -
dimパラメーターを使用してベクトルの次元数を指定します。バイナリベクトルは挿入時にバイト配列に変換する必要があるため、dimは 8 の倍数でなければならない点に注意してください。8 個の boolean 値(0 または 1)が 1 バイトにパックされます。たとえば、dim=128の場合、挿入には 16 バイトの配列が必要です。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=128)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

CreateCollectionReq.CollectionSchema schema = MilvusClientV2.CreateSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("binary_vector")
        .dataType(DataType.BinaryVector)
        .dimension(128)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    milvusclient "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema().WithEnableDynamicField(true).
    WithField(entity.NewField().
        WithName("pk").
        WithDataType(entity.FieldTypeVarChar).
        WithIsAutoID(true).
        WithIsPrimaryKey(true).
        WithMaxLength(100),
    ).WithField(entity.NewField().
        WithName("binary_vector").
        WithDataType(entity.FieldTypeBinaryVector).
        WithDim(128),
    )
use milvus::v2::prelude::*;

let client = ClientV2::new(
    &ConnectConfig::new()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN"),
)
.await?;

let mut schema = CollectionSchema::new().enable_dynamic_field(true);
schema = schema
    .add_field(
        FieldSchema::new()
            .name("pk")
            .data_type(DataType::VarChar)
            .primary_key(true)
            .auto_id(true)
            .max_length(100),
    )
    .add_field(
        FieldSchema::new()
            .name("binary_vector")
            .data_type(DataType::BinaryVector)
            .dimension(128),
    );
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(true);
schema->AddField(milvus::FieldSchema("pk", milvus::DataType::VARCHAR, "", true, true).WithMaxLength(100));
schema->AddField(milvus::FieldSchema("binary_vector", milvus::DataType::BINARY_VECTOR).WithDimension(128));
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "binary_vector",
  data_type: DataType.BinaryVector,
  dim: 128,
});
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "binary_vector",
    "dataType": "BinaryVector",
    "elementTypeParams": {
        "dim": 128
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ],
    \"enableDynamicField\": true
}"
この例では、バイナリベクトルを保存するための binary_vector という名前のベクトルフィールドを追加しています。このフィールドのデータ型は BINARY_VECTOR で、次元数は 128 です。
ベクトルフィールドのインデックスパラメーターを設定する
検索を高速化するには、バイナリベクトルフィールドにインデックスを作成する必要があります。インデックス作成により、大規模なベクトルデータの検索効率を大幅に向上させることができます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_name="binary_vector_index",
    index_type="AUTOINDEX",
    metric_type="HAMMING"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexParams = new ArrayList<>();

indexParams.add(IndexParam.builder()
        .fieldName("binary_vector")
        .indexName("binary_vector_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.HAMMING)
        .build());
idx := index.NewAutoIndex(entity.HAMMING)
indexOption := milvusclient.NewCreateIndexOption("my_collection", "binary_vector", idx)
let index_params = vec![IndexParam::new()
    .field_name("binary_vector")
    .index_name("binary_vector_index")
    .index_type(IndexType::AutoIndex)
    .metric_type(MetricType::Hamming)];
std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("binary_vector", "binary_vector_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::HAMMING)
};
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = [{
  indexName: "binary_vector_index",
  field_name: "binary_vector",
  metric_type: MetricType.HAMMING,
  index_type: IndexType.AUTOINDEX
}];
export indexParams='[
        {
            "fieldName": "binary_vector",
            "metricType": "HAMMING",
            "indexName": "binary_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
上記の例では、binary_vector フィールドに対して binary_vector_index という名前のインデックスを、AUTOINDEX インデックスタイプを使用して作成しています。metric_type は HAMMING に設定されており、類似度の測定にハミング距離が使用されることを示しています。
さらに、Zilliz Cloud はバイナリベクトルに対して他の類似度メトリクスもサポートしています。詳細については、Metric Types を参照してください。
コレクションの作成
バイナリベクトルとインデックスの設定が完了したら、バイナリベクトルを含むコレクションを作成します。以下の例では、create_collection メソッドを使用して my_collection という名前のコレクションを作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(requestCreate);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("my_collection")
            .schema(schema)
            .index_params(index_params)
            .build()?,
    )
    .await?;
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                        .WithCollectionName("my_collection")
                                        .WithIndexes(std::move(indexes))
                                        .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
データの挿入
コレクションを作成した後、insert メソッドを使用して、バイナリベクトルを含むデータを追加します。バイナリベクトルはバイト配列の形式で指定する必要があり、各バイトは 8 個の boolean 値を表す点に注意してください。
たとえば、128 次元のバイナリベクトルには 16 バイトの配列が必要です(128 ビット ÷ 8 ビット/byte = 16 バイト)。以下は、データを挿入するためのコード例です。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
def convert_bool_list_to_bytes(bool_list):
    if len(bool_list) % 8 != 0:
        raise ValueError("The length of a boolean list must be a multiple of 8")

    byte_array = bytearray(len(bool_list) // 8)
    for i, bit in enumerate(bool_list):
        if bit == 1:
            index = i // 8
            shift = i % 8
            byte_array[index] |= (1 << shift)
    return bytes(byte_array)

bool_vectors = [
    [1, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 0] + [0] * 112,
    [0, 1, 0, 1, 0, 1, 0, 0, 1, 1, 0, 0, 1, 1, 0, 1] + [0] * 112,
]

data = [{"binary_vector": convert_bool_list_to_bytes(bool_vector)} for bool_vector in bool_vectors]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;
import java.nio.ByteBuffer;

// Binary vectors (128 bits = 16 bytes)
// vector1: [1,0,0,1,1,0,1,1, 0,1,0,1,0,1,0,0] + [0]*112
byte[] vector1 = new byte[16];
vector1[0] = (byte) 0xD9;
vector1[1] = 0x2A;

// vector2: [0,1,0,1,0,1,0,0, 1,1,0,0,1,1,0,1] + [0]*112
byte[] vector2 = new byte[16];
vector2[0] = 0x2A;
vector2[1] = (byte) 0xB3;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();

JsonObject row1 = new JsonObject();
row1.add("binary_vector", gson.toJsonTree(vector1));
rows.add(row1);

JsonObject row2 = new JsonObject();
row2.add("binary_vector", gson.toJsonTree(vector2));
rows.add(row2);

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithBinaryVectorColumn("binary_vector", 128, [][]byte{
        {0b11011001, 0b00101010, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0},
        {0b00101010, 0b10110011, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
// Binary vectors (128 bits = 16 bytes)
let binary_vectors: Vec<Vec<u8>> = vec![
    vec![0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    vec![0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
];

client
    .insert(
        InsertRequest::builder()
            .collection_name("my_collection")
            .columns(vec![FieldData::binary_vector(
                "binary_vector",
                binary_vectors,
            )])
            .build()?,
    )
    .await?;
// Binary vectors (128 bits = 16 bytes)
std::vector<uint8_t> vector1 = {0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};
std::vector<uint8_t> vector2 = {0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};

milvus::EntityRows data = {
    {{"binary_vector", vector1}},
    {{"binary_vector", vector2}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const data = [
  { binary_vector: [1,0,0,1,1,0,1,1,0,1,0,1,0,1,0,0] },
  { binary_vector: [0,1,0,1,0,1,0,0,1,1,0,0,1,1,0,1] },
];

await client.insert({
  collection_name: "my_collection",
  data: data,
});
export data='[
    {"binary_vector": "2SoAAAAAAAAAAAAAAAAAAA=="},
    {"binary_vector": "KrMAAAAAAAAAAAAAAAAAAA=="}
]'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"data\": $data,
    \"collectionName\": \"my_collection\"
}"
類似検索の実行
類似検索は Zilliz Cloud クラスターの中核機能の 1 つであり、ベクトル間の距離に基づいて、クエリベクトルに最も類似したデータをすばやく見つけることができます。バイナリベクトルを使用して類似検索を実行するには、クエリベクトルと検索パラメーターを準備し、search メソッドを呼び出します。
検索操作時にも、バイナリベクトルはバイト配列の形式で指定する必要があります。クエリベクトルの次元数が、dim の定義時に指定した次元数と一致していること、および 8 個の boolean 値ごとに 1 バイトに変換されていることを確認してください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
search_params = {
    "params": {"nprobe": 10}
}

query_bool_list = [1, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 0] + [0] * 112
query_vector = convert_bool_list_to_bytes(query_bool_list)

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="binary_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172268', 'distance': 10.0, 'entity': {'pk': '453718927992172268'}}]"]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.nio.ByteBuffer;

// query vector = vector1
byte[] queryBytes = new byte[16];
queryBytes[0] = (byte) 0xD9;
queryBytes[1] = 0x2A;
ByteBuffer queryVector = ByteBuffer.wrap(queryBytes);

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new BinaryVec(queryVector)))
        .annsField("binary_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());
queryVector := []byte{0b11011001, 0b00101010, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0}

annSearchParams := index.NewCustomAnnParam()
annSearchParams.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.BinaryVector(queryVector)},
).WithANNSField("binary_vector").
    WithOutputFields("pk").
    WithAnnParam(annSearchParams))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
// query vector = vector1
let query_vector: Vec<u8> = vec![0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0];

let results = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection")
            .vector_field("binary_vector")
            .vectors(SearchVectors::Binary(vec![query_vector]))
            .limit(5)
            .output_fields(vec!["pk"])
            .metric_type(MetricType::Hamming)
            .build()?,
    )
    .await?;
println!("{:?}", results.results());
// query vector = vector1
std::vector<uint8_t> query_vector = {0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};

auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("binary_vector")
                   .WithLimit(5)
                   .AddOutputField("pk")
                   .AddBinaryVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
const query_vector = [1,0,0,1,1,0,1,1,0,1,0,1,0,1,0,0];

await client.search({
    collection_name: 'my_collection',
    data: query_vector,
    anns_field: 'binary_vector',
    limit: 5,
    output_fields: ['pk'],
    params: { nprobe: 10 }
});
export searchParams='{
        "params":{"nprobe":10}
    }'

export data='[
    {"binary_vector": "2SoAAAAAAAAAAAAAAAAAAA=="}
]'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"data\": $data,
    \"annsField\": \"binary_vector\",
    \"limit\": 5,
    \"searchParams\":$searchParams,
    \"outputFields\": [\"pk\"]
}"
類似検索パラメーターの詳細については、基本的な ANN 検索 を参照してください。