密ベクトル
密ベクトルは、機械学習やデータ分析で広く使用される数値データ表現です。実数の配列で構成され、ほとんどの要素またはすべての要素がゼロ以外です。スパースベクトルと比較して、密ベクトルは同じ次元レベルでより多くの情報を含みます。これは、各次元が意味のある値を保持しているためです。この表現により、複雑なパターンや関係を効果的に捉えることができ、高次元空間でのデータの分析と処理が容易になります。密ベクトルは通常、固定された次元数を持ち、特定のアプリケーションと要件に応じて数十から数百、あるいは数千に及ぶこともあります。
密ベクトルは主に、セマンティック検索やレコメンデーションシステムなど、データのセマンティクスを理解する必要があるシナリオで使用されます。セマンティック検索では、密ベクトルによってクエリとドキュメント間の潜在的なつながりを捉え、検索結果の関連性を向上させることができます。レコメンデーションシステムでは、ユーザーとアイテム間の類似性を特定し、よりパーソナライズされた提案を提供するのに役立ちます。
概要
密ベクトルは通常、[0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5] のような固定長の浮動小数点数配列として表されます。これらのベクトルの次元数は通常、128、256、768、1024 などの数百から数千の範囲です。各次元はオブジェクトの特定のセマンティックな特徴を捉え、類似度計算を通じてさまざまなシナリオに適用できるようにします。
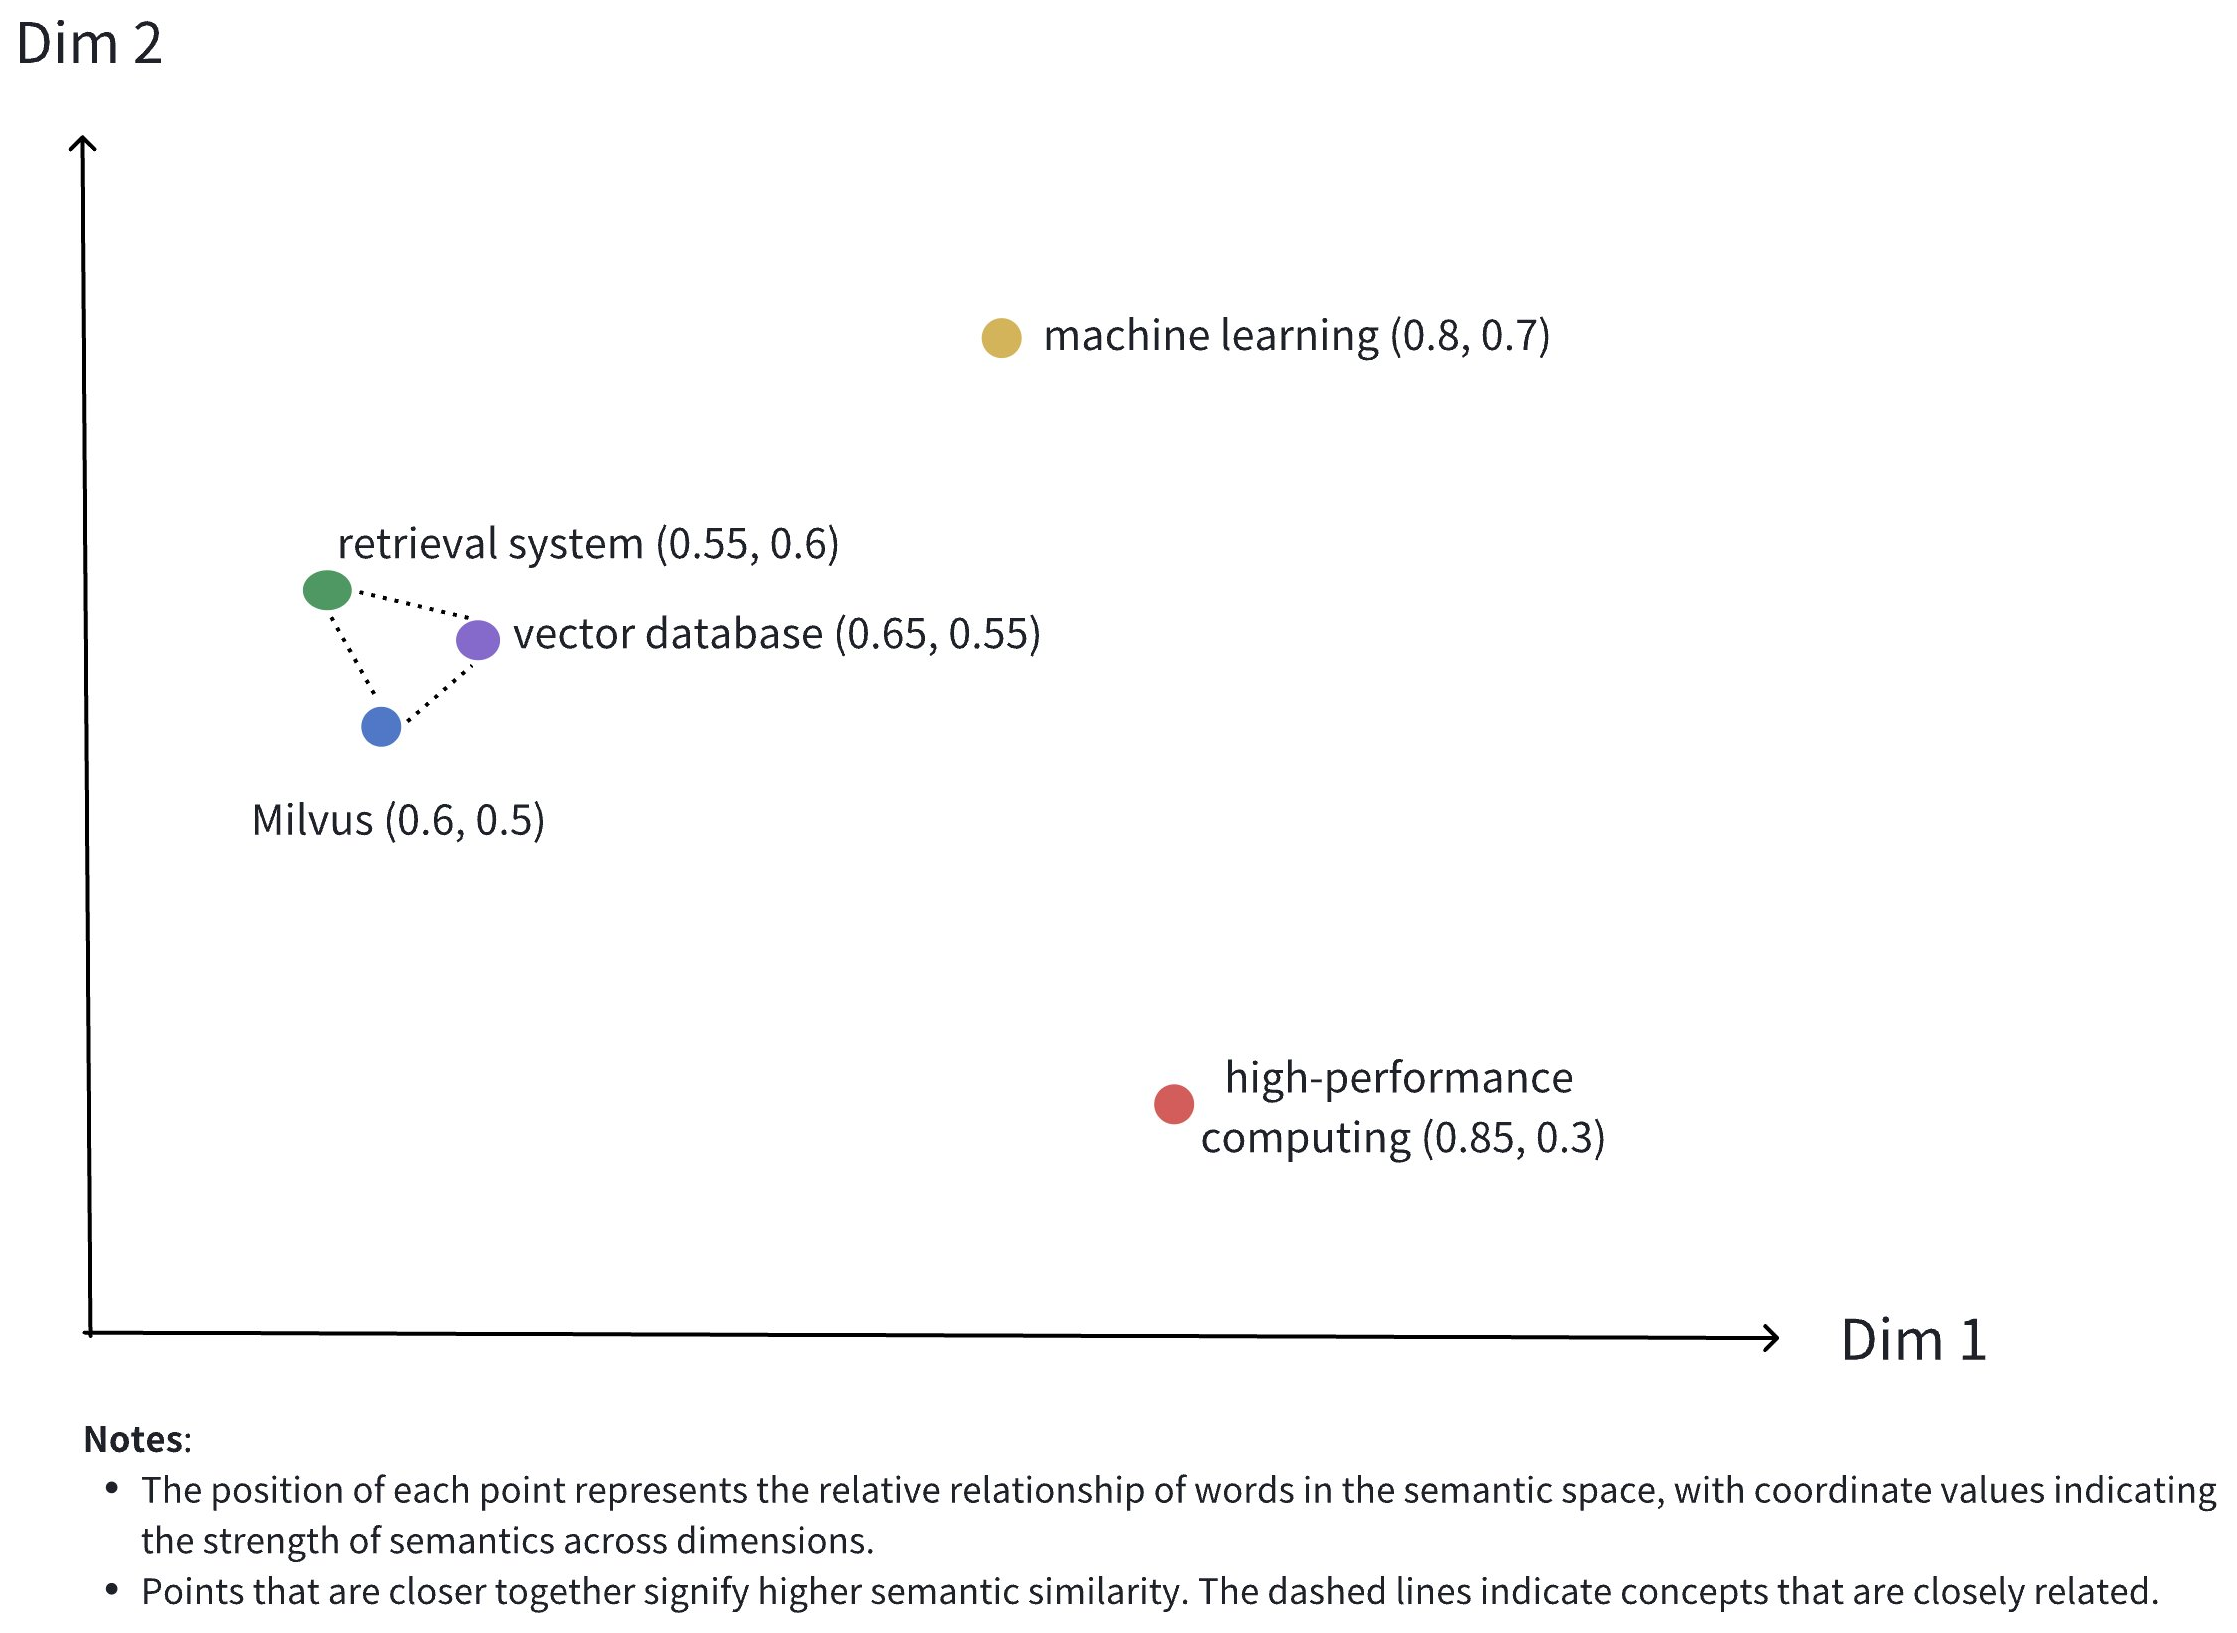
上の図は、2D 空間における密ベクトルの表現を示しています。実際のアプリケーションでは密ベクトルの次元がはるかに高いことがよくありますが、この 2D の図はいくつかの主要な概念を効果的に伝えています。
-
多次元表現: 各点は概念的なオブジェクト(Milvus、ベクトルデータベース、検索システム など)を表し、その位置は各次元の値によって決まります。
-
セマンティックな関係: 点間の距離は概念間のセマンティックな類似性を反映します。点の距離が近いほど、概念の関連性が高いことを示します。
-
クラスタリング効果: 関連する概念(Milvus、ベクトルデータベース、検索システム など)は空間内で互いに近くに配置され、セマンティックなクラスターを形成します。
以下は、テキスト "Milvus is an efficient vector database" を表す実際の密ベクトルの例です。
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
密ベクトルは、画像向けの CNN モデル(ResNet、VGG など)やテキスト向けの言語モデル(BERT、Word2Vec など)を含む、さまざまな embedding モデルを使用して生成できます。これらのモデルは、生データを高次元空間内の点に変換し、データのセマンティックな特徴を捉えます。また、Zilliz Cloud は密ベクトルの生成と処理に役立つ便利な方法を提供しています。詳細は Embeddings で説明しています。
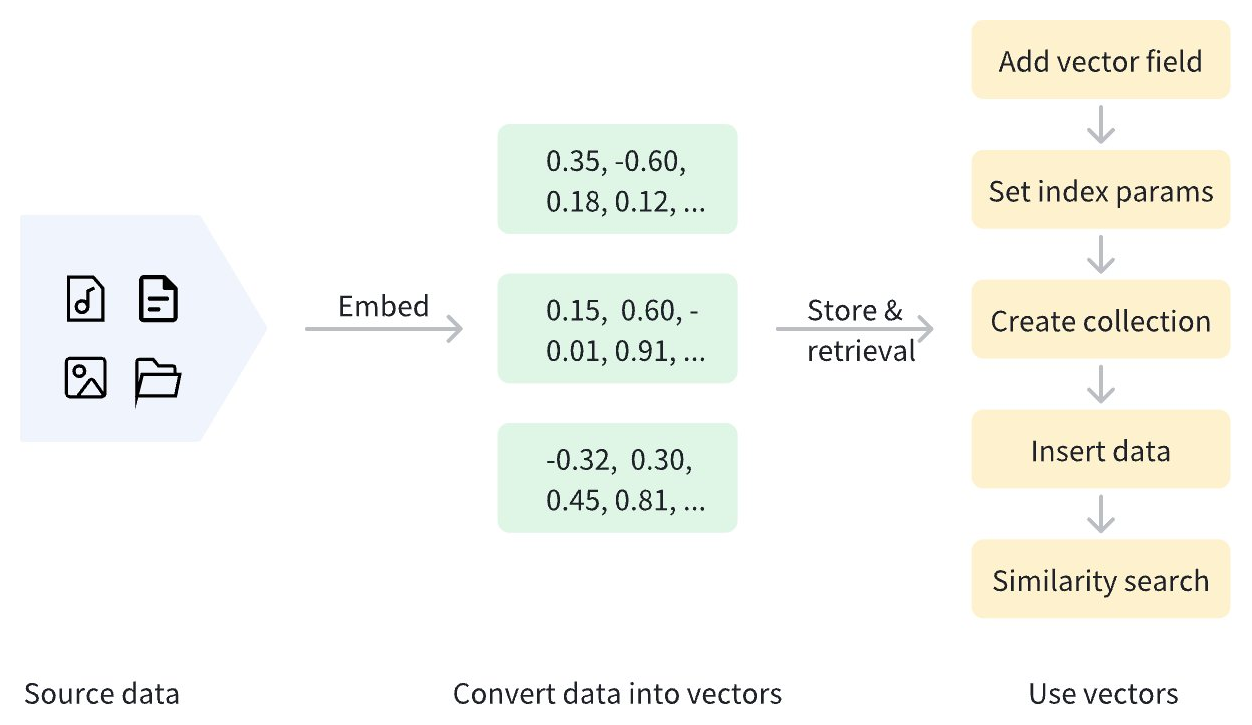
データがベクトル化されると、管理とベクトル検索のために Zilliz Cloud クラスターに保存できます。以下の図は基本的なプロセスを示しています。
密ベクトルを使用する
ベクトルフィールドを追加する
Zilliz Cloud クラスターで密ベクトルを使用するには、まずコレクションの作成時に密ベクトルを保存するベクトルフィールドを定義します。このプロセスには以下が含まれます。
-
datatypeを、サポートされている密ベクトルのデータ型に設定します。サポートされている密ベクトルのデータ型については、Data Types を参照してください。 -
dimパラメーターを使用して、密ベクトルの次元数を指定します。
以下の例では、密ベクトルを保存する dense_vector という名前のベクトルフィールドを追加します。このフィールドのデータ型は FLOAT_VECTOR で、次元数は 4 です。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

// CreateCollection does not implicitly load the collection; load it before search.
loadTask, err := client.LoadCollection(ctx, milvusclient.NewLoadCollectionOption("my_collection"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
if err := loadTask.Await(ctx); err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let client = ClientV2::new(
    &ConnectConfig::new()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN"),
)
.await?;

let schema = CollectionSchema::new()
    .enable_dynamic_field(true)
    .add_field(
        FieldSchema::new()
            .name("pk")
            .data_type(DataType::VarChar)
            .primary_key(true)
            .auto_id(true)
            .max_length(100),
    )
    .add_field(
        FieldSchema::new()
            .name("dense_vector")
            .data_type(DataType::FloatVector)
            .dimension(4),
    );
#include <iostream>
#include <memory>
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(true);
schema->AddField(milvus::FieldSchema("pk", milvus::DataType::VARCHAR, "", true, true).WithMaxLength(100));
schema->AddField(milvus::FieldSchema("dense_vector", milvus::DataType::FLOAT_VECTOR).WithDimension(4));
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: "YOUR_CLUSTER_ENDPOINT"
});

const schema = [
    {
        name: "pk",
        data_type: DataType.VarChar,
        is_primary_key: true,
        autoID: true,
        max_length: 100
    },
    {
        name: "dense_vector",
        data_type: DataType.FloatVector,
        dim: 4
    }
];
using Milvus.Client.V2;
using Milvus.Client.V2.Types;

var client = new MilvusClientV2(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    ApiKey = "YOUR_CLUSTER_TOKEN"
});
await client.ConnectAsync();

var schema = new CollectionSchema
{
    EnableDynamicFields = true,
    Fields =
    {
        FieldSchema.CreateVarchar("pk", maxLength: 100, isPrimaryKey: true, autoId: true),
        FieldSchema.CreateFloatVector("dense_vector", dimension: 4)
    }
};
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
密ベクトルフィールドでサポートされているデータ型:
| データ型 | 説明 |
|---|---|
FLOAT_VECTOR | 32 ビットの浮動小数点数を格納します。科学計算や機械学習で実数を表現するためによく使用されます。類似したベクトルを区別するなど、高い精度が求められるシナリオに適しています。 |
FLOAT16_VECTOR | 16 ビットの半精度浮動小数点数を格納し、深層学習や GPU 計算で使用されます。レコメンデーションシステムの低精度リコールフェーズなど、精度がそれほど重要でないシナリオではストレージスペースを節約します。 |
BFLOAT16_VECTOR | 16 ビットの Brain Floating Point(bfloat16)数値を格納し、Float32 と同じ指数範囲を持ちながら精度が低くなります。大規模な画像検索など、大量のベクトルを高速に処理する必要があるシナリオに適しています。 |
INT8_VECTOR | 各次元の個々の要素が 8 ビット整数(int8)であるベクトルを格納します。各要素の範囲は –128 から 127 です。量子化された深層学習モデル(ResNet、EfficientNet など)向けに設計されており、INT8_VECTOR は精度の損失を最小限に抑えながらモデルサイズを削減し、推論を高速化します。 |
ベクトルフィールドのインデックスパラメーターを設定する
セマンティック検索を高速化するには、ベクトルフィールドにインデックスを作成する必要があります。インデックス作成により、大規模なベクトルデータの検索効率を大幅に向上できます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexName("dense_vector_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

idx := index.NewAutoIndex(entity.IP)
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
use milvus::v2::prelude::*;

let index_params = vec![IndexParam::new()
    .field_name("dense_vector")
    .index_name("dense_vector_index")
    .index_type(IndexType::AutoIndex)
    .metric_type(MetricType::Ip)];
#include <vector>

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("dense_vector", "dense_vector_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP)
};
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
using Milvus.Client.V2;
using Milvus.Client.V2.Types;

var indexParams = new[]
{
    new IndexParam(
        fieldName: "dense_vector",
        indexName: "dense_vector_index",
        indexType: IndexType.AutoIndex,
        metricType: MetricType.Ip)
};
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
上記の例では、AUTOINDEX インデックスタイプを使用して、dense_vector フィールドに dense_vector_index という名前のインデックスを作成します。metric_type は IP に設定されており、距離メトリクスとして内積が使用されることを示します。
Zilliz Cloud は他のメトリクスタイプもサポートしています。詳細については、メトリクスタイプ を参照してください。
コレクションを作成する
密ベクトルとインデックスパラメーターの設定が完了したら、密ベクトルを含むコレクションを作成できます。以下の例では、create_collection メソッドを使用して my_collection という名前のコレクションを作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

loadTask, err := client.LoadCollection(ctx, milvusclient.NewLoadCollectionOption("my_collection"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
if err := loadTask.Await(ctx); err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("my_collection")
            .schema(schema)
            .index_params(index_params)
            .build()?,
    )
    .await?;
// CreateCollection creates the configured indexes and loads the collection automatically.
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                            .WithCollectionName("my_collection")
                                            .WithIndexes(std::move(indexes))
                                            .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const createRes = await client.createCollection({
    collection_name: "my_collection",
    schema: schema,
    index_params: indexParams
});

console.log(createRes);
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Collection;
using Milvus.Client.V2.Types;

await client.CreateCollectionAsync(new CreateCollectionReq
{
    CollectionName = "my_collection",
    Schema = schema,
    Indexes = indexParams
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
データを挿入する
コレクションを作成したら、insert メソッドを使用して、密ベクトルを含むデータを追加します。挿入する密ベクトルの次元数が、密ベクトルフィールドの追加時に定義した dim の値と一致していることを確認してください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.7]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.8]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}

flushTask, err := client.Flush(ctx, milvusclient.NewFlushOption("my_collection"))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
if err := flushTask.Await(ctx); err != nil {
    fmt.Println(err.Error())
    // handle err
}
use milvus::v2::prelude::*;

let rows = vec![
    serde_json::json!({"dense_vector": [0.1, 0.2, 0.3, 0.7]}),
    serde_json::json!({"dense_vector": [0.2, 0.3, 0.4, 0.8]}),
];

let insert = client
    .insert(
        InsertRequest::builder()
            .collection_name("my_collection")
            .rows(rows)
            .build()?,
    )
    .await?;
println!("{} rows inserted", insert.insert_count());
milvus::EntityRows data = {{{"dense_vector", std::vector<float>{0.1, 0.2, 0.3, 0.7}}},
                           {{"dense_vector", std::vector<float>{0.2, 0.3, 0.4, 0.8}}}};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

status = client->Flush(milvus::FlushRequest().AddCollectionName("my_collection"));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const data = [
    { dense_vector: [0.1, 0.2, 0.3, 0.7] },
    { dense_vector: [0.2, 0.3, 0.4, 0.8] }
];

const insertRes = await client.insert({
    collection_name: "my_collection",
    data: data
});

console.log(insertRes);
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Dml;
using Milvus.Client.V2.Types;

var data = new[]
{
    new Dictionary<string, object?>
    {
        ["dense_vector"] = new[] { 0.1f, 0.2f, 0.3f, 0.7f }
    },
    new Dictionary<string, object?>
    {
        ["dense_vector"] = new[] { 0.2f, 0.3f, 0.4f, 0.8f }
    }
};

await client.InsertAsync(new InsertReq
{
    CollectionName = "my_collection",
    RowsData = data
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.8]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
類似検索を実行する
密ベクトルに基づくセマンティック検索は、Zilliz Cloud クラスターの中核機能の 1 つであり、ベクトル間の距離に基づいて、クエリベクトルに最も類似したデータをすばやく見つけられます。類似検索を実行するには、クエリベクトルと検索パラメーターを準備し、search メソッドを呼び出します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.2f, 0.3f, 0.7f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
use milvus::v2::prelude::*;
use std::collections::HashMap;

let query_vector = vec![0.1, 0.2, 0.3, 0.7];

let search = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection")
            .vector_field("dense_vector")
            .vectors(SearchVectors::Float(vec![query_vector]))
            .extra_params(HashMap::from([("nprobe".to_string(), "10".to_string())]))
            .limit(5)
            .output_fields(["pk"])
            .build()?,
    )
    .await?;

println!("{:?}", search.results());
std::vector<float> query_vector = {0.1, 0.2, 0.3, 0.7};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("dense_vector")
                   .WithLimit(5)
                   .AddExtraParam("nprobe", "10")
                   .AddOutputField("pk")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
const query_vector = [0.1, 0.2, 0.3, 0.7];

const searchRes = await client.search({
    collection_name: "my_collection",
    data: query_vector,
    anns_field: "dense_vector",
    limit: 5,
    output_fields: ["pk"],
    params: {
        nprobe: 10
    }
});

console.log(searchRes);
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

var queryVector = new ReadOnlyMemory<float>(new[] { 0.1f, 0.2f, 0.3f, 0.7f });

SearchResp res = await client.SearchAsync(new SearchReq
{
    CollectionName = "my_collection",
    VectorFieldName = "dense_vector",
    Vectors = new[] { queryVector },
    Limit = 5,
    Parameters = new SearchParameters
    {
        Nprobe = 10,
        OutputFields = { "pk" }
    }
});
Console.WriteLine(string.Join(", ", res.SingleResults.SelectMany(r => r.Scores)));
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
類似検索パラメーターの詳細については、基本ベクトル検索 を参照してください。