Partition Key の使用
Partition Key は、コレクションの名前空間として機能することで論理的なデータ分離を可能にする検索最適化ソリューションです。特定のスカラーフィールド(テナント ID やプロジェクト名など)を Partition Key に指定すると、単一のコレクション内でデータを個別の名前空間に効果的に分割できます。これにより、フィルタリング条件を通じて検索リクエストを特定の名前空間に限定でき、検索範囲を大幅に絞り込んで全体的な効率を向上させることができます。本記事では、この名前空間ベースの最適化を実装する方法と、Partition Key を使用する際の注意事項を紹介します。
概要
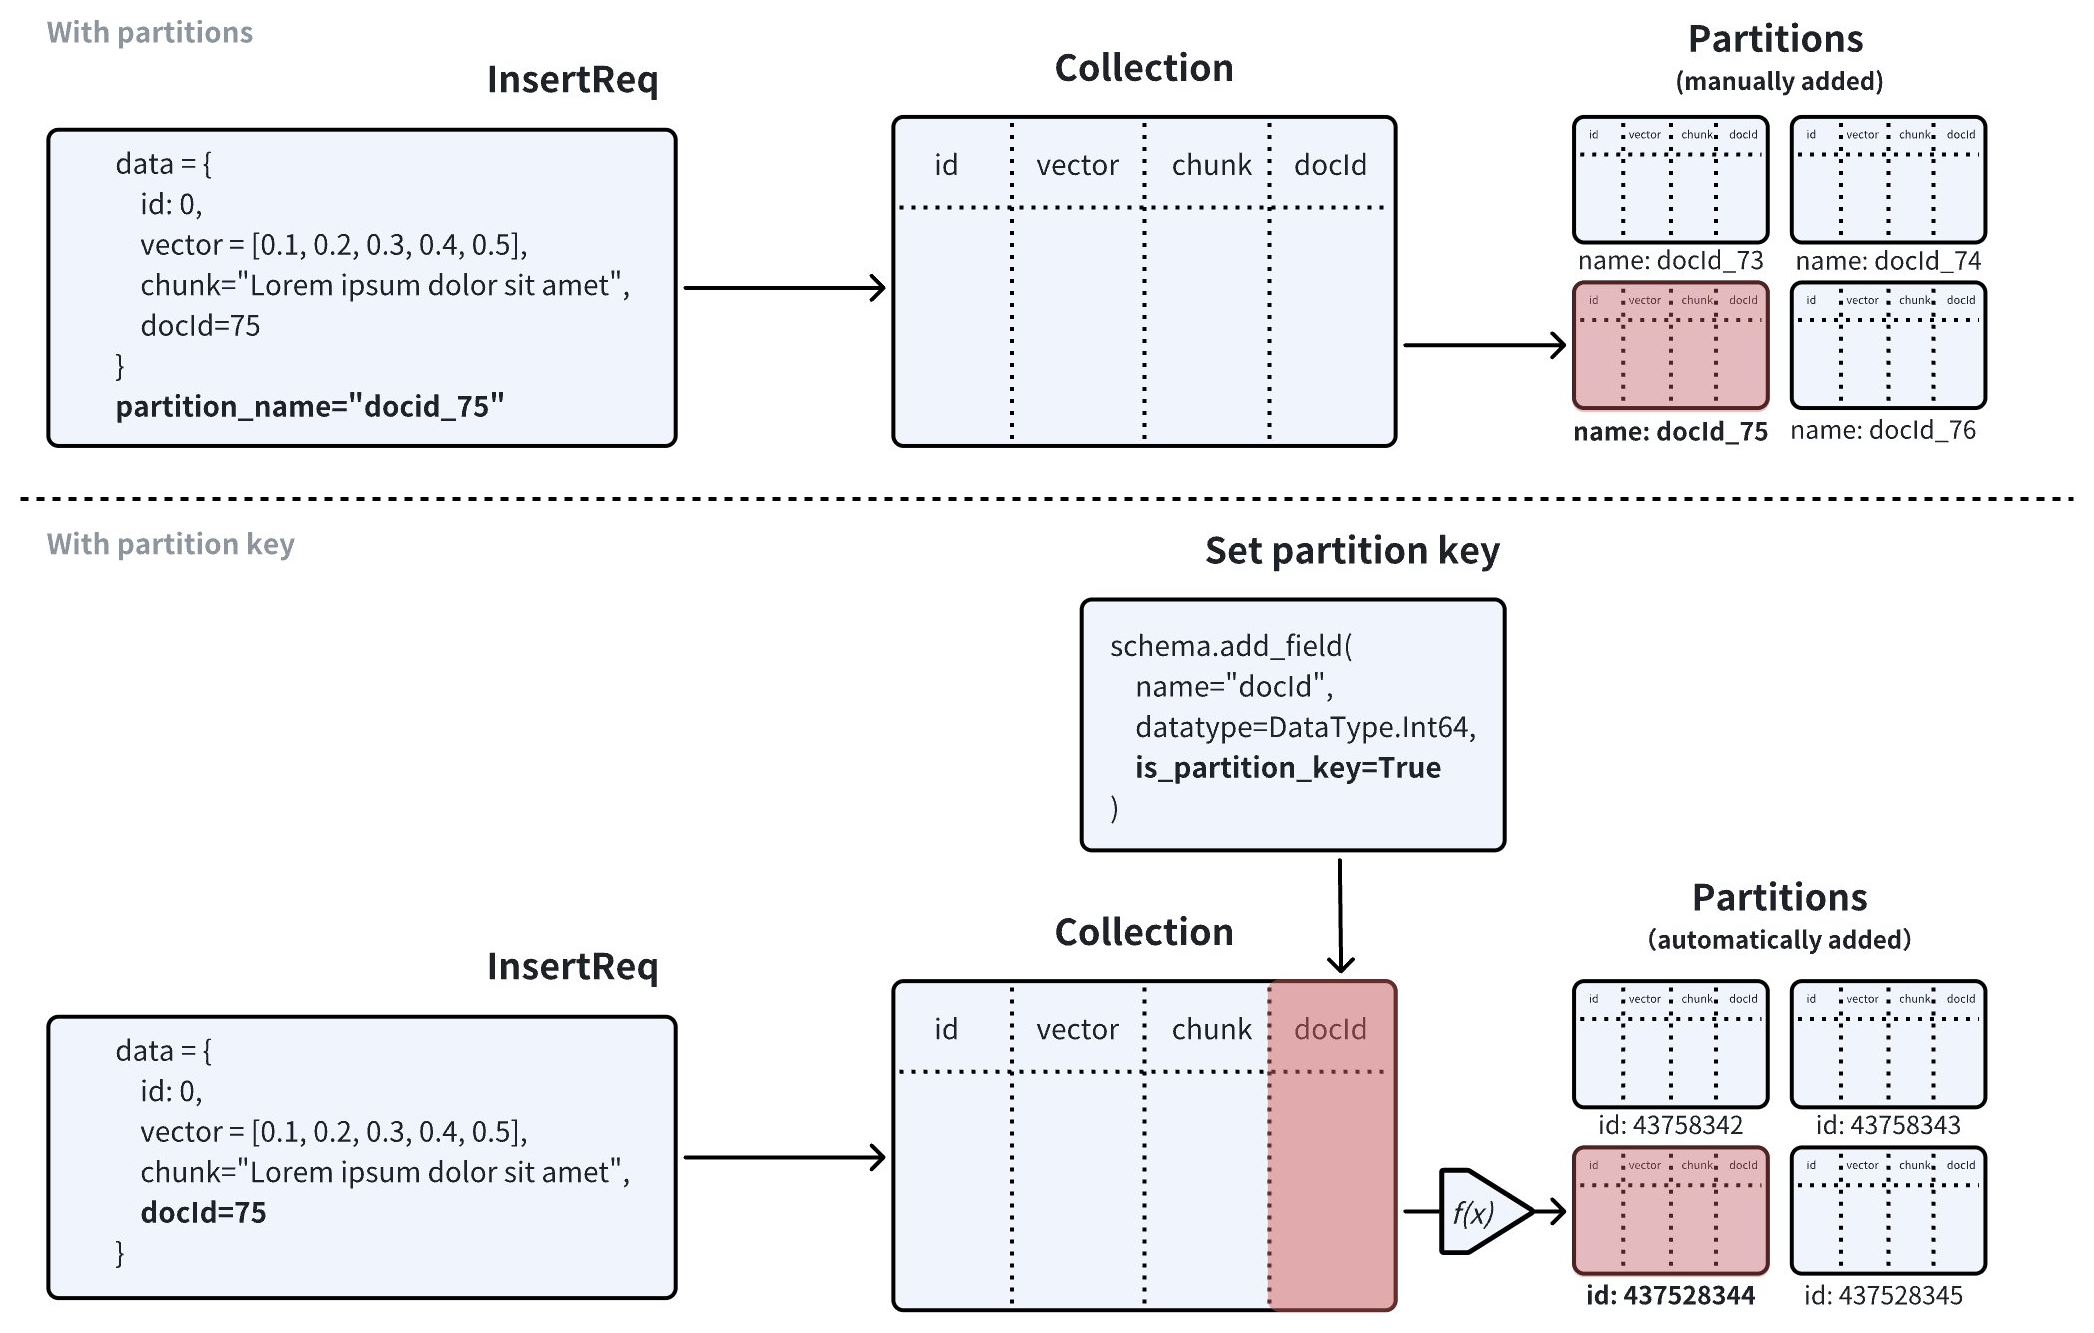
Zilliz Cloud では、パーティションを使用してデータ分離を実装し、検索範囲を特定のパーティションに制限することで検索パフォーマンスを向上させることができます。パーティションを手動で管理する場合、1 つのコレクションに最大 1,024 個のパーティションを作成し、特定のルールに基づいてこれらのパーティションにエンティティを挿入することで、検索を特定の数のパーティション内に制限して検索範囲を絞り込むことができます。
Zilliz Cloud は、コレクションに作成できるパーティション数の制限を克服するために、データ分離でパーティションを再利用できるよう Partition Key を導入しました。コレクションを作成する際に、スカラーフィールドを Partition Key として使用できます。コレクションの準備が完了すると、Zilliz Cloud はコレクション内に指定された数のパーティションを作成します。挿入されたエンティティを受け取ると、Zilliz Cloud はそのエンティティの Partition Key 値を使用してハッシュ値を計算し、ハッシュ値とコレクションの partitions_num プロパティに基づいて剰余演算を実行して対象のパーティション ID を取得し、そのエンティティを対象のパーティションに格納します。
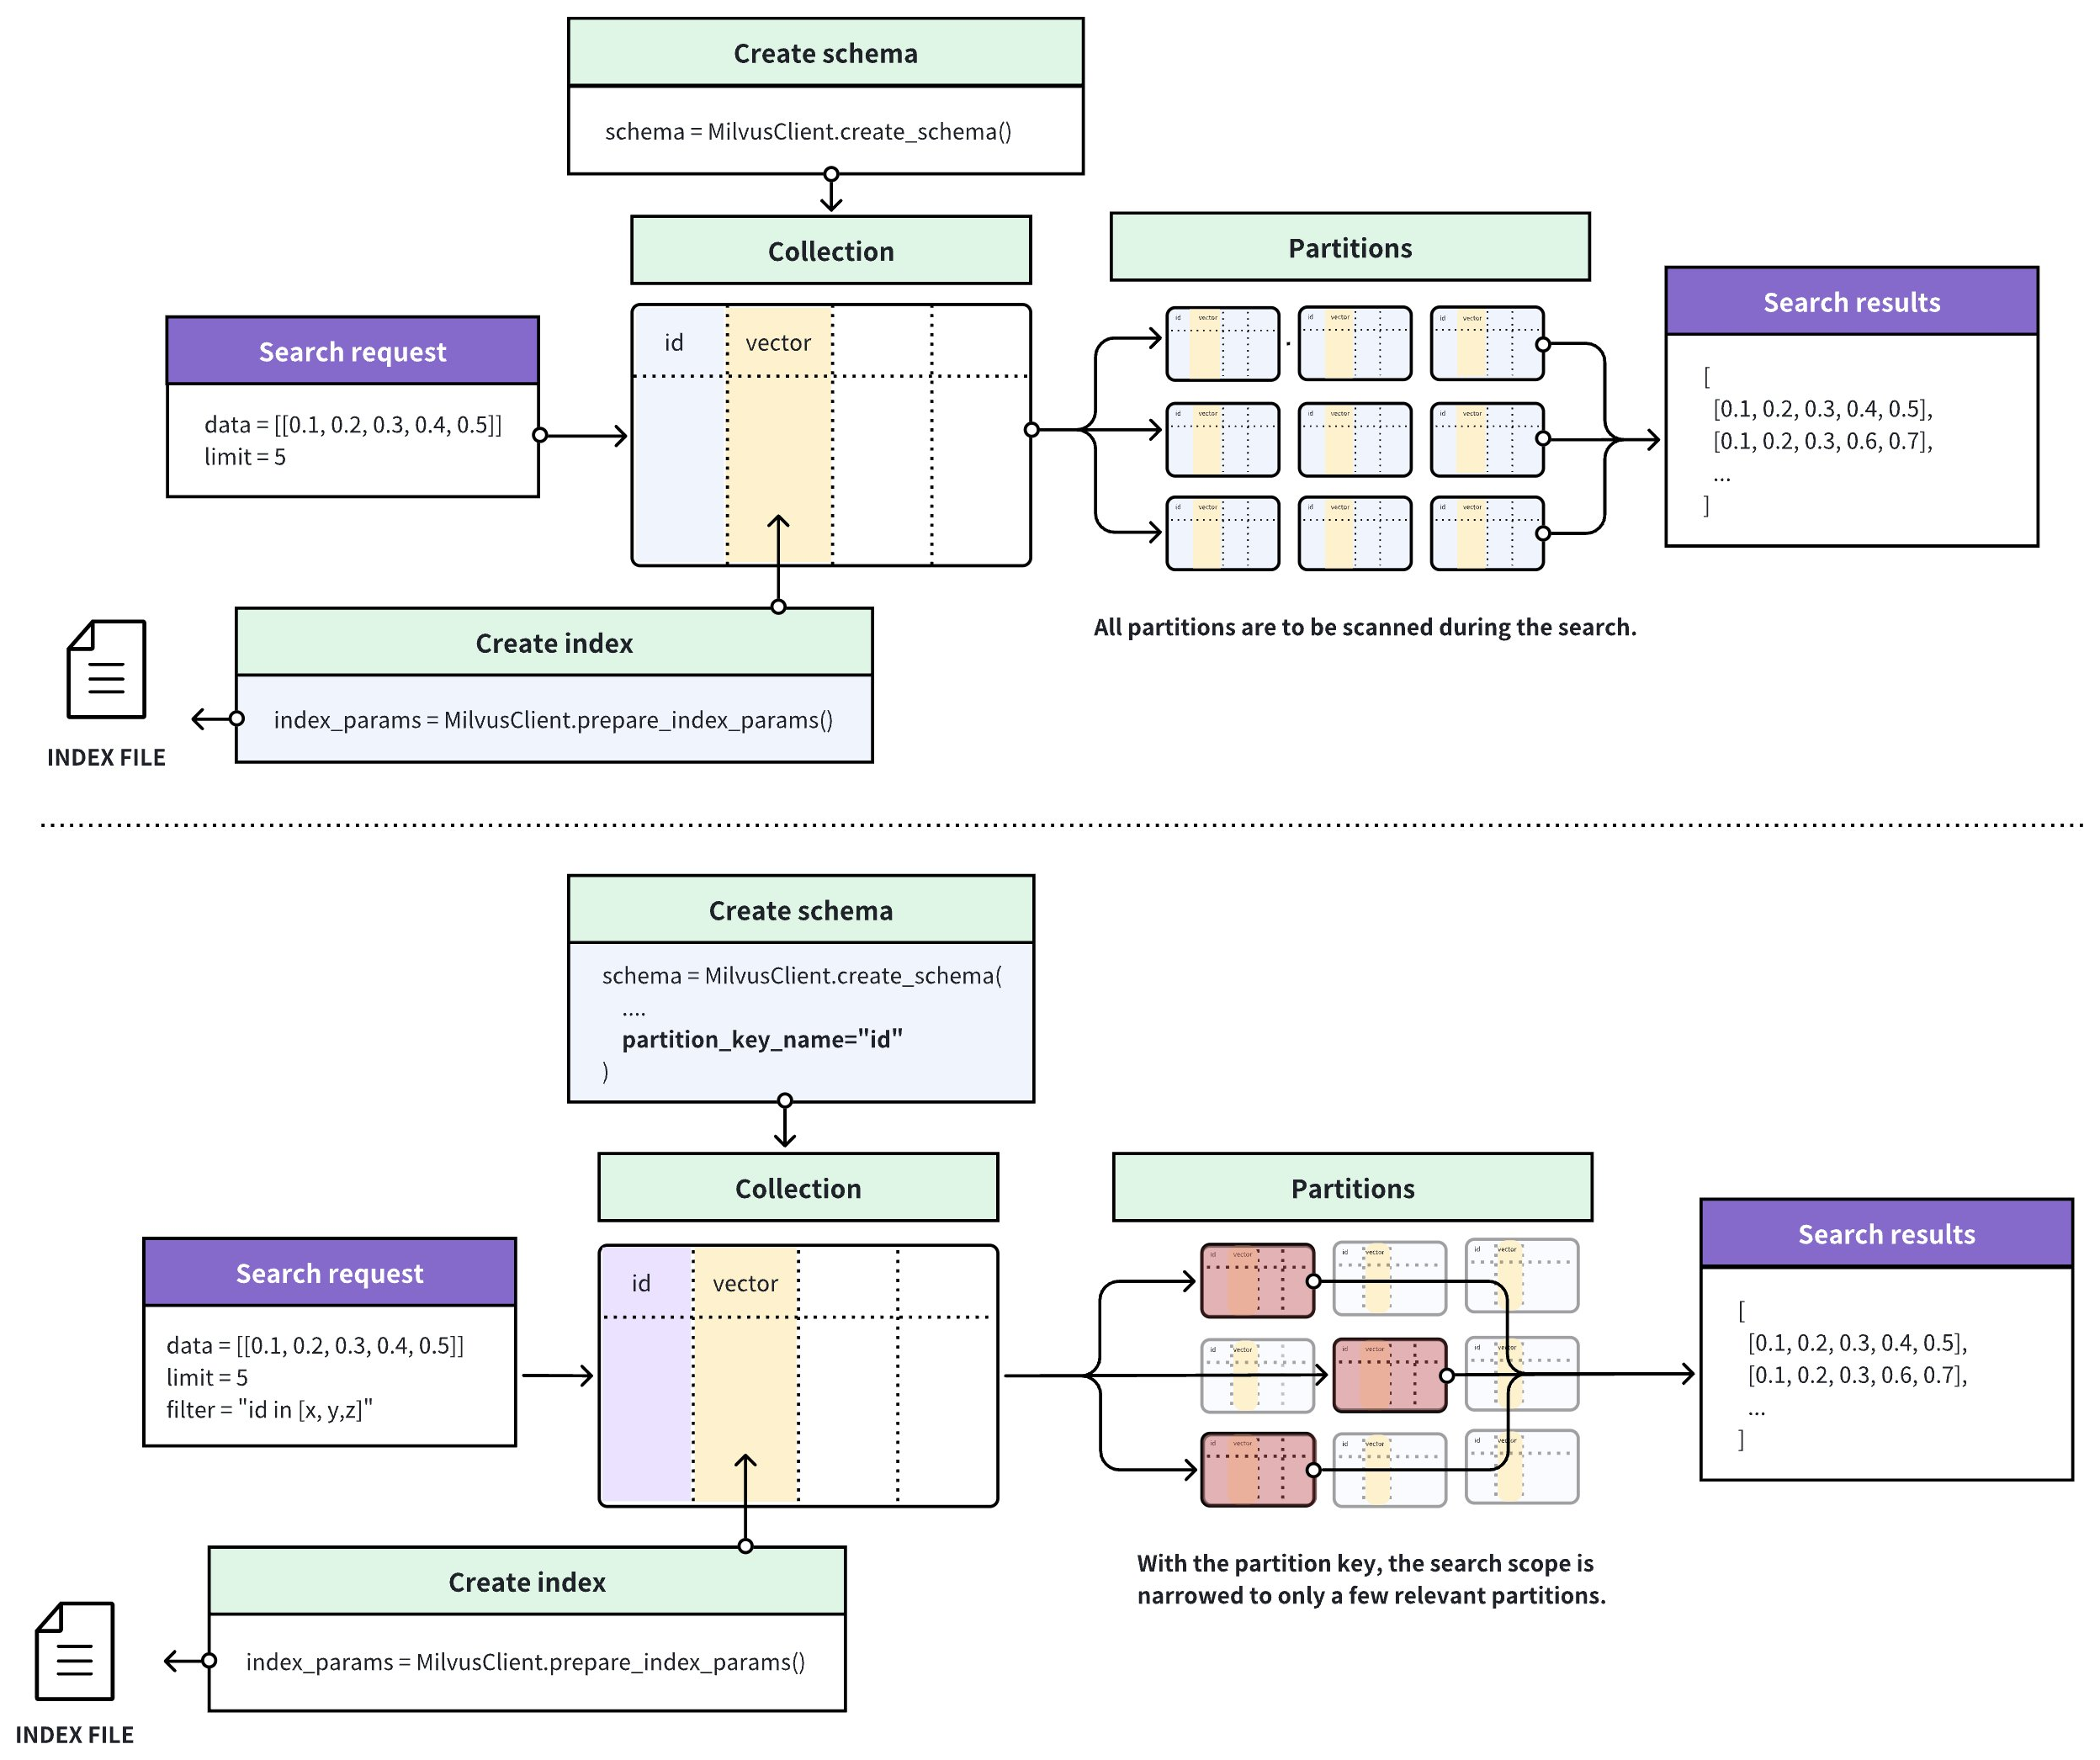
次の図は、Partition Key 機能が有効な場合と無効な場合に、Zilliz Cloud がコレクション内で検索リクエストを処理する方法を示しています。
-
Partition Key が無効な場合、Zilliz Cloud はコレクション内でクエリベクトルに最も類似するエンティティを検索します。最も関連性の高い結果を含むパーティションがわかっている場合は、検索範囲を絞り込むことができます。
-
Partition Key が有効な場合、Zilliz Cloud は検索フィルターで指定された Partition Key 値に基づいて検索範囲を決定し、一致するパーティション内のエンティティのみをスキャンします。
Partition Key の使用
Partition Key を使用するには、以下を行う必要があります。
Partition Key を設定する
スカラーフィールドを Partition Key に指定するには、そのスカラーフィールドを追加するときに is_partition_key 属性を true に設定する必要があります。
スカラーフィールドを Partition Key に設定すると、そのフィールドの値は空または null にできません。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
from pymilvus import (
    MilvusClient, DataType
)

client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

schema = client.create_schema()

schema.add_field(field_name="id",
    datatype=DataType.INT64,
    is_primary=True)

schema.add_field(field_name="vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=5)

# Add the partition key
schema.add_field(
    field_name="my_varchar",
    datatype=DataType.VARCHAR,
    max_length=512,
    is_partition_key=True,
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

// Create schema
CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());

// Add the partition key
schema.addField(AddFieldReq.builder()
        .fieldName("my_varchar")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .isPartitionKey(true)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("my_varchar").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPartitionKey(true).
    WithMaxLength(512),
).WithField(entity.NewField().
    WithName("vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
use milvus::v2::prelude::*;

let config = ConnectConfig::new()
    .uri("YOUR_CLUSTER_ENDPOINT")
    .token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

let schema = CollectionSchema::new()
    .add_field(
        FieldSchema::new()
            .name("id")
            .data_type(DataType::Int64)
            .primary_key(true),
    )
    .add_field(
        FieldSchema::new()
            .name("vector")
            .data_type(DataType::FloatVector)
            .dimension(5),
    )
    .add_field(
        FieldSchema::new()
            .name("my_varchar")
            .data_type(DataType::VarChar)
            .max_length(512)
            .partition_key(true), // Add the partition key
    );
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("vector", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
schema->AddField(milvus::FieldSchema("my_varchar", milvus::DataType::VARCHAR).WithPartitionKey(true).WithMaxLength(512));
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "YOUR_CLUSTER_ENDPOINT";
const token = "YOUR_CLUSTER_TOKEN";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
  {
    name: 'id',
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: 'vector',
    data_type: DataType.FloatVector,
    dim: 5,
  },
  {
    name: 'my_varchar',
    data_type: DataType.VarChar,
    max_length: 512,
    is_partition_key: true,
  },
];
export schema='{
        "autoId": false,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "vector",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            },
            {
                "fieldName": "my_varchar",
                "dataType": "VarChar",
                "isPartitionKey": true,
                "elementTypeParams": {
                    "max_length": 512
                }
            }
        ]
    }'
# Zilliz CLI
パーティション数を設定する
コレクション内のスカラーフィールドを Partition Key に指定すると、Zilliz Cloud はコレクション内に自動的に 16 個のパーティションを作成します。エンティティを受け取ると、Zilliz Cloud はそのエンティティの Partition Key 値に基づいてパーティションを選択し、そのエンティティをパーティションに格納します。その結果、一部またはすべてのパーティションに異なる Partition Key 値を持つエンティティが保持されます。
コレクションとあわせて、作成するパーティション数を指定することもできます。これは、Partition Key として指定されたスカラーフィールドがある場合にのみ有効です。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    num_partitions=128
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
                .collectionName("my_collection")
                .collectionSchema(schema)
                .numPartitions(128)
                .build();
        client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithNumPartitions(128))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
client.create_collection(
    CreateCollectionRequest::builder()
        .collection_name("my_collection")
        .schema(schema)
        .num_partitions(128)
        .build()?,
)
.await?;
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .WithNumPartitions(128));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    num_partitions: 128
})
export params='{
    "partitionsNum": 128
}'

export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"params\": $params
}"
# Zilliz CLI
フィルタリング条件を作成する
Partition Key 機能が有効なコレクションで ANN 検索を実行する場合は、検索リクエストに Partition Key が関係するフィルタリング式を含める必要があります。フィルタリング式では Partition Key 値を特定の範囲内に制限でき、Zilliz Cloud は対応するパーティション内に検索範囲を制限します。
削除操作を実行する場合は、より効率的な削除を実現するために、単一の Partition Key を指定するフィルター式を含めることをおすすめします。この方法では削除操作が特定のパーティションに限定されるため、Compaction 中の書き込み増幅が減少し、Compaction とインデックス作成のためのリソースを節約できます。
次の例は、特定の Partition Key 値と一連の Partition Key 値に基づく Partition Key ベースのフィルタリングを示しています。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
# Filter based on a single partition key value, or
filter='my_varchar == "x" && <other conditions>'

# Filter based on multiple partition key values
filter='my_varchar in ["x", "y", "z"] && <other conditions>'
// Filter based on a single partition key value, or
String filter = "my_varchar == 'x' && <other conditions>";

// Filter based on multiple partition key values
filter = "my_varchar in ['x', 'y', 'z'] && <other conditions>";
// Filter based on a single partition key value, or
filter := "my_varchar == 'x' && <other conditions>"

// Filter based on multiple partition key values
filter = "my_varchar in ['x', 'y', 'z'] && <other conditions>"
// Filter based on a single partition key value, or
let filter = "my_varchar == 'x' && <other conditions>";

// Filter based on multiple partition key values
let filter = "my_varchar in ['x', 'y', 'z'] && <other conditions>";
// Filter based on a single partition key value, or
std::string filter = R"(my_varchar == 'x' && <other conditions>)";

// Filter based on multiple partition key values
filter = R"(my_varchar in ['x', 'y', 'z'] && <other conditions>)";
// Filter based on a single partition key value, or
let filter = 'my_varchar == "x" && <other conditions>'

// Filter based on multiple partition key values
filter = 'my_varchar in ["x", "y", "z"] && <other conditions>'
# Filter based on a single partition key value, or
export filter='my_varchar == "x" && <other conditions>'

# Filter based on multiple partition key values
export filter='my_varchar in ["x", "y", "z"] && <other conditions>'
# Zilliz CLI
partition_key は、Partition Key として指定されたフィールドの名前に置き換える必要があります。
Partition Key Isolation の使用
マルチテナンシーのシナリオでは、テナントの識別情報に関連するスカラーフィールドを Partition Key に指定し、このスカラーフィールド内の特定の値に基づいてフィルターを作成できます。同様のシナリオで検索パフォーマンスをさらに向上させるために、Zilliz Cloud は Partition Key Isolation 機能を導入しました。
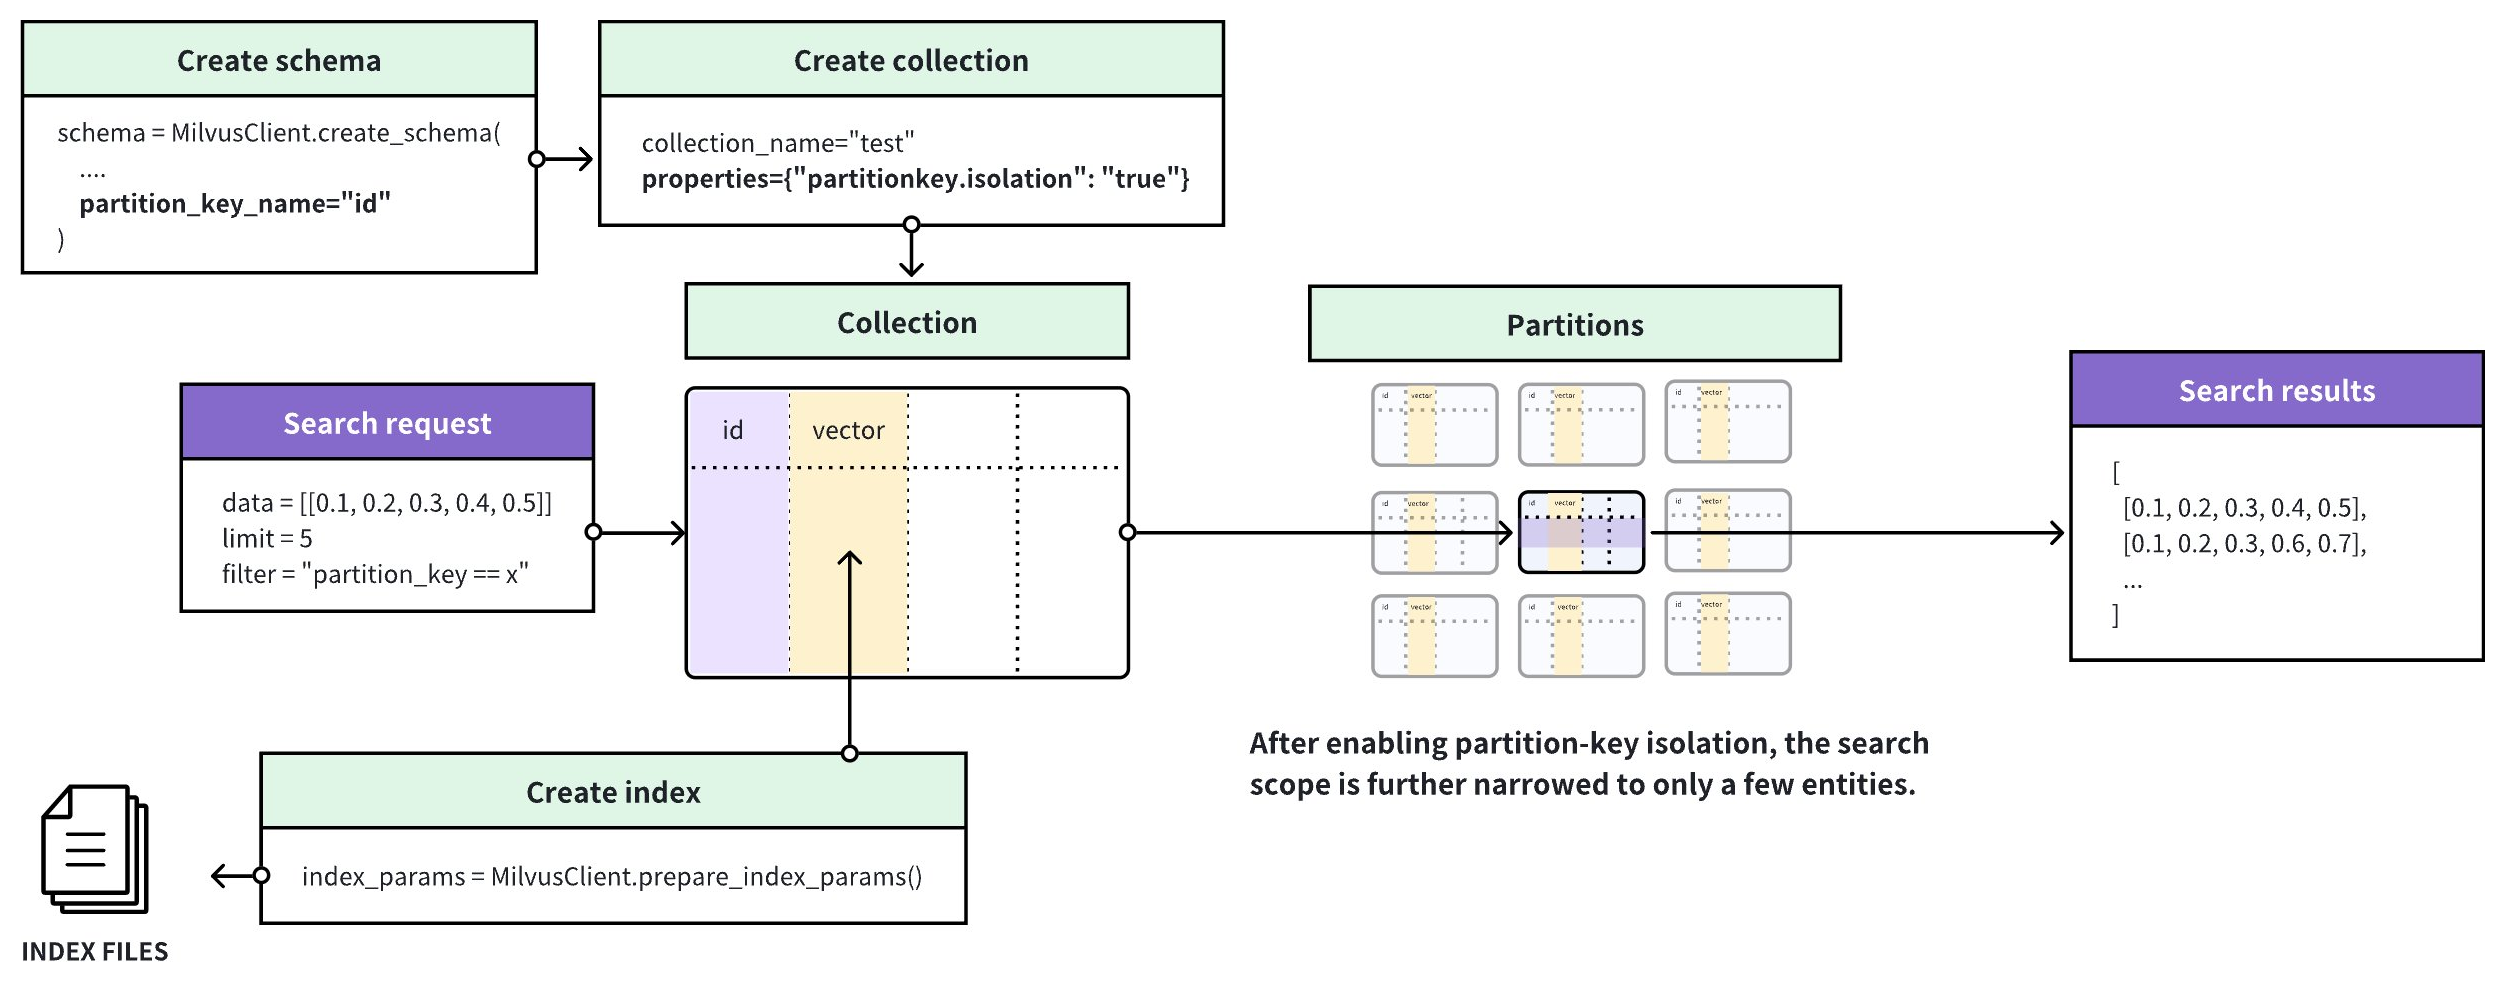
上の図に示すように、Zilliz Cloud は Partition Key 値に基づいてエンティティをグループ化し、これらのグループごとに個別のインデックスを作成します。検索リクエストを受け取ると、Zilliz Cloud はフィルタリング条件で指定された Partition Key 値に基づいてインデックスを特定し、そのインデックスに含まれるエンティティ内に検索範囲を制限します。これにより、検索中に関係のないエンティティをスキャンすることを避け、検索パフォーマンスを大幅に向上させます。
Partition Key Isolation を有効にした後は、Zilliz Cloud が一致するインデックスに含まれるエンティティ内に検索範囲を制限できるように、Partition Key ベースのフィルターに特定の値を 1 つだけ含める必要があります。
Partition Key Isolation を有効にする
次のコード例は、Partition Key Isolation を有効にする方法を示しています。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    properties={"partitionkey.isolation": True}
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import java.util.HashMap;
import java.util.Map;

Map<String, String> properties = new HashMap<>();
properties.put("partitionkey.isolation", "true");

CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .properties(properties)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithProperty("partitionkey.isolation", true))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use std::collections::HashMap;

client.create_collection(
    CreateCollectionRequest::builder()
        .collection_name("my_collection")
        .schema(schema)
        .properties(HashMap::from([(
            "partitionkey.isolation".to_string(),
            "true".to_string(),
        )]))
        .build()?,
)
.await?;
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .AddProperty("partitionkey.isolation", "true"));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    properties: {
        "partitionkey.isolation": true
    }
})
export params='{
    "partitionKeyIsolation": true
}'

export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"params\": $params
}"
# Zilliz CLI
Partition Key Isolation を有効にした後も、パーティション数を設定する で説明されているように、Partition Key とパーティション数を設定できます。Partition Key ベースのフィルターには、特定の Partition Key 値を 1 つだけ含める必要があることに注意してください。