ユースケースに適した Analyzer を選ぶ
このガイドは、Zilliz Cloud のテキストコンテンツに最適な analyzer を選択して設定するのに役立ちます。
このガイドは 実践的な意思決定 に焦点を当てています。どの analyzer を使用するか、いつカスタマイズするか、そして構成をどのように検証するかについて説明します。analyzer のコンポーネントやパラメータの背景については、Analyzer Overview を参照してください。
クイックコンセプト: analyzer の仕組み
analyzer は、全文検索(BM25 ベース)、フレーズ一致、または テキストマッチ などの機能で検索可能になるように、テキストデータを処理します。生のテキストを 2 段階のパイプラインを通じて、検索可能な離散トークンに変換します。
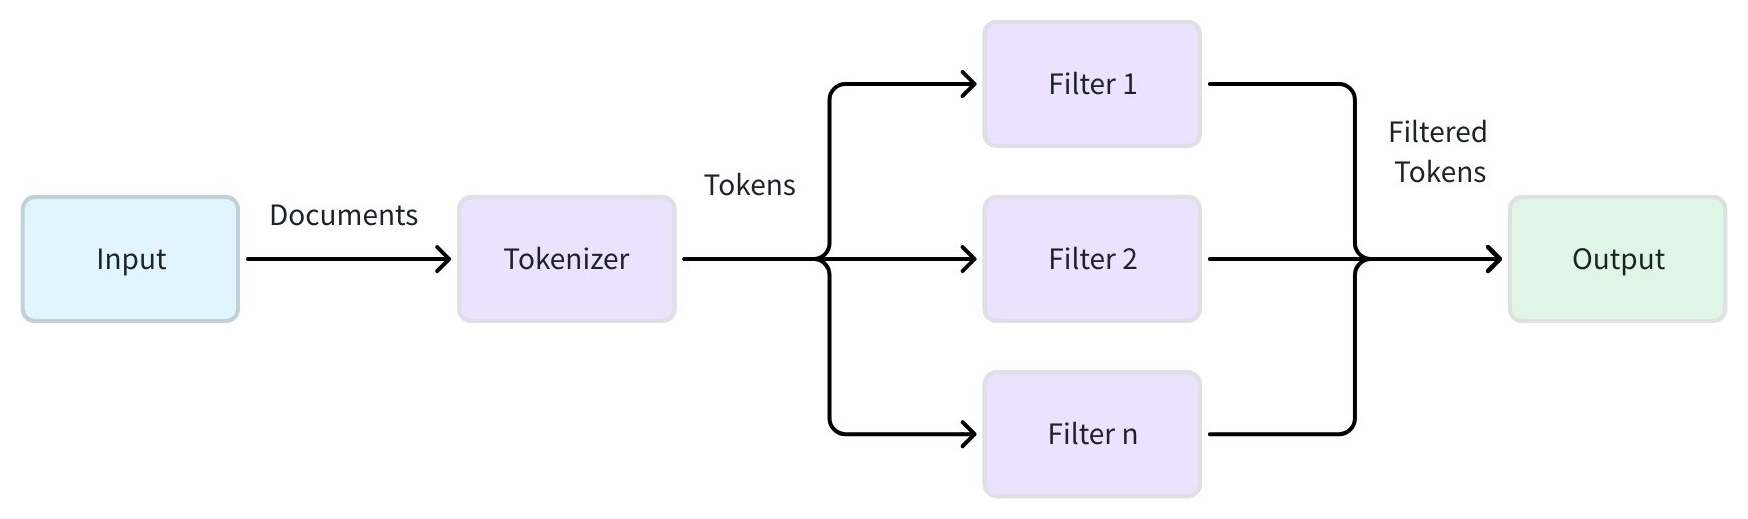
-
トークン化(必須): この最初の段階では、tokenizer を適用して、連続するテキスト文字列をトークンと呼ばれる離散的で意味のある単位に分割します。トークン化の方法は、言語やコンテンツの種類によって大きく異なる場合があります。
-
トークンフィルタリング(任意): トークン化の後、filter を適用してトークンを変更、削除、または精緻化します。これらの操作には、すべてのトークンを小文字に変換する、一般的で意味のない単語(ストップワードなど)を削除する、単語を語根の形に還元する(stemming)などが含まれます。
例:
Input: "Hello World!"
       1. Tokenization → ["Hello", "World", "!"]
       2. Lowercase & Punctuation Filtering → ["hello", "world"]
analyzer の選択が重要な理由
選択する analyzer は、検索品質と関連性 に直接影響します。
不適切な analyzer を使用すると、トークン化の不足や過剰、用語の欠落、無関係な結果が発生する可能性があります。
問題 | 症状 | 例(入力と出力) | 原因(不適切な analyzer) | 解決策(適切な analyzer) |
|---|---|---|---|---|
過剰なトークン化 | 技術用語、識別子、URL が正しく分割されない |
|
|
|
過少なトークン化 | 複数単語のフレーズが単一のトークンとして扱われる |
|
| 句読点とスペースで分割する |
言語のミスマッチ | 外国語の検索結果が無意味になる | 中国語のテキスト: |
|
|
入力方式のミスマッチ | ユーザーはピンインを入力しますが、インデックスされるテキストは中国語の漢字を使用しています。 | 中国語のテキスト: | 中国語の文字トークンのみを出力する analyzer |
ステップ 1: analyzer を選択する必要がありますか?
テキスト検索機能(全文検索、フレーズ一致、テキストマッチ など)を使用しているものの、analyzer を明示的に指定していない 場合、
Zilliz Cloud は自動的に standard analyzer を適用します。
standard analyzer の動作:
-
スペースと句読点でテキストを分割します
-
すべてのトークンを小文字に変換します
変換例:
Input:  "The Milvus vector database is built for scale!"
Output: ['the', 'milvus', 'vector', 'database', 'is', 'built', 'for', 'scale']
ステップ 2: standard analyzer が要件を満たすか確認する
この表を使用して、デフォルトの standard analyzer が要件を満たすかどうかをすばやく判断してください。満たさない場合は、別のパスを選択 する必要があります。
| コンテンツ | standard analyzer で十分か? | 理由 | 必要な対応 |
|---|---|---|---|
| 英語のブログ記事 | はい | デフォルトの動作で十分です。 | デフォルトを使用します(構成は不要です)。 |
| 中国語のドキュメント | いいえ | 中国語の単語にはスペースがなく、1 つのトークンとして扱われます。 | 組み込みの chinese analyzer を使用します。 |
| 技術ドキュメント | いいえ | C++ のような用語から句読点が削除されます。 | whitespace tokenizer と alphanumonly filter を組み合わせたカスタム analyzer を作成します。 |
| French/Spanish などのスペース区切り言語のテキスト | ⚠️ 場合による | アクセント付き文字(café と cafe)が一致しない可能性があります。 | より良い結果を得るには、asciifolding を使用したカスタム analyzer を推奨します。 |
| 多言語または不明な言語 | いいえ | standard analyzer には、異なる文字セットやトークン化ルールを処理するために必要な言語固有のロジックがありません。 | Unicode 対応のトークン化には、icu tokenizer を使用したカスタム analyzer を使用します。または、多言語コンテンツをより正確に処理するために、多言語 analyzer または language identifier の構成を検討してください。 |
ステップ 3: パスを選択する
デフォルトの standard analyzer では不十分な場合は、次の 2 つのパスのいずれかを選択します。
-
パス A – 組み込み analyzer を使用する(すぐに使用可能、言語固有)
-
パス B – カスタム analyzer を作成する(tokenizer と一連の filter を手動で定義する)
パス A: 組み込み analyzer を使用する
組み込み analyzer は、一般的な言語向けに事前構成されたソリューションです。デフォルトの standard analyzer が完全に適合しない場合に、最も簡単に開始できる方法です。
使用可能な組み込み analyzer
Analyzer | 対応言語 | コンポーネント | 注記 |
|---|---|---|---|
ほとんどのスペース区切り言語(英語、フランス語、ドイツ語、スペイン語など) |
| 初期のテキスト処理向けの汎用 analyzer です。単一言語のシナリオでは、言語固有の analyzer( | |
英語専用(Dedicated)で、英語のセマンティックマッチングを改善するために stemming とストップワードの削除を適用します |
| 英語のみのコンテンツでは | |
中国語 |
| 現在はデフォルトで簡体字中国語の辞書を使用します。 |
実装例
組み込み analyzer を使用するには、フィールドスキーマを定義する際に analyzer_params でそのタイプを指定するだけです。
# Using built-in English analyzer
analyzer_params = {
    "type": "english"
}

# Applying analyzer config to target VARCHAR field in your collection schema
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params=analyzer_params,
)
パス B: カスタム analyzer を作成する
組み込みオプション が要件を満たさない場合は、tokenizer と一連の filter を組み合わせてカスタム analyzer を作成できます。これにより、テキスト処理パイプラインを完全に制御できます。
ステップ 1: 言語に基づいて tokenizer を選択する
コンテンツの主要言語に基づいて tokenizer を選択します。
西洋言語
スペース区切り言語の場合は、次のオプションがあります。
Tokenizer | 仕組み | 最適な用途 | 例 |
|---|---|---|---|
スペースと句読点に基づいてテキストを分割します | 一般的なテキスト、句読点が混在するテキスト |
| |
空白文字のみで分割します | 前処理済みのコンテンツ、ユーザーが整形したテキスト |
|
東アジア言語
辞書ベースの言語では、適切な単語分割のために専用の tokenizer が必要です。
中国語
Tokenizer | 仕組み | 最適な用途 | 例 |
|---|---|---|---|
インテリジェントアルゴリズムによる中国語の辞書ベースの分割 | 中国語コンテンツに推奨 - 辞書とインテリジェントアルゴリズムを組み合わせ、中国語向けに特別に設計されています |
| |
中国語辞書(cc-cedict)を使用した純粋な辞書ベースの形態素解析 |
|
|
日本語と韓国語
言語 | Tokenizer | 辞書オプション | 最適な用途 | 例 |
|---|---|---|---|---|
日本語 | ipadic(汎用)、ipadic-neologd(現代用語)、unidic(学術向け) | 固有名詞の処理を含む形態素解析 |
| |
韓国語 | 韓国語の形態素解析 |
|
多言語または不明な言語
言語が予測できない、またはドキュメント内で混在しているコンテンツの場合:
Tokenizer | 仕組み | 最適な用途 | 例 |
|---|---|---|---|
Unicode 対応のトークン化(International Components for Unicode) | 混在する文字体系、不明な言語、または単純なトークン化で十分な場合 |
|
icu を使用する場合:
-
言語の識別が現実的でない混在言語の場合。
-
多言語 analyzer や language identifier のオーバーヘッドを避けたい場合。
-
コンテンツに主要言語があり、全体の意味にほとんど寄与しない外国語が時折含まれる場合(例: 日本語やフランス語のブランド名や技術用語が散見される英語のテキスト)。
代替アプローチ: 多言語コンテンツをより正確に処理するには、多言語 analyzer または language identifier の使用を検討してください。詳細については、多言語 analyzer または language identifier を参照してください。
ステップ 2: 精度を高めるために filter を追加する
tokenizer を選択 した後、特定の検索要件とコンテンツの特性に基づいて filter を適用します。
よく使用される filter
これらの filter は、ほとんどのスペース区切り言語構成(英語、フランス語、ドイツ語、スペイン語など)で不可欠であり、検索品質を大幅に向上させます:
Filter | 仕組み | 使用する場合 | 例 |
|---|---|---|---|
すべてのトークンを小文字に変換します | 普遍的 - 大文字と小文字を区別するすべての言語に適用されます |
| |
単語を語根の形に還元します | 語形変化のある言語(英語、フランス語、ドイツ語など) | 英語の場合:
| |
一般的で意味のない単語を削除します | ほとんどの言語 - 特にスペース区切り言語で効果的です |
|
東アジア言語(中国語、日本語、韓国語など)では、代わりに 言語固有の filter に重点を置いてください。これらの言語は通常、テキスト処理に異なるアプローチを使用するため、stemming の恩恵をあまり受けられない可能性があります。
テキスト正規化 filter
これらの filter は、テキストの表記のばらつきを標準化してマッチングの一貫性を向上させます:
Filter | 仕組み | 使用する場合 | 例 |
|---|---|---|---|
アクセント付き文字を ASCII の等価文字に変換します | 国際的なコンテンツ、ユーザー生成コンテンツ |
|
トークンフィルタリング
文字の内容または長さに基づいて、保持するトークンを制御します:
Filter | 仕組み | 使用する場合 | 例 |
|---|---|---|---|
独立した句読点トークンを削除します |
|
| |
文字と数字のみを保持します | 技術的なコンテンツ、クリーンなテキスト処理 |
| |
指定した長さの範囲外のトークンを削除します | ノイズの除外(長すぎるトークン) |
| |
カスタムのパターンベースのフィルタリング | ドメイン固有のトークン要件 |
|
言語固有の filter
これらの filter は、特定の言語の特性を処理します:
Filter | 言語 | 仕組み | 例 |
|---|---|---|---|
ドイツ語 | 複合語を検索可能な構成要素に分割します |
| |
中国語 | 中国語の文字と英数字を保持します |
| |
中国語 | 中国語の文字のみを保持します |
| |
中国語 | 中国語のトークンに対してピンイン形式のトークンを出力します |
|
ステップ 3: 組み合わせて実装する
カスタム analyzer を作成するには、analyzer_params ディクショナリで tokenizer と filter のリストを定義します。filter は記載された順序で適用されます。
# Example: A custom analyzer for technical content
analyzer_params = {
    "tokenizer": "whitespace",
    "filter": ["lowercase", "alphanumonly"]
}

# Applying analyzer config to target VARCHAR field in your collection schema
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params=analyzer_params,
)
最後に: run_analyzer でテストする
コレクションに適用する前に、必ず構成を検証してください:
# Sample text to analyze
sample_text = "The Milvus vector database is built for scale!"

# Run analyzer with the defined configuration
result = client.run_analyzer(sample_text, analyzer_params)
print("Analyzer output:", result)
確認すべき一般的な問題:
-
過剰なトークン化: 技術用語が正しく分割されない
-
過少なトークン化: フレーズが適切に分割されない
-
トークンの欠落: 重要な用語がフィルタリングによって除外される
詳細な使用方法については、run_analyzer を参照してください。
ユースケース別のクイックレシピ
このセクションでは、Zilliz Cloud で analyzer を使用する際の一般的なユースケース向けに、推奨される tokenizer と filter の構成を提供します。コンテンツの種類と検索要件に最も適した組み合わせを選択してください。
コレクションに analyzer を適用する前に、run_analyzer を使用してテキスト解析のパフォーマンスをテストおよび検証することをお勧めします。
英語
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "english"
        },
        {
            "type": "stop",
            "stop_words": [
                "_english_"
            ]
        }
    ]
}
中国語
{
    "tokenizer": "jieba",
    "filter": ["cnalphanumonly"]
}
アラビア語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "arabic"
        }
    ]
}
ベンガル語
{
    "tokenizer": "icu",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": [<put stop words list here>]
    }]
}
フランス語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "french"
        },
        {
            "type": "stop",
            "stop_words": [
                "_french_"
            ]
        }
    ]
}
ドイツ語
{
    "tokenizer": {
        "type": "lindera",
        "dict_kind": "ipadic"
    },
    "filter": [
        "removepunct"
    ]
}
ヒンディー語
{
    "tokenizer": "icu",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": [<put stop words list here>]
    }]
}
韓国語
{
    "tokenizer": {
        "type": "lindera",
        "dict_kind": "ko-dic",
        "filter": [
            {
                "kind": "korean_stop_tags",
                "tags": ["SP", "SSC", "SSO", "SC", "SE", "SF", "JKS", "JKC", "JKG", "JKO", "JKB", "JKV", "JKQ", "JX", "JC", "UNK", "EP", "ETM"]
            }
        ]
    }
}
日本語
{
    "tokenizer": {
        "type": "lindera",
        "dict_kind": "ipadic"
    },
    "filter": [
        "removepunct"
    ]
}
ポルトガル語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "portuguese"
        },
        {
            "type": "stop",
            "stop_words": [
                "_portuguese_"
            ]
        }
    ]
}
ロシア語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "russian"
        },
        {
            "type": "stop",
            "stop_words": [
                "_russian_"
            ]
        }
    ]
}
スペイン語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "spanish"
        },
        {
            "type": "stop",
            "stop_words": [
                "_spanish_"
            ]
        }
    ]
}
スワヒリ語
{
    "tokenizer": "standard",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": [<put stop words list here>]
    }]
}
トルコ語
{
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "turkish"
        }
    ]
}
ウルドゥー語
{
    "tokenizer": "icu",
    "filter": ["lowercase", {
        "type": "stop",
        "stop_words": [<put stop words list here>]
    }]
}
混在または多言語コンテンツ
複数の言語にまたがるコンテンツや、文字体系が予測できないコンテンツを扱う場合は、icu analyzer から開始してください。この Unicode 対応の analyzer は、混在する文字体系や記号を効果的に処理します。
基本的な多言語構成(stemming なし):
analyzer_params = {
    "tokenizer": "icu",
    "filter": ["lowercase", "asciifolding"]
}
高度な多言語処理:
異なる言語間でトークンの動作をより細かく制御するには:
-
多言語 analyzer 構成を使用します。詳細については、多言語 analyzer を参照してください。
-
コンテンツに language identifier を実装します。詳細については、language identifier を参照してください。
Zilliz Cloud での analyzer の構成とプレビュー
Zilliz Cloud では、コードを記述することなく、Zilliz Cloud コンソール から直接テキスト analyzer を構成してテストできます。