JSON/JSON Lines ファイルからのインポート
JSON(JavaScript Object Notation)は、軽量で人間が読みやすく、マシンが容易に解析・生成できるデータ形式です。言語に依存せず、C 系言語のプログラマーにとって馴染みのある規約に従うため、データ交換形式として理想的です。
JSON Line は、各行が完全で有効な JSON オブジェクトであるテキスト形式であり、標準的なテキストツールを使ってデータストリームを段階的に処理しやすくします。
以下の表に、JSON ファイルまたは JSON Line ファイルのデータ例を示します。
ファイル形式 | 例 |
|---|---|
JSON (.json) | |
JSON Lines (.ndjson, .jsonl) | |
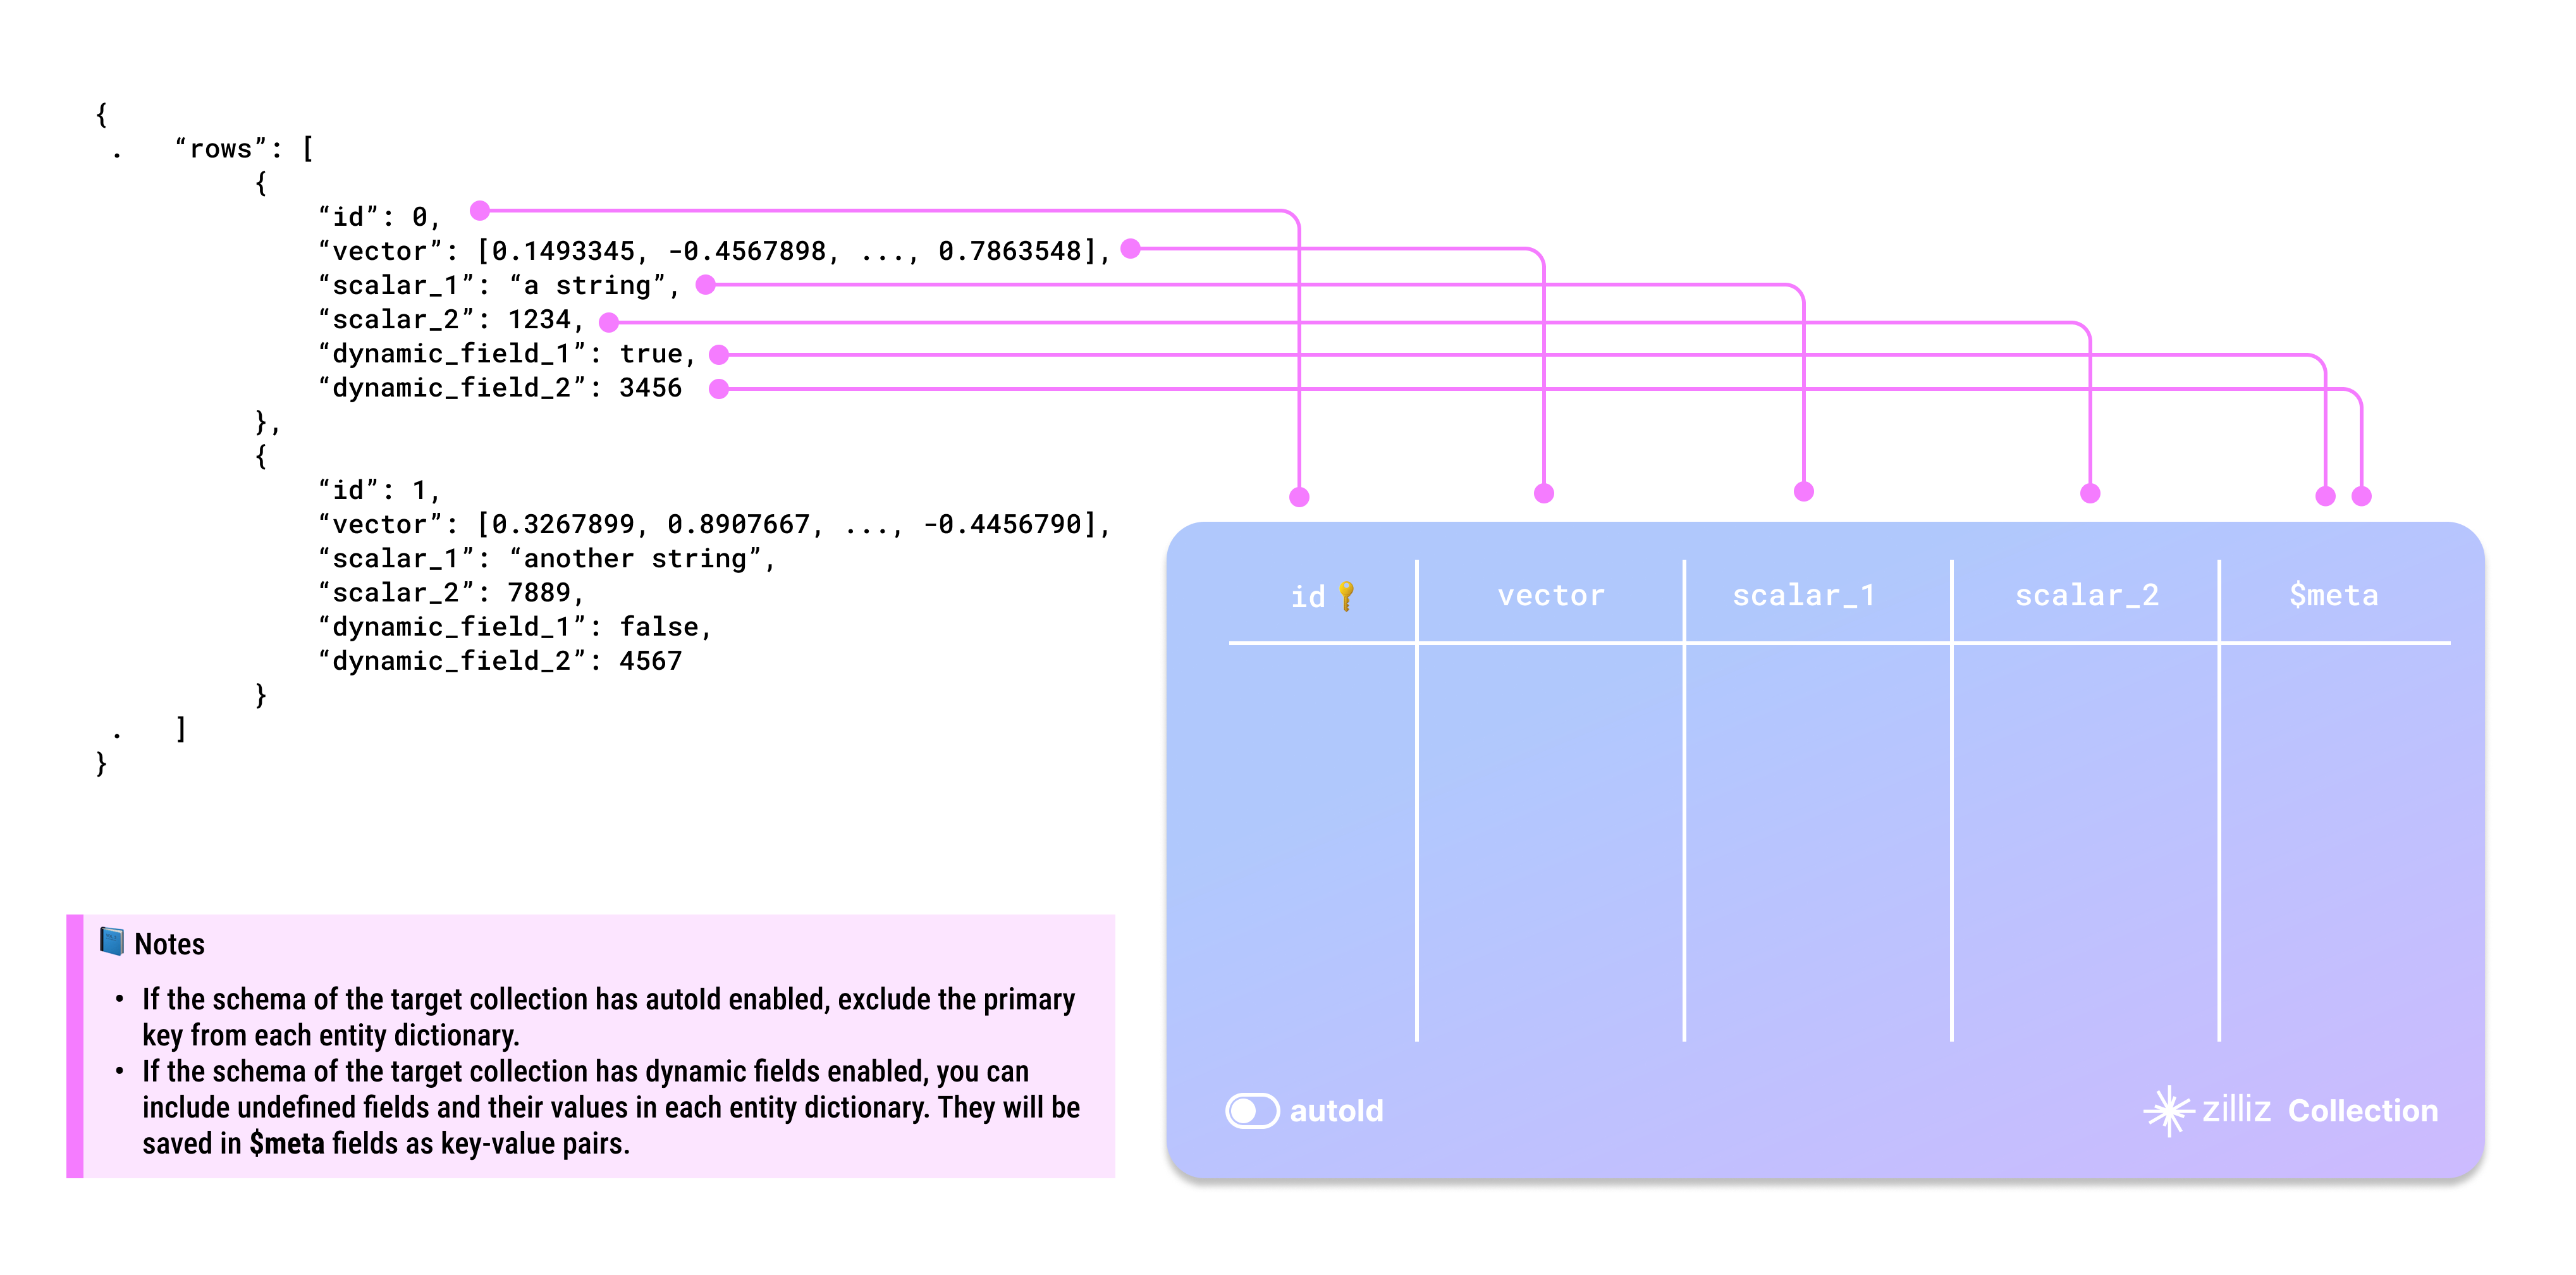
生データを JSON ファイルに準備するには、the BulkWriter tool の使用をお勧めします。以下の図は、生データをどのように JSON ファイルにマッピングできるかを示しています。
-
AutoID を有効にするかどうか
id フィールドはコレクションの主フィールドとして機能します。主フィールドを自動インクリメントにするには、スキーマで AutoID を有効にします。この場合、ソースデータの各行から id フィールドを除外する必要があります。
-
動的フィールドを有効にするかどうか
ターゲットコレクションで動的フィールドが有効になっている場合、事前定義されたスキーマに含まれないフィールドを保存する必要があるときは、書き込み操作時に $meta 列を指定し、対応するキーと値のデータを指定できます。
-
大文字と小文字の区別
ディクショナリのキーとコレクションのフィールド名は大文字と小文字を区別します。データ内のディクショナリのキーが、ターゲットコレクションのフィールド名と完全に一致することを確認してください。ターゲットコレクションに id という名前のフィールドがある場合、各エンティティのディクショナリには id という名前のキーが必要です。ID または Id を使用するとエラーになります。
ディレクトリ構造
データを JSON ファイルまたは JSON Lines ファイルとして準備する場合は、以下のツリー図に示すように、すべてのファイルをソースデータフォルダーに直接配置します。
├── json-folder
│   ├── 1.json
│   └── 2.json
データのインポート
データの準備ができたら、以下のいずれかの方法で Zilliz Cloud コレクションにインポートできます。
ファイルが比較的小さい場合は、フォルダーまたは複数パスの方法を使用してすべてを一度にインポートすることをお勧めします。この方法により、インポートプロセス中に内部的な最適化が可能になり、その後のリソース消費を抑えるのに役立ちます。
Milvus SDK を使用して Zilliz Cloud コンソールでデータをインポートすることもできます。詳細については、Import Data (Console) および Import Data (SDK) を参照してください。
複数のパスからのファイルのインポート(推奨)
複数のパスからファイルをインポートする場合は、以下のコード例のように、各 JSON ファイルのパスを個別のリストに含め、その後ですべてのリストを上位のリストにまとめます。
curl --request POST \
     --url "https://api.cloud.zilliz.com/v2/vectordb/jobs/import/create" \
     --header "Authorization: Bearer ${TOKEN}" \
     --header "Accept: application/json" \
     --header "Content-Type: application/json" \
     -d '{
        "clusterId": "inxx-xxxxxxxxxxxxxxx",
        "collectionName": "medium_articles",
        "partitionName": "",
        "objectUrls": [
            ["s3://bucket-name/json-folder-1/1.json"],
            ["s3://bucket-name/json-folder-2/1.json"],
            ["s3://bucket-name/json-folder-3/"]
         ],
        "accessKey": "",
        "secretKey": ""
    }'
フォルダーからのファイルのインポート
ソースフォルダーにインポートするファイルが含まれている場合は、以下のようにリクエストにソースフォルダーを含めることができます。
curl --request POST \
     --url "https://api.cloud.zilliz.com/v2/vectordb/jobs/import/create" \
     --header "Authorization: Bearer ${TOKEN}" \
     --header "Accept: application/json" \
     --header "Content-Type: application/json" \
     -d '{
        "clusterId": "inxx-xxxxxxxxxxxxxxx",
        "collectionName": "medium_articles",
        "partitionName": "",
        "objectUrls": [
            ["s3://bucket-name/json-folder/"]
         ],
        "accessKey": "",
        "secretKey": ""
    }'
フォルダーに複数の形式のファイルが含まれている場合、リクエストは失敗します。
単一ファイルのインポート
準備したデータファイルが単一の JSON ファイルである場合は、以下のコード例に示すようにインポートします。
curl --request POST \
     --url "https://api.cloud.zilliz.com/v2/vectordb/jobs/import/create" \
     --header "Authorization: Bearer ${TOKEN}" \
     --header "Accept: application/json" \
     --header "Content-Type: application/json" \
     -d '{
        "clusterId": "inxx-xxxxxxxxxxxxxxx",
        "collectionName": "medium_articles",
        "partitionName": "",
        "objectUrls": [
            ["s3://bucket-name/json-folder/1.json"]
         ],
        "accessKey": "",
        "secretKey": ""
    }'
ストレージパス
Zilliz Cloud は、お使いのクラウドストレージからのデータインポートをサポートしています。以下の表に、データファイルに使用できるストレージパスを示します。
| Cloud | Quick Examples |
|---|---|
| AWS S3 | s3://bucket-name/json-folder/ s3://bucket-name/json-folder/data.json |
| Google Cloud Storage | gs://bucket-name/json-folder/ gs://bucket-name/json-folder/data.json |
| Azure Bolb | https://myaccount.blob.core.windows.net/bucket-name/json-folder/ https://myaccount.blob.core.windows.net/bucket-name/json-folder/data.json |
制限事項
ローカルの JSON ファイルまたはクラウドストレージの JSON ファイルからデータをインポートする際には、守る必要があるいくつかの制限があります。
有効な JSON ファイルには rows という名前のルートキーがあり、その対応する値はディクショナリのリストで、各ディクショナリはターゲットコレクションのスキーマに一致するエンティティを表します。
インポート方法 | クラスタープラン | 1 回のインポートあたりの最大ファイル数 | 最大ファイルサイズ | 最大合計インポートサイズ |
|---|---|---|---|---|
ローカルファイルから | すべてのプラン | 1 ファイル | 1 GB | 1 GB |
オブジェクトストレージから | Free | 1,000 ファイル | 1 GB | 1 GB |
Serverless & Dedicated | 1,000 ファイル | 10 GB | 1 TB |
Prepare the data file を参照してデータを自分で再構築するか、the BulkWriter tool を使用してソースデータファイルを生成できます。上の図のスキーマに基づいて準備されたサンプルデータをダウンロードするには、ここをクリックしてください。