フルテキスト検索
フルテキスト検索は、テキストデータセット内で特定の用語やフレーズを含むドキュメントを取得し、その後、関連性に基づいて結果をランク付けする機能です。この機能は、正確な用語を見落とす可能性があるセマンティック検索の制限を克服し、最も正確で文脈に即した結果を確実に得られるようにします。さらに、生のテキスト入力を受け入れ、手動でベクトル埋め込みを生成することなくテキストデータを自動的にスパース埋め込みに変換することで、ベクトル検索を簡素化します。
関連性スコアリングに BM25 アルゴリズムを使用するこの機能は、retrieval-augmented generation(RAG)のシナリオで特に有用であり、特定の検索語句に密接に一致するドキュメントを優先します。
フルテキスト検索をセマンティックベースの密ベクトル検索と統合することで、検索結果の精度と関連性を高めることができます。詳細については、ハイブリッド検索 を参照してください。
Zilliz Cloud は、フルテキスト検索をプログラムから、または Web コンソール経由で有効にすることをサポートしています。このページでは、フルテキスト検索をプログラムから有効にする方法について説明します。Web コンソールでの操作の詳細については、コレクションの管理(コンソール) を参照してください。
BM25 実装
Zilliz Cloud は、情報検索システムで広く採用されているスコアリング関数である BM25 関連性アルゴリズムを活用したフルテキスト検索を提供しており、Zilliz Cloud はそれを検索ワークフローに統合することで、正確で関連性に基づいてランク付けされたテキスト結果を提供します。
Zilliz Cloud のフルテキスト検索は、次のワークフローに従います。
-
生のテキスト入力: テキストドキュメントを挿入するか、プレーンテキストでクエリを指定します。埋め込みモデルは必要ありません。
-
テキスト解析: Zilliz Cloud は analyzer を使用して、テキストをインデックス化および検索可能な意味のある用語に処理します。
-
BM25 関数処理: 組み込み関数がこれらの用語を、BM25 スコアリングに最適化されたスパースベクトル表現に変換します。
-
コレクションストア: Zilliz Cloud は、生成されたスパース埋め込みをコレクションに格納し、高速な取得とランク付けを可能にします。
-
BM25 関連性スコアリング: 検索時に、Zilliz Cloud は BM25 スコアリング関数を適用してドキュメントの関連性を計算し、クエリ語句に最も一致するランク付けされた結果を返します。
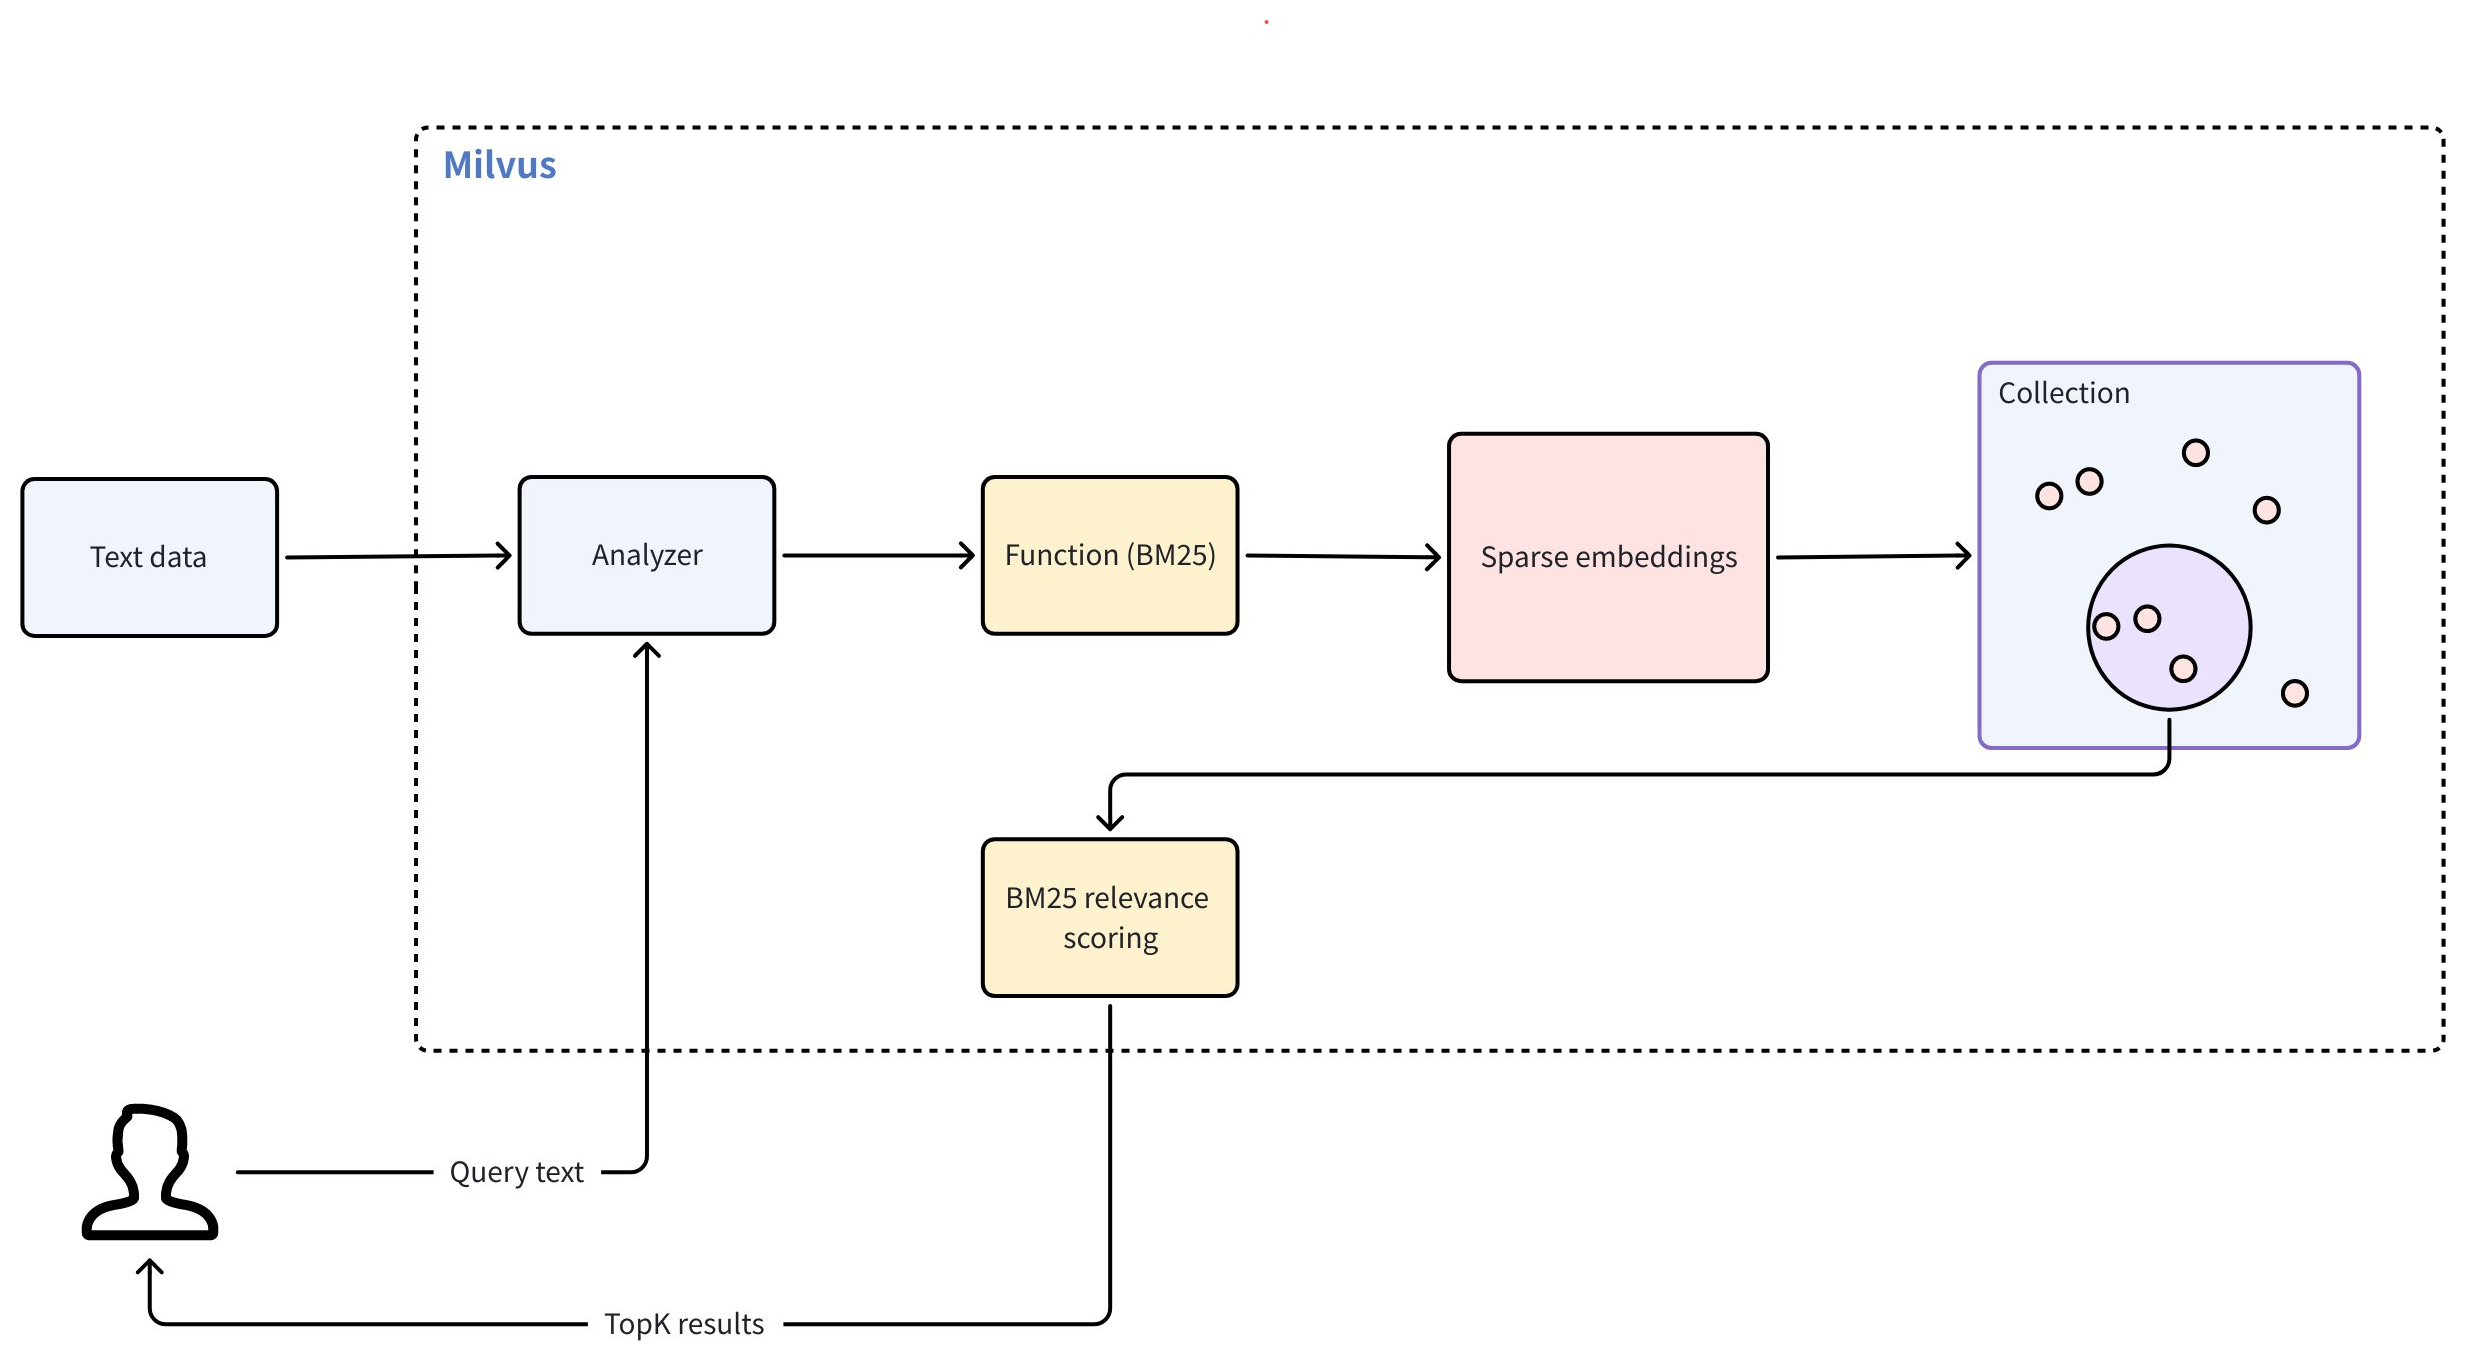
フルテキスト検索を使用するには、次の主な手順に従います。
-
コレクションを作成する: 必要なフィールドを設定し、生のテキストをスパース埋め込みに変換する BM25 関数を定義します。
-
データを挿入する: 生のテキストドキュメントをコレクションに取り込みます。
-
検索を実行する: 自然言語のクエリテキストを使用して、BM25 の関連性に基づくランク付けされた結果を取得します。
BM25 フルテキスト検索用のコレクションを作成する
BM25 を利用したフルテキスト検索を有効にするには、必要なフィールドを備えたコレクションを準備し、スパースベクトルを生成する BM25 関数を定義し、インデックスを構成してから、コレクションを作成する必要があります。
スキーマフィールドを定義する
コレクションのスキーマには、少なくとも 3 つの必須フィールドを含める必要があります。
-
プライマリフィールド: コレクション内の各エンティティを一意に識別します。
-
文字列フィールド (
VARCHARまたはTEXT): 生のテキストドキュメントを格納します。Zilliz Cloud が BM25 関連性ランキングのためにテキストを処理できるよう、enable_analyzer=Trueを設定する必要があります。デフォルトでは、Zilliz Cloud はテキスト解析にstandardanalyzer を使用します。別の analyzer を設定するには、Analyzer の概要 を参照してください。このページの例ではVARCHARを使用しています。長いテキストの場合は、入力フィールドをTEXTとして定義し、max_lengthを省略できます。完全な例については、Text フィールド を参照してください。 -
スパースベクトルフィールド (
SPARSE_FLOAT_VECTOR): BM25 関数によって自動的に生成されるスパース埋め込みを格納します。
- Python
- Java
- Go
- NodeJS
- cURL
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True) # Primary field
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True) # Text field
schema.add_field(field_name="sparse", datatype=DataType.SPARSE_FLOAT_VECTOR) # Sparse vector field; no dim required for sparse vectors
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("sparse")
        .dataType(DataType.SparseFloatVector)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
token := "YOUR_CLUSTER_TOKEN"

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
    APIKey: token
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("sparse").
    WithDataType(entity.FieldTypeSparseVector),
)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "YOUR_CLUSTER_ENDPOINT";
const token = "YOUR_CLUSTER_TOKEN";
const client = new MilvusClient({address, token});
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "sparse",
    data_type: DataType.SparseFloatVector,
  },
];

console.log(schema);
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ]
    }'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("sparse", milvus::DataType::SPARSE_FLOAT_VECTOR));
# Zilliz CLI
前述の設定は以下のとおりです。
-
id: 主キーとして機能し、auto_id=Trueによって自動生成されます。 -
text: フルテキスト検索操作用の生のテキストデータを格納します。データ型はVARCHARである必要があります。VARCHARは Zilliz Cloud でテキストを格納するための文字列データ型です。 -
sparse: フルテキスト検索操作用に内部的に生成されたスパース埋め込みを格納するために予約されたベクトルフィールドです。データ型はSPARSE_FLOAT_VECTORである必要があります。
BM25 関数を定義する
BM25 関数は、トークン化されたテキストを BM25 スコアリングをサポートするスパースベクトルに変換します。
関数を定義し、スキーマに追加します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
bm25_function = Function(
    name="text_bm25_emb", # Function name
    input_field_names=["text"], # Name of the VARCHAR field containing raw text data
    output_field_names=["sparse"], # Name of the SPARSE_FLOAT_VECTOR field reserved to store generated embeddings
    function_type=FunctionType.BM25, # Set to `BM25`
)

schema.add_function(bm25_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("sparse"))
        .build());
function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("sparse").
    WithType(entity.FunctionTypeBM25)
schema.WithFunction(function)
const functions = [
    {
      name: 'text_bm25_emb',
      description: 'bm25 function',
      type: FunctionType.BM25,
      input_field_names: ['text'],
      output_field_names: ['sparse'],
      params: {},
    },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ],
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["sparse"],
                "params": {}
            }
        ]
    }'
milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25);
function->AddInputFieldName("text");
function->AddOutputFieldName("sparse");
schema->AddFunction(function);
# Zilliz CLI
| パラメーター | 説明 |
|---|---|
name | 関数の名前です。この関数は、text フィールドの生のテキストを BM25 互換のスパースベクトルに変換し、それらを sparse フィールドに格納します。 |
input_field_names | テキストからスパースベクトルへの変換が必要な VARCHAR フィールドの名前です。FunctionType.BM25 の場合、このパラメーターは 1 つのフィールド名のみを受け付けます。 |
output_field_names | 内部的に生成されたスパースベクトルを格納するフィールドの名前です。FunctionType.BM25 の場合、このパラメーターは 1 つのフィールド名のみを受け付けます。 |
function_type | 使用する関数のタイプです。FunctionType.BM25 を指定する必要があります。 |
複数の VARCHAR フィールドで BM25 処理が必要な場合は、フィールドごとに 1 つの BM25 関数を定義し、それぞれに一意の名前と出力フィールドを設定してください。
インデックスを設定する
必要なフィールドと組み込み関数を含むスキーマを定義したら、コレクションのインデックスを設定します。このプロセスを簡素化するには、index_type として AUTOINDEX を使用します。これは、データの構造に基づいて最適なインデックスタイプを Zilliz Cloud が選択して構成できるようにするオプションです。
- Python
- Java
- Go
- NodeJS
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="sparse",
    index_type="AUTOINDEX",
    metric_type="BM25"
)
import io.milvus.v2.common.IndexParam;

Map<String,Object> params = new HashMap<>();
params.put("inverted_index_algo", "DAAT_MAXSCORE");
params.put("bm25_k1", 1.2);
params.put("bm25_b", 0.75);

List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("sparse")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(params)
        .build());
indexOption := milvusclient.NewCreateIndexOption("my_collection", "sparse",
    index.NewAutoIndex(entity.MetricType(entity.BM25)))
    .WithExtraParam("inverted_index_algo", "DAAT_MAXSCORE")
    .WithExtraParam("bm25_k1", 1.2)
    .WithExtraParam("bm25_b", 0.75)
const index_params = [
  {
    field_name: "sparse",
    metric_type: "BM25",
    index_type: "SPARSE_INVERTED_INDEX",
    params: {
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }
  },
];
export indexParams='[
        {
            "fieldName": "sparse",
            "metricType": "BM25",
            "indexType": "AUTOINDEX",
            "params":{
               "inverted_index_algo": "DAAT_MAXSCORE",
               "bm25_k1": 1.2,
               "bm25_b": 0.75
            }
        }
    ]'
auto index_params = milvus::IndexDesc("sparse", "", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25);
index_params.AddExtraParam("inverted_index_algo", "DAAT_MAXSCORE");
index_params.AddExtraParam("bm25_k1", "1.2");
index_params.AddExtraParam("bm25_b", "0.75");
# Zilliz CLI
パラメーター | 説明 |
|---|---|
| インデックスを作成するベクトルフィールドの名前です。フルテキスト検索では、生成されたスパースベクトルを格納するフィールドを指定します。この例では、値を |
| 作成するインデックスのタイプです。 |
| このパラメーターの値は、特にフルテキスト検索機能で使用する場合、 |
| インデックスに固有の追加パラメーターの辞書です。 |
| インデックスの構築とクエリに使用されるアルゴリズムです。有効な値は次のとおりです。
|
| 用語頻度の飽和を制御します。値を大きくすると、ドキュメントのランキングにおける用語頻度の重要度が高まります。値の範囲: [1.2, 2.0]。 |
| ドキュメントの長さが正規化される程度を制御します。通常は 0 ~ 1 の値が使用され、デフォルト値は 0.75 です。値 0 は長さの正規化を行わないことを意味し、値 1 は完全な長さの正規化を意味します。 |
コレクションを作成する
次に、定義したスキーマとインデックスパラメーターを使用してコレクションを作成します。
- Python
- Java
- Go
- NodeJS
- cURL
client.create_collection(
    collection_name='my_collection',
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
await client.create_collection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: index_params,
    functions: functions
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                    .WithCollectionName("my_collection")
                                    .WithCollectionSchema(schema)
                                    .AddIndex(std::move(index_params)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
# Zilliz CLI
テキストデータを挿入する
コレクションとインデックスを設定したら、テキストデータを挿入する準備が整います。このプロセスでは、生のテキストを指定するだけで済みます。先ほど定義した組み込み関数が、各テキストエントリに対応するスパースベクトルを自動的に生成します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
client.insert('my_collection', [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
])
import com.google.gson.Gson;
import com.google.gson.JsonObject;

import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
List<JsonObject> rows = Arrays.asList(
        gson.fromJson("{\"text\": \"information retrieval is a field of study.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"information retrieval focuses on finding relevant information in large datasets.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"data mining and information retrieval overlap in research.\"}", JsonObject.class)
);

client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithVarcharColumn("text", []string{
        "information retrieval is a field of study.",
        "information retrieval focuses on finding relevant information in large datasets.",
        "data mining and information retrieval overlap in research.",
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
await client.insert({
    collection_name: 'my_collection',
    data: [
        {'text': 'information retrieval is a field of study.'},
        {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
        {'text': 'data mining and information retrieval overlap in research.'},
    ],
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"text": "information retrieval is a field of study."},
        {"text": "information retrieval focuses on finding relevant information in large datasets."},
        {"text": "data mining and information retrieval overlap in research."}
    ],
    "collectionName": "my_collection"
}'
milvus::EntityRows data = {
    {{"text", "information retrieval is a field of study."}},
    {{"text", "information retrieval focuses on finding relevant information in large datasets."}},
    {{"text", "data mining and information retrieval overlap in research."}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data))
                                , response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
# Zilliz CLI
フルテキスト検索を実行する
コレクションにデータを挿入したら、生のテキストクエリを使用してフルテキスト検索を実行できます。Zilliz Cloud はクエリを自動的にスパースベクトルに変換し、BM25 アルゴリズムを使用して一致した検索結果をランク付けしてから、上位 topK(limit)件の結果を返します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
search_params = {
    'params': {'level': 10},
}

res = client.search(
    collection_name='my_collection',
    data=['whats the focus of information retrieval?'],
    anns_field='sparse',
    output_fields=['text'], # Fields to return in search results; sparse field cannot be output
    limit=3,
    search_params=search_params
)

print(res)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("level", 10);
SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new EmbeddedText("whats the focus of information retrieval?")))
        .annsField("sparse")
        .topK(3)
        .searchParams(searchParams)
        .outputFields(Collections.singletonList("text"))
        .build());
annSearchParams := index.NewCustomAnnParam()
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.Text("whats the focus of information retrieval?")},
).WithConsistencyLevel(entity.ClStrong).
    WithANNSField("sparse").
    WithAnnParam(annSearchParams).
    WithOutputFields("text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("text: ", resultSet.GetColumn("text").FieldData().GetScalars())
}
await client.search({
    collection_name: 'my_collection',
    data: ['whats the focus of information retrieval?'],
    anns_field: 'sparse',
    output_fields: ['text'],
    limit: 3,
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data-raw '{
    "collectionName": "my_collection",
    "data": [
        "whats the focus of information retrieval?"
    ],
    "annsField": "sparse",
    "limit": 3,
    "outputFields": [
        "text"
    ],
    "searchParams":{
        "params":{}
    }
}'
auto request = milvus::SearchRequest()
                       .WithCollectionName("my_collection")
                       .AddEmbeddedText("whats the focus of information retrieval?")
                       .WithLimit(3)
                       .WithAnnsField("sparse")
                       .AddOutputField("text");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
# Zilliz CLI
| パラメーター | 説明 |
|---|---|
search_params | 検索パラメーターを含む辞書です。 |
params.level | 簡素化された検索最適化によって検索精度を制御します。詳細については、再現率の調整 を参照してください。 |
data | 自然言語による生のクエリテキストです。Zilliz Cloud は BM25 関数を使用してテキストクエリを自動的にスパースベクトルに変換します。事前に計算されたベクトルは指定しないでください。 |
anns_field | 内部的に生成されたスパースベクトルを含むフィールドの名前です。 |
output_fields | 検索結果で返すフィールド名のリストです。BM25 で生成された埋め込みを含む スパースベクトルフィールドを除く すべてのフィールドをサポートします。一般的な出力フィールドには、主キーフィールド(例: id)や元のテキストフィールド(例: text)があります。詳細については、FAQ を参照してください。 |
limit | 返す上位一致の最大数です。 |
FAQ
フルテキスト検索で BM25 関数が生成したスパースベクトルを出力またはアクセスできますか?
いいえ、BM25 関数によって生成されたスパースベクトルは、フルテキスト検索で直接アクセスしたり出力したりすることはできません。詳細は次のとおりです。
-
BM25 関数は、ランキングと取得のために内部的にスパースベクトルを生成します
-
これらのベクトルはスパースフィールドに格納されますが、
output_fieldsに含めることはできません -
出力できるのは、元のテキストフィールドとメタデータ(
id、textなど)のみです
例:
- Python
- Java
- Go
- NodeJS
- cURL
# ❌ This throws an error - you cannot output the sparse field
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text', 'sparse'],  # 'sparse' causes an error
    limit=3,
    search_params=search_params
)

# ✅ This works - output text fields only
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text'],
    limit=3,
    search_params=search_params
)
// Searching with the sparse field in outputFields throws an error.
// Only output the original text and metadata fields.
SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new EmbeddedText("query text")))
        .annsField("sparse")
        .topK(3)
        .outputFields(Collections.singletonList("text"))
        .build());
// Searching with the sparse field in output_fields throws an error.
// Only output the original text and metadata fields.
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection",
    3,
    []entity.Vector{entity.Text("query text")},
).WithConsistencyLevel(entity.ClStrong).
    WithANNSField("sparse").
    WithAnnParam(index.NewCustomAnnParam()).
    WithOutputFields("text"))
// Searching with the sparse field in output_fields throws an error.
// Only output the original text and metadata fields.
await client.search({
    collection_name: 'my_collection',
    data: ['query text'],
    anns_field: 'sparse',
    output_fields: ['text'],
    limit: 3,
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data-raw '{
    "collectionName": "my_collection",
    "data": ["query text"],
    "annsField": "sparse",
    "limit": 3,
    "outputFields": ["text"]
}'
// Searching with the sparse field in output_fields throws an error.
// Only output the original text and metadata fields.
milvus::SearchRequest request = milvus::SearchRequest()
    .WithCollectionName("my_collection")
    .AddEmbeddedText("query text")
    .WithLimit(3)
    .WithAnnsField("sparse")
    .AddOutputField("text");
# Zilliz CLI
アクセスできないのに、なぜスパースベクトルフィールドを定義する必要があるのですか?
スパースベクトルフィールドは、ユーザーが直接操作しないデータベースのインデックスと同様に、内部的な検索インデックスとして機能します。
設計の根拠:
-
関心の分離: テキスト (input/output), Milvus がベクトル(内部処理)を扱います
-
パフォーマンス: 事前に計算されたスパースベクトルにより、クエリ時の高速な BM25 ランキングが可能になります
-
ユーザーエクスペリエンス: 複雑なベクトル操作をシンプルなテキストインターフェースの背後に抽象化します
ベクトルにアクセスする必要がある場合:
-
フルテキスト検索の代わりに、手動のスパースベクトル操作を使用します
-
カスタムのスパースベクトルワークフロー用に別のコレクションを作成します
詳細については、スパースベクトル を参照してください。