Function の概要
Zilliz Cloud は、semantic search、lexical search、hybrid search、intelligent reranking を含む、モダンな検索システムを構築するための統合検索アーキテクチャを提供します。これらの機能を個別の機能として公開するのではなく、Zilliz Cloud はそれらを単一の中核抽象である Function を中心に構成しています。
Function とは何ですか?
Zilliz Cloud において、Function は、検索ワークフローの定義された段階で特定の操作を適用する、設定可能な実行ユニットです。
Function は、実務上の次の 3 つの問いに答えます。
-
この操作はいつ実行されますか? 検索前または検索後。
-
どの入力に対して動作しますか? 生テキスト、ベクトル表現、または取得された候補結果。
-
どのような出力を生成しますか? 検索に使用されるベクトル埋め込み、またはユーザーに返される並べ替え済み結果。
ワークフローの観点から見ると、Functions は 2 つの異なる段階で検索に参加します。
-
検索前: Functions は検索前に実行され、テキストをベクトル表現に変換します。これらのベクトルが、どの候補が取得されるかを決定します。
-
検索後: Functions は候補取得後に実行され、候補セットを変更することなく結果の並び順を調整します。
次の図は、検索ワークフローにおいて Functions がどのように動作するかを抽象化して示しています。
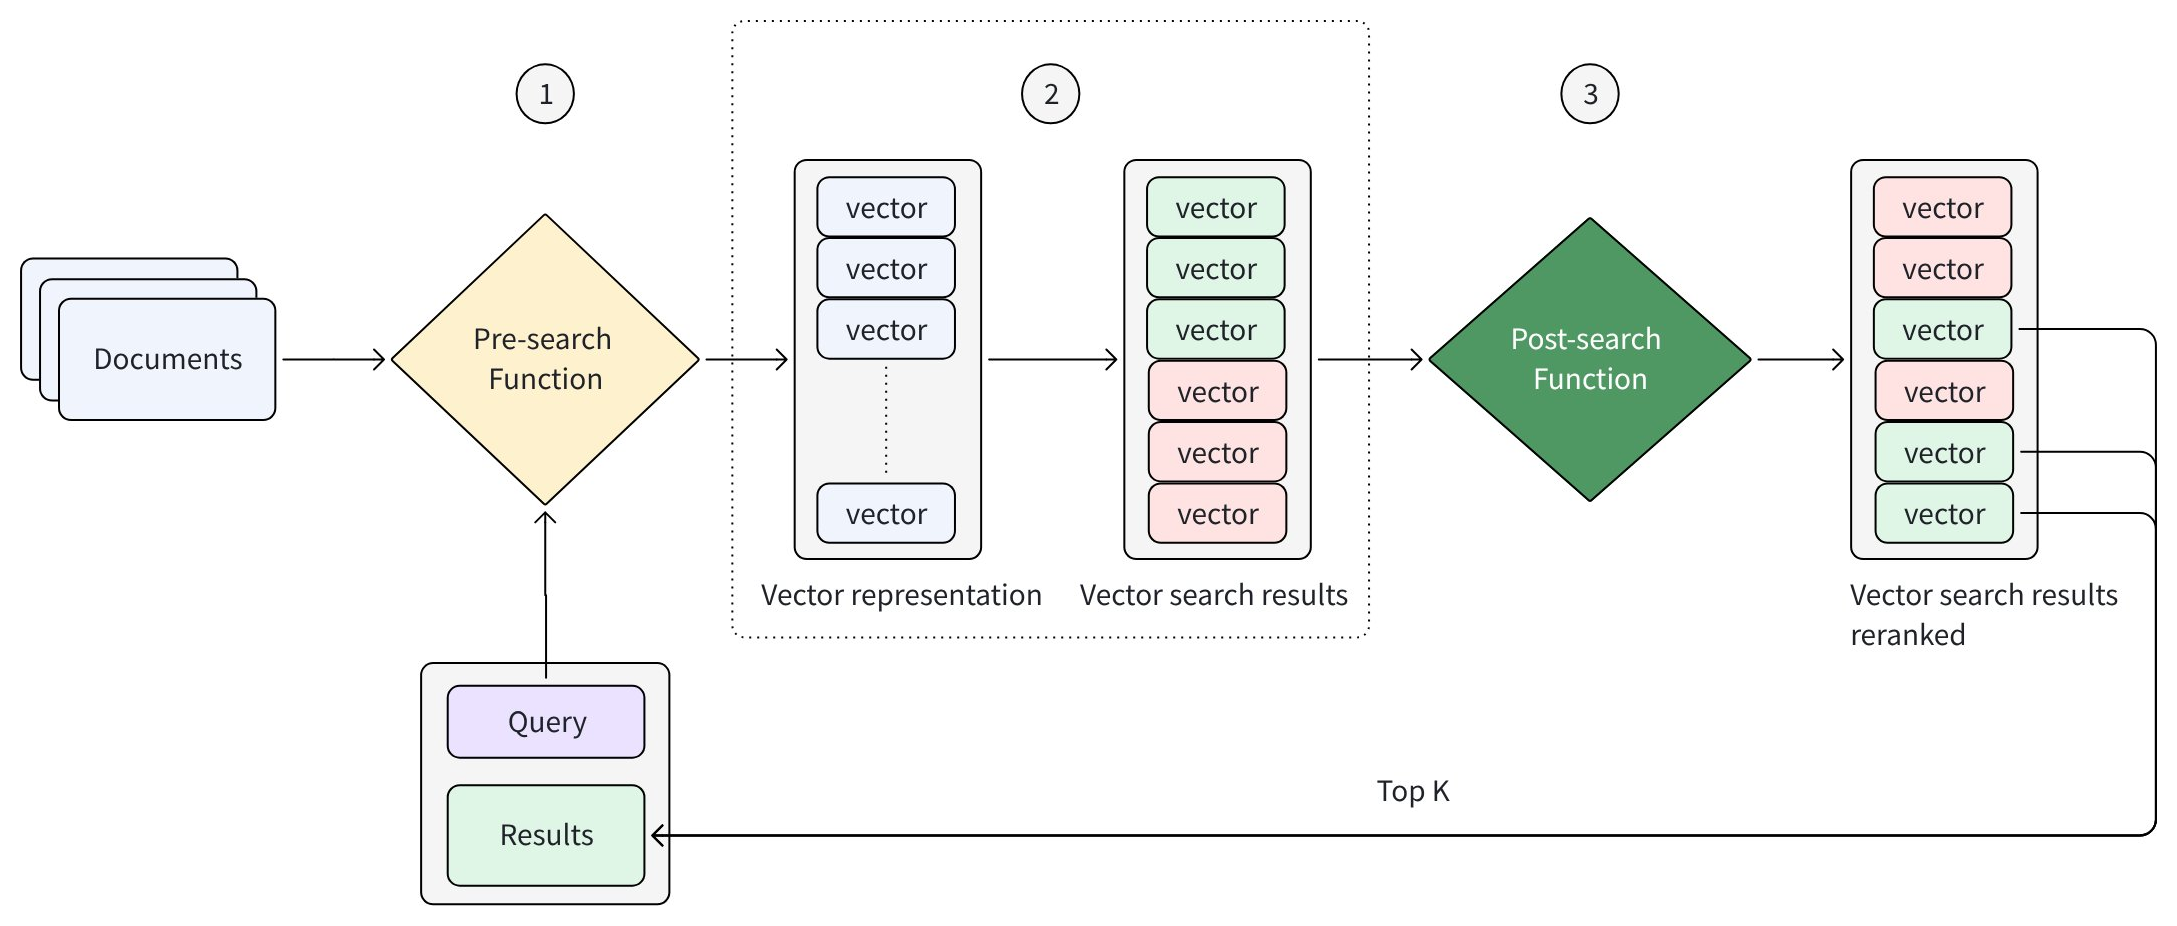
すべての検索リクエストは、同じ高レベルのフローに従います。
-
Pre-search Function が入力テキストからベクトル表現を生成する
-
検索エンジンがそれらのベクトルに基づいて候補結果を取得する
-
(任意)Post-search Function が取得された候補を再ランキングする
Function のカテゴリ
Zilliz Cloud の Functions は、検索ワークフロー内でいつ実行されるか と どのような役割を果たすか に基づいて分類されます。高レベルでは、Functions は次の 2 つのグループに分かれます。
-
Pre-search Functions: テキストをベクトル埋め込みに変換し、候補取得を決定するもの
-
Post-search Functions: 取得された候補の並び順を調整するもの
Pre-search Functions: テキストをベクトル埋め込みに変換する
Pre-search Functions は候補取得の前に実行されます。その役割は、生テキスト(保存されたドキュメントと受信したクエリの両方)を、検索エンジンが関連候補を特定するために使用するベクトル表現に変換することです。
異なる Pre-search Functions は異なる種類の埋め込みを生成し、それが検索の実行方法に直接影響します。
以下の表は、利用可能な Pre-search Functions をまとめたものです。
| Function Type | ベクトルの種類 | 説明 | 代表的なシナリオ |
|---|---|---|---|
| BM25 Function | Sparse embeddings | 用語一致、用語頻度、およびドキュメント長の正規化に基づいて語彙的関連性を計算します。 ローカルな仕組みとしてデータベースエンジン内で完全に実行されます。model inference は不要です。 | キーワード主導の全文検索、ドキュメント検索やコード検索、ならびに用語一致、低レイテンシー、決定論的な動作が重要なワークロード。 |
| Model-based Embedding Functions | Dense embeddings | 機械学習モデルを使用してテキストの意味内容をエンコードし、完全一致のキーワードを超えた類似性ベースの検索を可能にします。 ホスト型モデルまたはサードパーティのモデルサービスを介した model inference が必要です。 | Semantic search、自然言語クエリ、Q&A や RAG パイプライン、ならびに文字どおりの用語の重なりよりも概念的類似性が重要なユースケース。 |
すべての Pre-search Functions は、ドキュメントデータとクエリテキストの両方に一貫して適用されるため、同じ表現空間内で検索が実行されます。
Post-search Functions: 候補結果を再ランキングする
Post-search Functions は、候補取得後 に適用されます。その目的は、候補セットに項目を追加または削除することなく、取得された候補のランキングを調整すること です。
これらの Functions は検索段階で返された結果に対してのみ動作し、結果品質を向上させるために追加のランキングロジックまたは関連性シグナルを適用します。これらは、インデックス作成、検索、フィルタリングの動作には影響せず、最終的な結果の並び順にのみ影響します。
以下の表は、利用可能な Post-search Functions をまとめたものです。
| Function Type | Operates On | 説明 | 代表的なシナリオ |
|---|---|---|---|
| Hybrid Search Rankers | hybrid search から取得された複数の結果セット | weighted ranking や reciprocal rank fusion(RRF)などの手法を使用して、異なる検索戦略から取得された結果を結合し、再バランスします。 | Semantic 検索と lexical 検索を組み合わせ、バランスの取れた結果の統合を必要とする hybrid search シナリオ。 |
| Rule-based Rankers | 単一ベクトルまたは hybrid search からの候補結果 | boosting や decay-based スコアリングなどの、事前定義されたルールまたは数値シグナルに基づいてランキングを調整します。 | ビジネス主導のランキングロジック、鮮度や人気度のブースト、および予測可能で非 ML の再ランキングが必要なシナリオ。 |
| Model-based Rankers | 単一ベクトルまたは hybrid search からの候補結果 | 機械学習モデルを使用して関連性を評価し、学習済みまたは意味的シグナルに基づいて結果を並べ替えます。 | Intelligent reranking、意味理解を用いた関連性の洗練、ならびに LLM ベースの関連性評価。 |
Post-search Functions は取得済みの候補に対してのみ動作するため、これらは結果の順序には影響しても、検索範囲には影響しない調整ステップです。