Grouping Search
Grouping Search を使用すると、Zilliz Cloud は検索結果を指定されたフィールドの値ごとにグループ化し、より高いレベルでデータを集約できます。たとえば、基本的な ANN 検索を使用して手元の本に似た本を見つけることはできますが、Grouping Search を使用すると、その本で議論されているトピックに関連する可能性のある本のカテゴリを見つけることができます。このトピックでは、主な考慮事項とあわせて Grouping Search の使用方法について説明します。
概要
検索結果内のエンティティがスカラーフィールドで同じ値を共有している場合、それらが特定の属性において類似していることを示しており、検索結果に悪影響を与える可能性があります。
あるコレクションに複数のドキュメント(docId で示す)が保存されているとします。ドキュメントをベクトルに変換する際にできるだけ多くの意味情報を保持するため、各ドキュメントはより小さく扱いやすい段落(または chunks)に分割され、個別のエンティティとして保存されます。ドキュメントがより小さなセクションに分割されていても、ユーザーは多くの場合、どのドキュメントが自分のニーズに最も関連しているかを特定したいと考えています。
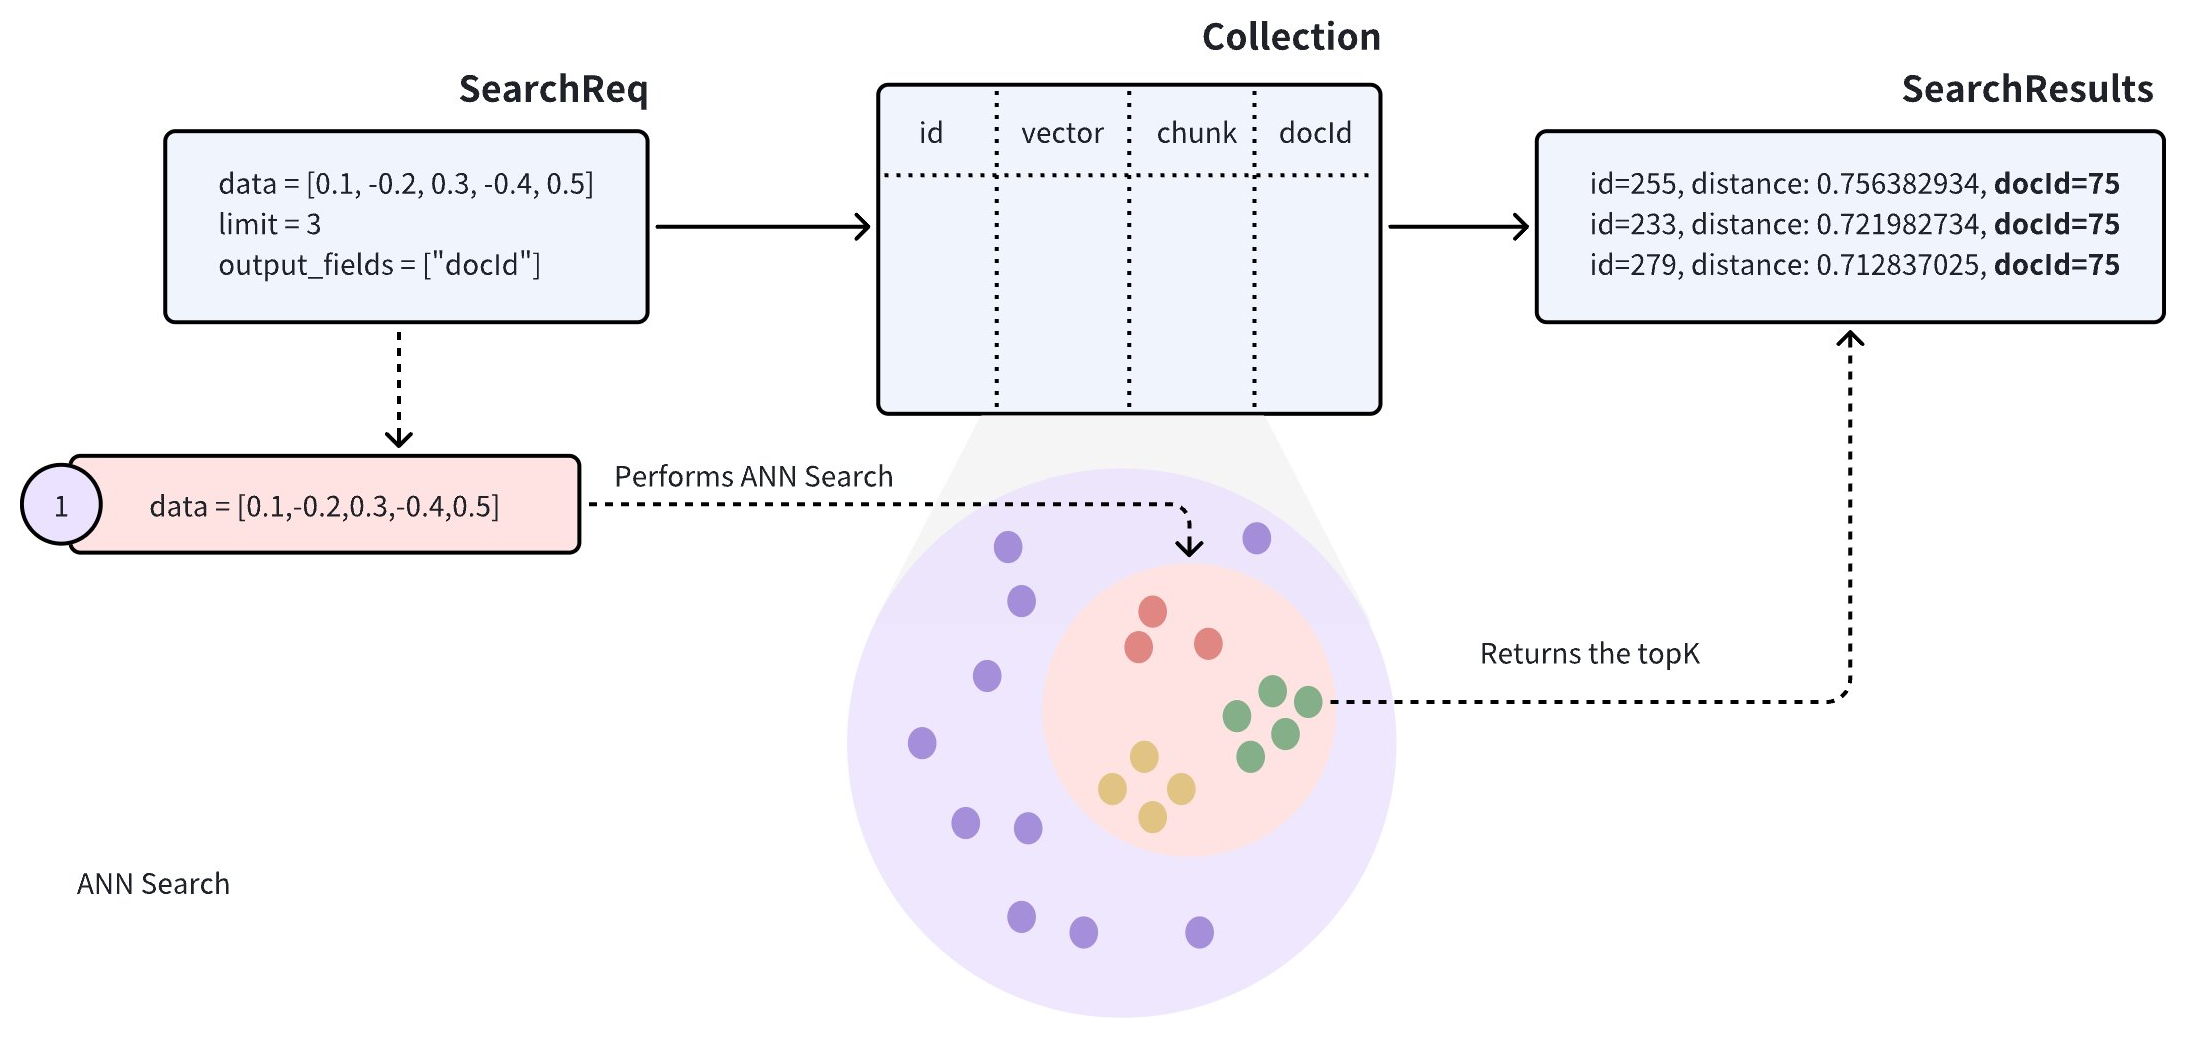
このようなコレクションに対して近似最近傍(ANN)検索を実行すると、検索結果に同じドキュメントの複数の段落が含まれることがあり、その結果、他のドキュメントが見落とされる可能性があり、意図したユースケースに沿わないことがあります。
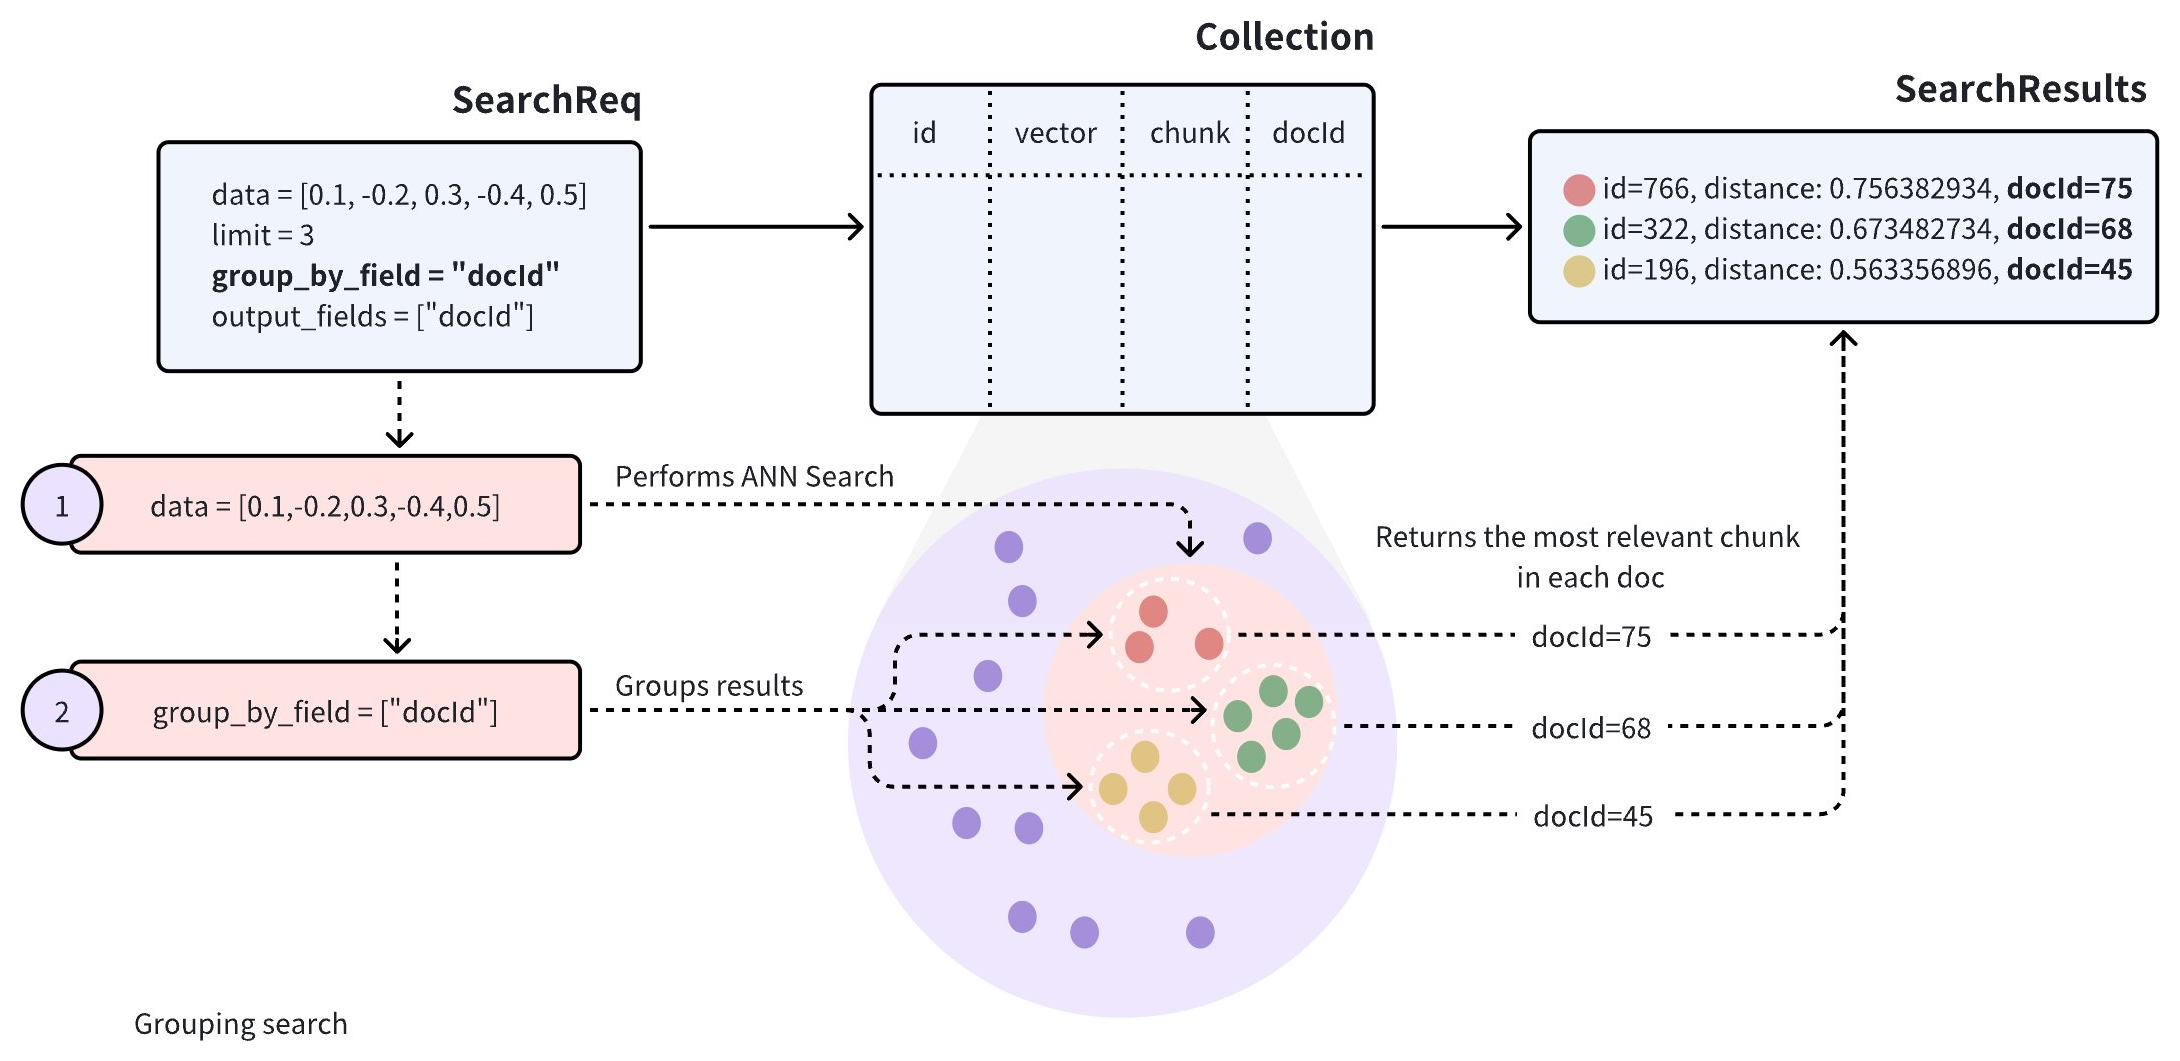
検索結果の多様性を向上させるには、検索リクエストに group_by_field パラメーターを追加して Grouping Search を有効にできます。図に示すように、group_by_field を docId に設定できます。このリクエストを受信すると、Zilliz Cloud は次の処理を行います。
-
指定されたクエリベクトルに基づいて ANN 検索を実行し、クエリに最も類似したすべてのエンティティを見つけます。
-
検索結果を、指定された
group_by_field(たとえばdocId)でグループ化します。 -
limitパラメーターで定義された各グループの上位結果を、各グループで最も類似したエンティティとともに返します。
デフォルトでは、Grouping Search は各グループにつき 1 つのエンティティのみを返します。グループごとに返す結果の数を増やしたい場合は、group_size と strict_group_size パラメーターで制御できます。
Grouping Search を実行する
このセクションでは、Grouping Search の使用方法を示すサンプルコードを提供します。次の例では、コレクションに id、vector、chunk、docId の各フィールドが含まれていることを前提としています。
[
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
検索リクエストでは、group_by_field と output_fields の両方を docId に設定します。Zilliz Cloud は結果を指定されたフィールドでグループ化し、各グループで最も類似したエンティティを、返される各エンティティの docId の値を含めて返します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

query_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)

# Retrieve the values in the `docId` column
doc_ids = [result['entity']['docId'] for result in res[0]]
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(3)
        .groupByFieldName("docId")
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "YOUR_CLUSTER_ENDPOINT";
const token = "YOUR_CLUSTER_TOKEN";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 3,
    group_by_field: "docId"
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 3,
    "groupingField": "docId",
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

std::vector<float> query_vector = {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(3)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .AddOutputField("docId");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.
zilliz vector search \
  --collection my_collection \
  --body '{
  "data": [
    [
      0.14529211512077012,
      0.9147257273453546,
      0.7965055218724449,
      0.7009258593102812,
      0.5605206522382088
    ]
  ],
  "annsField": "vector",
  "limit": 3,
  "groupingField": "docId",
  "outputFields": [
    "docId"
  ]
}' \
  --output json
上記のリクエストでは、limit=3 は、システムが 3 つのグループから検索結果を返し、各グループにクエリベクトルに最も類似した 1 つのエンティティが含まれることを示します。
グループサイズを設定する
デフォルトでは、Grouping Search は各グループにつき 1 つのエンティティのみを返します。グループごとに複数の結果が必要な場合は、group_size と strict_group_size パラメーターを調整します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
- Zilliz CLI
# Group search results

res = client.search(
    collection_name="my_collection",
    data=query_vectors, # query vector
    limit=5, # number of groups to return
    group_by_field="docId", # grouping field
    group_size=2, # p to 2 entities to return from each group
    strict_group_size=True, # return exact 2 entities from each group
    output_fields=["docId"]
)
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .groupByFieldName("docId")
        .groupSize(2)
        .strictGroupSize(true)
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=5}, score=-0.49148706, id=8)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=2}, score=0.38515577, id=2)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
// SearchResp.SearchResult(entity={docId=3}, score=0.19556211, id=4)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithStrictGroupSize(true).
    WithGroupSize(2).
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "YOUR_CLUSTER_ENDPOINT";
const token = "YOUR_CLUSTER_TOKEN";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    group_by_field: "docId",
    group_size: 2,
    strict_group_size: true
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "groupingField": "docId",
    "groupSize":2,
    "strictGroupSize":true,
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

std::vector<float> query_vector = {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .WithGroupSize(2)
                   .WithStrictGroupSize(true)
                   .AddOutputField("docId");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.
zilliz vector search \
  --collection my_collection \
  --body '{
  "data": [
    [
      0.14529211512077012,
      0.9147257273453546,
      0.7965055218724449,
      0.7009258593102812,
      0.5605206522382088
    ]
  ],
  "annsField": "vector",
  "limit": 5,
  "groupingField": "docId",
  "outputFields": [
    "docId"
  ],
  "groupSize": 2,
  "strictGroupSize": true
}' \
  --output json
上記の例では:
-
group_size: グループごとに返すエンティティ数を指定します。たとえば、group_size=2に設定すると、各グループ(または各docId)は理想的には最も類似した 2 つの段落(または chunks)を返す必要があります。group_sizeが設定されていない場合、システムはデフォルトでグループごとに 1 件の結果を返します。 -
strict_group_size: このブール値のパラメーターは、システムがgroup_sizeで設定された件数を厳密に適用するかどうかを制御します。strict_group_size=Trueの場合、システムは、そのグループに十分なデータがない場合を除き、各グループにgroup_sizeで指定された正確な数のエンティティ(たとえば 2 つの段落)を含めようとします。デフォルト(strict_group_size=False)では、システムは各グループにgroup_size個のエンティティが含まれることを保証するよりも、limitパラメーターで指定されたグループ数を満たすことを優先します。このアプローチは、データ分布が不均一な場合に一般的により効率的です。
追加のパラメーターの詳細については、search を参照してください。
スカラーフィールドでグループを並べ替える | ONDEMAND
Grouping Search を order_by_fields と組み合わせることで、スカラーフィールドによってグループを並べ替えることができます。これは、グループ間で多様な結果を得たい一方で、価格や評価のようなビジネス上重要な順序に従ってグループを並べ替えたい場合に役立ちます。
次の例では、検索結果を category でグループ化し、各グループにつき最大 3 つのエンティティを返し、返されたグループを price の低い順に並べ替えます。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
- Zilliz CLI
res = client.search(
    collection_name="product_catalog",
    data=query_vectors,
    anns_field="embedding",
    limit=20,
    group_by_field="category",
    group_size=3,
    strict_group_size=True,
    output_fields=["category", "price", "rating"],
    order_by_fields=[
        {"field": "price", "order": "asc"}
    ],
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.OrderByField;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.List;

// Prerequisite: client is connected to the project endpoint;
// clusterId identifies the on-demand cluster containing product_catalog.
var session = client.session(clusterId);
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq request = SearchReq.builder()
    .collectionName("product_catalog")
    .data(List.of(queryVector))
    .annsField("embedding")
    .topK(20)
    .groupByFieldName("category")
    .groupSize(3)
    .strictGroupSize(true)
    .outputFields(List.of("category", "price", "rating"))
    .orderByFields(List.of(OrderByField.builder()
        .fieldName("price").direction(AggDirection.ASC).build()))
    .build();
SearchResp response = session.search(request);
System.out.println(response.getSearchResults());
// Prerequisite: client is connected to the project endpoint;
// clusterId identifies the on-demand cluster containing product_catalog.
const session = client.session(clusterId);
const queryVector = [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088];
const response = await session.search({
  collection_name: "product_catalog",
  data: [queryVector],
  anns_field: "embedding",
  limit: 20,
  group_by_field: "category",
  group_size: 3,
  strict_group_size: true,
  output_fields: ["category", "price", "rating"],
  order_by_fields: [{ field: "price", order: "asc" }],
});
console.log(response.results);
import (
    "fmt"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Prerequisite: client is connected to the project endpoint;
// clusterID identifies the on-demand cluster containing product_catalog.
queryVector := []float32{0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088}
results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "product_catalog", 20, []entity.Vector{entity.FloatVector(queryVector)},
).
    WithANNSField("embedding").
    WithGroupByField("category").
    WithGroupSize(3).
    WithStrictGroupSize(true).
    WithOutputFields("category", "price", "rating").
    WithSearchParam("order_by_fields", "price:asc").
    WithSearchParam("cluster_id", clusterID))
if err != nil {
    panic(err)
}
for _, result := range results {
    fmt.Println(result.IDs, result.Scores)
    fmt.Println(result.GetColumn("category"), result.GetColumn("price"), result.GetColumn("rating"))
}
# Prerequisite: set PROJECT_ENDPOINT, TOKEN, and CLUSTER_ID for your on-demand cluster.
curl --request POST \
  --url "${PROJECT_ENDPOINT}/v2/vectordb/entities/search?cluster_id=${CLUSTER_ID}" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_catalog",
    "data": [[0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]],
    "annsField": "embedding",
    "limit": 20,
    "groupingField": "category",
    "groupSize": 3,
    "strictGroupSize": true,
    "outputFields": ["category", "price", "rating"],
    "orderByFields": ["price:asc"]
  }'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>

// Prerequisite: client is connected to the project endpoint;
// cluster_id identifies the on-demand cluster containing product_catalog.
milvus::MilvusClientV2SessionPtr session;
auto status = client->Session(cluster_id, session);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
std::vector<float> query_vector = {0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f};
auto request = milvus::SearchRequest()
    .WithCollectionName("product_catalog")
    .AddFloatVector(query_vector)
    .WithAnnsField("embedding")
    .WithLimit(20)
    .WithGroupByField("category")
    .WithGroupSize(3)
    .WithStrictGroupSize(true)
    .AddOutputField("category")
    .AddOutputField("price")
    .AddOutputField("rating")
    .AddOrderByField(milvus::OrderByField("price", milvus::AggregationDirection::ASC));
milvus::SearchResponse response;
status = session->Search(request, response);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
for (const auto& result : response.Results().Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
    std::cout << rows << std::endl;
}
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.
# Select an on-demand cluster containing product_catalog.
zilliz vector search \
  --collection product_catalog \
  --body '{
  "data": [
    [
      0.14529211512077012,
      0.9147257273453546,
      0.7965055218724449,
      0.7009258593102812,
      0.5605206522382088
    ]
  ],
  "annsField": "embedding",
  "limit": 20,
  "groupingField": "category",
  "groupSize": 3,
  "strictGroupSize": true,
  "outputFields": [
    "category",
    "price",
    "rating"
  ],
  "orderByFields": [
    "price:asc"
  ]
}' \
  --output json
上記のリクエストでは、limit=20 は、Zilliz Cloud が最大 20 個のグループを選択することを意味し、20 個のエンティティを選択することを意味するものではありません。group_size=3 であるため、フラットな結果リストには合計で最大 60 個のエンティティを含めることができます。
group_by_field とあわせて order_by_fields を使用すると、Zilliz Cloud は各グループの先頭エンティティの指定されたスカラーフィールド値に基づいてグループを並べ替えます。各グループ内では、エンティティはクエリベクトルに対する類似度スコアの順に保たれます。
考慮事項
-
グループ数:
limitパラメーターは、各グループ内の具体的なエンティティ数ではなく、検索結果が返されるグループ数を制御します。適切なlimitを設定すると、検索の多様性とクエリのパフォーマンスを制御しやすくなります。データが密に分布している場合やパフォーマンスが懸念される場合は、limitを減らすことで計算コストを削減できます。 -
グループあたりのエンティティ数:
group_sizeパラメーターは、グループごとに返されるエンティティ数を制御します。ユースケースに応じてgroup_sizeを調整すると、検索結果の豊富さを高めることができます。ただし、データが不均一に分布している場合、特にデータが限られているシナリオでは、一部のグループがgroup_sizeで指定された数よりも少ないエンティティしか返さないことがあります。 -
厳密なグループサイズ:
strict_group_size=Trueの場合、システムは、そのグループに十分なデータがない場合を除き、各グループに対して指定された数のエンティティ(group_size)を返そうとします。この設定により、グループごとのエンティティ数を一定に保つことができますが、データ分布が不均一な場合やリソースが限られている場合はパフォーマンスが低下する可能性があります。厳密なエンティティ数が必要ない場合は、strict_group_size=Falseに設定するとクエリ速度を向上させることができます。 -
クエリベクトルが対象のコレクションにすでに存在する場合は、検索前にそれらを取得する代わりに
idsを使用することを検討してください。詳細については、Primary-Key Search を参照してください。