Hugging Face
Hugging Face の埋め込みモデルを使用するには、通常、アプリケーション側で認証情報を管理し、モデルを個別に呼び出し、挿入データと検索クエリに対して一貫した埋め込みを生成する必要があります。Hugging Face モデルプロバイダーの統合とテキスト埋め込み関数を使用すると、Zilliz Cloud は挿入時と検索時に生のテキストをベクトルに変換します。
仕組み
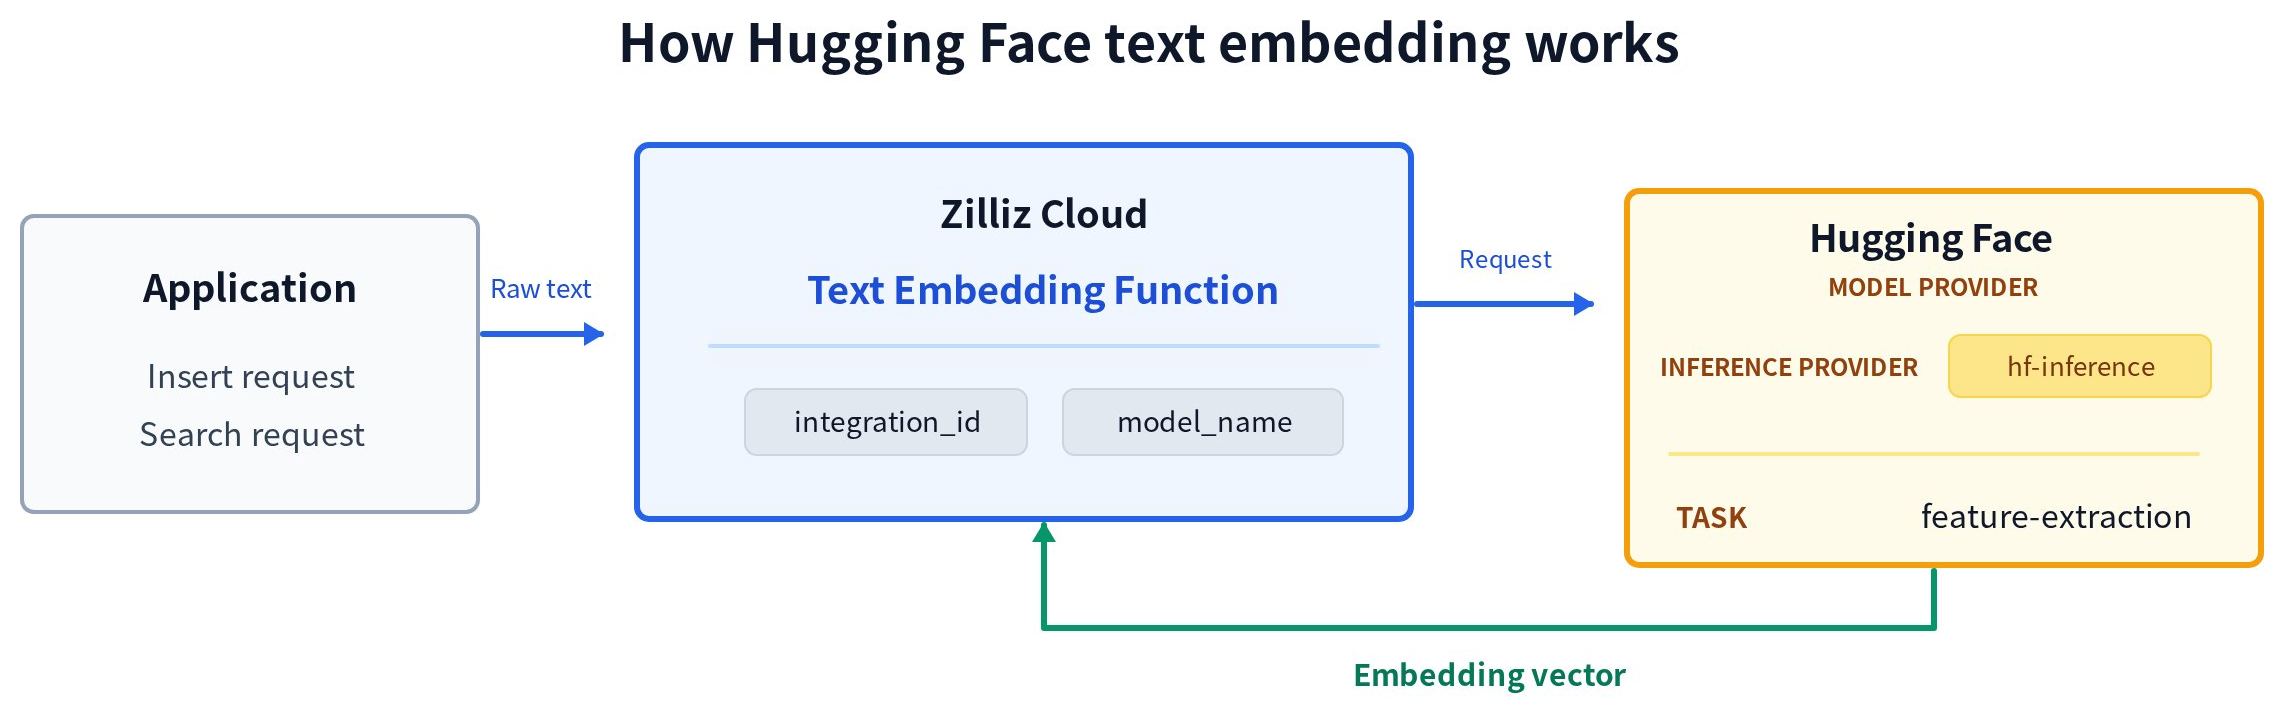
ワークフローは 3 つのステップで構成されます。
-
生のテキストを送信します。 アプリケーションは、挿入または検索リクエストで生のテキストを提供します。
-
埋め込みを生成します。 テキスト埋め込み関数は、
integration_idを使用して Hugging Face モデルプロバイダーの統合を参照し、model_nameを使用してモデルを選択します。Zilliz Cloud は、Feature Extraction タスクのためにhf-inferenceを通じてテキストを Hugging Face に送信します。 -
埋め込みを使用します。 Hugging Face は浮動小数点の埋め込みベクトルを返します。挿入時、Zilliz Cloud はベクトルを関数の出力フィールドに格納します。検索時、Zilliz Cloud はベクトルをクエリベクトルとして使用します。
挿入と検索には同じ関数構成が使用されるため、両方の操作でモデルと推論パラメーターが一貫した状態に保たれます。
モデルの互換性
Hugging Face モデルをテキスト埋め込み関数で使用するには、そのモデルに Feature Extraction 機能があり、構成された hf-inference 統合を通じて埋め込みを正常に返す必要があります。関数の出力フィールドは、dim がモデルの埋め込み次元と一致する FLOAT_VECTOR フィールドである必要があります。
次のモデルは、記載された日付に Zilliz Cloud との互換性テストに合格しました。
| モデル | 機能 | 次元 | 最終テスト日 |
|---|---|---|---|
BAAI/bge-m3 | Feature Extraction | 1024 | 2026-07-27 |
BAAI/bge-large-zh-v1.5 | Feature Extraction | 1024 | 2026-07-27 |
BAAI/bge-large-en-v1.5 | Feature Extraction | 1024 | 2026-07-27 |
BAAI/bge-small-en-v1.5 | Feature Extraction | 384 | 2026-07-27 |
dragonkue/snowflake-arctic-embed-l-v2.0-ko | Feature Extraction | 1024 | 2026-07-27 |
upskyy/bge-m3-korean | Feature Extraction | 1024 | 2026-07-27 |
この表は互換性のあるモデルの完全なリストではありません。記載されていないモデルでも、統合と互換性がある場合があります。
互換性の結果は、記載された日付のテストを反映しています。Zilliz Cloud は、モデルが引き続き hf-inference 経由で利用可能であるか、安定性、レイテンシ、出力品質に関する要件を満たしているかを管理するものではありません。Zilliz Cloud は、過去の結果を定期的に再テストすることを約束するものではありません。実稼働環境で使用する前に、Hugging Face で選択したモデルを確認し、ワークロードに適しているか評価してください。
事前準備
Hugging Face のテキスト埋め込みを使用する前に、以下を確認してください。
-
Hugging Face モデルプロバイダーの統合を作成し、統合 ID をコピーして、Provider を
hf-inferenceに設定すること。手順の詳細は Integrate with Model Providers に記載されていること。 -
モデルの Hugging Face ページを開き、Inference Providers セクションを確認して、
hf-inferenceが現在feature-extractionタスク用にそのモデルを提供していることを検証すること。 -
カスタム出力次元はサポートされていないため、モデルの出力次元を確認し、関数の出力フィールドが
dimとモデル出力が一致するFLOAT_VECTORフィールドであることを検証すること。
この例では BAAI/bge-small-en-v1.5 を使用しています。このモデルは執筆時点で hf-inference を通じて 384 次元の埋め込みを生成します。このモデルは構成を説明するためだけに使用されており、Zilliz Cloud による推奨または認定を示すものではありません。
Hugging Face のテキスト埋め込みを使用する
ステップ 1: テキスト埋め込み関数を使用してコレクションを作成する
スキーマフィールドを定義する
以下を含むコレクションスキーマを作成します。
-
各エンティティを一意に識別するプライマリフィールド。
-
生のテキストを格納する
VARCHARフィールド。 -
選択したモデルの出力次元と一致する次元を持つ
FLOAT_VECTORフィールド。
次の例では BAAI/bge-small-en-v1.5 を使用しています。このモデルは 384 次元のベクトルを生成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import DataType, Function, FunctionType, MilvusClient

client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN",
)

schema = client.create_schema()

schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)

schema.add_field(
    field_name="document",
    datatype=DataType.VARCHAR,
    max_length=9000
,
)

# The vector dimension must match the model's output dimension.
schema.add_field(
    field_name="dense",
    datatype=DataType.FLOAT_VECTOR,
    dim=384,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

String CLUSTER_ENDPOINT = "YOUR_CLUSTER_ENDPOINT";
String TOKEN = "YOUR_CLUSTER_TOKEN";

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri(CLUSTER_ENDPOINT)
        .token(TOKEN)
        .build();

MilvusClientV2 client = new MilvusClientV2(connectConfig);

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("document")
        .dataType(DataType.VarChar)
        .maxLength(9000)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense")
        .dataType(DataType.FloatVector)
        .dimension(384)
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

schema := entity.NewSchema().
    WithField(entity.NewField().WithName("id").WithDataType(entity.FieldTypeInt64).WithIsPrimaryKey(true).WithIsAutoID(false)).
    WithField(entity.NewField().WithName("document").WithDataType(entity.FieldTypeVarChar).WithMaxLength(9000)).
    WithField(entity.NewField().WithName("dense").WithDataType(entity.FieldTypeFloatVector).WithDim(384))
use milvus::v2::prelude::*;

let schema = CollectionSchema::new()
    .add_field(FieldSchema::new().name("id").data_type(DataType::Int64).primary_key(true).auto_id(false))
    .add_field(FieldSchema::new().name("document").data_type(DataType::VarChar).max_length(9000))
    .add_field(FieldSchema::new().name("dense").data_type(DataType::FloatVector).dimension(384));
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("document", milvus::DataType::VARCHAR).WithMaxLength(9000));
schema->AddField(milvus::FieldSchema("dense", milvus::DataType::FLOAT_VECTOR).WithDimension(384));
import { MilvusClient, DataType } from '@zilliz/milvus2-sdk-node';

const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN',
});

const schema = {
  fields: [
    { name: 'id', data_type: DataType.Int64, is_primary_key: true, autoID: false },
    { name: 'document', data_type: DataType.VarChar, max_length: 9000 },
    { name: 'dense', data_type: DataType.FloatVector, dim: 384 },
  ],
};
# Define the collection schema
SCHEMA='{
  "fields": [
    { "fieldName": "id", "dataType": "Int64", "isPrimary": true },
    { "fieldName": "document", "dataType": "VarChar", "elementTypeParams": { "max_length": "9000" } },
    { "fieldName": "dense", "dataType": "FloatVector", "elementTypeParams": { "dim": "384" } }
  ]
}'
テキスト埋め込み関数を定義する
document フィールドの値を埋め込みに変換し、dense フィールドに書き込む TEXTEMBEDDING Function を定義します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
text_embedding_function = Function(
    name="hugging_face_embedding",
    input_field_names=["document"],
    output_field_names=["dense"],
    function_type=FunctionType.TEXTEMBEDDING,
    params={
        "provider": "huggingface",
        "model_name": "BAAI/bge-small-en-v1.5",
        "integration_id": "YOUR_INTEGRATION_ID",
        "normalize": "true",
        "truncate": "true",
    },
)

schema.add_function(text_embedding_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;
import java.util.Collections;

Function function = Function.builder()
        .functionType(FunctionType.TEXTEMBEDDING)
        .name("hugging_face_embedding")
        .inputFieldNames(Collections.singletonList("document"))
        .outputFieldNames(Collections.singletonList("dense"))
        .param("provider", "huggingface")
        .param("model_name", "BAAI/bge-small-en-v1.5")
        .param("integration_id", "YOUR_INTEGRATION_ID")
        .param("normalize", "true")
        .param("truncate", "true")
        .build();
schema.addFunction(function);
import "github.com/milvus-io/milvus/client/v3/entity"

function := entity.NewFunction().
    WithName("hugging_face_embedding").
    WithType(entity.FunctionTypeTextEmbedding).
    WithInputFields("document").
    WithOutputFields("dense").
    WithParam("provider", "huggingface").
    WithParam("model_name", "BAAI/bge-small-en-v1.5").
    WithParam("integration_id", "YOUR_INTEGRATION_ID").
    WithParam("normalize", "true").
    WithParam("truncate", "true")

schema.WithFunction(function)
use milvus::v2::prelude::*;
use std::collections::HashMap;

let function = Function::new()
    .name("hugging_face_embedding")
    .function_type(FunctionType::TextEmbedding)
    .input_fields(["document"])
    .output_fields(["dense"])
    .params(HashMap::from([
        ("provider".into(), "huggingface".into()),
        ("model_name".into(), "BAAI/bge-small-en-v1.5".into()),
        ("integration_id".into(), "YOUR_INTEGRATION_ID".into()),
        ("normalize".into(), "true".into()),
        ("truncate".into(), "true".into()),
    ]));

schema.add_function(function);
milvus::FunctionPtr function = std::make_shared<milvus::Function>("hugging_face_embedding", milvus::FunctionType::TEXTEMBEDDING);
function->AddInputFieldName("document");
function->AddOutputFieldName("dense");
function->AddParam("provider", "huggingface");
function->AddParam("model_name", "BAAI/bge-small-en-v1.5");
function->AddParam("integration_id", "YOUR_INTEGRATION_ID");
function->AddParam("normalize", "true");
function->AddParam("truncate", "true");
schema->AddFunction(function);
const hfFunc = {
  name: 'hugging_face_embedding',
  type: 'TextEmbedding',
  input_field_names: ['document'],
  output_field_names: ['dense'],
  params: {
    provider: 'huggingface',
    model_name: 'BAAI/bge-small-en-v1.5',
    integration_id: 'YOUR_INTEGRATION_ID',
    normalize: 'true',
    truncate: 'true',
  },
};
# Define the text embedding function
FUNCTION='{
  "name": "hugging_face_embedding",
  "type": "TextEmbedding",
  "inputFieldNames": ["document"],
  "outputFieldNames": ["dense"],
  "params": {
    "provider": "huggingface",
    "model_name": "BAAI/bge-small-en-v1.5",
    "integration_id": "YOUR_INTEGRATION_ID",
    "normalize": "true",
    "truncate": "true"
  }
}'
次の表は、params でサポートされるすべてのエントリを説明しています。Hugging Face のリクエストオプションは Feature Extraction API specification に従います。provider、model_name、integration_id、および max_client_batch_size は Zilliz Cloud 統合を構成します。
| パラメーター | 必須 | 説明 |
|---|---|---|
provider | はい | Zilliz Cloud のモデルプロバイダーです。この値には huggingface を設定します。 |
model_name | はい | 現在 feature-extraction タスク用に hf-inference 経由で提供されているモデルの Hugging Face Model ID です。 |
integration_id | はい | Hugging Face モデルプロバイダー統合の ID です。手順の詳細は Integrate with Model Providers を参照してください。 |
normalize | いいえ | 正規化された埋め込みをリクエストするかどうかです。省略した場合、Zilliz Cloud は Hugging Face リクエストでこのオプションを設定しません。動作は選択したモデルに従います。 |
prompt_name | いいえ | 選択したモデルの Sentence Transformers 構成で定義されているプロンプトの名前です。Hugging Face はエンコード前に該当するプロンプトテキストを先頭に追加します。省略した場合、プロンプトはリクエストされません。 |
truncate | いいえ | 入力がモデルのサポートする長さを超えた場合に切り捨てをリクエストするかどうかです。省略した場合、Zilliz Cloud は Hugging Face リクエストでこのオプションを設定しません。動作は選択したモデルに従います。 |
truncation_direction | いいえ | Hugging Face が入力を切り捨てる方向です。サポートされる値は left と right です。 |
max_client_batch_size | いいえ | 1 回のリクエストで Hugging Face に送信する入力テキストの最大数です。デフォルト値は 128 です。値は 0 より大きい必要があります。 |
インデックスを構成する
出力ベクトルフィールドのインデックスを構成します。次の例では AUTOINDEX とコサイン類似度を使用します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE",
)
import io.milvus.v2.common.IndexParam;
import java.util.ArrayList;
import java.util.List;

List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("dense")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

indexOption := milvusclient.NewCreateIndexOption("hugging_face_demo", "dense", index.NewAutoIndex(entity.COSINE))
use milvus::v2::prelude::*;

let index_params = vec![
    IndexParam::new()
        .field_name("dense")
        .index_type(IndexType::AutoIndex)
        .metric_type(MetricType::Cosine),
];
#include <vector>
#include "milvus/MilvusClientV2.h"

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("dense", "", milvus::IndexType::AUTOINDEX, milvus::MetricType::COSINE)
};
const indexParams = {
  field_name: 'dense',
  index_type: 'AUTOINDEX',
  metric_type: 'COSINE',
};
# Define the index parameters
indexParams='{
  "fieldName": "dense",
  "indexName": "dense_index",
  "indexType": "AUTOINDEX",
  "metricType": "COSINE"
}'
コレクションを作成する
スキーマとインデックスパラメーターを指定してコレクションを作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
client.create_collection(
    collection_name="hugging_face_demo",
    schema=schema,
    index_params=index_params,
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("hugging_face_demo")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import (
    "log"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

err = client.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("hugging_face_demo", schema).WithIndexOptions(indexOption))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("hugging_face_demo")
            .schema(schema)
            .index_params(index_params)
            .build()?,
    )
    .await?;
#include <iostream>
#include <utility>
#include "milvus/MilvusClientV2.h"

auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                    .WithCollectionName("hugging_face_demo")
                                    .WithIndexes(std::move(indexes))
                                    .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createCollection({
  collection_name: 'hugging_face_demo',
  fields: schema.fields,
  functions: [hfFunc],
});

// Create the index on the dense vector field
await client.createIndex({
  collection_name: 'hugging_face_demo',
  ...indexParams,
});
curl --request POST \
  --url "YOUR_CLUSTER_ENDPOINT/v2/vectordb/collections/create" \
  --header "Authorization: Bearer YOUR_CLUSTER_TOKEN" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "hugging_face_demo",
    "schema": {
      "fields": [
        { "fieldName": "id", "dataType": "Int64", "isPrimary": true },
        { "fieldName": "document", "dataType": "VarChar", "elementTypeParams": { "max_length": "9000" } },
        { "fieldName": "dense", "dataType": "FloatVector", "elementTypeParams": { "dim": "384" } }
      ],
      "functions": [
        {
          "name": "hugging_face_embedding",
          "type": "TextEmbedding",
          "inputFieldNames": ["document"],
          "outputFieldNames": ["dense"],
          "params": {
            "provider": "huggingface",
            "model_name": "BAAI/bge-small-en-v1.5",
            "integration_id": "YOUR_INTEGRATION_ID",
            "normalize": "true",
            "truncate": "true"
          }
        }
      ]
    },
    "indexParams": [
      {
        "fieldName": "dense",
        "indexName": "dense_index",
        "indexType": "AUTOINDEX",
        "metricType": "COSINE"
      }
    ]
  }'
コレクションは、384 次元のベクトルを dense フィールドに書き込むテキスト埋め込み関数とともに作成されます。
ステップ 2: データを挿入する
ベクトルを指定せずに生のテキストを挿入します。Zilliz Cloud は Hugging Face モデルを呼び出し、生成された埋め込みを dense フィールドに書き込みます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
client.insert(
    collection_name="hugging_face_demo",
    data=[
        {
            "id": 1,
            "document": "Milvus simplifies semantic search through embeddings.",
        },
        {
            "id": 2,
            "document": "Vector embeddings convert text into searchable numeric data.",
        },
        {
            "id": 3,
            "document": "Semantic search helps users find relevant information quickly.",
        },
    ],
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import java.util.Arrays;
import java.util.List;

Gson gson = new Gson();
List<JsonObject> rows = Arrays.asList(
        gson.fromJson("{\"id\": 1, \"document\": \"Milvus simplifies semantic search through embeddings.\"}", JsonObject.class),
        gson.fromJson("{\"id\": 2, \"document\": \"Vector embeddings convert text into searchable numeric data.\"}", JsonObject.class),
        gson.fromJson("{\"id\": 3, \"document\": \"Semantic search helps users find relevant information quickly.\"}", JsonObject.class)
);

client.insert(InsertReq.builder()
        .collectionName("hugging_face_demo")
        .data(rows)
        .build());
import (
    "log"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

_, err = client.Insert(ctx, milvusclient.NewRowBasedInsertOption("hugging_face_demo",
    map[string]any{"id": int64(1), "document": "Milvus simplifies semantic search through embeddings."},
    map[string]any{"id": int64(2), "document": "Vector embeddings convert text into searchable numeric data."},
    map[string]any{"id": int64(3), "document": "Semantic search helps users find relevant information quickly."},
))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;
use serde_json::json;

let rows = vec![
    json!({"id": 1, "document": "Milvus simplifies semantic search through embeddings."}),
    json!({"id": 2, "document": "Vector embeddings convert text into searchable numeric data."}),
    json!({"id": 3, "document": "Semantic search helps users find relevant information quickly."}),
];

client
    .insert(
        InsertRequest::builder()
            .collection_name("hugging_face_demo")
            .rows(rows)
            .build()?,
    )
    .await?;
#include <iostream>
#include <utility>
#include "milvus/MilvusClientV2.h"

milvus::EntityRows data = {
    {{"id", 1}, {"document", "Milvus simplifies semantic search through embeddings."}},
    {{"id", 2}, {"document", "Vector embeddings convert text into searchable numeric data."}},
    {{"id", 3}, {"document", "Semantic search helps users find relevant information quickly."}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("hugging_face_demo")
                                .WithRowsData(std::move(data))
                                , response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.insert({
  collection_name: 'hugging_face_demo',
  fields_data: [
    { id: 1, document: 'Milvus simplifies semantic search through embeddings.' },
    { id: 2, document: 'Vector embeddings convert text into searchable numeric data.' },
    { id: 3, document: 'Semantic search helps users find relevant information quickly.' },
  ],
});
curl --request POST \
  --url "YOUR_CLUSTER_ENDPOINT/v2/vectordb/entities/insert" \
  --header "Authorization: Bearer YOUR_CLUSTER_TOKEN" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "hugging_face_demo",
    "data": [
      { "id": 1, "document": "Milvus simplifies semantic search through embeddings." },
      { "id": 2, "document": "Vector embeddings convert text into searchable numeric data." },
      { "id": 3, "document": "Semantic search helps users find relevant information quickly." }
    ]
  }'
挿入操作は生のテキストを格納し、各エンティティに対して 1 つの埋め込みを生成します。
ステップ 3: テキストで検索する
生のクエリテキストを使用して検索します。Zilliz Cloud は、同じ Function、モデル、およびオプションの推論パラメーターを使用して、ベクトル検索を実行する前にクエリテキストを埋め込みに変換します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
results = client.search(
    collection_name="hugging_face_demo",
    data=["How does Milvus handle semantic search?"],
    anns_field="dense",
    limit=3,
    output_fields=["document"],
)

print(results)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Collections;
import java.util.List;

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("hugging_face_demo")
        .data(Collections.singletonList(new EmbeddedText("How does Milvus handle semantic search?")))
        .annsField("dense")
        .limit(3)
        .outputFields(Collections.singletonList("document"))
        .build());
List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}
import (
    "fmt"
    "log"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

searchResults, err := client.Search(ctx, milvusclient.NewSearchOption(
    "hugging_face_demo",
    3,
    []entity.Vector{entity.Text("How does Milvus handle semantic search?")},
).
    WithANNSField("dense").
    WithOutputFields("document"))
if err != nil {
    log.Fatal(err)
}
for _, rs := range searchResults {
    fmt.Println(rs.Fields)
}
use milvus::v2::prelude::*;

let response = client
    .search(
        SearchRequest::builder()
            .collection_name("hugging_face_demo")
            .vector_field("dense")
            .vectors(SearchVectors::EmbeddedText(vec!["How does Milvus handle semantic search?".into()]))
            .limit(3)
            .output_fields(["document"])
            .build()?,
    )
    .await?;
#include <iostream>
#include "milvus/MilvusClientV2.h"

auto request = milvus::SearchRequest()
                   .WithCollectionName("hugging_face_demo")
                   .AddEmbeddedText("How does Milvus handle semantic search?")
                   .WithAnnsField("dense")
                   .WithLimit(3)
                   .AddOutputField("document");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const results = await client.search({
  collection_name: 'hugging_face_demo',
  data: ['How does Milvus handle semantic search?'],
  anns_field: 'dense',
  limit: 3,
  output_fields: ['document'],
});
console.log(results);
curl --request POST \
  --url "YOUR_CLUSTER_ENDPOINT/v2/vectordb/entities/search" \
  --header "Authorization: Bearer YOUR_CLUSTER_TOKEN" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "hugging_face_demo",
    "data": ["How does Milvus handle semantic search?"],
    "annsField": "dense",
    "limit": 3,
    "outputFields": ["document"]
  }'
検索結果には、クエリテキストに最も関連するドキュメントがコサイン類似度順に含まれます。
トラブルシューティング
feature-extraction タスクでモデルを利用できない
Hugging Face でモデルページを開き、Inference Providers セクションを確認します。hf-inference が現在そのモデルを提供していること、およびモデルが feature-extraction をサポートしていることを確認してください。いずれかの要件が満たされていない場合は、別のモデルを選択し、そのモデルページで確認します。モデルの互換性の表は完全なリストではなく、記載されていないモデルでも互換性がある場合があります。モデルを変更する場合は、Function の出力フィールドの次元が置き換え後のモデルと一致していることを確認してください。
返されたベクトルの次元がスキーマと一致しない
モデルの出力次元を確認し、Function の FLOAT_VECTOR 出力フィールドに構成されている dim と比較します。次元が異なるモデルを使用するには、互換性のあるベクトルフィールドまたはコレクションを作成します。カスタム出力次元はサポートされていません。
次のステップ
Functions の一般的な情報については、Function Overview を参照してください。
Hugging Face Sentence Similarity スコアを使用してベクトル検索の候補を再ランク付けするには、Hugging Face Ranker を参照してください。