JSON Shredding
JSON shredding は、従来の行ベースのストレージを最適化されたカラムナストレージに変換することで、JSON クエリを高速化します。JSON のデータモデリングにおける柔軟性を維持しながら、Zilliz Cloud はバックグラウンドでカラムナ最適化を実行し、アクセス効率とクエリ効率を大幅に向上させます。
JSON shredding は、ほとんどの JSON クエリシナリオで有効です。次の場合、パフォーマンス上の利点がさらに顕著になります。
-
より大きく、より複雑な JSON ドキュメント - ドキュメントサイズが大きくなるほど、パフォーマンスの向上幅が大きくなります
-
読み取り中心のワークロード - JSON key に対する頻繁なフィルタリング、ソート、検索
-
混在するクエリパターン - 異なる JSON key にまたがるクエリは、ハイブリッドストレージアプローチの恩恵を受けます
仕組み
JSON shredding のプロセスは、データを高速に取得できるように最適化するため、3 つの明確なフェーズで行われます。
フェーズ 1: 取り込みと key の分類
新しい JSON ドキュメントが書き込まれると、Zilliz Cloud はそれらを継続的にサンプリングして分析し、各 JSON key の統計情報を構築します。この分析には、key の出現率と型の安定性(ドキュメント間でデータ型が一貫しているかどうか)が含まれます。
これらの統計に基づき、JSON key は最適なストレージのために次のように分類されます。
JSON key のカテゴリ
key の種類 | 説明 |
|---|---|
型付き key | ほとんどのドキュメントに存在し、常に同じデータ型を持つ key です(例: すべて整数、またはすべて文字列)。 |
動的 key | 頻繁に出現しますが、データ型が混在している key です(例: 文字列の場合も整数の場合もあります)。 |
共有 key | 出現頻度が低い key、または設定可能な頻度しきい値を下回るネストされた key です。 |
分類例
次の JSON key を含むサンプル JSON データを考えてみましょう。
{"a": 10, "b": "str1", "f": 1}
{"a": 20, "b": "str2", "f": 2}
{"a": 30, "b": "str3", "f": 3}
{"a": 40, "b": 1, "f": 4}       // b becomes mixed type
{"a": 50, "b": 2, "e": "rare"}  // e appears infrequently
このデータに基づくと、key は次のように分類されます。
-
型付き key:
aとf(常に整数) -
動的 key:
b(mixed string/integer) -
共有 key:
e(出現頻度の低い key)
フェーズ 2: ストレージの最適化
フェーズ 1 での分類によって、ストレージレイアウトが決まります。Zilliz Cloud は、クエリ用に最適化されたカラムナ形式を使用します。
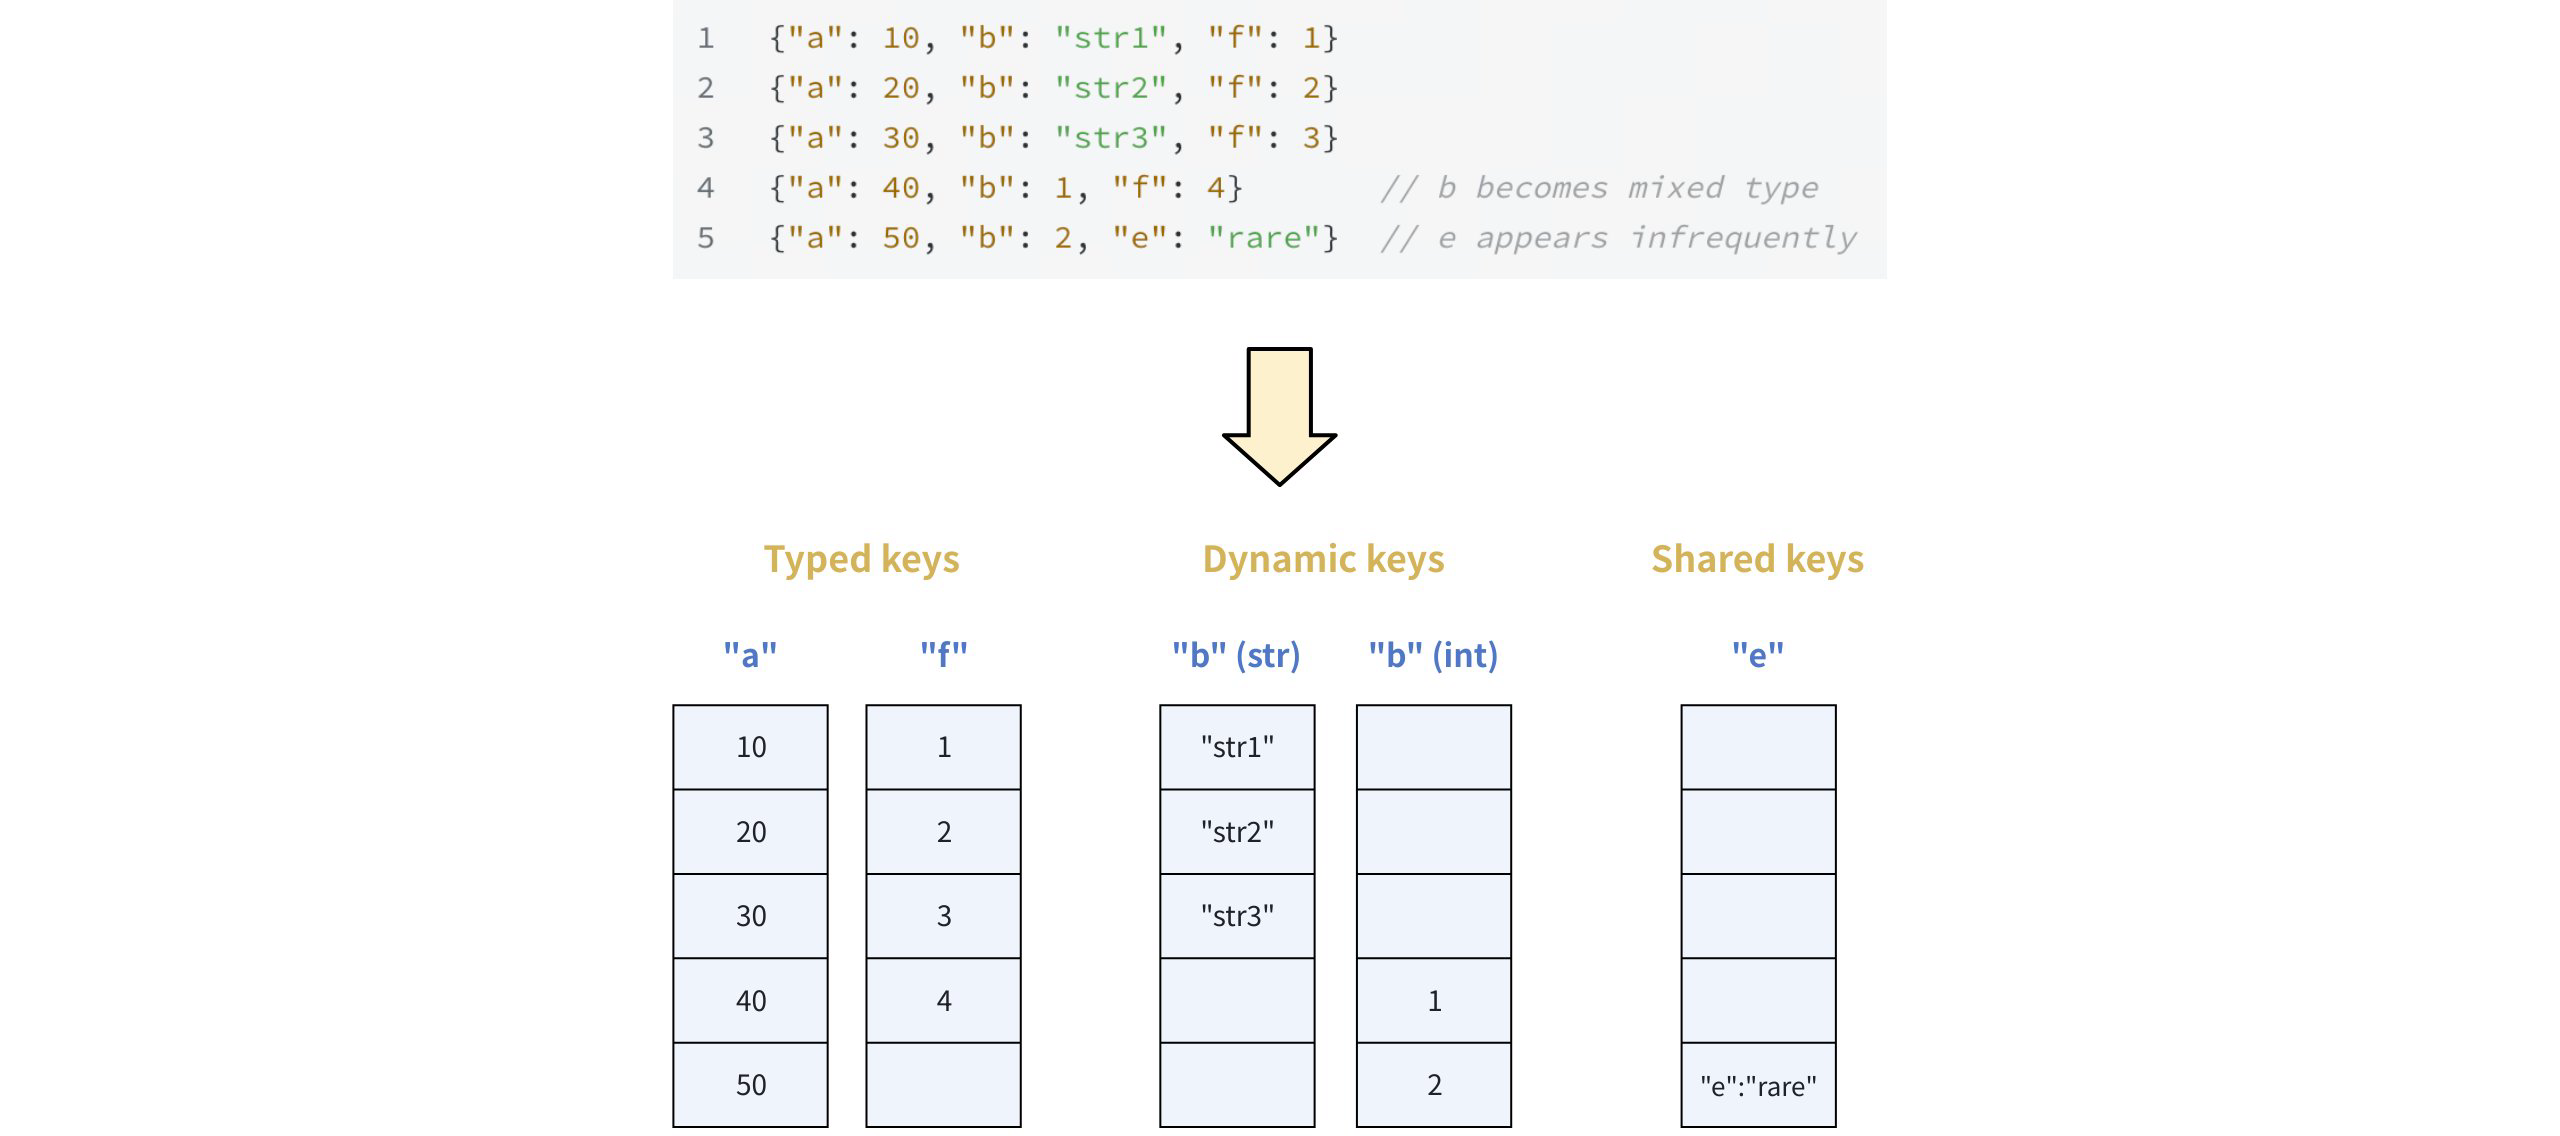
-
Shredded columns: typed および dynamic keys のデータは、専用の列に書き込まれます。このカラムナストレージにより、クエリ時に高速かつ直接的なスキャンが可能になります。Zilliz Cloud は、ドキュメント全体を処理することなく、特定の key に必要なデータだけを読み取れるためです。
-
Shared column: すべての shared keys は、単一のコンパクトなバイナリ JSON 列にまとめて保存されます。この列には、shared-key の inverted インデックス が構築されます。このインデックスは、Zilliz Cloud がデータを迅速に枝刈りして、指定された key を含む行だけに検索範囲を効果的に絞り込めるようにすることで、低頻度 key に対するクエリを高速化するうえで重要です。
フェーズ 3: クエリ実行
最後のフェーズでは、最適化されたストレージレイアウトを活用し、各クエリ述語に対して最も高速な経路をインテリジェントに選択します。
-
Fast path: typed/dynamic key に対するクエリ(例:
json['a'] < 100)は、専用列に直接アクセスします -
Optimized path: shared key に対するクエリ(例:
json['e'] = 'rare')は、inverted インデックス を使用して関連するドキュメントを迅速に特定します
パフォーマンスベンチマーク
当社のテストでは、さまざまな JSON key の種類とクエリパターンにわたって、大幅なパフォーマンス向上が確認されました。
テスト環境と方法論
-
Hardware: 1 core/8GB クラスター
-
Dataset: JSONBench の 100 万件のドキュメント
-
Average document size: 478.89 bytes
-
Test duration: QPS とレイテンシを測定する 100 秒間
結果: typed keys
このテストでは、ほとんどのドキュメントに存在する key をクエリした場合のパフォーマンスを測定しました。
クエリ式 | key の値の型 | QPS(shredding なし) | QPS(shredding あり) | パフォーマンス向上率 |
|---|---|---|---|---|
| 整数 | 8.69 | 287.50 | 33x |
| 文字列 | 8.42 | 126.1 | 14.9x |
結果: shared keys
このテストでは、「shared」カテゴリに分類される、まばらでネストされた key に対するクエリに焦点を当てました。
クエリ式 | key の値の型 | QPS(shredding なし) | QPS(shredding あり) | パフォーマンス向上率 |
|---|---|---|---|---|
| ネストされた整数 | 4.33 | 385 | 88.9x |
| ネストされた文字列 | 7.6 | 352 | 46.3x |
主なポイント
-
shared key に対するクエリ では、最も劇的な改善が見られます(最大 89 倍高速)
-
typed key に対するクエリ では、一貫して 15~30 倍のパフォーマンス向上が得られます
-
すべてのクエリタイプ が JSON Shredding の恩恵を受け、パフォーマンスの低下はありません
FAQ
-
JSON shredding と JSON indexing はどのように選択すればよいですか?
-
JSON shredding は、ドキュメント内に頻繁に出現する key、特に複雑な JSON 構造に最適です。カラムナストレージと inverted indexing の利点を組み合わせており、多くの異なる key をクエリする読み取り中心のシナリオに適しています。ただし、非常に小さな JSON ドキュメントには推奨されません。パフォーマンスの向上が最小限だからです。key の値が JSON ドキュメント全体のサイズに占める割合が小さいほど、shredding によるパフォーマンス最適化の効果は高くなります。
-
JSON indexing は、特定の key に基づくクエリを対象に絞って最適化する場合に適しており、ストレージのオーバーヘッドも低くなります。よりシンプルな JSON 構造に適しています。JSON shredding は配列内の key に対するクエリには対応していないため、それらを高速化するには JSON インデックスが必要であることに注意してください。
詳細については、JSON Field の概要 を参照してください。
-