K-Means クラスタリング
この機能は、該当するすべての AWS リージョンでのみ利用できます。Google Cloud および Microsoft Azure では利用できません。有効化するには、お問い合わせください。
K-Means クラスタリングは、類似した埋め込みを持つレコードを指定した数のクラスターにグループ化します。このジョブを使用して、ベクトルデータの分布を調べたり、レコードを大まかなセマンティックグループに整理したり、サンプリング、分析、その他の下流ワークフロー用にデータセットを準備したりできます。
このジョブはすべての入力レコードを保持し、各レコードに割り当てられたクラスターを示す cluster_id フィールドを追加します。
概要
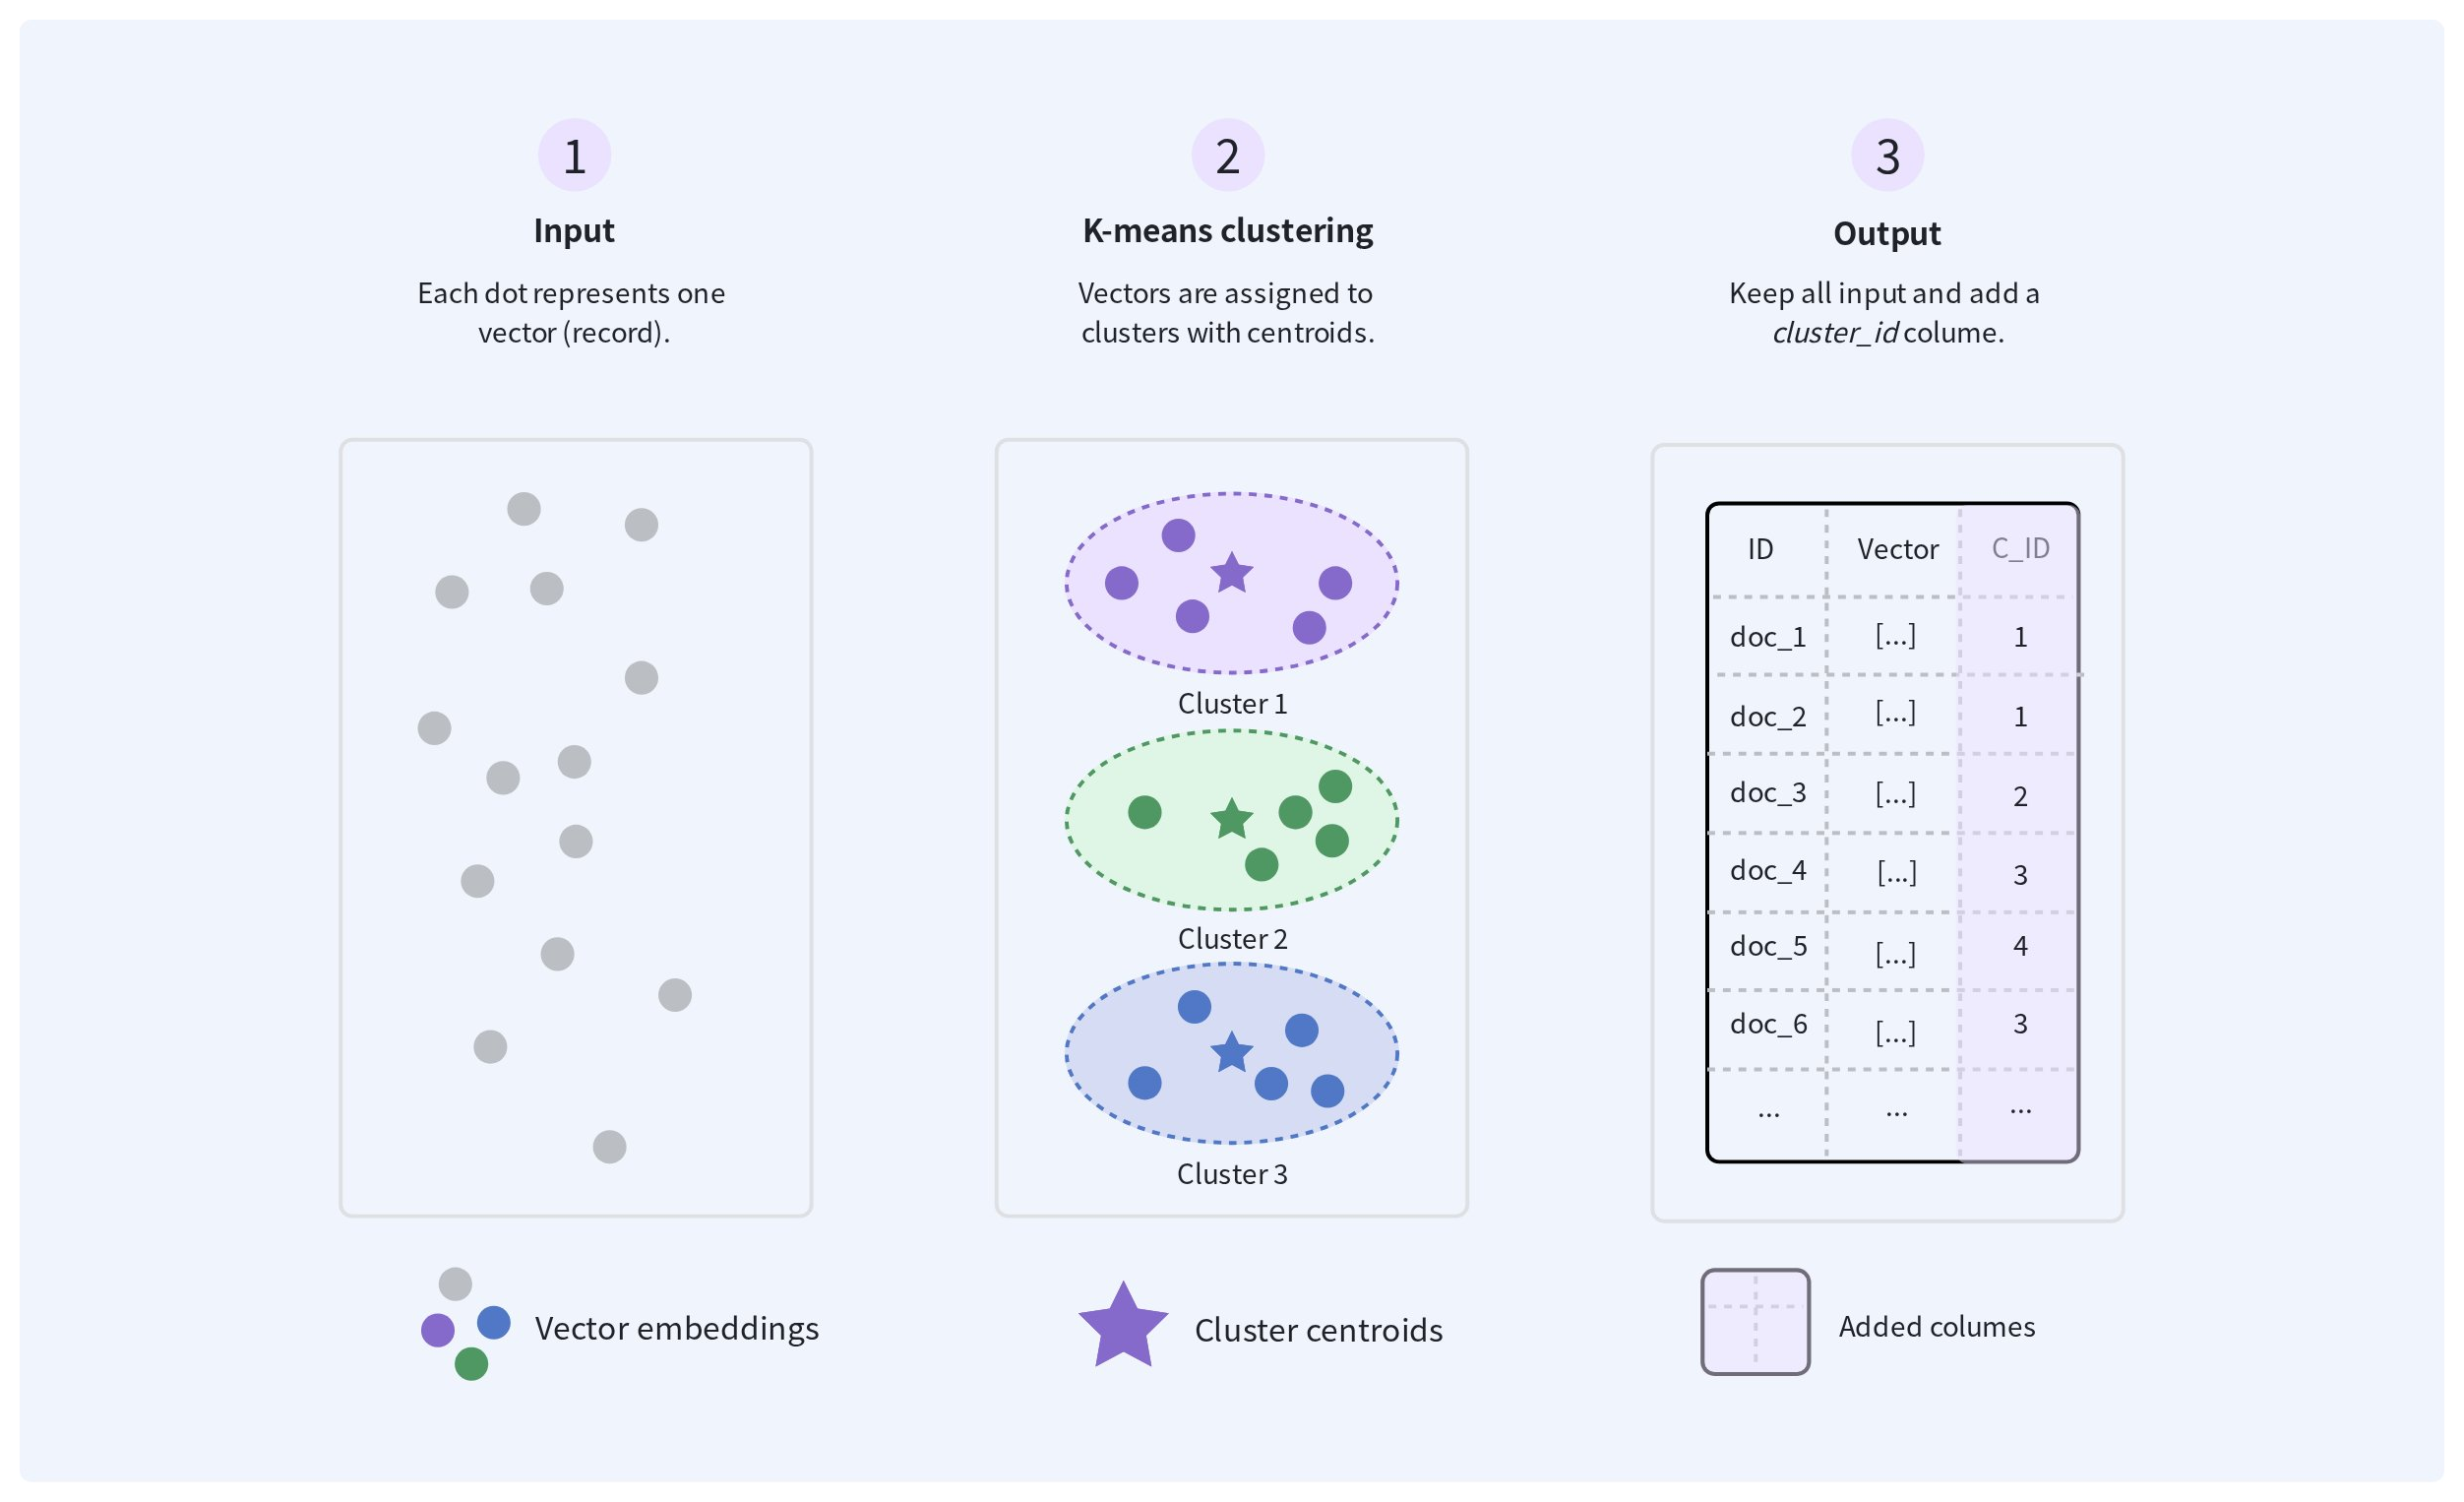
次の図は、K-Means クラスタリングジョブがベクトルデータをどのように整理するかを示しています。ジョブは指定されたベクトルフィールドを読み取り、各レコードを要求されたクラスターのいずれかに割り当て、元のレコードに cluster_id フィールドを追加して書き出します。
同じ cluster_id が割り当てられたレコードは、同じクラスターに属します。現在、ジョブはクラスターの重心を個別の出力ファイルとして書き出しません。
クラスター数を選択する
numClusters に、ジョブで生成するグループ数を設定します。値が小さいほど大まかなクラスターが作成され、値が大きいほどより細かいクラスターが作成されます。
距離メトリクスを選択する
距離メトリクスは、ベクトルがクラスターにどのように割り当てられるかを決定します。
| メトリクス | 類似度の解釈方法 | 使用する状況 |
|---|---|---|
l2 | ユークリッド距離が小さいベクトルほど類似度が高くなります。 | 埋め込みモデルまたは既存のワークフローでユークリッド距離を使用している場合は、このメトリクスを使用します。 |
cosine | コサイン類似度が大きいベクトルほど類似度が高くなります。 | ベクトルの方向がベクトルの大きさよりも重要な場合は、このメトリクスを使用します。 |
出力を理解する
出力はすべての入力列を保持し、各レコードに cluster_id フィールドを追加します。
| フィールド | 説明 |
|---|---|
cluster_id | レコードに割り当てられたクラスターです。同じ cluster_id を持つレコードは、同じ K-Means クラスターに属します。 |
ジョブは、有効なすべての入力ベクトルをいずれか 1 つのクラスターに割り当てます。クラスター ID は 1 回のジョブの出力内でグループを識別するものであり、別々の実行にまたがって安定した識別子として扱うべきではありません。
事前準備
K-Means クラスタリングジョブを作成する前に、以下の点を確認してください。
-
すべての入力ファイルが互換性のあるスキーマを使用し、クラスタリング対象のベクトルフィールドが含まれていること。
-
そのフィールド内のすべてのベクトルが同じ型と次元を使用しており、同じ埋め込みモデルと前処理方法を使用して生成されていること。
認証、入力ファイル、出力の動作など、Spark バッチジョブを実行するための一般的な要件については、Spark バッチジョブ を参照してください。
K-Means クラスタリングジョブを作成する
入力と出力の場所、クラスタリング対象のベクトルフィールド、距離メトリクス、クラスター数を指定して、K-Means クラスタリングジョブを作成します。ジョブは非同期で実行され、ステータスの監視に使用できるジョブ ID を返します。ジョブが成功すると、設定した出力パスで出力ファイルを利用できるようになります。
冪等性キーを準備します。
冪等性キーは、同じジョブリクエストを再試行しても変わらない一意の文字列です。詳細については、冪等性のある送信 を参照してください。
リクエストペイロードを準備します。
export payload='{
  "description": "clustering product embeddings",
  "regionId": "aws-us-west-2",
  "input": {
    "type": "volume",
    "volumeName": "product-data",
    "path": "input/products.parquet",
    "format": "parquet"
  },
  "output": {
    "type": "volume",
    "volumeName": "product-data",
    "path": "output/products-clustered.parquet",
    "format": "parquet"
  },
  "primaryKeyField": "id",
  "vectorField": "embedding",
  "metric": "l2",
  "numClusters": 100,
  "resourceSize": "MEDIUM",
  "timeoutSeconds": 7200
}'
次の表に、ジョブ固有のパラメーターを示します。
| パラメーター | 必須 | 説明 |
|---|---|---|
primaryKeyField | いいえ | 各レコードを識別し、割り当てられた cluster_id に関連付けるために使用する入力フィールドです。省略した場合、ジョブは出力内の各レコードの識別子を生成します。 |
vectorField | はい | クラスタリング対象のベクトルフィールドです。サポートされる表現には、array<float>、数値配列、Spark ベクトル、カンマ区切りの文字列があります。 |
metric | はい | ベクトルの比較に使用するメトリクスです。指定できる値は cosine と l2 です。 |
numClusters | はい | 作成するクラスター数です。値は正の整数である必要があります。 |
すべての Spark バッチジョブで共有されるパラメーターについては、リクエストペイロード を参照してください。
ペイロードを送信します。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request POST \
    --url "https://api.cloud.zilliz.com/v2/projects/{projectId}/jobs/kmeans" \
    --header "Authorization: Bearer ${API_KEY}" \
    --header "Idempotency-Key: spark-job-20260730-003" \
    --header "Content-Type: application/json" \
    --data "${payload}"
リクエストは、ジョブが作成された後に応答を返します。レスポンスには、進行状況の監視に使用できるジョブ ID が含まれます。次の例は、成功したレスポンスを示しています。
{
  "code": 0,
  "data": {
    "jobId": "job-xxxxxxxx",
    "projectId": "proj-xxxxxxxx",
    "type": "SPARK",
    "description": "clustering product embeddings",
    "status": "PENDING",
    "regionId": "aws-us-west-2",
    "clusterId": "in-xxxxxxxx",
    "createdAt": null,
    "startedAt": null,
    "finishedAt": null,
    "durationSeconds": null
  }
}
ジョブを監視する
リクエストを送信した後、返されたジョブ ID を使用して、ジョブが終了状態に達するまで監視します。ジョブのステータスと詳細を表示したり、既存のジョブを一覧表示したり、キャンセル可能な状態の間にジョブをキャンセルしたりできます。
ジョブが成功したら、リクエストで指定したパスに期待する出力が存在することを確認してください。
手順、ジョブの状態、状態遷移については、Spark バッチジョブの管理 を参照してください。
出力を検証する
ジョブが成功したら、次の点を確認してください。
-
構成したボリュームパスに出力ファイルが存在すること。
-
すべての入力レコードと列が保持されていること。
-
各レコードに有効な
cluster_idが含まれていること。 -
個別のクラスター ID の数が
numClustersを超えていないこと。 -
同じクラスターからサンプリングしたレコードが、目的の用途に対して妥当な類似度になっていること。
次のステップ
生成された cluster_id 値を使用して、埋め込みの分布を分析したり、異なるセマンティックグループからレコードをサンプリングしたり、下流の処理用にレコードを整理したりできます。これらのグループ内で意味的に冗長なレコードを特定するには、ベクトルの類似度による重複排除 を使用します。より広い分布に当てはまらない異常なレコードを見つけるには、異常検出 を使用します。