言語識別子
language_identifier は、言語分析プロセスを自動化することで Zilliz Cloud のテキスト検索機能を強化するために設計された専用のトークナイザーです。その主な機能は、テキストフィールドの言語を検出し、その言語に最も適した事前設定済みのアナライザーを動的に適用することです。これは、さまざまな言語を扱うアプリケーションにとって特に有用であり、入力ごとに言語を手動で割り当てる必要がなくなります。
テキストデータを適切な処理パイプラインにインテリジェントにルーティングすることで、language_identifier は多言語データの取り込みを効率化し、後続の検索および取得操作で正確なトークン化を保証します。
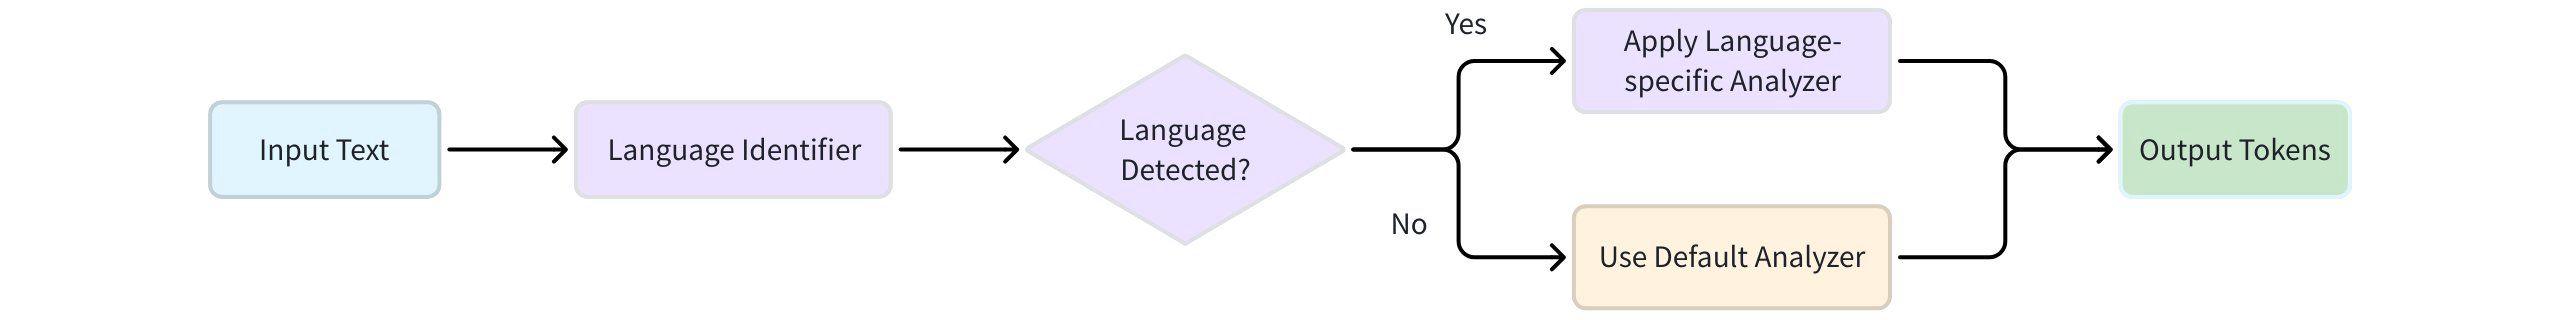
言語検出ワークフロー
language_identifier は、テキスト文字列を処理するために一連のステップを実行します。このワークフローを理解することは、正しく設定するために重要です。
-
入力: ワークフローは、テキスト文字列を入力として開始します。
-
言語検出: この文字列はまず言語検出エンジンに渡され、エンジンは言語の識別を試みます。Zilliz Cloud は whatlang と lingua の 2 つのエンジンをサポートしています。
-
アナライザーの選択:
-
成功: 言語が正常に検出されると、システムは、検出された言語名に対応するアナライザーが
analyzersディクショナリに設定されているかどうかを確認します。一致するものが見つかった場合、システムは指定されたアナライザーを入力テキストに適用します。たとえば、検出された「Mandarin」テキストはjiebaトークナイザーにルーティングされます。 -
フォールバック: 検出に失敗した場合、または言語の検出に成功しても特定のアナライザーが設定されていない場合、システムは事前設定済みの デフォルトアナライザー にフォールバックします。これは明確にしておくべき重要な点です。
defaultアナライザーは、検出失敗と一致するアナライザーが存在しない場合の両方に対するフォールバックです。
-
適切なアナライザーが選択されると、テキストがトークン化されて処理され、ワークフローが完了します。
利用可能な言語検出エンジン
Zilliz Cloud では、2 つの言語検出エンジンから選択できます:
選択は、アプリケーションの特定のパフォーマンスおよび精度の要件によって異なります。
エンジン | 速度 | 精度 | 出力形式 | 最適な用途 |
|---|---|---|---|---|
| 高速 | ほとんどの言語に対応 | 言語名(例: 参照: サポートされている言語表の言語列 | 速度が重要なリアルタイムアプリケーション |
| 低速 | 特に短いテキストで高い精度 | 英語の言語名(例: 参照: サポートされている言語の一覧 | 速度よりも精度が重要なアプリケーション |
重要な考慮事項は、エンジンの命名規則です。どちらのエンジンも言語名を英語で返しますが、一部の言語では異なる用語を使用します(例: whatlang は Mandarin を返し、lingua は Chinese を返します)。アナライザーのキーは、選択した検出エンジンが返す名前と完全に一致する必要があります。
設定
language_identifier トークナイザーを正しく使用するには、その設定を定義および適用するために次のステップを実行する必要があります。
ステップ 1: 言語とアナライザーを選択する
language_identifier の設定の核心は、サポートする予定の特定の言語に合わせてアナライザーを調整することです。システムは検出された言語を正しいアナライザーと照合して動作するため、このステップは正確なテキスト処理にとって重要です。
以下は、言語と適切な Zilliz Cloud アナライザーの推奨マッピングです。この表は、言語検出エンジンの出力と、その用途に最適なツールとの橋渡しをします。
言語(検出器の出力) | 推奨アナライザー | 説明 |
|---|---|---|
|
| ステミングとストップワードのフィルタリングを備えた標準的な英語のトークン化です。 |
|
| スペースで区切られていないテキスト向けの中国語の単語分割です。 |
|
| 日本語を含む複雑な文字体系に対応する堅牢なトークナイザーです。 |
|
| フランス語のアクセントと文字を処理するカスタム設定です。 |
-
一致が重要: アナライザーの名前は、検出エンジンの言語出力と 完全に一致する必要があります。たとえば、
whatlangを使用する場合、中国語テキストのキーはMandarinである必要があります。 -
ベストプラクティス: 上記の表は、いくつかの一般的な言語について推奨設定を示していますが、完全なリストではありません。アナライザーの選択に関するより包括的なガイドについては、ユースケースに適したアナライザーを選択する を参照してください。
-
検出器の出力: 検出エンジンが返す言語名の完全なリストについては、Whatlang サポート言語表 および Lingua サポート言語一覧 を参照してください。
ステップ 2: analyzer_params を定義する
Zilliz Cloud で language_identifier トークナイザーを使用するには、次の主要コンポーネントを含むディクショナリを作成します:
必須コンポーネント:
-
analyzers設定セット – すべてのアナライザー設定を含むディクショナリで、次を含める必要があります:-
default– 言語検出に失敗した場合、または一致するアナライザーが見つからない場合に使用されるフォールバックアナライザー -
言語固有のアナライザー – それぞれ
<analyzer_name>: <analyzer_config>として定義され、次の条件を満たします:-
analyzer_nameは、選択した検出エンジンの出力と一致します(例:"English"、"Japanese") -
analyzer_configは標準的なアナライザーパラメーター形式に従います(アナライザーの概要 を参照)
-
-
オプションコンポーネント:
-
identifier– 使用する言語検出エンジン(whatlangまたはlingua)を指定します。指定しない場合はwhatlangがデフォルトになります -
mapping– アナライザーのカスタムエイリアスを作成し、検出エンジンの正確な出力形式の代わりにわかりやすい名前を使用できるようにします
このトークナイザーは、まず入力テキストの言語を検出し、次に設定から適切なアナライザーを選択して動作します。検出に失敗した場合、または一致するアナライザーが存在しない場合は、自動的に default アナライザーにフォールバックします。
推奨: 名前の直接一致
アナライザー名は、選択した言語検出エンジンの出力と完全に一致する必要があります。この方法はよりシンプルで、混乱の可能性を回避できます。
whatlang と lingua の両方について、それぞれのドキュメントに記載されている言語名を使用します:
-
whatlang サポート言語(「Language」列を使用)
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",  # Must be `language_identifier`
        "identifier": "whatlang",  # or `lingua`
        "analyzers": {  # A set of analyzer configs
            "default": {
                "tokenizer": "standard"  # fallback if language detection fails
            },
            "English": {  # Analyzer name that matches whatlang output
                "type": "english"
            },
            "Mandarin": {  # Analyzer name that matches whatlang output
                "tokenizer": "jieba"
            }
        }
    }
}
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", new HashMap<String, Object>() {{
    put("type", "language_identifier");   // Must be `language_identifier`
    put("identifier", "whatlang");        // or `lingua`
    put("analyzers", new HashMap<String, Object>() {{  // A set of analyzer configs
        put("default", new HashMap<String, Object>() {{
            put("tokenizer", "standard"); // fallback if language detection fails
        }});
        put("English", new HashMap<String, Object>() {{  // Analyzer name that matches whatlang output
            put("type", "english");
        }});
        put("Mandarin", new HashMap<String, Object>() {{ // Analyzer name that matches whatlang output
            put("tokenizer", "jieba");
        }});
    }});
}});
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier", // Must be `language_identifier`
        "identifier": "whatlang",            // or `lingua`
        "analyzers": map[string]any{         // A set of analyzer configs
            "default": map[string]any{
                "tokenizer": "standard", // fallback if language detection fails
            },
            "English": map[string]any{ // Analyzer name that matches whatlang output
                "type": "english",
            },
            "Mandarin": map[string]any{ // Analyzer name that matches whatlang output
                "tokenizer": "jieba",
            },
        },
    },
}
use serde_json::json;

let analyzer_params = json!({
    "tokenizer": {
        "type": "language_identifier",  // Must be `language_identifier`
        "identifier": "whatlang",       // or `lingua`
        "analyzers": {                  // A set of analyzer configs
            "default": {
                "tokenizer": "standard" // fallback if language detection fails
            },
            "English": {                // Analyzer name that matches whatlang output
                "type": "english"
            },
            "Mandarin": {               // Analyzer name that matches whatlang output
                "tokenizer": "jieba"
            }
        }
    }
});
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"}, // Must be `language_identifier`
        {"identifier", "whatlang"},      // or `lingua`
        {"analyzers", {                  // A set of analyzer configs
            {"default", {{"tokenizer", "standard"}}}, // fallback if language detection fails
            {"English", {{"type", "english"}}},       // Analyzer name that matches whatlang output
            {"Mandarin", {{"tokenizer", "jieba"}}}    // Analyzer name that matches whatlang output
        }}
    }}
};
const analyzer_params = {
  tokenizer: {
    type: "language_identifier", // Must be `language_identifier`
    identifier: "whatlang",      // or `lingua`
    analyzers: {                 // A set of analyzer configs
      default: {
        tokenizer: "standard",   // fallback if language detection fails
      },
      English: {                 // Analyzer name that matches whatlang output
        type: "english",
      },
      Mandarin: {                // Analyzer name that matches whatlang output
        tokenizer: "jieba",
      },
    },
  },
};
using System.Collections.Generic;

var analyzerParams = new Dictionary<string, object>
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier", // Must be `language_identifier`
        ["identifier"] = "whatlang",      // or `lingua`
        ["analyzers"] = new Dictionary<string, object> // A set of analyzer configs
        {
            ["default"] = new Dictionary<string, object>
            {
                ["tokenizer"] = "standard" // fallback if language detection fails
            },
            ["English"] = new Dictionary<string, object> // Analyzer name that matches whatlang output
            {
                ["type"] = "english"
            },
            ["Mandarin"] = new Dictionary<string, object> // Analyzer name that matches whatlang output
            {
                ["tokenizer"] = "jieba"
            }
        }
    }
};
# restful
analyzerParams='{
  "tokenizer": {
    "type": "language_identifier",
    "identifier": "whatlang",
    "analyzers": {
      "default": {
        "tokenizer": "standard"
      },
      "English": {
        "type": "english"
      },
      "Mandarin": {
        "tokenizer": "jieba"
      }
    }
  }
}'
代替方法: mapping を使用したカスタム名
カスタムアナライザー名を使用する場合、または既存の設定との互換性を維持する必要がある場合は、mapping パラメーターを使用できます。これによりアナライザーのエイリアスが作成され、元の検出エンジン名とカスタム名の両方が機能します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {
                "tokenizer": "standard"
            },
            "english_analyzer": {  # Custom analyzer name
                "type": "english"
            },
            "chinese_analyzer": {  # Custom analyzer name
                "tokenizer": "jieba"
            }
        },
        "mapping": {
            "English": "english_analyzer",   # Maps detection output to custom name
            "Chinese": "chinese_analyzer"
        }
    }
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", new HashMap<String, Object>() {{
    put("type", "language_identifier");
    put("identifier", "lingua");
    put("analyzers", new HashMap<String, Object>() {{
        put("default", new HashMap<String, Object>() {{
            put("tokenizer", "standard");
        }});
        put("english_analyzer", new HashMap<String, Object>() {{  // Custom analyzer name
            put("type", "english");
        }});
        put("chinese_analyzer", new HashMap<String, Object>() {{  // Custom analyzer name
            put("tokenizer", "jieba");
        }});
    }});
    put("mapping", new HashMap<String, Object>() {{  // Maps detection output to custom name
        put("English", "english_analyzer");
        put("Chinese", "chinese_analyzer");
    }});
}});
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "lingua",
        "analyzers": map[string]any{
            "default": map[string]any{
                "tokenizer": "standard",
            },
            "english_analyzer": map[string]any{ // Custom analyzer name
                "type": "english",
            },
            "chinese_analyzer": map[string]any{ // Custom analyzer name
                "tokenizer": "jieba",
            },
        },
        "mapping": map[string]any{ // Maps detection output to custom names
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer",
        },
    },
}
use serde_json::json;

let analyzer_params = json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {
                "tokenizer": "standard"
            },
            "english_analyzer": {  // Custom analyzer name
                "type": "english"
            },
            "chinese_analyzer": {  // Custom analyzer name
                "tokenizer": "jieba"
            }
        },
        "mapping": {
            "English": "english_analyzer",   // Maps detection output to custom name
            "Chinese": "chinese_analyzer"
        }
    }
});
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "lingua"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"english_analyzer", {{"type", "english"}}},      // Custom analyzer name
            {"chinese_analyzer", {{"tokenizer", "jieba"}}}    // Custom analyzer name
        }},
        {"mapping", {                                          // Maps detection output to custom names
            {"English", "english_analyzer"},
            {"Chinese", "chinese_analyzer"}
        }}
    }}
};
const analyzer_params = {
  tokenizer: {
    type: "language_identifier",
    identifier: "lingua",
    analyzers: {
      default: {
        tokenizer: "standard",
      },
      english_analyzer: { // Custom analyzer name
        type: "english",
      },
      chinese_analyzer: { // Custom analyzer name
        tokenizer: "jieba",
      },
    },
    mapping: {            // Maps detection output to custom names
      English: "english_analyzer",
      Chinese: "chinese_analyzer",
    },
  },
};
var analyzerParams = new Dictionary<string, object>
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier",
        ["identifier"] = "lingua",
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object>
            {
                ["tokenizer"] = "standard"
            },
            ["english_analyzer"] = new Dictionary<string, object> // Custom analyzer name
            {
                ["type"] = "english"
            },
            ["chinese_analyzer"] = new Dictionary<string, object> // Custom analyzer name
            {
                ["tokenizer"] = "jieba"
            }
        },
        ["mapping"] = new Dictionary<string, object> // Maps detection output to custom names
        {
            ["English"] = "english_analyzer",
            ["Chinese"] = "chinese_analyzer"
        }
    }
};
# restful
analyzerParams='{
  "tokenizer": {
    "type": "language_identifier",
    "identifier": "lingua",
    "analyzers": {
      "default": {
        "tokenizer": "standard"
      },
      "english_analyzer": {
        "type": "english"
      },
      "chinese_analyzer": {
        "tokenizer": "jieba"
      }
    },
    "mapping": {
      "English": "english_analyzer",
      "Chinese": "chinese_analyzer"
    }
  }
}'
analyzer_params を定義した後、コレクションスキーマを定義するときにそれを VARCHAR フィールドに適用できます。これにより、Zilliz Cloud は指定されたアナライザーを使用してそのフィールドのテキストを処理し、効率的なトークン化とフィルタリングを実行できます。詳細は、使用例 を参照してください。
例
一般的なシナリオ向けのすぐに使用できる設定をいくつか紹介します。各例には設定と検証コードの両方が含まれているため、セットアップをすぐにテストできます。
英語と中国語の検出
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient

# Configuration
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
}

# Test the configuration
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# English text
result_en = client.run_analyzer("The Milvus vector database is built for scale!", analyzer_params)
print("English:", result_en)

# Chinese text
result_cn = client.run_analyzer("Milvus 向量数据库专为大规模应用而设计", analyzer_params)
print("Chinese:", result_cn)
import java.util.*;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Configuration
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", new HashMap<String, Object>() {{
    put("type", "language_identifier");
    put("identifier", "whatlang");
    put("analyzers", new HashMap<String, Object>() {{
        put("default", new HashMap<String, Object>() {{
            put("tokenizer", "standard");
        }});
        put("English", new HashMap<String, Object>() {{
            put("type", "english");
        }});
        put("Mandarin", new HashMap<String, Object>() {{
            put("tokenizer", "jieba");
        }});
    }});
}});

// English text
List<String> english = new ArrayList<>();
english.add("The Milvus vector database is built for scale!");
RunAnalyzerResp enResp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(english)
        .analyzerParams(analyzerParams)
        .build());

// Chinese text
List<String> chinese = new ArrayList<>();
chinese.add("Milvus 向量数据库专为大规模应用而设计");
RunAnalyzerResp cnResp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(chinese)
        .analyzerParams(analyzerParams)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

// Configuration
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "whatlang",
        "analyzers": map[string]any{
            "default":  map[string]any{"tokenizer": "standard"},
            "English":  map[string]any{"type": "english"},
            "Mandarin": map[string]any{"tokenizer": "jieba"},
        },
    },
}

// English text
enResult, err := client.RunAnalyzer(ctx,
    milvusclient.NewRunAnalyzerOption("The Milvus vector database is built for scale!").
        WithAnalyzerParams(analyzerParams))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
for _, tokens := range enResult {
    fmt.Println("English:", tokens.Tokens)
}

// Chinese text
cnResult, err := client.RunAnalyzer(ctx,
    milvusclient.NewRunAnalyzerOption("Milvus 向量数据库专为大规模应用而设计").
        WithAnalyzerParams(analyzerParams))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
for _, tokens := range cnResult {
    fmt.Println("Chinese:", tokens.Tokens)
}
use milvus::v2::prelude::*;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

// Configuration
let analyzer_params = serde_json::json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
});

// English text
let en_response = client.run_analyzer(RunAnalyzerRequest::builder()
    .texts(["The Milvus vector database is built for scale!"])
    .analyzer_params(analyzer_params.clone())
    .build()?).await?;

// Chinese text
let cn_response = client.run_analyzer(RunAnalyzerRequest::builder()
    .texts(["Milvus 向量数据库专为大规模应用而设计"])
    .analyzer_params(analyzer_params)
    .build()?).await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

// Configuration
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "whatlang"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"Mandarin", {{"tokenizer", "jieba"}}}
        }}
    }}
};

// English text
milvus::RunAnalyzerRequest en_request;
en_request.WithAnalyzerParams(analyzer_params);
en_request.AddText("The Milvus vector database is built for scale!");
milvus::RunAnalyzerResponse en_response;
status = client->RunAnalyzer(en_request, en_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

// Chinese text
milvus::RunAnalyzerRequest cn_request;
cn_request.WithAnalyzerParams(analyzer_params);
cn_request.AddText("Milvus 向量数据库专为大规模应用而设计");
milvus::RunAnalyzerResponse cn_response;
status = client->RunAnalyzer(cn_request, cn_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN',
});

// Configuration
const analyzer_params = {
  tokenizer: {
    type: "language_identifier",
    identifier: "whatlang",
    analyzers: {
      default: { tokenizer: "standard" },
      English: { type: "english" },
      Mandarin: { tokenizer: "jieba" },
    },
  },
};

// English text
const en_result = await client.runAnalyzer({
  text: 'The Milvus vector database is built for scale!',
  analyzer_params,
});
console.log('English:', en_result.results.flatMap(r => r.tokens.map(t => t.token)));

// Chinese text
const cn_result = await client.runAnalyzer({
  text: 'Milvus 向量数据库专为大规模应用而设计',
  analyzer_params,
});
console.log('Chinese:', cn_result.results.flatMap(r => r.tokens.map(t => t.token)));
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Utility;
using Milvus.Client.V2.Responses.Utility;

using var client = new MilvusClientV2(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    ApiKey = "YOUR_CLUSTER_TOKEN"
});
await client.ConnectAsync();

// Configuration
var analyzerParams = new Dictionary<string, object>
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier",
        ["identifier"] = "whatlang",
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object> { ["tokenizer"] = "standard" },
            ["English"] = new Dictionary<string, object> { ["type"] = "english" },
            ["Mandarin"] = new Dictionary<string, object> { ["tokenizer"] = "jieba" }
        }
    }
};

// English text
await client.RunAnalyzerAsync(new RunAnalyzerReq
{
    AnalyzerParams = analyzerParams,
    Texts = new[] { "The Milvus vector database is built for scale!" }
});

// Chinese text
await client.RunAnalyzerAsync(new RunAnalyzerReq
{
    AnalyzerParams = analyzerParams,
    Texts = new[] { "Milvus 向量数据库专为大规模应用而设计" }
});
curl --request POST \
  --url "YOUR_CLUSTER_ENDPOINT/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer YOUR_CLUSTER_TOKEN" \
  --header "Content-Type: application/json" \
  --data-raw '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"whatlang\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"Mandarin\":{\"tokenizer\":\"jieba\"}}}}",
    "text": ["The Milvus vector database is built for scale!"]
  }'
アクセント正規化を使用するヨーロッパ言語
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient

# Configuration for French, German, Spanish, etc.
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
}

# Test with accented text
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

result_fr = client.run_analyzer("Café français très délicieux", analyzer_params)
print("French:", result_fr)
import java.util.*;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Configuration for French, German, Spanish, etc.
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", new HashMap<String, Object>() {{
    put("type", "language_identifier");
    put("identifier", "lingua");
    put("analyzers", new HashMap<String, Object>() {{
        put("default", new HashMap<String, Object>() {{
            put("tokenizer", "standard");
        }});
        put("English", new HashMap<String, Object>() {{
            put("type", "english");
        }});
        put("French", new HashMap<String, Object>() {{
            put("tokenizer", "standard");
            put("filter", Arrays.asList("lowercase", "asciifolding"));
        }});
    }});
}});

// Test with accented text
List<String> texts = new ArrayList<>();
texts.add("Café français très délicieux");
RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

// Configuration for French, German, Spanish, etc.
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "lingua",
        "analyzers": map[string]any{
            "default": map[string]any{"tokenizer": "standard"},
            "English": map[string]any{"type": "english"},
            "French": map[string]any{
                "tokenizer": "standard",
                "filter":    []any{"lowercase", "asciifolding"},
            },
        },
    },
}

// Test with accented text
result, err := client.RunAnalyzer(ctx,
    milvusclient.NewRunAnalyzerOption("Café français très délicieux").
        WithAnalyzerParams(analyzerParams))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
for _, tokens := range result {
    fmt.Println("French:", tokens.Tokens)
}
use milvus::v2::prelude::*;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

// Configuration for French, German, Spanish, etc.
let analyzer_params = serde_json::json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
});

// Test with accented text
let response = client.run_analyzer(RunAnalyzerRequest::builder()
    .texts(["Café français très délicieux"])
    .analyzer_params(analyzer_params)
    .build()?).await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

// Configuration for French, German, Spanish, etc.
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "lingua"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"French", {
                {"tokenizer", "standard"},
                {"filter", {"lowercase", "asciifolding"}}
            }}
        }}
    }}
};

// Test with accented text
milvus::RunAnalyzerRequest request;
request.WithAnalyzerParams(analyzer_params);
request.AddText("Café français très délicieux");
milvus::RunAnalyzerResponse response;
status = client->RunAnalyzer(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN',
});

// Configuration for French, German, Spanish, etc.
const analyzer_params = {
  tokenizer: {
    type: "language_identifier",
    identifier: "lingua",
    analyzers: {
      default: { tokenizer: "standard" },
      English: { type: "english" },
      French: {
        tokenizer: "standard",
        filter: ["lowercase", "asciifolding"],
      },
    },
  },
};

// Test with accented text
const fr_result = await client.runAnalyzer({
  text: 'Café français très délicieux',
  analyzer_params,
});
console.log('French:', fr_result.results.flatMap(r => r.tokens.map(t => t.token)));
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Utility;
using Milvus.Client.V2.Responses.Utility;

using var client = new MilvusClientV2(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    ApiKey = "YOUR_CLUSTER_TOKEN"
});
await client.ConnectAsync();

// Configuration for French, German, Spanish, etc.
var analyzerParams = new Dictionary<string, object>
{
    ["tokenizer"] = new Dictionary<string, object>
    {
        ["type"] = "language_identifier",
        ["identifier"] = "lingua",
        ["analyzers"] = new Dictionary<string, object>
        {
            ["default"] = new Dictionary<string, object> { ["tokenizer"] = "standard" },
            ["English"] = new Dictionary<string, object> { ["type"] = "english" },
            ["French"] = new Dictionary<string, object>
            {
                ["tokenizer"] = "standard",
                ["filter"] = new[] { "lowercase", "asciifolding" }
            }
        }
    }
};

// Test with accented text
await client.RunAnalyzerAsync(new RunAnalyzerReq
{
    AnalyzerParams = analyzerParams,
    Texts = new[] { "Café français très délicieux" }
});
curl --request POST \
  --url "YOUR_CLUSTER_ENDPOINT/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer YOUR_CLUSTER_TOKEN" \
  --header "Content-Type: application/json" \
  --data-raw '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"lingua\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"French\":{\"tokenizer\":\"standard\",\"filter\":[\"lowercase\",\"asciifolding\"]}}}}",
    "text": ["Café français très délicieux"]
  }'
想定される出力
上記のヨーロッパ言語の例では、次のトークンが順に生成されます。SDK のレスポンスオブジェクトと出力形式は言語によって異なります。REST レスポンスでは、これらのトークンは data.results[].tokens[].token に含まれます。英語と中国語の検出例のトークンシーケンスは、検出器が各入力に対して選択するアナライザーによって異なるため、ここでは再現していません。
French: ['cafe', 'francais', 'tres', 'delicieux']
使用上の注意
-
フィールドごとに単一言語: フィールドを単一の均質なテキスト単位として処理します。異なるデータレコード間で異なる言語を扱えるように設計されており、たとえば、あるレコードには英語の文が含まれ、次のレコードにはフランス語の文が含まれる場合があります。
-
混合言語の文字列には非対応: 複数の言語のテキストを含む単一の文字列を処理するようには設計されて いません。たとえば、英語の文と引用された日本語のフレーズの両方を含む単一の
VARCHARフィールドは、単一言語として処理されます。 -
支配的な言語の処理: 混合言語のシナリオでは、検出エンジンはおそらく支配的な言語を識別し、対応するアナライザーがテキスト全体に適用されます。その結果、埋め込まれた外国語のテキストは十分にトークン化されないか、まったくトークン化されなくなります。