コレクションの解説
Zilliz Cloud では、データを管理するために複数のコレクションを作成し、データをエンティティとしてコレクションに挿入できます。コレクションとエンティティは、リレーショナルデータベースのテーブルとレコードに似ています。このページでは、コレクションと関連する概念について説明します。
コレクション
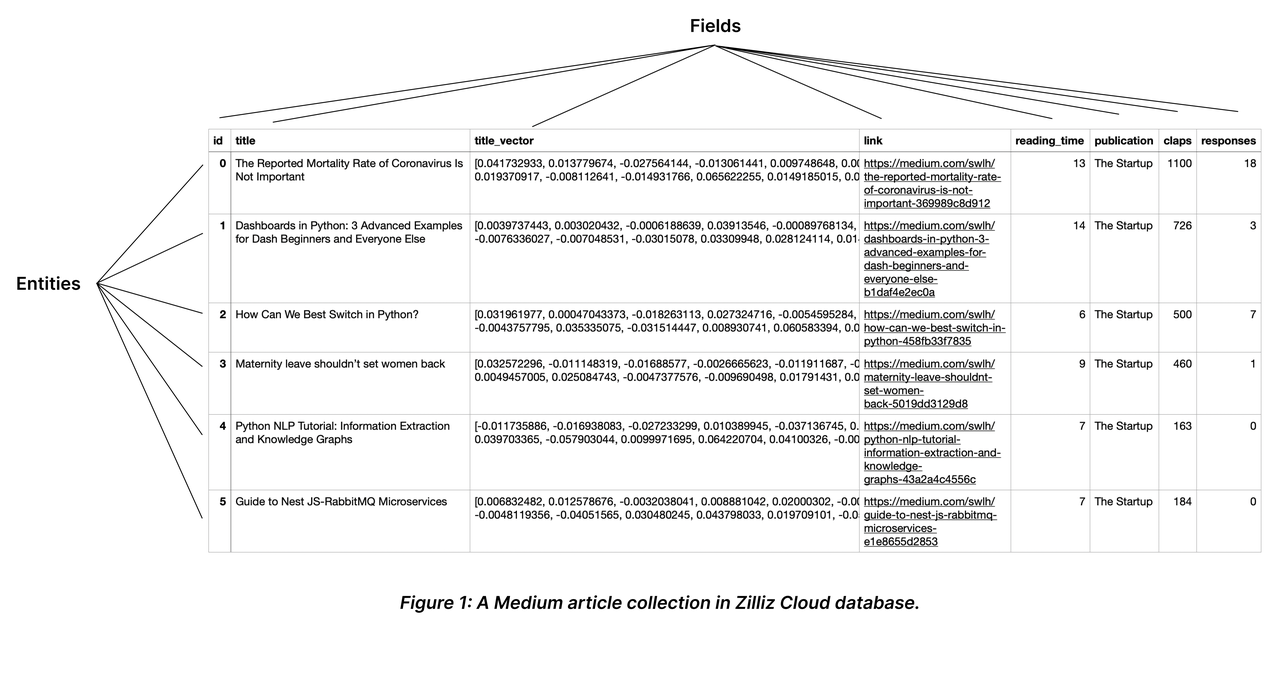
コレクションは、固定された列と可変の行を持つ二次元テーブルです。各列はフィールドを表し、各行はエンティティを表します。
次の図は、8 つの列と 6 つのエンティティを持つコレクションを示しています。
スキーマとフィールド
オブジェクトを説明する際には、通常、そのサイズ、重さ、位置などの属性に言及します。これらの属性をコレクションのフィールドとして使用できます。各フィールドには、データ型やベクトルフィールドの次元数など、さまざまな制約プロパティがあります。フィールドを作成してその順序を定義することで、コレクションスキーマを形成できます。適用可能なデータ型については、スキーマの解説 を参照してください。
挿入するエンティティには、スキーマで定義されたすべてのフィールドを含める必要があります。それらの一部を任意にするには、dynamic field を有効にすることを検討してください。詳細については、Dynamic Field を参照してください。
-
nullable にする、またはデフォルト値を設定する
field を nullable にする方法、またはデフォルト値を設定する方法の詳細については、Nullable & Defaultを参照してください。
-
dynamic field を有効にする
dynamic field を有効にして使用する方法の詳細については、Dynamic Fieldを参照してください。
Primary key と AutoId
リレーショナルデータベースの primary field と同様に、コレクションにはエンティティを他と区別するための primary field があります。primary field の各値はグローバルに一意であり、1 つの特定のエンティティに対応します。
上の図に示すように、id という名前の field が primary field として機能し、最初の ID 0 は The Mortality Rate of Coronavirus is Not Important というタイトルの entity に対応します。primary field が 0 である他の entity は存在しません。
primary field は整数または文字列のみを受け付けます。エンティティを挿入する際、デフォルトでは primary field の値を含める必要があります。ただし、コレクション作成時に AutoId を有効にしている場合、Zilliz Cloud はデータ挿入時にそれらの値を生成します。その場合、挿入するエンティティから primary field の値を除外してください。
詳細については、Primary Field & AutoIdを参照してください。
インデックス
特定のフィールドにインデックスを作成すると、検索効率が向上します。サービスが依存するすべてのフィールドにインデックスを作成することを推奨します。その中でも、ベクトルフィールドのインデックスは必須です。
Zilliz Cloud では、AUTOINDEX がコレクション内のベクトルフィールドに適用できる唯一のインデックスタイプです。詳細については、AUTOINDEX の解説 を参照してください。
エンティティ
エンティティは、コレクション内で同じフィールドセットを共有するデータレコードです。同じ行にあるすべてのフィールドの値で 1 つのエンティティが構成されます。
必要なだけ多くのエンティティをコレクションに挿入できます。ただし、エンティティの数が増えるにつれて必要なメモリサイズも増加し、検索パフォーマンスに影響します。
詳細については、スキーマの解説 を参照してください。
Load と Release
コレクションをロードすることは、コレクション内で類似検索やクエリを実行するための前提条件です。コレクションをロードすると、Zilliz Cloud はすべてのインデックスファイルと各フィールドの生データをメモリにロードし、検索やクエリに高速に応答できるようにします。
検索やクエリはメモリを大量に消費する操作です。コストを節約するため、現在使用していないコレクションはリリースすることを推奨します。
詳細については、Load & Release を参照してください。
Search と Query
インデックスを作成してコレクションをロードしたら、1 つまたは複数のクエリベクトルを入力して類似検索を開始できます。たとえば、検索リクエストに含まれるクエリのベクトル表現を受け取ると、Zilliz Cloud は指定されたメトリクスタイプを使用してクエリベクトルと対象コレクション内のベクトルとの類似度を測定し、その後、クエリと意味的に類似したものを返します。
検索やクエリには、結果の関連性を高めるために metadata filtering を含めることもできます。なお、metadata filtering 条件はクエリでは必須ですが、検索では任意です。
適用可能な metric type の詳細については、Metric Typesを参照してください。
検索とクエリの詳細については、Search & Rerank 章の記事を参照してください。基本機能は次のとおりです。
さらに、Zilliz Cloud は検索パフォーマンスと効率を向上させるための拡張機能も提供しています。これらはデフォルトで無効になっており、サービス要件に応じて有効化して使用できます。それらは次のとおりです。
Partition
パーティションはコレクションのサブセットであり、親コレクションと同じフィールドセットを共有し、それぞれがエンティティのサブセットを含みます。
entity を異なる partition に割り当てることで、entity グループを作成できます。特定の partition で検索やクエリを実行すると、Zilliz Cloud は他の partition 内の entity を無視し、検索効率を向上させます。
詳細については、Partition の管理を参照してください。
Shard
シャードは、コレクションの水平方向のスライスです。各シャードは 1 つのデータ入力チャネルに対応します。すべてのコレクションはデフォルトで 1 つのシャードを持ちます。コレクションに挿入するデータの想定スループットとボリュームに基づいて、コレクション作成時に適切なシャード数を設定できます。
シャード数の設定方法の詳細については、コレクションの作成 を参照してください。
Alias
コレクションのエイリアスを作成できます。1 つのコレクションは複数のエイリアスを持つことができますが、コレクション間でエイリアスを共有することはできません。コレクションに対するリクエストを受信すると、Zilliz Cloud は指定された名前に基づいてコレクションを特定します。指定された名前のコレクションが存在しない場合、Zilliz Cloud は指定された名前をエイリアスとして検索します。コレクションのエイリアスを使用して、さまざまなシナリオにコードを適応させることができます。
詳細については、Alias の管理を参照してください。
Function
コレクション作成時に、フィールドを導出するための関数を Zilliz Cloud に設定できます。たとえば、全文検索関数はユーザー定義関数を使用して、特定の varchar フィールドからスパースベクトルフィールドを導出します。全文検索の詳細については、全文検索 を参照してください。
Consistency Level
分散データベースシステムでは通常、consistency level を使用して、データノードやレプリカ間でのデータの同一性を定義します。コレクションを作成するとき、またはコレクション内で類似検索を実行するときに、それぞれ別の consistency level を設定できます。適用可能な consistency level は、Strong、Bounded Staleness、Session、および Eventually です。
これらの consistency level の詳細については、Consistency Levelを参照してください。
Limits
コレクションに関する制限事項については、Zilliz Cloud Limits を参照してください。