コレクションの管理(コンソール)
コレクションは、ベクトル埋め込みとメタデータを保存するために使用される 2 次元テーブルです。コレクション内のすべてのエンティティは同じスキーマを共有します。データ管理やマルチテナンシーを目的として、複数のコレクションを作成できます。
このガイドでは、Web コンソールでのコレクションの作成と管理の操作について説明します。視覚的なインターフェースを好むユーザーを対象としています。SDK に慣れている場合は、SDK を使用してコレクションを作成および管理することもできます。詳細については、コレクションの作成 を参照してください。
強力なデータ分離が必要で、管理するテナント数が少ない場合は、テナントごとに個別のコレクションを作成できます。
ただし、作成できるコレクションの最大数は、クラスタープラン に応じて 16,384 です。そのため、大規模なマルチテナンシーでは、ユースケースに応じて、パーティションベースやパーティションキーベースのマルチテナンシーなどの代替戦略の使用を検討してください。詳細については、マルチテナンシーの実装 を参照してください。
コレクションを作成する
Zilliz Cloud コンソールでは、コレクションを作成する 3 つの方法が提供されており、それぞれ異なるシナリオ向けに設計されています:
-
独自のコレクションを作成: データセットとユースケースに合わせてスキーマとインデックスのパラメーターをカスタマイズします。スキーマをきめ細かく制御する必要があるユーザーに最適です。
-
サンプルコレクションを作成: 定義済みのスキーマとサンプルデータセットを使用して、コレクションをすばやくセットアップします。Zilliz Cloud を試す新しいユーザーに推奨されます。
-
データ付きで既存のコレクションを複製: 同じデータベース内で既存のコレクションを複製します。テスト用コレクションから本番用コレクションにスキーマとデータの両方をコピーする必要がある、環境複製のシナリオで役立ちます。
-
既存のスキーマから作成: 既存のコレクションのスキーマを使用して新しいコレクションをすばやく作成し、確定する前に編集するオプションもあります。
以下のデモでは、Web UI 上でこれらの機能の場所を示しています。
以下は、コレクションを作成する際に遭遇する概念の一部です。
コレクションの基本情報
コレクションのメタデータには、以下が含まれます。
-
コレクション名
-
(任意)コレクションの説明。最大 1024(UTF-8 バイト単位)。
-
コレクションが属するデータベース。データベースは、クラスターとコレクションの間にあるレイヤーであり、コレクションを管理および整理するための論理コンテナとして機能します。関連するコレクションを同じデータベースの下にグループ化できます。
コレクションスキーマ
スキーマはコレクションのデータ構造を定義するもので、以下を含める必要があります。
-
1 つの主キー(PK)フィールド
-
少なくとも 1 つのベクトルフィールド。コレクションで許可されるベクトルフィールドの数の制限については、Zilliz Cloud の制限 を参照してください。
-
(任意)メタデータ用のスカラーフィールド
-
(任意)動的フィールド。動的フィールドを有効にすると、既存のスキーマを変更せずにデータ挿入時にフィールドを追加できるため、コレクションスキーマに柔軟性がもたらされます。データ構造が固定されていない場合は、動的フィールドを有効にすることを推奨します。フィルターやクエリで頻繁に使用されるフィールドは、動的フィールドを使用するのではなく、あらかじめスキーマで定義してください。これにより、最適なクエリパフォーマンスを維持しやすくなります。
スキーマ構成のほとんどは、コレクションの作成後に変更できません。現在および将来のビジネスニーズを満たすように、スキーマを慎重に設計してください。ベストプラクティスについては、スキーマの解説 を参照してください。
インデックス
インデックスは、検索およびクエリを高速化するためにデータを整理するデータ構造です。Zilliz Cloud は 2 種類のインデックスをサポートしています。
-
ベクトルインデックス: AUTOINDEX を使用して自動的に作成され、ベクトル検索を高速化します。スキーマに複数のベクトルフィールドがある場合は、ベクトルフィールドごとに個別のインデックスを作成できます。さらに、ベクトル間の距離の計算に使用されるメトリクスタイプと、インデックスのコスト、パフォーマンス、容量のトレードオフのために基盤となる量子化戦略を制御するインデックス構築レベルを編集することもできます。
-
スカラーインデックス: デフォルトでは、Zilliz Cloud はスカラーフィールドのインデックスを自動作成しません。ただし、フィルタリングによく使用されるスカラーフィールドには、検索およびクエリを高速化するために手動でインデックスを作成できます。
インデックスの作成はコレクションの作成時にスキップし、後からインデックスを追加することもできます。詳細については、Indexes を参照してください。
関数
Zilliz Cloud では、関数は、データ挿入時およびクエリ実行時に、コレクション内でテキスト関連の機能がどのように適用されるかを定義します。
関数は、適用されるタイミングに基づいて 2 つの主要なカテゴリに分類されます。
-
Pre-search Functions
Pre-search Functions は、生のテキストが検索に使用できるベクトル表現にどのように変換されるかを定義します。これらはコレクションの作成時に構成され、コレクションのスキーマの一部になります。
Pre-search Functions の例には、BM25 関数やモデルベースの関数があります。
Pre-search Functions の動作の概念的な概要については、Function の概要 を参照してください。
-
Post-search Functions
Post-search Functions は、クエリ時に検索結果の順序を調整します。Pre-search Functions とは異なり、Post-search Functions はコレクションスキーマにバインドされません。これらは検索リクエストのパラメーターとして指定され、検索によって返された候補結果に対して動作します。
Post-search Functions は、インデックス作成や候補の取得には影響しません。
Post-search Functions の動作の概念的な概要については、Function の概要 を参照してください。
パーティションとパーティションキー
パーティション: パーティションはコレクションの物理的なサブセットです。パーティションは親コレクションと同じデータスキーマを共有しますが、コレクション内のデータの一部のみを含みます。各コレクションにはデフォルトで 1 つのパーティションが付属しています。マルチテナンシーやデータ管理を目的として、手動でさらにパーティションを追加できます。追加のパーティションを作成しない場合、コレクションに挿入されたすべてのデータはデフォルトパーティションに入ります。詳細については、パーティションの管理 を参照してください。
パーティションキー: パーティションキーは、パーティションに基づく検索最適化ソリューションです。主キー以外の INT64 または VARCHAR フィールドをパーティションキーとして指定すると、Zilliz Cloud によって 16 個のパーティションが自動的に作成され、挿入されたすべてのエンティティは、そのパーティションキーの値に基づいてこれら 16 個の自動生成されたパーティションに入ります。コレクションでパーティションキーを有効にすると、このコレクションで手動でパーティションを作成できなくなります。詳細については、パーティションキーを使用する を参照してください。
パーティションを作成する必要があるか、パーティションキーを使用する必要があるかを判断するには、次の要素を考慮してください。
-
マルチテナンシー戦略: 数百万のテナントをサポートする必要がある場合は、パーティションキーを使用してください。テナント間で強力な物理データ分離が必要な場合は、パーティションを使用してください。詳細については、マルチテナンシーの実装 を参照してください。
-
リソース管理: パーティションを自分で作成および管理する場合は、パーティションを使用できます。パーティションの自動作成および管理が必要な場合は、パーティションキーを使用してください。
-
ホットデータとコールドデータの管理: ホットデータとコールドデータを効率的に処理する必要がある場合は、パーティションキーを使用してください。Dedicated クラスターでホットデータとコールドデータの管理にパーティションキーを使用するには、お問い合わせください。
mmap
メモリマッピング(mmap)は、ディスク上の大きなファイルをメモリにロードせずに直接アクセスできるようにするメモリ使用量の最適化です。mmap を有効にすると、同じ CU サイズ仕様でより多くのデータを保存できます。以下に示すように、mmap は CU タイプとプランに基づく推奨のデフォルト値で構成されます。
-
extended-capacity CU タイプを使用する Free、Serverless、Dedicated クラスターでは、mmap がデフォルトで有効になっています。この設定は固定されており変更できないため、コレクションの作成時に mmap 設定のオプションが表示されない場合があります。
-
performance-optimized CU タイプを使用する Dedicated クラスターでは、mmap がデフォルトで無効になっています。
-
capacity-optimized CU タイプを使用する Dedicated クラスターでは、mmap がデフォルトで有効になっています。
クラスターレベルのデフォルト mmap 設定の詳細については、mmap を使用する を参照してください。
コレクションの作成時に、ユースケースに応じて コレクション レベルまたは フィールド レベルで mmap 設定を任意に構成できます。下位レベルの設定は上位レベルよりも優先されます:フィールド > コレクション > クラスター。
-
コレクションレベルの mmap: コレクション全体の生データに対して mmap を有効にします。この設定は後から変更できますが、その前にコレクションをリリースする必要があります。
-
フィールドレベルの mmap: カスタム設定により、選択したフィールドの生データとスカラーインデックスに対して mmap を有効にします。一般に、データサイズが大きく、フィルターやクエリで頻繁に使用されないフィールドに対して mmap を有効にすることが推奨されます。この設定は選択したフィールドにのみ適用され、後から変更できます。フィールドレベルの mmap 設定を変更するには、先にコレクションをリリースする必要があります。
mmap 設定には注意してください。デフォルトの mmap 設定を変更すると、メモリ不足(OOM)によるパフォーマンス低下やロード失敗が発生する可能性があります。ベストプラクティスについては、mmap を使用する を参照してください。
以下のデモでは、Zilliz Cloud Web コンソール上でこの機能の入口を示しています。
シャード
シャードは、データ入力チャネルに対応するコレクションの水平スライスです。すべてのコレクションにはデフォルトで 1 つのシャードが付属しています。書き込みスループットを向上させるために、シャードを追加できます。
一般的なガイドラインとして、データ 1 億行ごとに 1 つのシャードを追加することを検討してください。許可されるシャードの最大数は、クラスタープランとクラスターの CU サイズによって異なります。詳細については、Zilliz Cloud の制限 を参照してください。
シャード数は、コレクションの作成後、コレクションの複製 機能を使用して編集できます。
全文検索
Zilliz Cloud コンソールでは、全文検索で使用する関数とアナライザーを構成できます。全文検索の詳細については、フルテキスト検索 を参照してください。
以下のデモでは、Zilliz Cloud Web コンソール上でこの機能の入口を示しています。
テキストマッチ
Zilliz Cloud コンソールでは、テキストマッチ用のフィールドとアナライザーを構成することもできます。テキストマッチの詳細については、テキストマッチ を参照してください。
以下のデモでは、Zilliz Cloud Web コンソール上でこの機能の入口を示しています。
コレクションの管理
Zilliz Cloud では、Web コンソールを通じて、作成済みのコレクションに対して次の管理操作を実行できます。
-
コレクションの名前変更: 既存のコレクションの名前を変更できます。
-
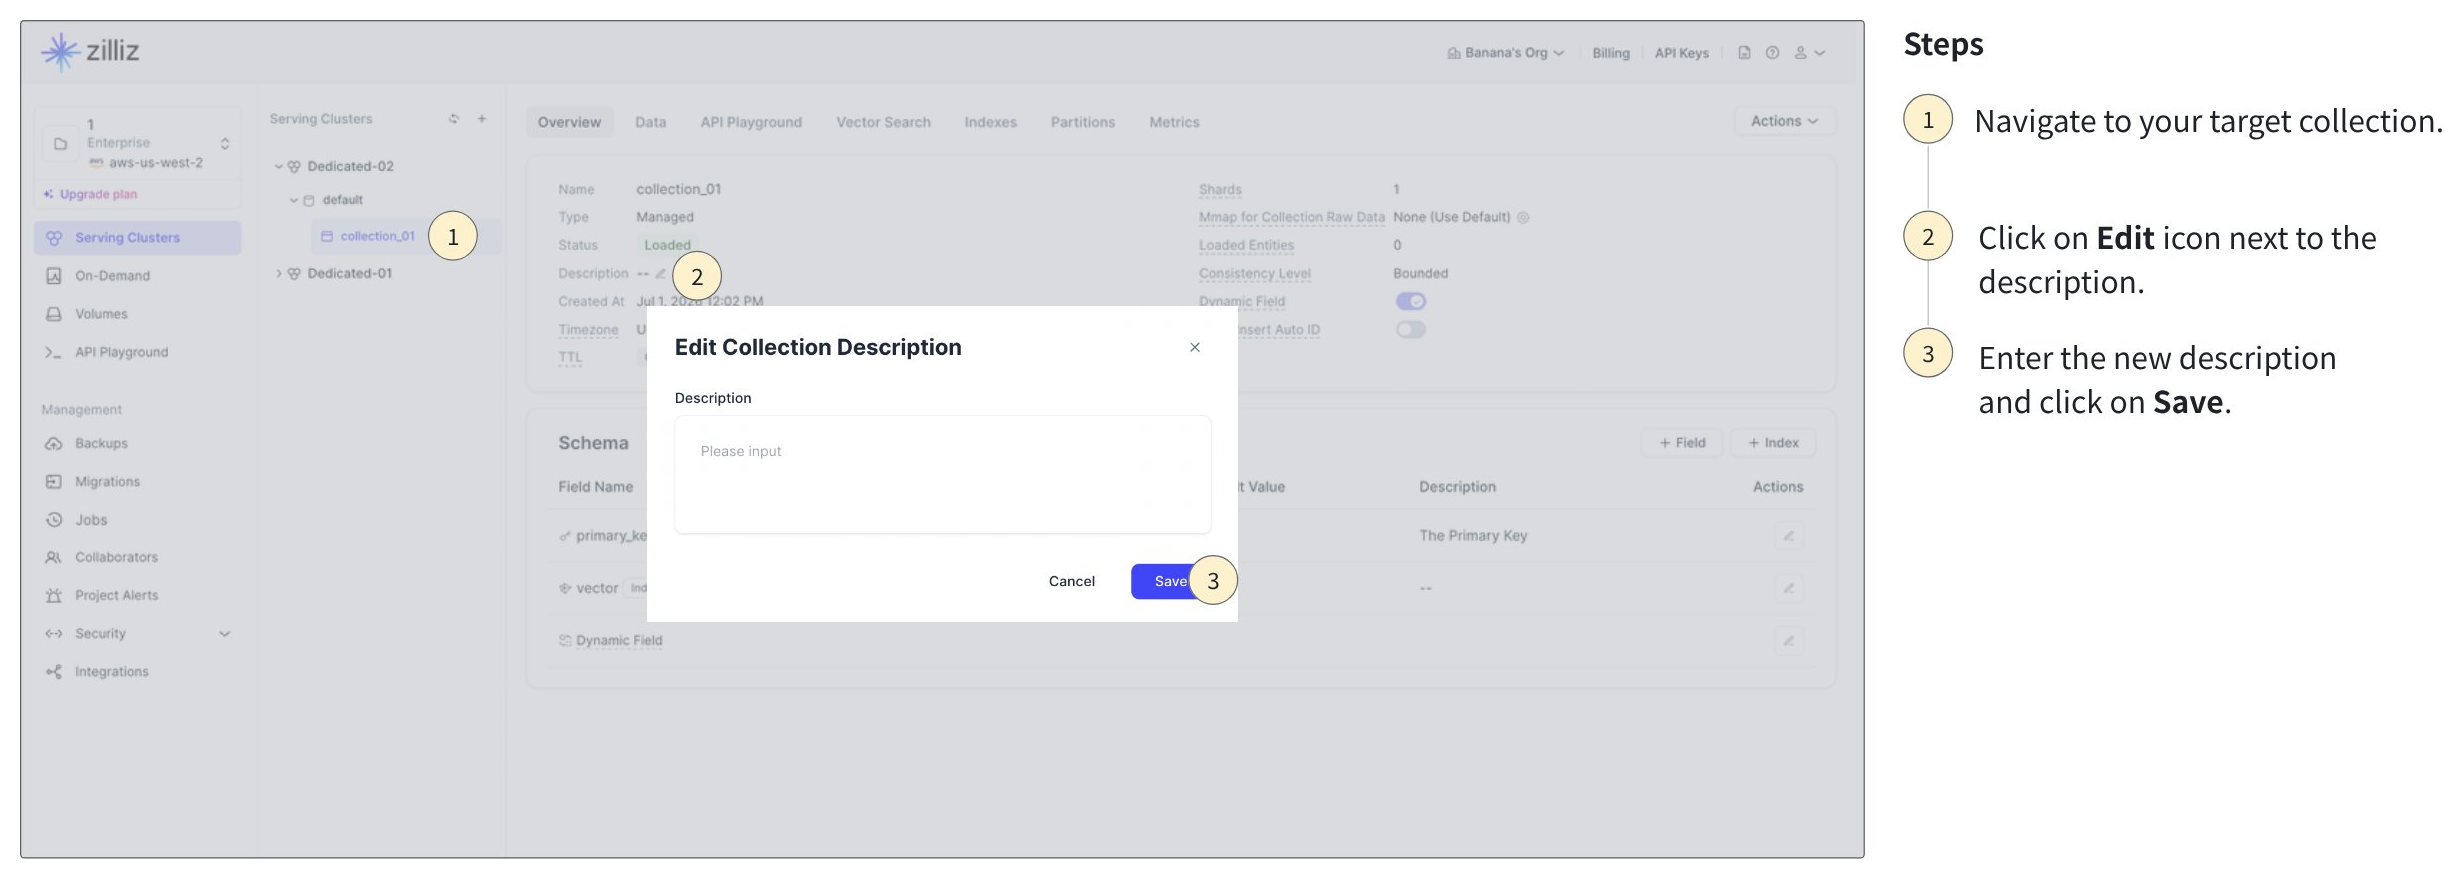
コレクションの説明の編集: 既存のコレクションの説明を変更できます。
-
コレクションのスキーマと設定の編集: 現時点では、Zilliz Cloud は次のスキーマと設定の編集のみをサポートしています。
-
既存の VarChar フィールド の
max_length値を編集できます。 -
既存の Array フィールド の
max_capacity値と、ARRAY 型が VARCHAR の場合はmax_length値も編集できます。 -
新しいスカラーフィールドを既存のスキーマに追加できます。
-
シャード設定を変更するには、代わりにコレクションの複製機能を使用してください。
-
mmap または パーティションキー設定を変更するには、代わりに SDK を使用してください。詳細については、コレクションの変更 を参照してください。
-
コレクションの作成時に動的フィールドを有効にしていなかった場合は、後から SDK または Web コンソールを使用して有効にできます。SDK の詳細については、コレクションの変更 を参照してください。Web コンソールで動的フィールドを有効にする方法の詳細については、上のデモを参照してください。
その他のコレクションスキーマ設定は編集できません。変更を適用するには、目的の構成で新しいコレクションを作成し、そのコレクションにデータをインポートしてください。
-
-
コレクションのロードとリリース: Zilliz Cloud Web コンソールでは、コレクションは作成直後に自動的にメモリにロードされ、検索およびクエリに使用できるようになります。メモリ領域を解放するために、未使用のコレクションをリリースできます。Zilliz Cloud Web コンソールは、単一のコレクションのロードまたはリリース、あるいは複数のコレクションの一括ロードまたはリリースをサポートしています。
-
コレクションを別のデータベースに移動: 関連するコレクションを同じデータベース内にグループ化し、必要に応じてデータベース間でコレクションを移動できます。
-
コレクション内のパーティションの管理: パーティションキーが有効なコレクションでは、パーティションを手動で管理する必要はありません。パーティションキーが無効なコレクションでは、パーティションを手動で管理し、次の操作を実行できます。
-
パーティションの作成: 各コレクションには最大 1,024 個のパーティションを作成できます。詳細については、Zilliz Cloud の制限 を参照してください。
-
パーティションの削除: デフォルトパーティションは削除できず、パーティションを削除するとその中のすべてのデータが復元できない形で削除されます。コレクション内のパーティションを削除する前に、先にコレクションをリリースする必要があります。
-
-
コレクションエイリアスの表示: コレクション一覧ページで、クラスター内のすべてのコレクションのエイリアスを表示できます。
-
コレクションのタイムゾーンの編集: コレクションのタイムゾーンは、このコレクション内のすべての TIMESTAMPTZ エンティティのタイムゾーンを定義します。デフォルトでは UTC が使用されますが、アプリケーションのニーズに合わせて別のタイムゾーンを選択できます。
-
コレクション TTL の編集: Time-to-live(TTL)は、コレクション内のデータの有効期限を決定するコレクションのプロパティです。詳細については、コレクション TTL の設定 を参照してください。
-
Allow Insert Auto ID の有効化:
allow_insert_auto_idプロパティを使用すると、AutoID が有効なコレクションが、insert、upsert、および一括インポート時にユーザー指定の主キー値を受け入れることができます。詳細については、コレクションの変更 を参照してください。 -
コレクションの削除: リソースのオーバーヘッドを削減するために、不要になったコレクションを削除できます。コレクションを削除すると、その中のすべてのデータが復元できない形で削除されます。
コレクションのデータをプレビューする
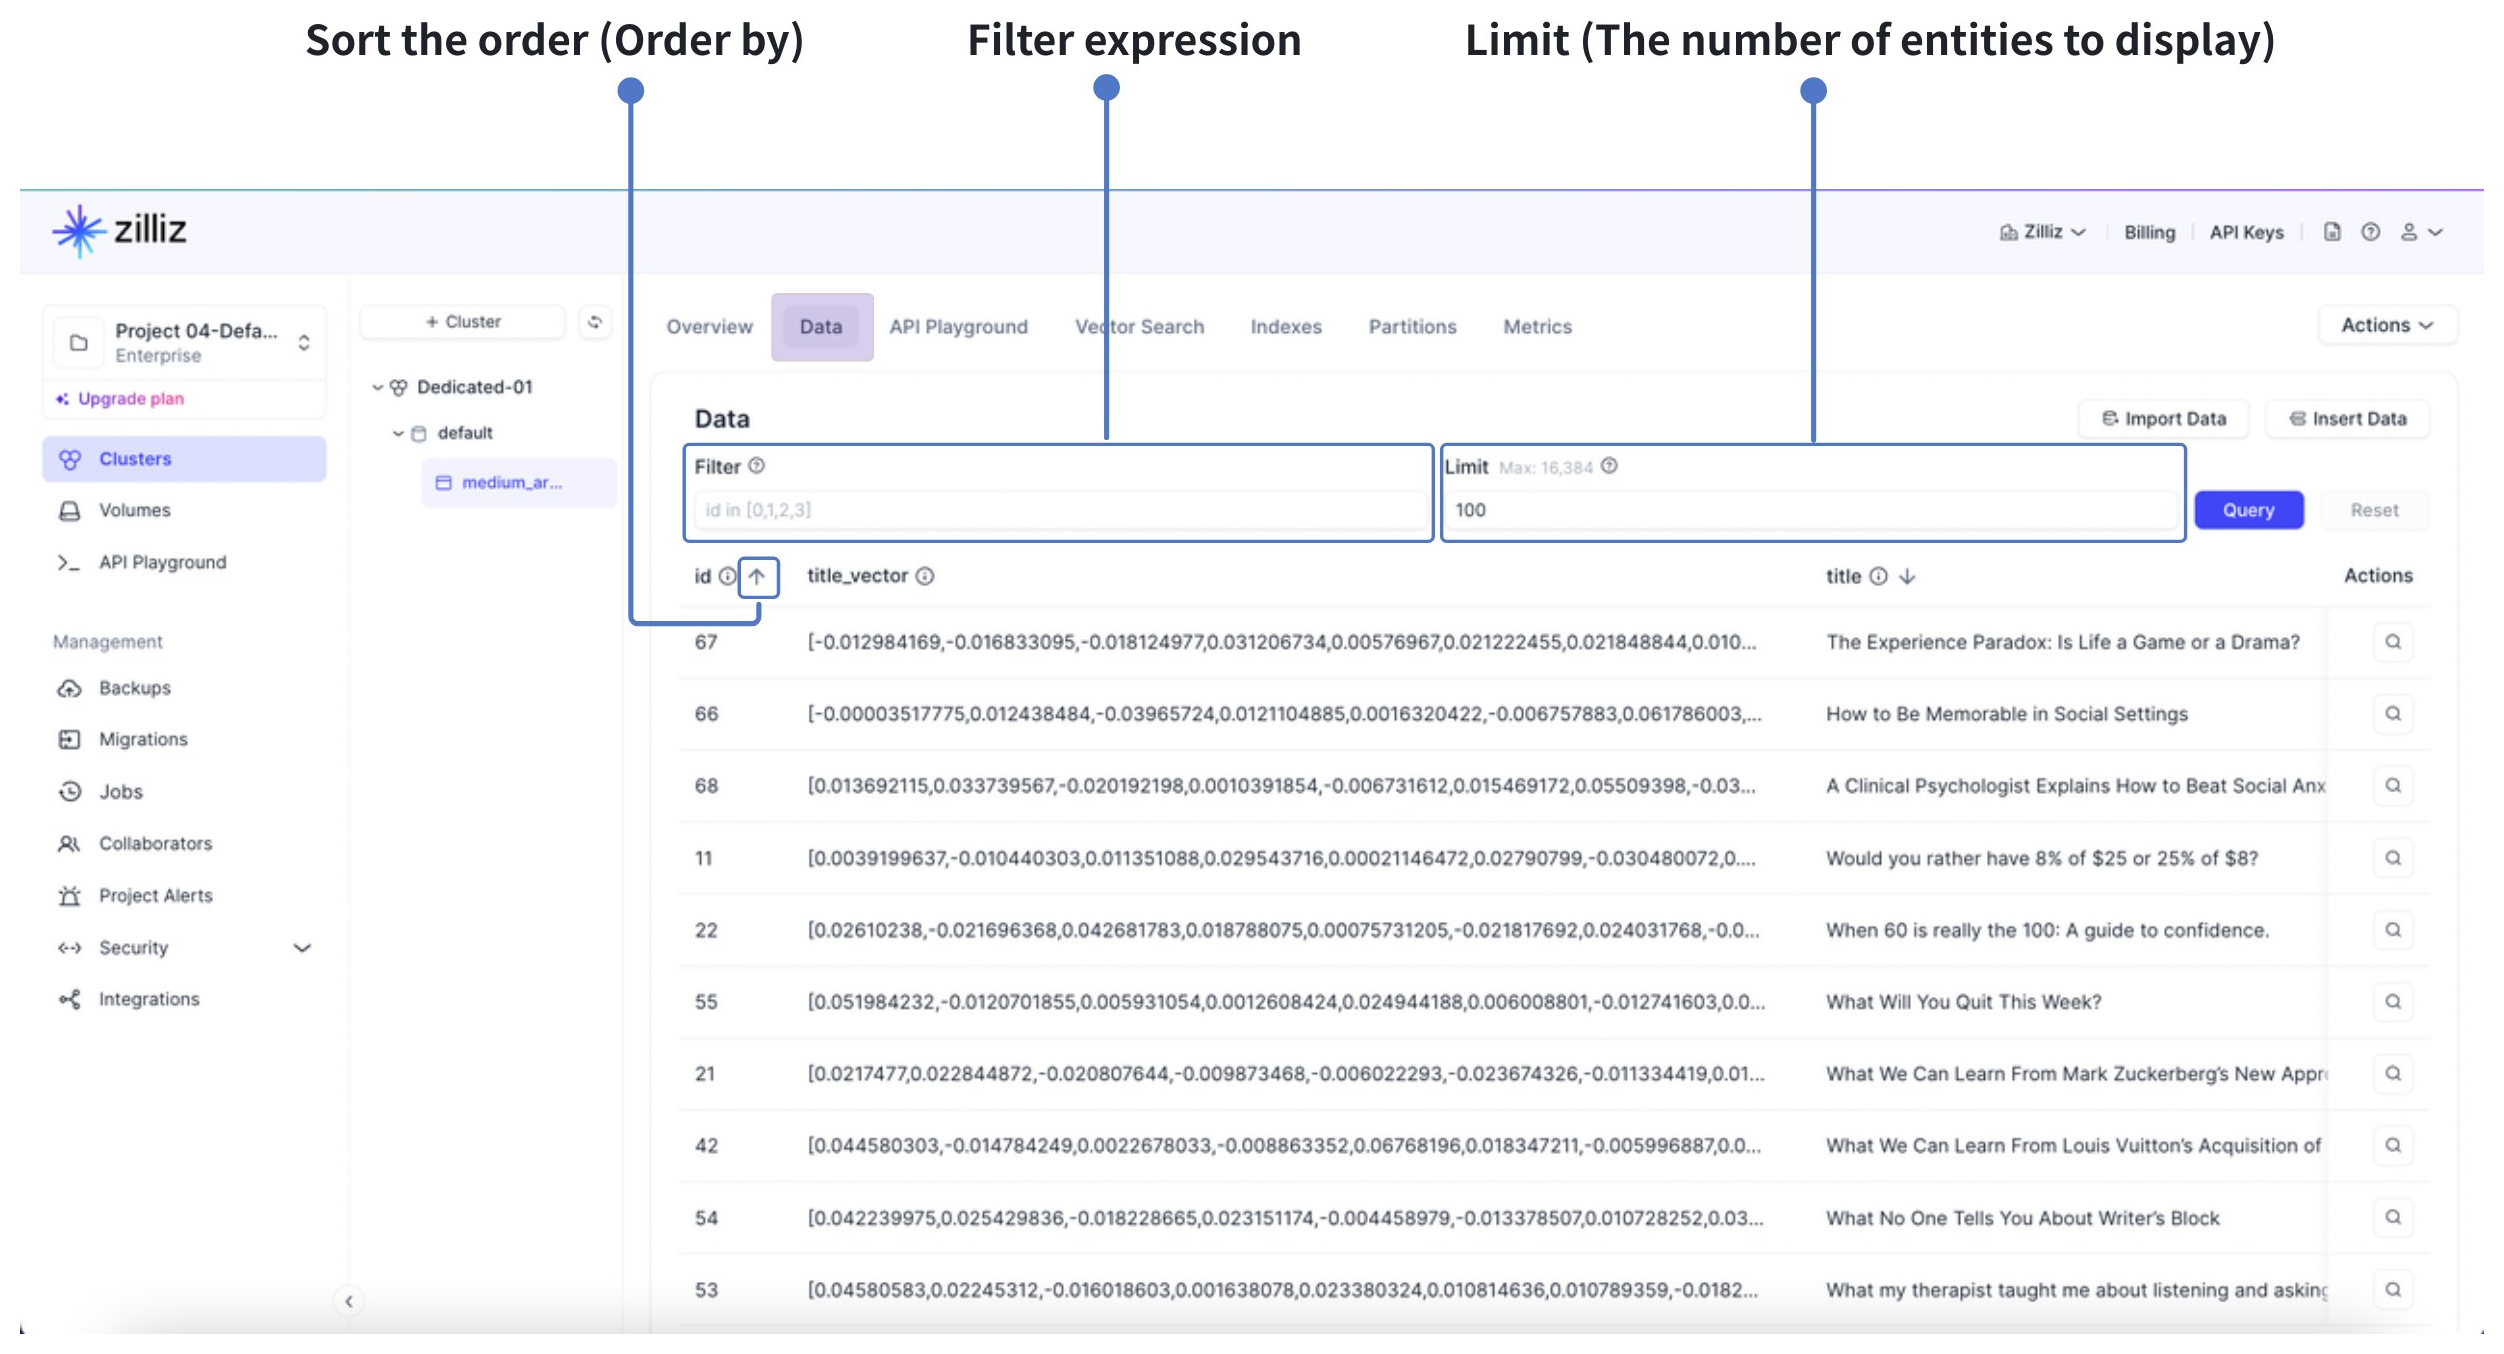
Data タブを使用すると、Zilliz Cloud コンソールからコレクション内のエンティティを直接プレビューできます。
フィルター式を定義し、limit パラメーターを構成してプレビューに表示されるエンティティ数を制御し(デフォルトでは 100、最大 16,384)、一致するエンティティをクエリして、テーブル内のフィールド値を確認できます。
また、Order By を使用すると、主キーフィールド、数値フィールド、またはスカラーフィールドを基準に、データプレビューを昇順または降順に並べ替えることもできます。