Spark バッチジョブの管理
この機能は AWS us-west-2 リージョンでのみ利用できます。Google Cloud および Microsoft Azure では利用できません。
Spark バッチジョブは非同期で実行され、送信から完了までの間に複数の状態を遷移します。このページでは、ジョブのライフサイクルについて説明したうえで、ジョブの一覧表示、ジョブの詳細の取得、およびキャンセル可能な状態にあるジョブをキャンセルする方法を説明します。
ジョブの状態を理解する
次の図は、ジョブのライフサイクルとキャンセルのフローを示しています。
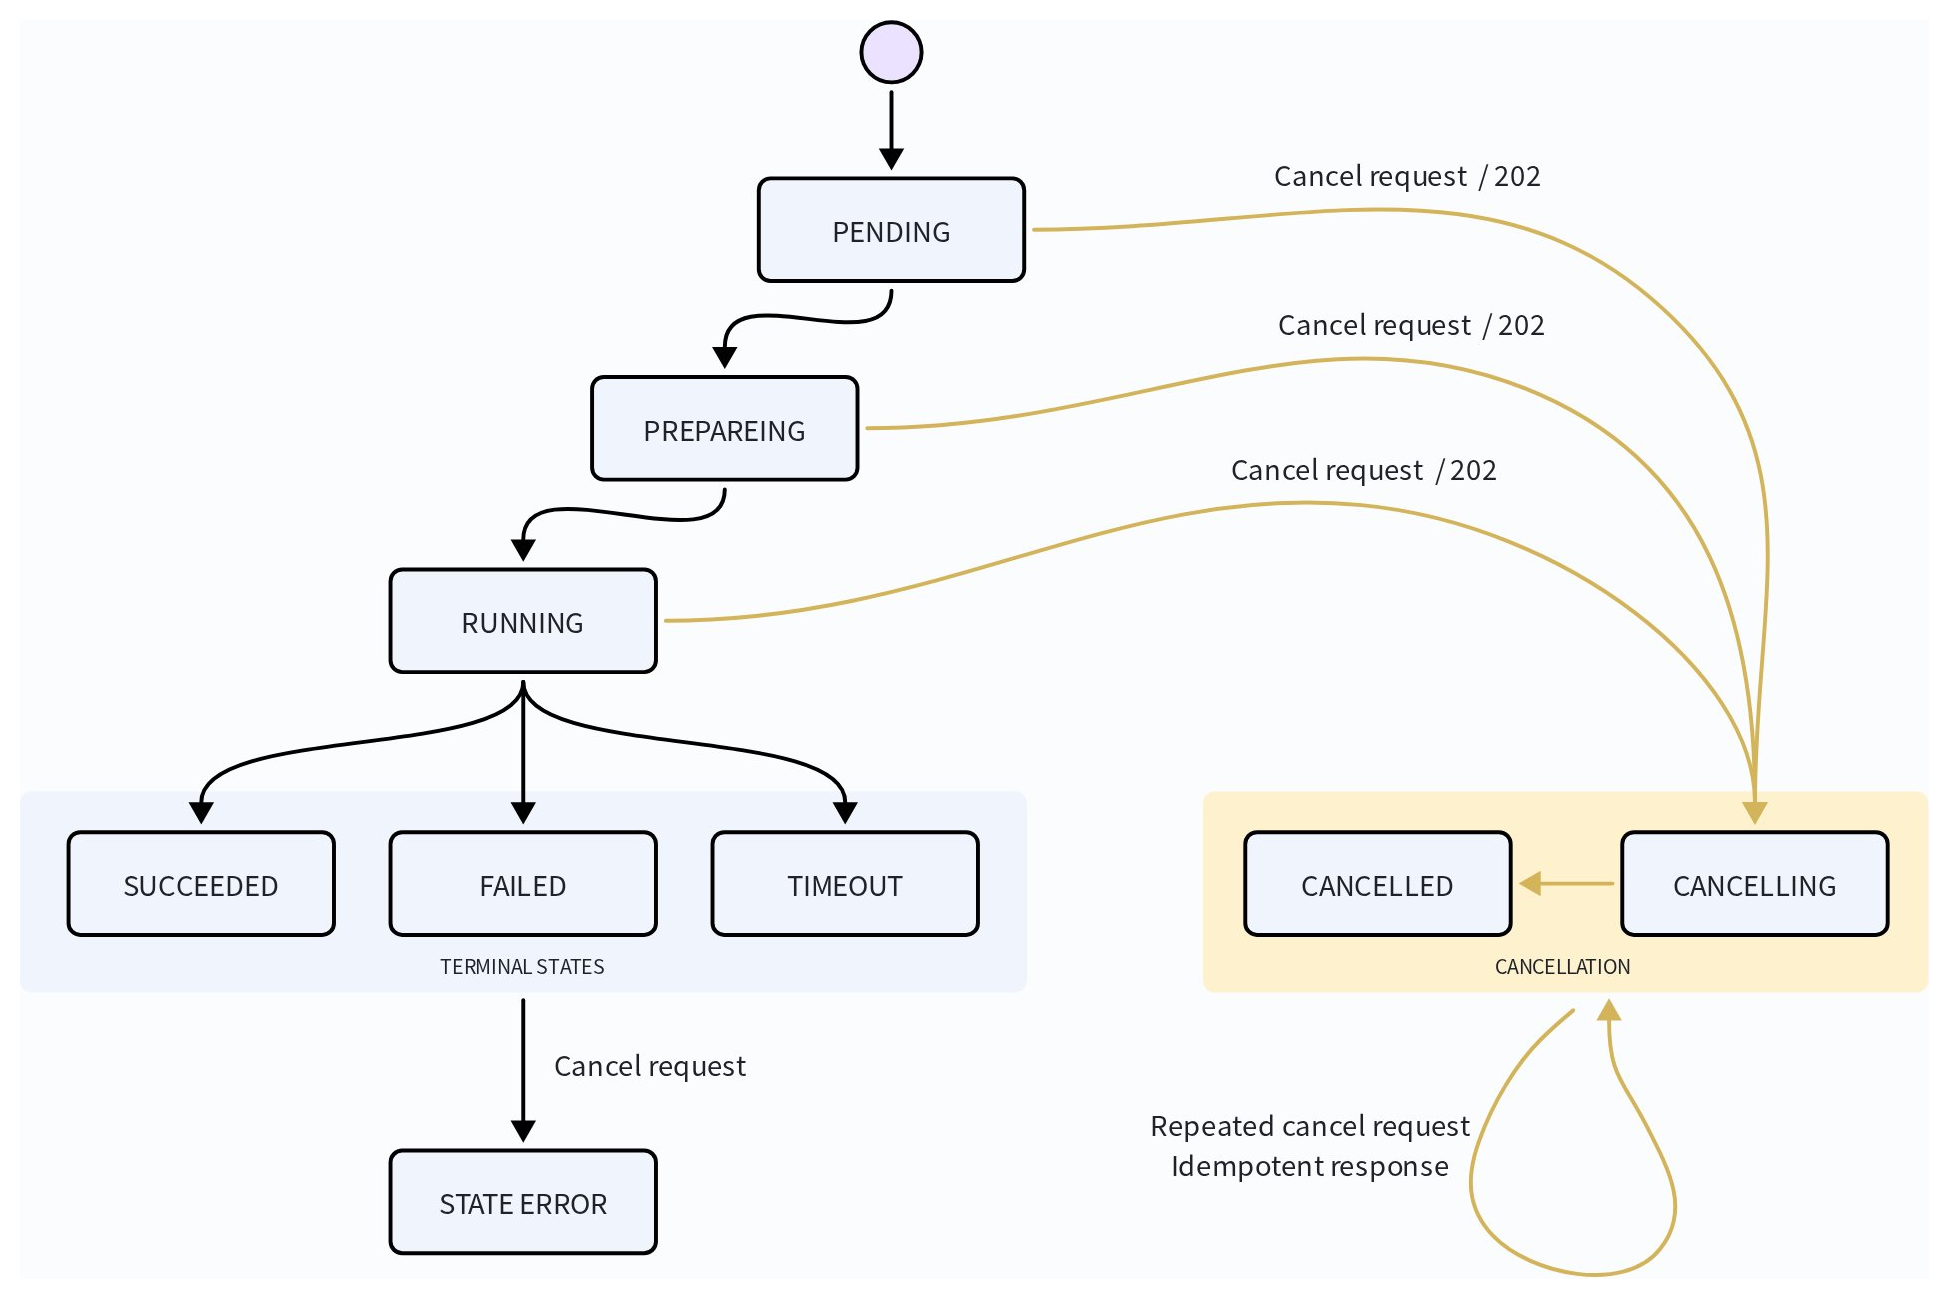
通常、ジョブは PENDING から PREPARING、次に RUNNING へと進み、最終状態に到達します。
PENDING、PREPARING、または RUNNING の状態にあるジョブはキャンセルリクエストを受け付けますが、SUCCEEDED、FAILED、または TIMEOUT に到達したジョブはキャンセルできません。すでにキャンセルフローにあるジョブに対する重複したキャンセルリクエストは、冪等に処理されます。
リージョン内の Spark バッチジョブを一覧表示する
特定のリージョン内の Spark バッチジョブを一覧表示すると、アクセス権限のあるプロジェクト全体で送信されたジョブを検索できます。リクエストにはリージョン ID と type=SPARK が必要です。オプションのフィルターを組み合わせて、状態、ジョブ名のプレフィックス、または作成時刻で結果を絞り込むことができます。
リクエストの例
次の例では、aws-us-west-2 内でアクセスできるすべてのプロジェクトにわたるすべての Spark バッチジョブを一覧表示します。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
curl --request GET \
--url "https://api.cloud.zilliz.com/v2/jobs?type=SPARK®ionId=aws-us-west-2" \
--header "Authorization: Bearer ${API_KEY}"
結果を絞り込むには、1 つ以上のオプションのフィルターを追加します。次の例では、aws-us-west-2 内で名前が pk-dedup で始まる 実行中 の Spark バッチジョブを一覧表示します。1 ページあたり最大 50 件のジョブを返します。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request GET \
  --url "https://api.cloud.zilliz.com/v2/jobs" \
  --get \
  --data-urlencode "type=SPARK" \
  --data-urlencode "regionId=aws-us-west-2" \
  --data-urlencode "status=RUNNING" \
  --data-urlencode "pageSize=50" \
  --header "Authorization: Bearer ${API_KEY}"
結果をフィルタリングする
次の表に、ジョブ一覧リクエストに適用できるフィルターを示します。
| パラメーター | 必須 | 説明 |
|---|---|---|
type | はい | ジョブの種類です。このパラメーターには SPARK を設定します。 |
regionId | はい | Spark バッチジョブを一覧表示するリージョンの ID です。 |
status | いいえ | PENDING、RUNNING、SUCCEEDED などの状態でジョブを絞り込みます。 |
createdAfter | いいえ | 2026-07-30T00:00:00Z など、指定した ISO 8601 タイムスタンプより後に作成されたジョブを返します。 |
createdBefore | いいえ | 指定した ISO 8601 タイムスタンプより前に作成されたジョブを返します。 |
pageSize | いいえ | 1 ページあたりに返すジョブの数です。デフォルトは 20 で、有効な範囲は 1 から 100 です。 |
pageToken | いいえ | 前回のレスポンスで nextPageToken として返されたページネーショントークンです。 |
オプションのフィルターは、上記のリクエスト例に示すように、同じリクエスト内で組み合わせることができます。
結果をページネーションする
レスポンスに nextPageToken が含まれている場合は、その値を次のリクエストで pageToken として渡します。nextPageToken が存在しないか空になるまで続けます。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
export NEXT_PAGE_TOKEN="token-returned-by-the-previous-request"

curl --request GET \
  --url "https://api.cloud.zilliz.com/v2/jobs" \
  --get \
  --data-urlencode "type=SPARK" \
  --data-urlencode "regionId=aws-us-west-2" \
  --data-urlencode "pageSize=20" \
  --data-urlencode "pageToken=${NEXT_PAGE_TOKEN}" \
  --header "Authorization: Bearer ${API_KEY}"
レスポンスを理解する
成功したレスポンスは、一致するジョブの総数、現在のページのジョブ、およびさらに結果がある場合に次のページを取得するためのトークンを返します。
{
  "code": 0,
  "data": {
    "total": 2,
    "items": [
      {
        "jobId": "job-xxxxxxxx",
        "projectId": "proj-xxxxxxxx",
        "type": "SPARK",
        "description": "backfill product attributes",
        "status": "RUNNING",
        "regionId": "aws-us-west-2",
        "clusterId": "in-xxxxxxxx",
        "createdAt": "2026-08-21T02:00:00Z",
        "startedAt": "2026-08-21T02:01:00Z",
        "finishedAt": null,
        "durationSeconds": null
      }
    ],
    "nextPageToken": "opaque-token"
  }
}
レスポンスには以下が含まれます。
-
total: リクエストのフィルターに一致するジョブの総数です。 -
items: 現在のページで返された Spark バッチジョブです。 -
nextPageToken: 次のページを取得するために使用するトークンです。これ以上結果がない場合、このフィールドは存在しないか空になります。
レスポンス内のパラメーターの詳細については、リファレンスページ List Spark batch jobs を参照してください。
プロジェクト内の Spark バッチジョブの詳細を表示する
ジョブ ID と、そのジョブが送信されたプロジェクトのプロジェクト ID を指定することで、Spark バッチジョブの詳細を取得できます。
リクエストの例
export PROJECT_ID="proj-xxxxxxxxxxxxxxxxxxxxxxx"
export JOB_ID="job-xxxxxxxxxxxxxxxxxxxxxxx"
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request GET \
  --url "https://api.cloud.zilliz.com/v2/projects/${PROJECT_ID}/jobs/${JOB_ID}" \
  --header "Authorization: Bearer ${API_KEY}"
レスポンスを理解する
次の例は、失敗した K-Means クラスタリングジョブに対する成功した API レスポンスを示しています。
{
  "code": 0,
  "data": {
    "jobId": "job-xxxxxxxx",
    "projectId": "proj-xxxxxxxx",
    "type": "SPARK",
    "description": "backfill product attributes",
    "status": "FAILED",
    "regionId": "aws-us-west-2",
    "clusterId": "in-xxxxxxxx",
    "artifact": null,
    "details": {
      "dbName": "default",
      "collectionName": "products",
      "input": {
        "type": "volume",
        "volumeName": "product-data",
        "path": "backfill/products.parquet",
        "format": "parquet"
      },
      "fields": ["title", "price", "embedding"],
      "columnMapping": {
        "source_id": "id",
        "source_title": "title",
        "source_price": "price",
        "source_embedding": "embedding"
      },
      "mode": "coalesce",
      "resourceSize": "SMALL"
    },
    "precheckReport": null,
    "failureReason": {
      "code": "SPARK_EXECUTION_FAILED",
      "message": "The Spark job failed.",
      "retryable": false
    },
    "createdAt": "2026-08-21T02:00:00Z",
    "submittedAt": "2026-08-21T02:00:30Z",
    "startedAt": "2026-08-21T02:01:00Z",
    "finishedAt": "2026-08-21T02:10:00Z",
    "durationSeconds": 540
  }
}
レスポンスには以下が含まれます。
-
ジョブの状態と識別情報:
jobId、jobName、status、regionId、および Spark アプリケーションの識別子です。 -
診断情報:
failureReason、Spark 履歴のリンク、および利用可能な場合はドライバーログの URI です。 -
出力コントラクト: オペレーター、出力形式、書き込みモード、入力列が保持されるかどうか、およびジョブによって生成される列です。
-
タイミング情報: ジョブの作成、キューイング、送信、実行、完了のタイムスタンプです。
ジョブが失敗した場合は、まず failureReason を確認し、その後、より詳細なトラブルシューティングを行うために Spark 履歴またはドライバーログのリンクを使用します。
出力コントラクトを理解する
次の表に、outputContract エンベロープ内のフィールドを示します。
| フィールド | 説明 |
|---|---|
operator | Spark バッチジョブによって実行される組み込みオペレーターです。たとえば、kmeans、pk_deduplicate、vector_deduplicate、anomaly_detection などです。 |
outputFormat | 生成される出力の実際の形式です。通常は、ジョブリクエスト内の output.format と一致します。 |
writeMode | 設定された出力パスがすでに存在する場合に使用される動作です。 |
preservesInputColumns | 出力に入力データセットの元の列が保持されるかどうかを示します。 |
generatedColumns | ジョブによって追加される列です。たとえば、K-Means クラスタリングの場合は cluster_id、異常検知の場合は outlier_score です。 |
たとえば、preservesInputColumns が true に設定され、generatedColumns に cluster_id が含まれる K-Means ジョブは、元のデータセットにクラスター割り当て列を追加したものを生成します。
Spark バッチジョブをキャンセルする
PENDING、PREPARING、または RUNNING の状態にあるジョブに対しては、キャンセルリクエストを送信できます。
リクエストの例
export PROJECT_ID="proj-xxxxxxxxxxxxxxxxxxxxxxx"
export JOB_ID="job-xxxxxxxxxxxxxxxxxxxxxxx"
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request POST \
  --url "https://api.cloud.zilliz.com/v2/projects/${PROJECT_ID}/jobs/${JOB_ID}/cancel" \
  --header "Authorization: Bearer ${API_KEY}"
キャンセルリクエストの動作を理解する
キャンセルの動作は、ジョブの現在の状態によって異なります。非終端状態にあるジョブはキャンセルリクエストを受け付けます。次の表に、ジョブの状態と、これらの状態でキャンセルリクエストを受信したときに対応する動作を示します。
| 現在の状態 | キャンセルリクエストの動作 |
|---|---|
PENDING, PREPARING, RUNNING | 202 Accepted を返し、ジョブをキャンセルフローに移行します。 |
CANCELLING | 既存のキャンセル処理を継続します。 |
CANCELED | 新たなキャンセル操作を開始せずに、現在のジョブを返します。 |
SUCCEEDED, FAILED, TIMEOUT | 状態エラーでリクエストを拒否します。 |