NGRAM
Zilliz Cloud の NGRAM インデックスは、VARCHAR フィールドまたは JSON フィールド内の特定の JSON パスに対する LIKE クエリと対象となる正規表現フィルターを高速化します。インデックスを構築する前に、Zilliz Cloud はテキストを固定長 n の短い重複部分文字列(n-gram)に分割します。たとえば、n = 3 の場合、単語 "Milvus" は 3-gram の "Mil"、"ilv"、"lvu"、"vus" に分割されます。これらの n-gram は、各 gram をそれが出現するドキュメント ID にマッピングする転置インデックスに格納されます。クエリ実行時、このインデックスにより、Zilliz Cloud は元のフィルター条件を検証する前に検索対象を少数の候補にすばやく絞り込めます。
高速なプレフィックス、サフィックス、インフィックス、ワイルドカード、または対象となる正規表現フィルタリングが必要な場合に使用します。たとえば、次のような場合です:
-
name LIKE "data%" -
title LIKE "%vector%" -
path LIKE "%json" -
message =~ "error.*timeout" -
url =~ "/api/v[0-9]+/users"
LIKE および正規表現フィルター式の構文の詳細については、Pattern Matching を参照してください。
仕組み
NGRAM の仕組みを確認するには展開してください
Zilliz Cloud は NGRAM インデックスを 2 段階のプロセスで実装しています:
-
インデックスを構築:取り込み時に各ドキュメントの n-gram を生成し、転置インデックスを構築します。
-
クエリを高速化:インデックスを使用して少数の候補セットに絞り込み、完全一致を検証します。
フェーズ 1: インデックスを構築する
データの取り込み中、Zilliz Cloud は次の 2 つの主要な手順で NGRAM インデックスを構築します:
-
テキストを n-gram に分解:Zilliz Cloud は対象フィールド内の各文字列に対して n のウィンドウをスライドさせ、重複する部分文字列(n-gram)を抽出します。これらの部分文字列の長さは、設定可能な範囲
[min_gram, max_gram]に収まります。-
min_gram:生成する最短の n-gram です。これは、インデックスの恩恵を受けられるクエリ部分文字列の最小長も定義します。 -
max_gram:生成する最長の n-gram です。クエリ実行時には、長いクエリ文字列を分割する際の最大ウィンドウサイズとしても使用されます。
たとえば、
min_gram=2とmax_gram=3の場合、文字列"AI database"は次のように分解されます: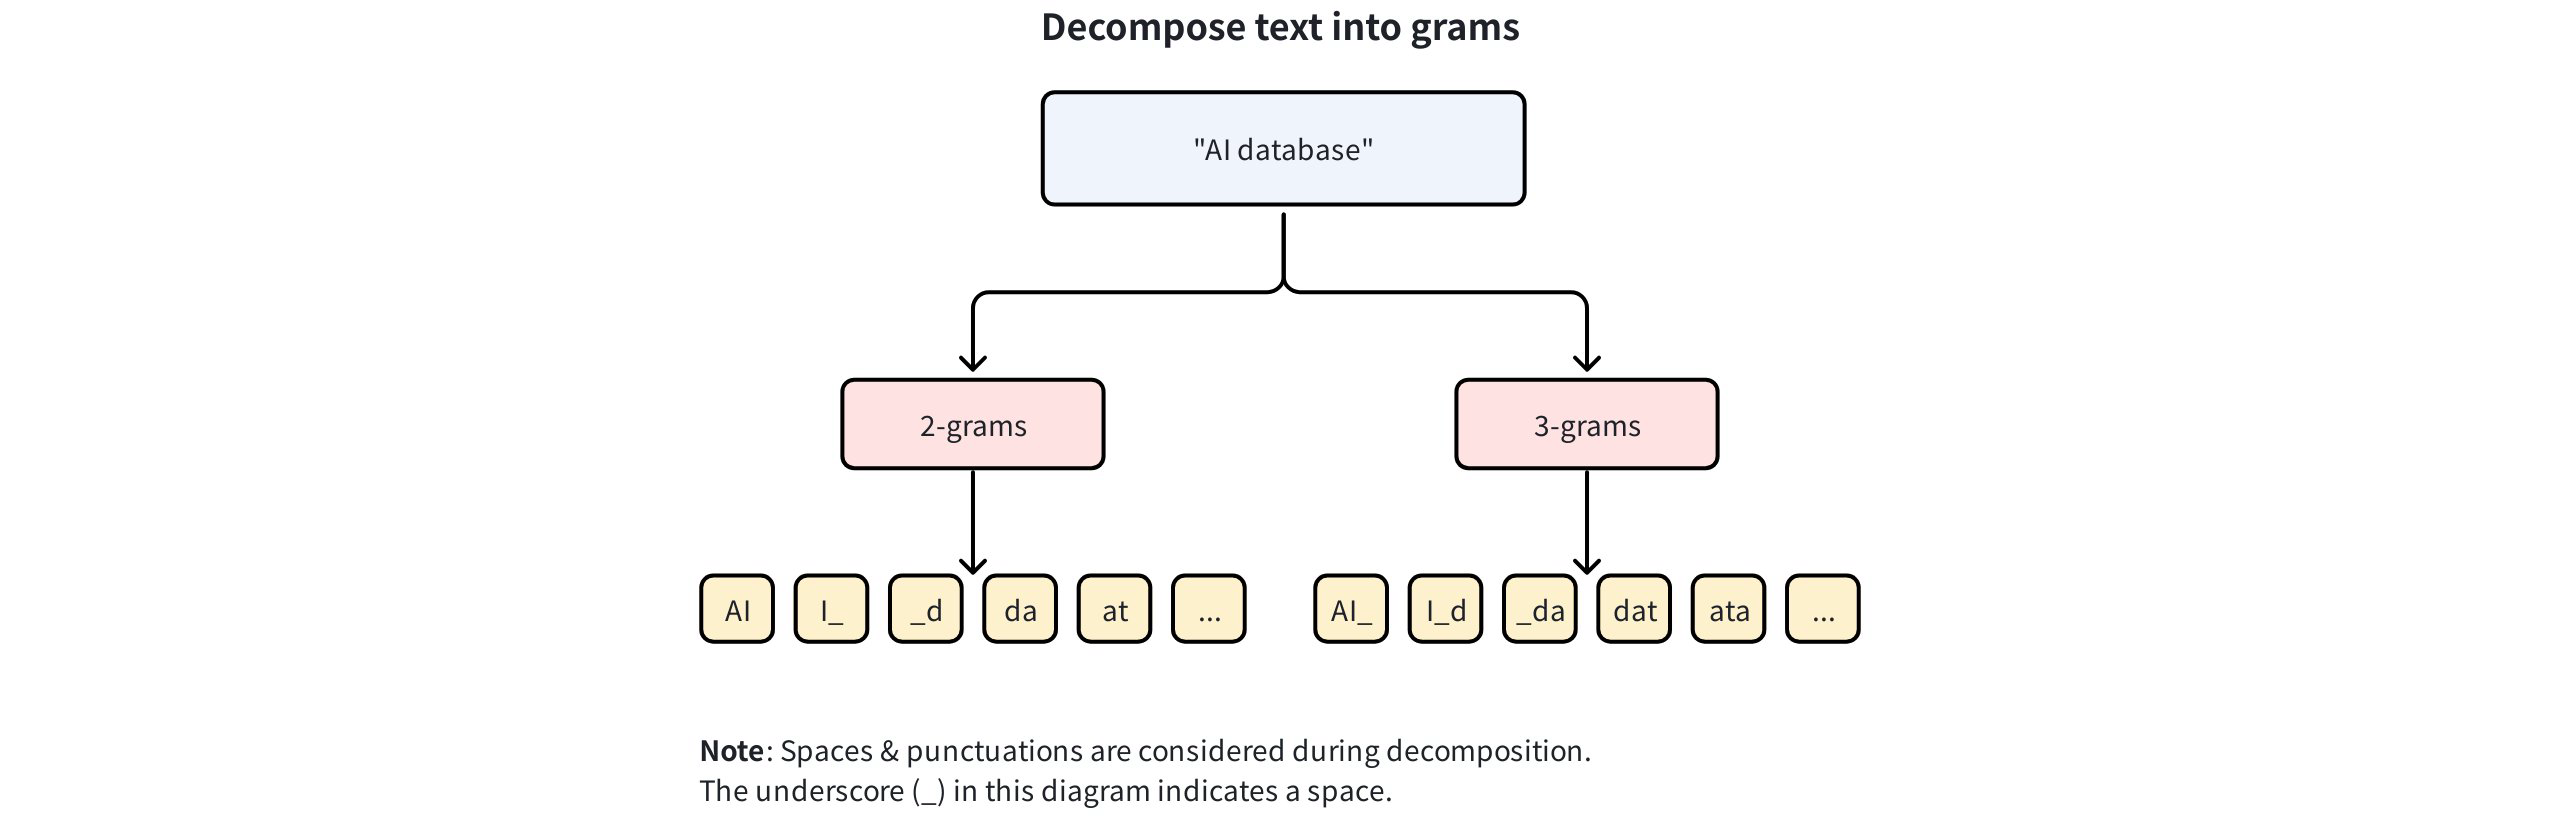
-
2-gram:
AI,I_,_d,da,at, ... -
3-gram:
AI_,I_d,_da,dat,ata, ...
📘Notes-
範囲
[min_gram, max_gram]の場合、Zilliz Cloud は 2 つの値の間(両端を含む)のすべての長さについて n-gram を生成します。たとえば、[2,4]と単語"text"の場合、Zilliz Cloud は次を生成します: -
2-gram:
te,ex,xt -
3-gram:
tex,ext -
4-gram:
text -
N-gram の分解は文字ベースで言語に依存しません。たとえば、中国語では、
min_gram = 2を指定した"向量数据库"は"向量"、"量数"、"数据"、"据库"に分解されます。 -
スペースと句読点は、分解時に文字として扱われます。
-
分解では元の大文字と小文字の区別が保持され、マッチングでは大文字と小文字が区別されます。たとえば、
"Database"と"database"は異なる n-gram を生成し、クエリ時に完全な大文字と小文字の一致が必要です。
-
-
転置インデックスを構築:生成された各 n-gram を、それを含むドキュメント ID のリストにマッピングする転置インデックスが作成されます。
たとえば、2-gram
"AI"が ID 1、5、6、8、9 のドキュメントに出現する場合、インデックスには{"AI": [1, 5, 6, 8, 9]}が記録されます。このインデックスは、クエリ実行時に検索範囲をすばやく絞り込むために使用されます。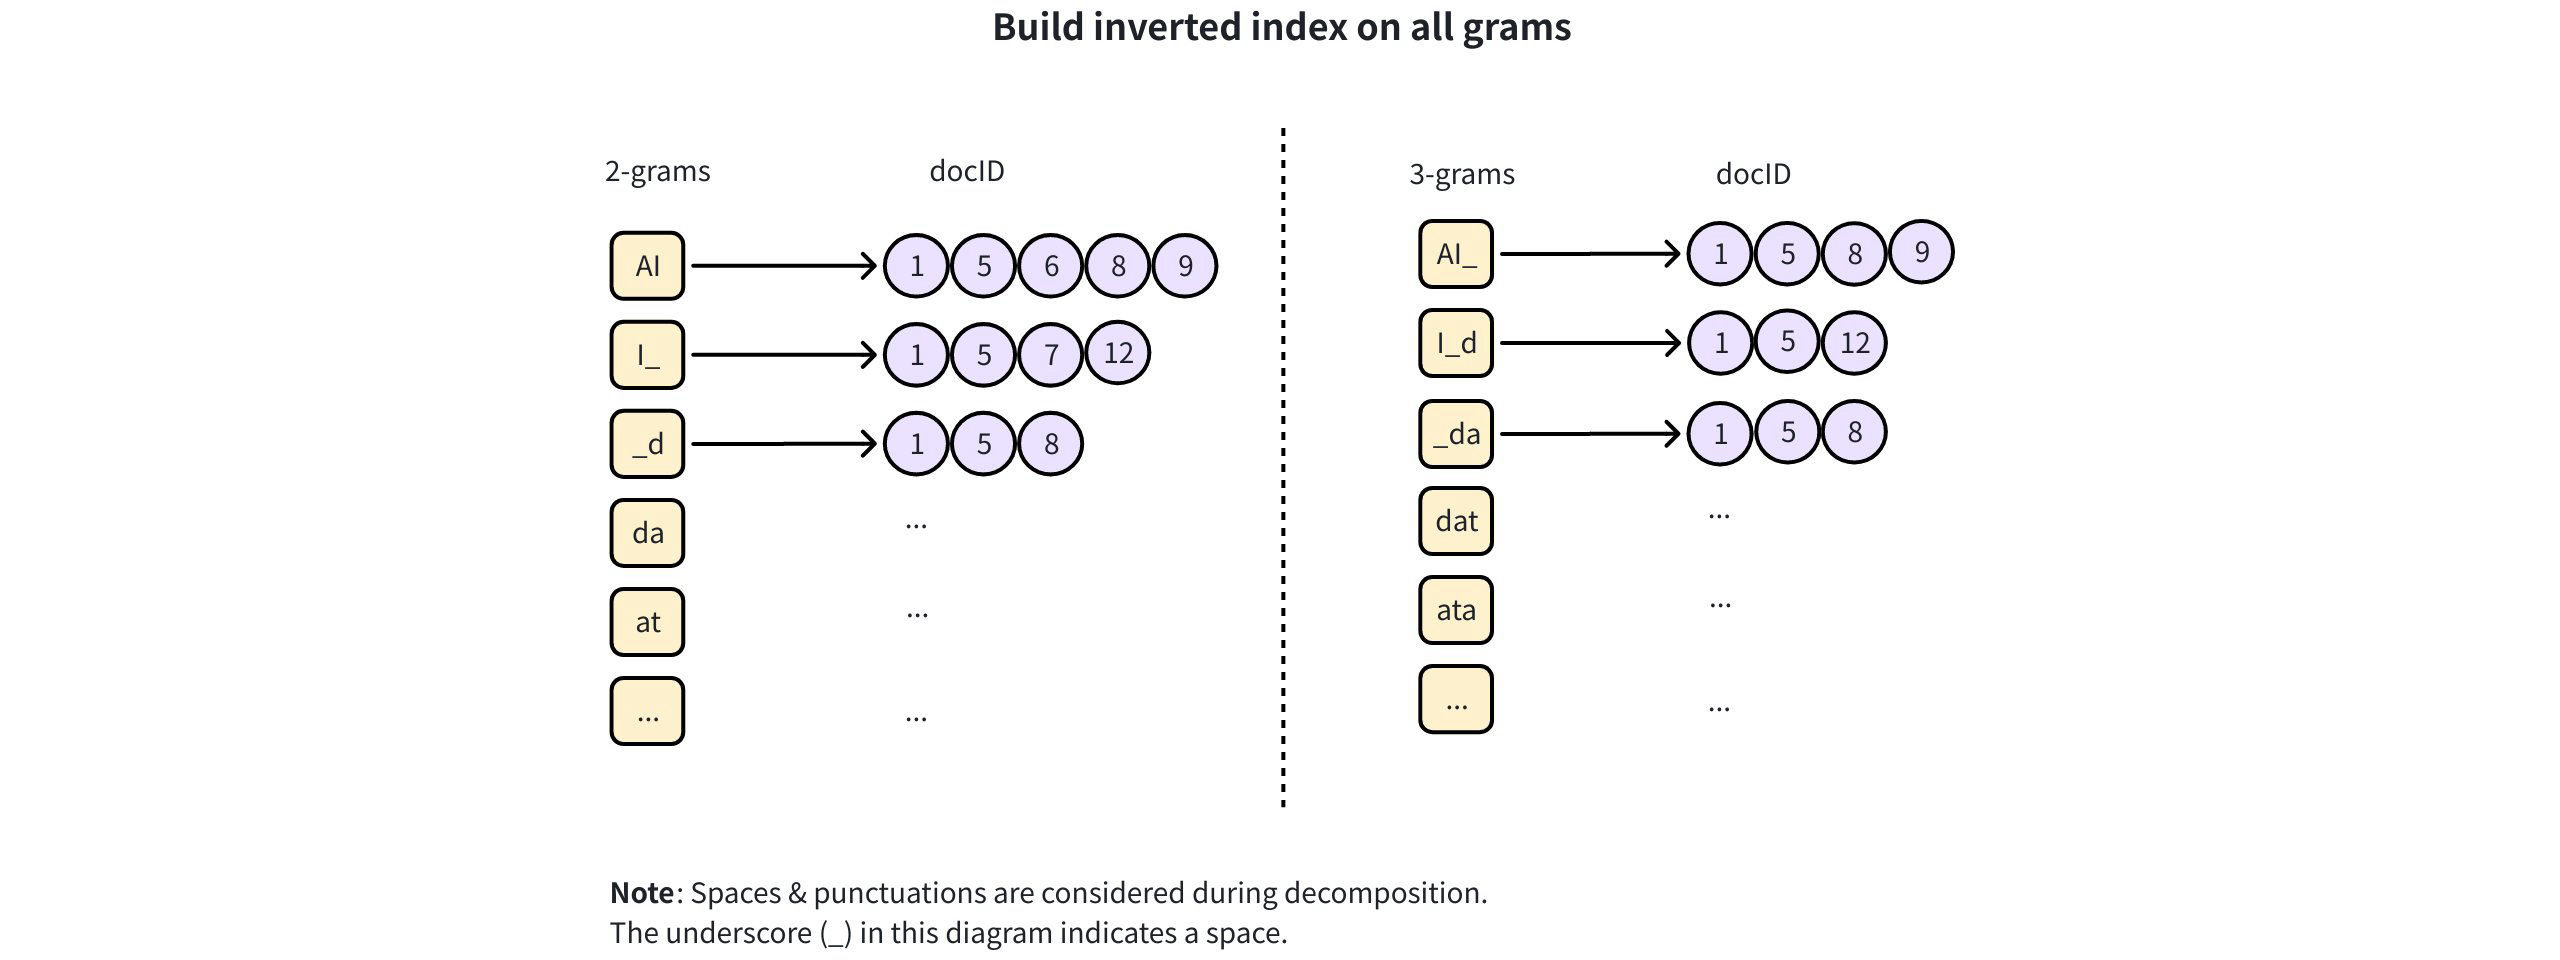 📘Notes
[min_gram, max_gram]の範囲を広げると、より多くの gram が生成され、マッピングリストが大きくなります。メモリが不足している場合は、非常に大きなポスティングリストには mmap モードの使用を検討してください。詳細については、Use mmap を参照してください。
フェーズ 2: クエリを高速化する
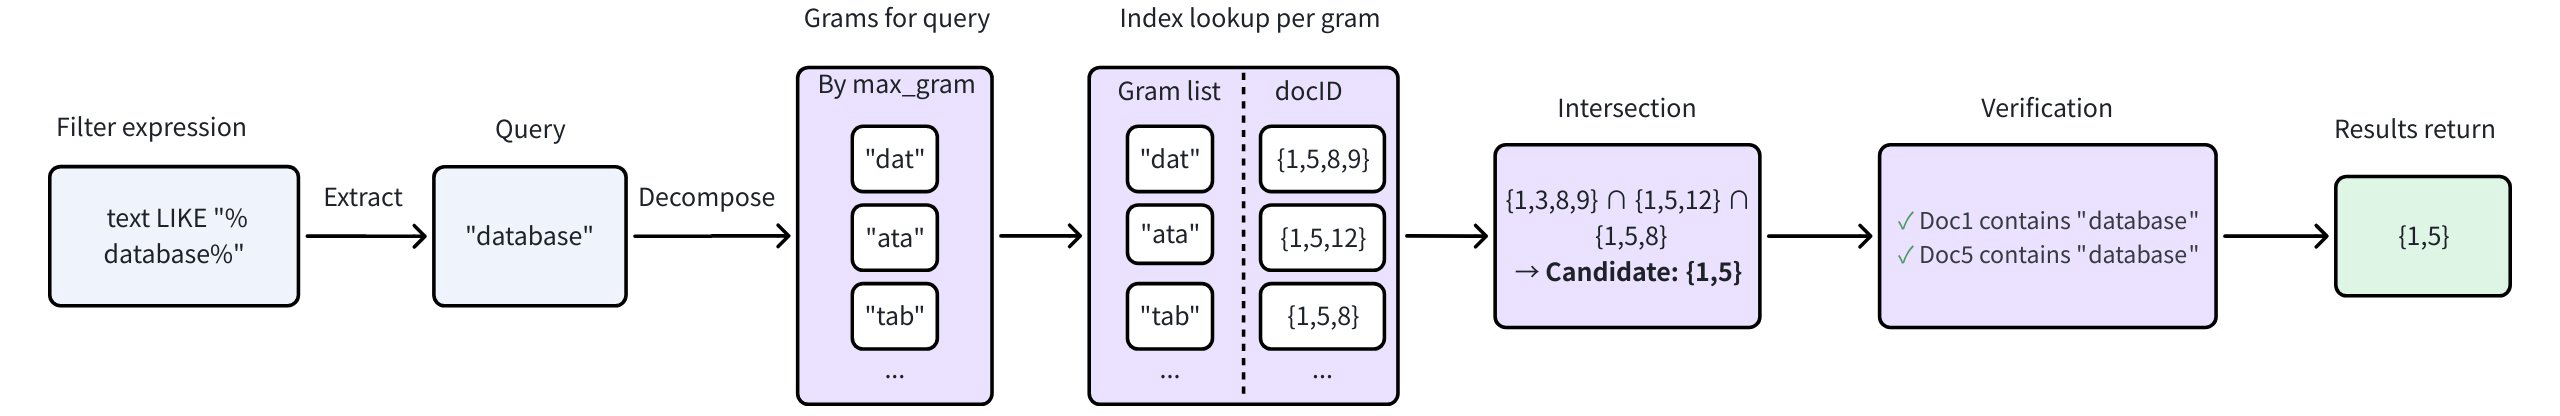
LIKE フィルターまたは対象となる正規表現フィルターが実行されると、Zilliz Cloud は次の手順で NGRAM インデックスを使用してクエリを高速化します:
-
クエリ用語を抽出:ワイルドカードを含まない連続した部分文字列を
LIKE式から抽出します(例:"%database%"は"database"になります)。正規表現フィルターの場合、Zilliz Cloud は可能な限り正規表現パターンから固定のリテラル部分文字列を抽出します。たとえば、message =~ "error.*timeout"にはリテラルerrorとtimeoutが含まれています。 -
クエリ用語を分解:クエリ用語は、その長さ(
L)とmin_gram、max_gramの設定に基づいて n-gram に分解されます。-
L < min_gramの場合、インデックスは使用できず、クエリはフルスキャンにフォールバックします。 -
min_gram ≤ L ≤ max_gramの場合、クエリ用語全体が 1 つの n-gram として扱われ、それ以上の分解は不要です。 -
L > max_gramの場合、クエリ用語はmax_gramに等しいウィンドウサイズを使用して、重複する gram に分割されます。
たとえば、
max_gramが3に設定され、クエリ用語が"database"(長さ 8)の場合、"dat"、"ata"、"tab"などの 3-gram 部分文字列に分解されます。 -
-
各 gram を検索して交差:Zilliz Cloud はクエリの各 gram を転置インデックスで検索し、得られたドキュメント ID リストを交差させて、少数の候補ドキュメントを特定します。これらの候補には、クエリのすべての gram が含まれています。
-
検証して結果を返す:最後に、元の
LIKEまたは正規表現フィルターを少数の候補セットのみに適用して最終確認を行い、完全一致を見つけます。
NGRAM インデックスを作成する
VARCHAR フィールド、または JSON フィールド内の特定のパスに NGRAM インデックスを作成できます。
例 1: VARCHAR フィールドに作成する
VARCHAR フィールドの場合は、field_name を指定し、min_gram と max_gram を設定するだけです。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT") # Replace with your server address

# Assume you have defined a VARCHAR field named "text" in your collection schema

# Prepare index parameters
index_params = client.prepare_index_params()

# Add NGRAM index on the "text" field
index_params.add_index(
    field_name="text",   # Target VARCHAR field
    index_type="NGRAM",           # Index type is NGRAM
    index_name="ngram_index",     # Custom name for the index
    min_gram=2,                   # Minimum substring length (e.g., 2-gram: "st")
    max_gram=3                    # Maximum substring length (e.g., 3-gram: "sta")
)

# Create the index on the collection
client.create_index(
    collection_name="Documents",
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.index.request.CreateIndexReq;
import java.util.Arrays;
import java.util.HashMap;
import java.util.Map;

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(connectConfig);

Map<String, Object> params = new HashMap<>();
params.put("min_gram", "2");
params.put("max_gram", "3");

client.createIndex(CreateIndexReq.builder()
        .collectionName("Documents")
        .indexParams(Arrays.asList(
                IndexParam.builder().fieldName("text").indexType(IndexParam.IndexType.NGRAM)
                        .indexName("ngram_index")
                        .extraParams(params)
                        .build()))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err)
}

_, err = cli.CreateIndex(ctx, milvusclient.NewCreateIndexOption("Documents", "text", index.NewNgramIndex(2, 3)).WithIndexName("ngram_index"))
if err != nil {
    fmt.Println(err)
}
use milvus::v2::prelude::*;
use std::collections::HashMap;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

let request = CreateIndexRequest::builder()
    .collection_name("Documents")
    .index_params(vec![IndexParam::new()
        .field_name("text")
        .index_name("ngram_index")
        .index_type(IndexType::Ngram)
        .extra_params(HashMap::from([
            ("min_gram".to_string(), "2".to_string()),
            ("max_gram".to_string(), "3".to_string()),
        ]))])
    .build()?;
client.create_index(request).await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

auto client = milvus::MilvusClientV2::Create();
auto status = client->Connect(milvus::ConnectParam("YOUR_CLUSTER_ENDPOINT").WithToken("YOUR_CLUSTER_TOKEN"));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::IndexDesc ngram_index("text", "ngram_index", milvus::IndexType::NGRAM);
ngram_index.AddExtraParam("min_gram", "2");
ngram_index.AddExtraParam("max_gram", "3");

milvus::CreateIndexRequest create_request;
create_request.WithCollectionName("Documents");
create_request.WithIndexes({ngram_index});
create_request.WithSync(true);

status = client->CreateIndex(create_request);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({ address: "YOUR_CLUSTER_ENDPOINT", token: "YOUR_CLUSTER_TOKEN" });

await client.createIndex({
    collection_name: "Documents",
    field_name: "text",
    index_name: "ngram_index",
    index_type: "NGRAM",
    params: { min_gram: 2, max_gram: 3 },
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/indexes/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "Documents",
    "indexParams": [
        {
            "fieldName": "text",
            "indexName": "ngram_index",
            "params": {
                "index_type": "NGRAM",
                "min_gram": 2,
                "max_gram": 3
            }
        }
    ]
}'
この設定では、text 内の各文字列に対して 2-gram と 3-gram が生成され、転置インデックスに格納されます。
例 2: JSON パスに作成する
JSON フィールドの場合は、gram の設定に加えて、次も指定する必要があります:
-
params.json_path:インデックスを作成する値を指す JSON パスです。 -
params.json_cast_type:"varchar"(大文字と小文字を区別しない)である必要があります。NGRAM インデックスは文字列を対象に動作するためです。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Assume you have defined a JSON field named "json_field" in your collection schema, with a JSON path named "body"

# Prepare index parameters
index_params = client.prepare_index_params()

# Add NGRAM index on a JSON field
index_params.add_index(
    field_name="json_field",              # Target JSON field
    index_type="NGRAM",                   # Index type is NGRAM
    index_name="json_ngram_index",        # Custom index name
    min_gram=2,                           # Minimum n-gram length
    max_gram=4,                           # Maximum n-gram length
    params={
        "json_path": "json_field[\"body\"]",  # Path to the value inside the JSON field
        "json_cast_type": "varchar"                  # Required: cast the value to varchar
    }
)

# Create the index on the collection
client.create_index(
    collection_name="Documents",
    index_params=index_params
)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.index.request.CreateIndexReq;
import java.util.Arrays;
import java.util.HashMap;
import java.util.Map;

Map<String, Object> params = new HashMap<>();
params.put("min_gram", "2");
params.put("max_gram", "4");
params.put("json_path", "json_field[\"body\"]");
params.put("json_cast_type", "varchar");

client.createIndex(CreateIndexReq.builder()
        .collectionName("Documents")
        .indexParams(Arrays.asList(
                IndexParam.builder().fieldName("json_field").indexType(IndexParam.IndexType.NGRAM)
                        .indexName("json_ngram_index")
                        .extraParams(params)
                        .build()))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

opt := milvusclient.NewCreateIndexOption("Documents", "json_field", index.NewNgramIndex(2, 4)).
    WithIndexName("json_ngram_index")
opt.WithExtraParam("json_path", `json_field["body"]`)
opt.WithExtraParam("json_cast_type", "varchar")

_, err = cli.CreateIndex(ctx, opt)
if err != nil {
    fmt.Println(err)
}
use milvus::v2::prelude::*;
use std::collections::HashMap;

    let request = CreateIndexRequest::builder()
        .collection_name("Documents")
        .index_params(vec![IndexParam::new()
            .field_name("json_field")
            .index_name("json_ngram_index")
            .index_type(IndexType::Ngram)
            .extra_params(HashMap::from([
                ("min_gram".to_string(), "2".to_string()),
                ("max_gram".to_string(), "4".to_string()),
                ("json_path".to_string(), "json_field[\"body\"]".to_string()),
                ("json_cast_type".to_string(), "varchar".to_string()),
            ]))])
        .build()?;
    client.create_index(request).await?;
milvus::IndexDesc json_ngram_index("json_field", "json_ngram_index", milvus::IndexType::NGRAM);
json_ngram_index.AddExtraParam("min_gram", "2");
json_ngram_index.AddExtraParam("max_gram", "4");
json_ngram_index.AddExtraParam("json_path", "json_field[\"body\"]");
json_ngram_index.AddExtraParam("json_cast_type", "varchar");

milvus::CreateIndexRequest create_request;
create_request.WithCollectionName("Documents");
create_request.WithIndexes({json_ngram_index});
create_request.WithSync(true);

status = client->CreateIndex(create_request);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createIndex({
    collection_name: "Documents",
    field_name: "json_field",
    index_name: "json_ngram_index",
    index_type: "NGRAM",
    params: { min_gram: 2, max_gram: 4, json_path: 'json_field["body"]', json_cast_type: "varchar" },
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/indexes/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "Documents",
    "indexParams": [
        {
            "fieldName": "json_field",
            "indexName": "json_ngram_index",
            "params": {
                "index_type": "NGRAM",
                "min_gram": 2,
                "max_gram": 4,
                "json_path": "json_field[\"body\"]",
                "json_cast_type": "varchar"
            }
        }
    ]
}'
この例では:
-
json_field["body"]の値のみがインデックスされます。 -
値は n-gram トークン化の前に
VARCHARにキャストされます。 -
Zilliz Cloud は長さ 2 から 4 の部分文字列を生成し、転置インデックスに格納します。
JSON フィールドにインデックスを作成する方法の詳細については、JSON Indexing を参照してください。
NGRAM によって高速化されるクエリ
NGRAM インデックスが適用されるには:
-
クエリは、
NGRAMインデックスを持つVARCHARフィールド(または JSON パス)を対象とする必要があります。 -
LIKEパターンのリテラル部分は、少なくともmin_gram文字の長さである必要があります。(たとえば、想定される最短のクエリ用語が 2 文字の場合は、インデックス作成時に min_gram=2 を設定します。)
サポートされるクエリタイプ:
-
プレフィックス一致
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Match any string that starts with the substring "database"filter = 'text LIKE "database%"'java// Match any string that starts with the substring "database"String filter = "text LIKE \"database%\"";go// Match any string that starts with the substring "database"filter := "text LIKE \"database%\""rust// Match any string that starts with the substring "database"let filter = "text LIKE \"database%\"";c++// Match any string that starts with the substring "database"const auto filter = R"(text LIKE "database%")";javascript// Match any string that starts with the substring "database"const filter = 'text LIKE "database%"';bash# Match any string that starts with the substring "database"# Use this filter expression in the "filter" field of the query/search request:# "filter": "text LIKE \"database%\"" -
サフィックス一致
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Match any string that ends with the substring "database"filter = 'text LIKE "%database"'java// Match any string that ends with the substring "database"String filter = "text LIKE \"%database\"";go// Match any string that ends with the substring "database"filter := "text LIKE \"%database\""rust// Match any string that ends with the substring "database"let filter = "text LIKE \"%database\"";c++// Match any string that ends with the substring "database"const auto filter = R"(text LIKE "%database")";javascript// Match any string that ends with the substring "database"const filter = 'text LIKE "%database"';bash# Match any string that ends with the substring "database"# Use this filter expression in the "filter" field of the query/search request:# "filter": "text LIKE \"%database\"" -
インフィックス一致
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Match any string that contains the substring "database" anywherefilter = 'text LIKE "%database%"'java// Match any string that contains the substring "database" anywhereString filter = "text LIKE \"%database%\"";go// Match any string that contains the substring "database" anywherefilter := "text LIKE \"%database%\""rust// Match any string that contains the substring "database" anywherelet filter = "text LIKE \"%database%\"";c++// Match any string that contains the substring "database" anywhereconst auto filter = R"(text LIKE "%database%")";javascript// Match any string that contains the substring "database" anywhereconst filter = 'text LIKE "%database%"';bash# Match any string that contains the substring "database" anywhere# Use this filter expression in the "filter" field of the query/search request:# "filter": "text LIKE \"%database%\"" -
ワイルドカード一致
Zilliz Cloud は
%(0 文字以上)と_(ちょうど 1 文字)の両方をサポートしています。- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Match any string where "st" appears first, and "um" appears later in the textfilter = 'text LIKE "%st%um%"'java// Match any string where "st" appears first, and "um" appears later in the textString filter = "text LIKE \"%st%um%\"";go// Match any string where "st" appears first, and "um" appears later in the textfilter := "text LIKE \"%st%um%\""rust// Match any string where "st" appears first, and "um" appears later in the textlet filter = "text LIKE \"%st%um%\"";c++// Match any string where "st" appears first, and "um" appears later in the textconst auto filter = R"(text LIKE "%st%um%")";javascript// Match any string where "st" appears first, and "um" appears later in the textconst filter = 'text LIKE "%st%um%"';bash# Match any string where "st" appears first, and "um" appears later in the text# Use this filter expression in the "filter" field of the query/search request:# "filter": "text LIKE \"%st%um%\"" -
JSON パスクエリ
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
pythonfilter = 'json_field["body"] LIKE "%database%"'javaString filter = "json_field[\"body\"] LIKE \"%database%\"";gofilter := "json_field[\"body\"] LIKE \"%database%\""rustlet filter = "json_field[\"body\"] LIKE \"%database%\"";c++const auto filter = R"(json_field["body"] LIKE "%database%")";javascriptconst filter = 'json_field["body"] LIKE "%database%"';bash# Use this filter expression in the "filter" field of the query/search request:# "filter": "json_field[\"body\"] LIKE \"%database%\"" -
正規表現フィルター
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
python# Match log messages that contain "error" followed later by "timeout"filter = 'text =~ "error.*timeout"'java// Match log messages that contain "error" followed later by "timeout"String filter = "text =~ \"error.*timeout\"";go// Match log messages that contain "error" followed later by "timeout"filter := "text =~ \"error.*timeout\""rust// Match log messages that contain "error" followed later by "timeout"let filter = "text =~ \"error.*timeout\"";c++// Match log messages that contain "error" followed later by "timeout"const auto filter = R"(text =~ "error.*timeout")";javascript// Match log messages that contain "error" followed later by "timeout"const filter = 'text =~ "error.*timeout"';bash# Match log messages that contain "error" followed later by "timeout"# Use this filter expression in the "filter" field of the query/search request:# "filter": "text =~ \"error.*timeout\"" -
JSON パスに対する正規表現フィルター
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
pythonfilter = 'json_field["body"] =~ "error.*timeout"'javaString filter = "json_field[\"body\"] =~ \"error.*timeout\"";gofilter := "json_field[\"body\"] =~ \"error.*timeout\""rustlet filter = "json_field[\"body\"] =~ \"error.*timeout\"";c++const auto filter = R"(json_field["body"] =~ "error.*timeout")";javascriptconst filter = 'json_field["body"] =~ "error.*timeout"';bash# Use this filter expression in the "filter" field of the query/search request:# "filter": "json_field[\"body\"] =~ \"error.*timeout\""
フィルター式の構文の詳細については、Pattern Matching を参照してください。
インデックスを削除する
既存のインデックスをコレクションから削除するには、drop_index() メソッドを使用します。
Milvus v2.6.x と互換性のあるクラスターでは、不要になったスカラーインデックスを直接削除できます。その前にコレクションを解放する必要はありません。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
client.drop_index(
    collection_name="Documents",   # Name of the collection
    index_name="ngram_index" # Name of the index to drop
)
import io.milvus.v2.service.index.request.DropIndexReq;

client.dropIndex(DropIndexReq.builder()
        .collectionName("Documents")
        .indexName("ngram_index")
        .build());
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

err = cli.DropIndex(ctx, milvusclient.NewDropIndexOption("Documents", "ngram_index"))
if err != nil {
    fmt.Println(err)
}
use milvus::v2::prelude::*;

    let request = DropIndexRequest::builder()
        .collection_name("Documents")
        .index_name("ngram_index")
        .build()?;
    client.drop_index(request).await?;
status = client->DropIndex(milvus::DropIndexRequest()
                               .WithCollectionName("Documents")
                               .WithIndexName("ngram_index"));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.dropIndex({ collection_name: "Documents", index_name: "ngram_index" });
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/indexes/drop" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "Documents",
    "indexName": "ngram_index"
}'
使用上の注意
-
フィールドタイプ:
VARCHARフィールドとJSONフィールドでサポートされます。JSON の場合は、params.json_pathとparams.json_cast_type="varchar"の両方を指定します。 -
正規表現の高速化:
NGRAMが正規表現フィルターを高速化するのは、Zilliz Cloud が正規表現パターンから固定のリテラル部分文字列を抽出できる場合のみです。[a-z]+などのパターンは固定リテラルを含まないため、スキャンにフォールバックする場合があります。 -
大文字と小文字を区別しない正規表現:
(?i)を含む正規表現パターンはサポートされていますが、インデックスは元の大文字と小文字を保持するため、NGRAMの最適化がスキップされる場合があります。 -
検証ステップ:正規表現フィルターの場合、
NGRAMは候補を生成し、Zilliz Cloud が完全な RE2 正規表現パターンでそれらを検証します。そのため、インデックスによる高速化によって一致結果が変わることはありません。 -
Unicode:NGRAM の分解は文字ベースで言語に依存せず、空白と句読点も含まれます。
-
空間と時間のトレードオフ:gram 範囲
[min_gram, max_gram]を広げると、生成される gram とインデックスが増えます。メモリが不足している場合は、大きなポスティングリストにmmapモードの使用を検討してください。詳細については、Use mmap を参照してください。 -
不変性:
min_gramとmax_gramはその場で変更できません。調整するにはインデックスを再構築してください。
ベストプラクティス
-
検索動作に合わせて
min_gramとmax_gramを選択する-
min_gram=2、max_gram=3から始めます。 -
min_gramは、ユーザーが入力すると想定される最短のリテラルに設定します。 -
max_gramは、意味のある部分文字列の一般的な長さ付近に設定します。max_gramを大きくするとフィルタリングは改善されますが、容量が増えます。
-
-
選択性の低い gram を避ける
非常に反復的なパターン(例:
"aaaaaa")はフィルタリング効果が弱く、得られる効果が限定的な場合があります。 -
一貫して正規化する
ユースケースで必要な場合は、取り込むテキストとクエリのリテラルに同じ正規化(小文字化、トリミングなど)を適用します。