フレーズマッチ
フレーズマッチを使用すると、クエリの用語を完全なフレーズとして含むドキュメントを検索できます。デフォルトでは、単語は同じ順序で直接隣り合って出現する必要があります。たとえば、"robotics machine learning" に対するクエリは、"…typical robotics machine learning models…" のようなテキストに一致します。ここでは、"robotics"、"machine"、"learning" の各単語が間に他の単語を挟まずに連続して出現しています。
ただし、実際のシナリオでは、厳密なフレーズマッチングは柔軟性に欠ける場合があります。"…machine learning models widely adopted in robotics…" のようなテキストに一致させたい場合があります。ここでは同じキーワードが含まれていますが、隣接しておらず、元の順序でもありません。これに対応するため、フレーズマッチは柔軟性を導入する slop パラメーターをサポートしています。slop の値は、フレーズ内の用語間に許容される位置のずれの数を定義します。たとえば、slop が 1 の場合、"machine learning" に対するクエリは、"...machine deep learning..." のようなテキストに一致します。この場合、1 つの単語("deep")が元の用語を分けています。
概要
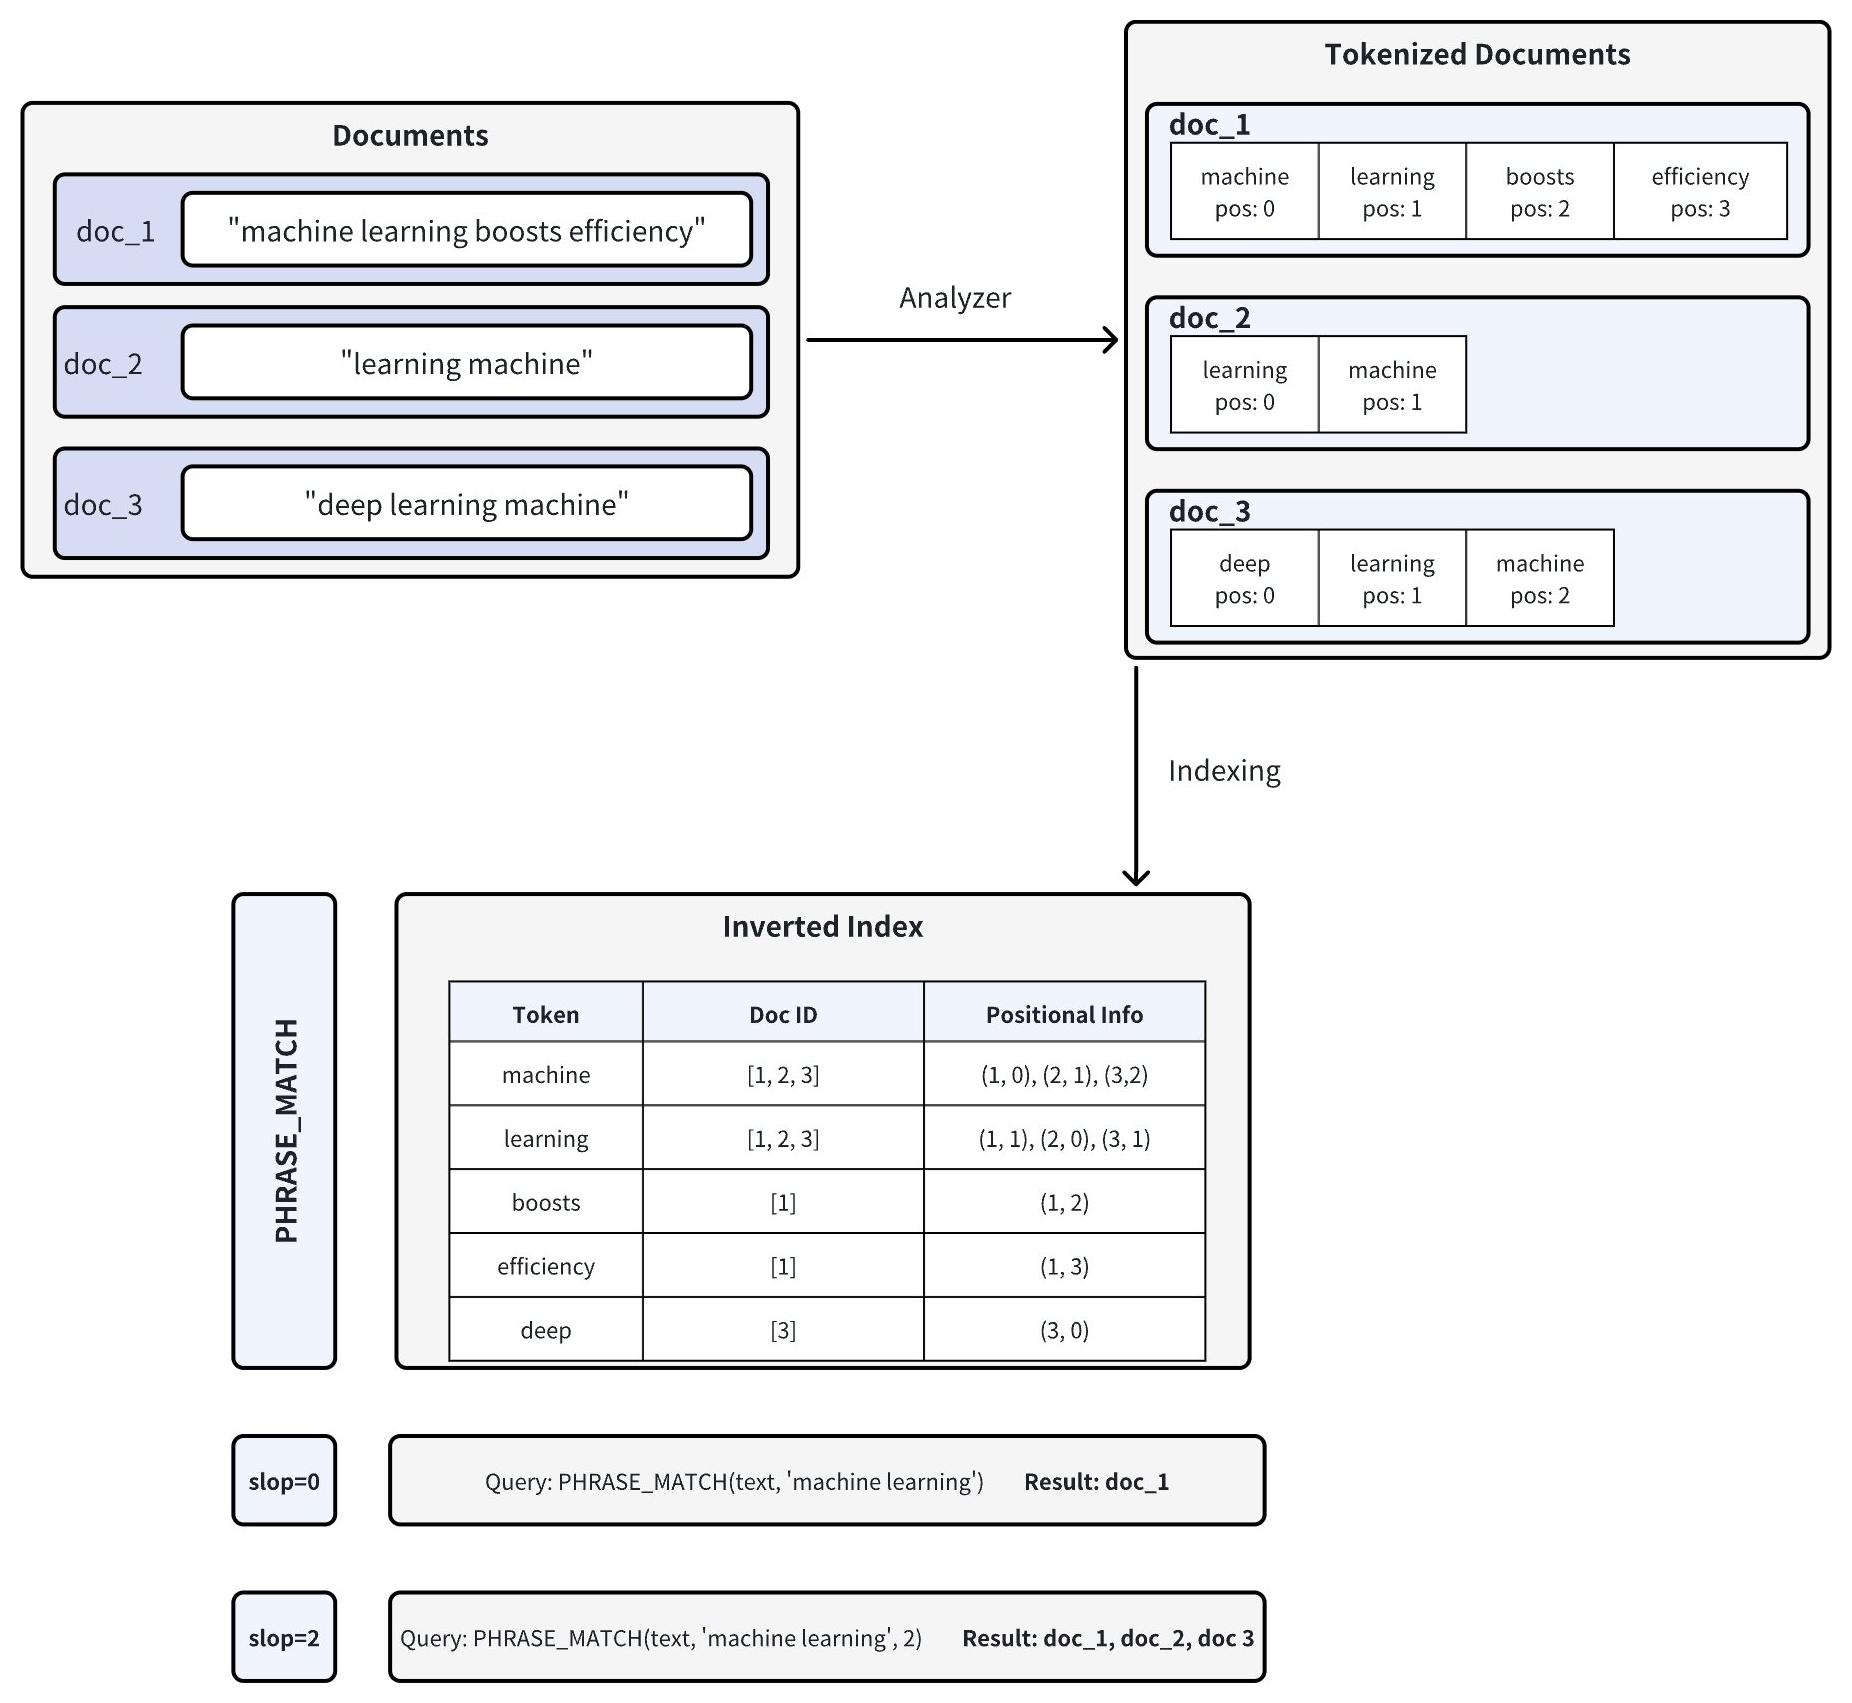
Tantivy 検索エンジンライブラリによって提供され、フレーズマッチはドキュメント内の単語の位置情報を分析して動作します。次の図はそのプロセスを示しています。
-
ドキュメントのトークン化: Zilliz Cloud にドキュメントを挿入すると、アナライザーを使用してテキストがトークン(個々の単語または用語)に分割され、各トークンの位置情報が記録されます。たとえば、doc_1 は ["machine" (pos=0), "learning" (pos=1), "boosts" (pos=2), "efficiency" (pos=3)] にトークン化されます。アナライザーの詳細は、Analyzer Overview を参照してください。
-
転置インデックスの作成: Zilliz Cloud は転置インデックスを構築し、各トークンを、それが出現するドキュメントおよびそれらのドキュメント内のトークン位置にマッピングします。
-
フレーズマッチング: フレーズクエリが実行されると、Zilliz Cloud は転置インデックスで各トークンを検索し、それらの位置を確認して、正しい順序と近接性で出現するかどうかを判定します。
slopパラメーターは、一致するトークン間に許容される位置の最大数を制御します:-
slop = 0 は、トークンが正確な順序で直ちに隣接して出現する必要があることを意味します(つまり、間に余分な単語はありません)。
- この例では、doc_1(pos=0 の "machine"、pos=1 の "learning")のみが完全に一致します。
-
slop = 2 は、一致するトークン間に最大 2 位置の柔軟性または並べ替えを許容します。
-
これにより、逆順("learning machine")またはトークン間の小さな間隔が許容されます。
-
その結果、doc_1、doc_2(pos=0 の "learning"、pos=1 の "machine")、および doc_3(pos=1 の "learning"、pos=2 の "machine")がすべて一致します。
-
-
フレーズマッチを有効にする
フレーズマッチは、Zilliz Cloud の文字列データ型である VARCHAR フィールド型で動作します。
フレーズマッチングを有効にするには、enable_analyzer と enable_match の両方のパラメーターを True に設定して、コレクションスキーマを構成します。この設定によりテキストがトークン化され、位置情報を含む転置インデックスが構築され、効率的なフレーズ検索が可能になります。
スキーマフィールドを定義する
特定の VARCHAR フィールドでフレーズマッチを有効にするには、フィールドスキーマを定義するときに enable_analyzer と enable_match の両方を True に設定します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
from pymilvus import MilvusClient, DataType

# Set up a MilvusClient
CLUSTER_ENDPOINT = "YOUR_CLUSTER_ENDPOINT"
TOKEN = "YOUR_CLUSTER_TOKEN"

client = MilvusClient(
    uri=CLUSTER_ENDPOINT,
    token=TOKEN
)

# Create a schema for a new collection
schema = client.create_schema(enable_dynamic_field=False)

# Add a primary key field
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)

# Add a VARCHAR field configured for phrase matching
schema.add_field(
    field_name="text",                  # Name of the field
    datatype=DataType.VARCHAR,          # Field data type set as VARCHAR (string)
    max_length=1000,                    # Maximum string length
    enable_analyzer=True,               # Required. Enables text analysis
    enable_match=True,                  # Required. Enables inverted indexing for phrase matching
    # Optional: Use a custom analyzer for better phrase matching in specific languages.
    # analyzer_params = {"type": "english"}     # Example: English analyzer; uncomment to apply custom analyzer
)

# Add a vector field for embeddings
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        // Optional: Use a custom analyzer for better phrase matching in specific languages.
        // .analyzerParams(Map.of("type", "english"))     // Example: English analyzer; uncomment to apply custom analyzer
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
APIKey := "YOUR_API_KEY"

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
    APIKey:  APIKey,
})

schema := entity.NewSchema().WithName(collectionName).
        WithField(entity.NewField().WithName("id").WithDataType(entity.FieldTypeInt64).WithIsPrimaryKey(true)).
        WithField(entity.NewField().WithName("text").WithDataType(entity.FieldTypeVarChar).WithMaxLength(1000).WithEnableMatch(true).WithEnableAnalyzer(true)).
        WithField(entity.NewField().WithName("embeddings").WithDataType(entity.FieldTypeFloatVector).WithDim(5))
use milvus::v2::prelude::*;

// Set up a MilvusClient
let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Create a schema for a new collection
let schema = CollectionSchema::new()
    .enable_dynamic_field(false)
    // Add a primary key field
    .add_field(
        FieldSchema::new()
            .name("id")
            .data_type(DataType::Int64)
            .primary_key(true)
            .auto_id(true),
    )
    // Add a VARCHAR field configured for phrase matching
    .add_field(
        FieldSchema::new()
            .name("text")
            .data_type(DataType::VarChar)
            .max_length(1000)
            .enable_analyzer(true)
            .enable_match(true),
        // Optional: Use a custom analyzer for better phrase matching in specific languages.
        // .analyzer_params(serde_json::json!({"type": "english"}))  // Example: English analyzer; uncomment to apply custom analyzer
    )
    // Add a vector field for embeddings
    .add_field(
        FieldSchema::new()
            .name("embeddings")
            .data_type(DataType::FloatVector)
            .dimension(5),
    );
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <memory>
#include <string>

const std::string address = "YOUR_CLUSTER_ENDPOINT";
const std::string token = "YOUR_CLUSTER_TOKEN";

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{address, token};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField(milvus::FieldSchema("id", milvus::DataType::VARCHAR, "", true, true).WithMaxLength(100));
schema->AddField(milvus::FieldSchema("dense_vector", milvus::DataType::FLOAT_VECTOR).WithDimension(4));
// Set up a MilvusClient
const address = "YOUR_CLUSTER_ENDPOINT"
const token = "YOUR_CLUSTER_TOKEN"

const client = new MilvusClient({address, token})

const schema = {
  collection_name: 'tech_articles',
  fields: [
    {
      name: "id",
      description: "primary id",
      data_type: DataType.Int64,
      is_primary_key: true,
      autoID: true,
    },
    {
      name: "text",
      description: "text field for phrase matching",
      data_type: DataType.VarChar,
      max_length: 1000,
      enable_analyzer: true, // Enables text analysis
      enable_match: true,    // Enables inverted indexing for
    },
    {
      name: "embeddings",
      description: "vector field",
      data_type: DataType.FloatVector,
      dim: 5,
    },
  ],
};
using Milvus.Client.V2;
using Milvus.Client.V2.Types;

const string CLUSTER_ENDPOINT = "YOUR_CLUSTER_ENDPOINT";
const string TOKEN = "YOUR_CLUSTER_TOKEN";

MilvusClientV2 client = new(new ConnectConfig
{
    Uri = CLUSTER_ENDPOINT,
    ApiKey = TOKEN
});

// Create a schema for a new collection
CollectionSchema schema = new()
{
    EnableDynamicFields = false,
    Fields =
    {
        // Add a primary key field
        new FieldSchema("id", DataType.Int64, isPrimaryKey: true, autoId: true),
        // Add a VARCHAR field configured for phrase matching
        FieldSchema.CreateVarchar("text", 1000, enableAnalyzer: true, enableMatch: true),
        new FieldSchema("embeddings", DataType.FloatVector) { Dimension = 5 }
    }
};
export idField='{
  "fieldName": "id",
  "dataType": "Int64",
  "isPrimary": true,
  "autoID": true
}'

export textField='{
  "fieldName": "text",
  "dataType": "VarChar",
  "elementTypeParams": {
    "max_length": 1000,
    "enable_analyzer": true,
    "enable_match": true
  }
}'

export vectorField='{
  "fieldName": "embeddings",
  "dataType": "FloatVector",
  "elementTypeParams": {
    "dim": 5
  }
}'

export schema="{
  \"autoID\": false,
  \"enableDynamicField\": true,
  \"fields\": [
    $idField,
    $textField,
    $vectorField
  ]
}"
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Create a collection with a VARCHAR field configured for phrase matching
zilliz collection create --collection-name tech_articles --schema '{
  "autoId": true,
  "enabledDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "text",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": 1000,
        "enable_analyzer": true,
        "enable_match": true
      }
    },
    {
      "fieldName": "embeddings",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": 5
      }
    }
  ]
}'
デフォルトでは、Zilliz Cloud は standard analyzer を使用します。これは、空白と句読点でテキストをトークン化し、テキストを小文字に変換します。
テキストデータが特定の言語または形式である場合は、analyzer_params パラメーター(たとえば、{ "type": "english" } または { "type": "jieba" })を使用してカスタムアナライザーを構成できます。
詳細は、Analyzer Overview を参照してください。
コレクションを作成する
必要なフィールドが定義されたら、次のコードを使用してコレクションを作成します:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Create the collection
COLLECTION_NAME = "tech_articles" # Name your collection

if client.has_collection(COLLECTION_NAME):
    client.drop_collection(COLLECTION_NAME)

client.create_collection(
    collection_name=COLLECTION_NAME,
    schema=schema
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.DropCollectionReq;
import io.milvus.v2.service.collection.request.HasCollectionReq;

String COLLECTION_NAME = "tech_articles"; // Name your collection

if (client.hasCollection(
        HasCollectionReq.builder()
            .collectionName(COLLECTION_NAME)
            .build()
    )) {
    client.dropCollection(
        DropCollectionReq.builder()
            .collectionName(COLLECTION_NAME)
            .build()
    );
}

client.createCollection(
    CreateCollectionReq.builder()
        .collectionName(COLLECTION_NAME)
        .collectionSchema(schema)
        .build()
);
import "github.com/milvus-io/milvus/client/v3/entity"

// Create a schema for a new collection
schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").                      // Name of the field
    WithDataType(entity.FieldTypeVarChar). // Field data type set as VARCHAR (string)
    WithMaxLength(1000).                   // Maximum length of the string
    WithEnableAnalyzer(true).              // Enables text analysis (tokenization)
    WithEnableMatch(true),                 // Enables inverted indexing for phrase matching
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Create the collection
let collection_name = "tech_articles"; // Name your collection

if client
    .has_collection(
        HasCollectionRequest::builder()
            .collection_name(collection_name)
            .build()?,
    )
    .await?
    .exists()
{
    client
        .drop_collection(
            DropCollectionRequest::builder()
                .collection_name(collection_name)
                .build()?,
        )
        .await?;
}

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name(collection_name)
            .schema(schema)
            .build()?,
    )
    .await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

const auto collection_name = "tech_articles";

milvus::HasCollectionResponse response;
auto status = client->HasCollection(milvus::HasCollectionRequest().WithCollectionName(collection_name), response);
if (response.Has()) {
    status = client->DropCollection(milvus::DropCollectionRequest().WithCollectionName(collection_name));
}

status = client->CreateCollection(milvus::CreateCollectionRequest()
                                    .WithCollectionName(collection_name)
                                    .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// Create or recreate the collection if it already exists
const COLLECTION_NAME = "tech_articles"; // Name your collection

const hasCollection = await client.hasCollection({ collection_name: COLLECTION_NAME });

if (hasCollection.value) {
    await client.dropCollection({ collection_name: COLLECTION_NAME });
}

await client.createCollection(schema);
using Milvus.Client.V2.Requests.Collection;

// Create the collection
const string COLLECTION_NAME = "tech_articles";

if (await client.HasCollectionAsync(new HasCollectionReq { CollectionName = COLLECTION_NAME }) is { Has: true })
{
    await client.DropCollectionAsync(new DropCollectionReq { CollectionName = COLLECTION_NAME });
}

await client.CreateCollectionAsync(new CreateCollectionReq
{
    CollectionName = COLLECTION_NAME,
    Schema = schema
});
# restful
# check collection exist
export MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"
export COLLECTION_NAME="tech_articles"
curl -X POST "YOUR_CLUSTER_ENDPOINT/v2/vectordb/collections/has" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -d "{
    \"collectionName\": \"$COLLECTION_NAME\"
  }"

# drop existing collection
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/collections/drop" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -d "{
    \"collectionName\": \"${COLLECTION_NAME}\"
  }"

# create new collection
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"$COLLECTION_NAME\",
    \"schema\": $schema
}"
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Create a collection with English analyzer for phrase matching
zilliz collection create --collection-name tech_articles --schema '{
  "autoId": true,
  "enabledDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "text",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": 1000,
        "enable_analyzer": true,
        "enable_match": true,
        "analyzer_params": {
          "type": "english"
        }
      }
    },
    {
      "fieldName": "embeddings",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": 5
      }
    }
  ]
}'
コレクションを作成した後、フレーズマッチを使用する前に、次の必要な手順を実行してください:
-
エンティティがコレクションに挿入されていること。
-
各ベクトルフィールドにインデックスを作成していること。
-
コレクションがメモリにロードされていること。
サンプルコードを表示
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Insert sample data with text containing "machine learning" phrases
sample_data = [
    {
        "text": "Machine learning is a subset of artificial intelligence that focuses on algorithms.",
        "embeddings": [0.1, 0.2, 0.3, 0.4, 0.5]
    },
    {
        "text": "Deep learning machine algorithms require large datasets for training.",
        "embeddings": [0.2, 0.3, 0.4, 0.5, 0.6]
    },
    {
        "text": "The machine learning model showed excellent performance on the test set.",
        "embeddings": [0.3, 0.4, 0.5, 0.6, 0.7]
    },
    {
        "text": "Natural language processing and machine learning go hand in hand.",
        "embeddings": [0.4, 0.5, 0.6, 0.7, 0.8]
    },
    {
        "text": "This article discusses various learning machine techniques and applications.",
        "embeddings": [0.5, 0.6, 0.7, 0.8, 0.9]
    }
]

# Insert the data
client.insert(
    collection_name=COLLECTION_NAME,
    data=sample_data
)

# Index the vector field and load the collection
index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embeddings",
    index_type="AUTOINDEX",
    index_name="embeddings_index",
    metric_type="COSINE"
)

client.create_index(collection_name=COLLECTION_NAME, index_params=index_params)

client.load_collection(collection_name=COLLECTION_NAME)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;

// Insert sample data with text containing "machine learning" phrases
String COLLECTION_NAME = "tech_articles";

Gson gson = new Gson();
List<JsonObject> data = new ArrayList<>();

JsonObject row1 = new JsonObject();
row1.addProperty("text", "machine learning boosts efficiency");
row1.add("embeddings", gson.toJsonTree(Arrays.asList(0.1f, 0.2f, 0.3f, 0.4f, 0.5f)));
data.add(row1);

JsonObject row2 = new JsonObject();
row2.addProperty("text", "learning machine is fun");
row2.add("embeddings", gson.toJsonTree(Arrays.asList(0.2f, 0.3f, 0.4f, 0.5f, 0.6f)));
data.add(row2);

JsonObject row3 = new JsonObject();
row3.addProperty("text", "machine quickly boosts learning");
row3.add("embeddings", gson.toJsonTree(Arrays.asList(0.3f, 0.4f, 0.5f, 0.6f, 0.7f)));
data.add(row3);

client.insert(InsertReq.builder().collectionName(COLLECTION_NAME).data(data).build());
// Define analyzer parameters for English-language tokenization
analyzerParams := map[string]any{"type": "english"}

// Add the VARCHAR field with the English analyzer enabled
schema.WithField(entity.NewField().
    WithName("text").                      // Name of the field
    WithDataType(entity.FieldTypeVarChar). // Field data type set as VARCHAR
    WithMaxLength(1000).                   // Maximum length of the string
    WithEnableAnalyzer(true).              // Enables text analysis
    WithAnalyzerParams(analyzerParams).    // Specifies the analyzer configuration
    WithEnableMatch(true),                 // Enables inverted indexing for phrase matching
)
use milvus::v2::prelude::*;
use serde_json::json;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

let collection_name = "tech_articles";

// Insert sample data with text containing "machine learning" phrases
let data = vec![
    json!({"text": "Machine learning is a subset of artificial intelligence that focuses on algorithms.", "embeddings": [0.1, 0.2, 0.3, 0.4, 0.5]}),
    json!({"text": "Deep learning machine algorithms require large datasets for training.", "embeddings": [0.2, 0.3, 0.4, 0.5, 0.6]}),
    json!({"text": "The machine learning model showed excellent performance on the test set.", "embeddings": [0.3, 0.4, 0.5, 0.6, 0.7]}),
    json!({"text": "Natural language processing and machine learning go hand in hand.", "embeddings": [0.4, 0.5, 0.6, 0.7, 0.8]}),
    json!({"text": "This article discusses various learning machine techniques and applications.", "embeddings": [0.5, 0.6, 0.7, 0.8, 0.9]}),
];

// Insert the data
client
    .insert(
        InsertRequest::builder()
            .collection_name(collection_name)
            .rows(data)
            .build()?,
    )
    .await?;

// Index the vector field and load the collection
client
    .create_index(
        CreateIndexRequest::builder()
            .collection_name(collection_name)
            .index_param(
                IndexParam::new()
                    .field_name("embeddings")
                    .index_name("embeddings_index")
                    .index_type(IndexType::AutoIndex)
                    .metric_type(MetricType::Cosine),
            )
            .build()?,
    )
    .await?;

client
    .load_collection(
        LoadCollectionRequest::builder()
            .collection_name(collection_name)
            .build()?,
    )
    .await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <utility>
#include <vector>

milvus::EntityRows data = {
    {{"text", "Machine learning is a subset of artificial intelligence that focuses on algorithms."}, {"embeddings", std::vector<float>{0.1, 0.2, 0.3, 0.4, 0.5}}},
    {{"text", "Deep learning machine algorithms require large datasets for training."}, {"embeddings", std::vector<float>{0.2, 0.3, 0.4, 0.5, 0.6}}},
    {{"text", "The machine learning model showed excellent performance on the test set.", std::vector<float>{0.3, 0.4, 0.5, 0.6, 0.7}}},
    {{"text", "Natural language processing and machine learning go hand in hand."}, {"embeddings", std::vector<float>{0.4, 0.5, 0.6, 0.7, 0.8}}},
    {{"text", "This article discusses various learning machine techniques and applications."}, {"embeddings", std::vector<float>{0.5, 0.6, 0.7, 0.8, 0.9}}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName(collection_name)
                                .WithRowsData(std::move(data))
                                , response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::IndexDesc index_vector("embeddings", "embeddings_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::COSINE);
status = client->CreateIndex(milvus::CreateIndexRequest()
                                    .WithCollectionName(collection_name)
                                    .AddIndex(std::move(index_vector)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

status = client->LoadCollection(milvus::LoadCollectionRequest().WithCollectionName(collection_name));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// Format and insert sample data for "machine learning" phrase matching
const COLLECTION_NAME = "tech_articles";

const sampleData = [
    {
        text: "Machine learning is a subset of artificial intelligence that focuses on algorithms.",
        embeddings: [0.1, 0.2, 0.3, 0.4, 0.5],
    },
    {
        text: "Deep learning machine algorithms require large datasets for training.",
        embeddings: [0.2, 0.3, 0.4, 0.5, 0.6],
    },
    {
        text: "The machine learning model showed excellent performance on the test set.",
        embeddings: [0.3, 0.4, 0.5, 0.6, 0.7],
    },
    {
        text: "Natural language processing and machine learning go hand in hand.",
        embeddings: [0.4, 0.5, 0.6, 0.7, 0.8],
    },
    {
        text: "This article discusses various learning machine techniques and applications.",
        embeddings: [0.5, 0.6, 0.7, 0.8, 0.9],
    },
];

// Insert the data into the collection
await client.insert({
    collection_name: COLLECTION_NAME,
    data: sampleData,
});

// Create an index on the vector field and load the collection
await client.createIndex({
    collection_name: COLLECTION_NAME,
    field_name: "embeddings",
    index_type: "AUTOINDEX",
    index_name: "embeddings_index",
    metric_type: "COSINE",
});

await client.loadCollection({
    collection_name: COLLECTION_NAME,
});
using Milvus.Client.V2.Requests.Dml;

// Insert sample data with text containing "machine learning" phrases
const string COLLECTION_NAME = "tech_articles";

await client.InsertAsync(new InsertReq
{
    CollectionName = COLLECTION_NAME,
    RowsData =
    [
        new Dictionary<string, object?> { ["text"] = "Machine learning is a subset of artificial intelligence that focuses on algorithms.", ["embeddings"] = new[] { 0.1f, 0.2f, 0.3f, 0.4f, 0.5f } },
        new Dictionary<string, object?> { ["text"] = "Deep learning machine algorithms require large datasets for training.", ["embeddings"] = new[] { 0.2f, 0.3f, 0.4f, 0.5f, 0.6f } },
        new Dictionary<string, object?> { ["text"] = "The machine learning model showed excellent performance.", ["embeddings"] = new[] { 0.3f, 0.4f, 0.5f, 0.6f, 0.7f } }
    ]
});
# restful
# Insert the data into the collection
curl -X POST "YOUR_CLUSTER_ENDPOINT/v2/vectordb/entities/insert" \
  -H "Content-Type: application/json" \
  -H "Request-Timeout: 10" \
  -H "Authorization: Bearer <token>" \
  -d '{
    "collectionName": "tech_articles",
    "data": [
      {
        "text": "Machine learning is a subset of artificial intelligence that focuses on algorithms.",
        "embeddings": [0.1, 0.2, 0.3, 0.4, 0.5]
      },
      {
        "text": "Deep learning machine algorithms require large datasets for training.",
        "embeddings": [0.2, 0.3, 0.4, 0.5, 0.6]
      },
      {
        "text": "The machine learning model showed excellent performance on the test set.",
        "embeddings": [0.3, 0.4, 0.5, 0.6, 0.7]
      },
      {
        "text": "Natural language processing and machine learning go hand in hand.",
        "embeddings": [0.4, 0.5, 0.6, 0.7, 0.8]
      },
      {
        "text": "This article discusses various learning machine techniques and applications.",
        "embeddings": [0.5, 0.6, 0.7, 0.8, 0.9]
      }
    ]
  }'
# Create an index on the vector field and load the collection
curl -X POST "YOUR_CLUSTER_ENDPOINT/v2/vectordb/indexes/create" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <token>" \
  -H "Request-Timeout: 10" \
  -d '{
    "collectionName": "tech_articles",
    "indexParams": [
      {
        "fieldName": "embeddings",
        "indexName": "embeddings_index",
        "metricType": "COSINE",
        "indexType": "AUTOINDEX"
      }
    ]
  }'

curl -X POST "YOUR_CLUSTER_ENDPOINT/v2/vectordb/collections/load" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <token>" \
  -H "Request-Timeout: 10" \
  -d '{
    "collectionName": "tech_articles"
  }'
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Use PHRASE_MATCH in a query to filter documents
zilliz collection query --collection-name tech_articles --filter "PHRASE_MATCH(text, 'machine learning')" --output-fields "id,text"
フレーズマッチを使用する
コレクションスキーマの VARCHAR フィールドでマッチを有効にすると、PHRASE_MATCH 式を使用してフレーズマッチを実行できます。
PHRASE_MATCH 式は大文字と小文字を区別しません。PHRASE_MATCH または phrase_match のいずれかを使用できます。
PHRASE_MATCH 式の構文
検索時に、PHRASE_MATCH 式を使用してフィールド、フレーズ、およびオプションの柔軟性(slop)を指定します。構文は次のとおりです:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
PHRASE_MATCH(field_name, phrase, slop)
String filter = "PHRASE_MATCH(text, 'machine learning')";
PHRASE_MATCH(field_name, phrase, slop)
let filter = "PHRASE_MATCH(text, 'machine learning')";
const auto filter = R"(PHRASE_MATCH(text, 'machine learning'))";
PHRASE_MATCH(field_name, phrase, slop)
string filter = "PHRASE_MATCH(text, 'machine learning')";
# restful
export filter = "PHRASE_MATCH(field_name, phrase, slop)"
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents containing exactly "machine learning"
zilliz collection query --collection-name tech_articles --filter "PHRASE_MATCH(text, 'machine learning')" --output-fields "id,text"
-
field_name: フレーズマッチを実行するVARCHARフィールドの名前です。 -
phrase: 検索する完全なフレーズです。 -
slop(オプション): 一致するトークンで許容される位置の最大数を指定する整数です。-
0(デフォルト):完全なフレーズのみに一致します。例:"machine learning" のフィルターは "machine learning" に完全に一致しますが、"machine boosts learning" や "learning machine" には一致しません。 -
1:1 つの余分な用語やわずかな位置のずれなど、小さな変動を許容します。例:"machine learning" のフィルターは "machine boosts learning"("machine" と "learning" の間に 1 トークン)に一致しますが、"learning machine"(用語が逆順)には一致しません。 -
2:用語の逆順や間に最大 2 トークンを許容するなど、より大きな柔軟性を提供します。例:"machine learning" のフィルターは "learning machine"(用語が逆順)または "machine quickly boosts learning"("machine" と "learning" の間に 2 トークン)に一致します。
-
フレーズマッチでクエリする
query() メソッドを使用する場合、PHRASE_MATCH はスカラーフィルターとして機能します。指定されたフレーズを含むドキュメント(許容される slop の範囲内)のみが返されます。
例:slop = 0(完全一致)
この例は、間に余分なトークンを挟まずに完全なフレーズ "machine learning" を含むドキュメントを返します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Match documents containing exactly "machine learning"
filter = "PHRASE_MATCH(text, 'machine learning')"

result = client.query(
    collection_name=COLLECTION_NAME,
    filter=filter,
    output_fields=["id", "text"]
)

print("Query result: ", result)

# Expected output:
# Query result:  data: ["{'id': 461366973343948097, 'text': 'Machine learning is a subset of artificial intelligence that focuses on algorithms.'}", "{'id': 461366973343948099, 'text': 'The machine learning model showed excellent performance on the test set.'}", "{'id': 461366973343948100, 'text': 'Natural language processing and machine learning go hand in hand.'}"]
import io.milvus.v2.service.vector.request.QueryReq;
import io.milvus.v2.service.vector.response.QueryResp;
import java.util.Arrays;

String COLLECTION_NAME = "tech_articles";
String filter = "PHRASE_MATCH(text, 'machine learning')";
QueryResp result = client.query(QueryReq.builder()
        .collectionName(COLLECTION_NAME)
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Match documents containing exactly "machine learning"
filter := "PHRASE_MATCH(text, 'machine learning')"

resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("tech_articles").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Match documents containing exactly "machine learning"
let filter = "PHRASE_MATCH(text, 'machine learning')";

let result = client
    .query(
        QueryRequest::builder()
            .collection_name("tech_articles")
            .filter(filter)
            .output_fields(["id", "text"])
            .build()?,
    )
    .await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

const auto filter = R"(PHRASE_MATCH(text, 'machine learning'))";

auto request = milvus::QueryRequest()
                       .WithCollectionName(collection_name)
                       .WithFilter(filter)
                       .AddOutputField("id")
                       .AddOutputField("text")
                       .WithLimit(100);

milvus::QueryResponse response;
auto status = client->Query(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const COLLECTION_NAME = "tech_articles";
const filter = "PHRASE_MATCH(text, 'machine learning')";

const result = await client.query({
    collection_name: COLLECTION_NAME,
    filter: filter,
    output_fields: ["id", "text"]
});
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// Match documents containing exactly "machine learning"
string filter = "PHRASE_MATCH(text, 'machine learning')";

QueryResp result = await client.QueryAsync(new QueryReq
{
    CollectionName = "tech_articles",
    Expression = filter,
    Parameters = new QueryParameters { OutputFields = { "id", "text" } }
});
# restful
curl -X POST "YOUR_CLUSTER_ENDPOINT/v2/vectordb/entities/query" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <token>" \
  -H "Request-Timeout: 10" \
  -d '{
    "collectionName": "tech_articles",
    "filter": "PHRASE_MATCH(text, '\''machine learning'\'')",
    "outputFields": ["id", "text"],
    "limit": 100
  }'
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Search documents containing "learning machine" with slop=1
zilliz collection search --collection-name tech_articles --vector-field embeddings --vectors '[[0.1,0.2,0.3,0.4,0.5]]' --filter "PHRASE_MATCH(text, 'learning machine', 1)" --limit 10 --output-fields "id,text"
フレーズマッチで検索する
検索操作では、PHRASE_MATCH を使用して、ベクトル類似度ランキングを適用する前にドキュメントを事前フィルタリングします。この 2 段階のアプローチでは、まずテキストマッチングによって候補セットを絞り込み、次にベクトル埋め込みに基づいてそれらの候補を再ランク付けします。
例:slop = 1
ここでは、slop を 1 に設定します。フィルターは、フレーズ "learning machine" をわずかな柔軟性をもって含むドキュメントに適用されます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Example: Filter documents containing "learning machine" with slop=1
filter_slop1 = "PHRASE_MATCH(text, 'learning machine', 1)"

result_slop1 = client.search(
    collection_name=COLLECTION_NAME,
    anns_field="embeddings",
    data=[[0.1, 0.2, 0.3, 0.4, 0.5]],
    filter=filter_slop1,
    search_params={},
    limit=10,
    output_fields=["id", "text"]
)

print("Slop 1 result: ", result_slop1)

# Expected output:
# Slop 1 result:  data: [[{'id': 461366973343948098, 'distance': 0.9949367046356201, 'entity': {'text': 'Deep learning machine algorithms require large datasets for training.', 'id': 461366973343948098}}, {'id': 461366973343948101, 'distance': 0.9710607528686523, 'entity': {'text': 'This article discusses various learning machine techniques and applications.', 'id': 461366973343948101}}]]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;

String COLLECTION_NAME = "tech_articles";
String filterSlop1 = "PHRASE_MATCH(text, 'learning machine', 1)";
List<Float> queryVector = Arrays.asList(0.1f, 0.2f, 0.3f, 0.4f, 0.5f);
SearchResp resultSlop1 = client.search(SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector))
        .filter(filterSlop1)
        .searchParams(Collections.emptyMap())
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());

System.out.println("Slop 1 result: " + resultSlop1);
// Example: Filter documents containing "learning machine" with slop=1
filter := "PHRASE_MATCH(text, 'learning machine', 1)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Example: Filter documents containing "learning machine" with slop=1
let filter = "PHRASE_MATCH(text, 'learning machine', 1)";

let result = client
    .search(
        SearchRequest::builder()
            .collection_name("tech_articles")
            .vector_field("embeddings")
            .vectors(SearchVectors::Float(vec![vec![0.1f32, 0.2, 0.3, 0.4, 0.5]]))
            .filter(filter)
            .output_fields(["id", "text"])
            .limit(10)
            .build()?,
    )
    .await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <vector>

const auto filter = R"(PHRASE_MATCH(text, 'learning machine', 1))";

std::vector<float> query_vector = {0.1, 0.2, 0.3, 0.4, 0.5};
auto request = milvus::SearchRequest()
                   .WithCollectionName(collection_name)
                   .WithAnnsField("embeddings")
                   .WithFilter(filter)
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const COLLECTION_NAME = "tech_articles";
const filter_slop1 = "PHRASE_MATCH(text, 'learning machine', 1)";

const result_slop1 = await client.search({
  collection_name: COLLECTION_NAME,
  anns_field: "embeddings",
  data: [0.1, 0.2, 0.3, 0.4, 0.5],
  filter: filter_slop1,
  limit: 10,
  output_fields: ["id", "text"],
});
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// Example: Filter documents containing "learning machine" with slop=1
string filter = "PHRASE_MATCH(text, 'learning machine', 1)";

SearchResp result = await client.SearchAsync(new SearchReq
{
    CollectionName = "tech_articles",
    VectorFieldName = "embeddings",
    Vectors = [new[] { 0.1f, 0.2f, 0.3f, 0.4f, 0.5f }],
    Limit = 10,
    Parameters = new SearchParameters
    {
        Expression = filter,
        OutputFields = { "id", "text" }
    }
});
# restful
export MILVUS_HOST="YOUR_CLUSTER_ENDPOINT"
export COLLECTION_NAME="tech_articles"
export AUTH_TOKEN="your_token_here"

# Search data
echo "Searching with PHRASE_MATCH filter (slop=1)..."
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/entities/search" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${AUTH_TOKEN}" \
  -H "Request-Timeout: 10" \
  -d "{
    \"collectionName\": \"${COLLECTION_NAME}\",
    \"annsField\": \"embeddings\",
    \"data\": [[0.1, 0.2, 0.3, 0.4, 0.5]],
    \"filter\": \"PHRASE_MATCH(text, 'learning machine', 1)\",
    \"searchParams\": {},
    \"limit\": 10,
    \"outputFields\": [\"id\", \"text\"]
  }"
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Search documents containing "machine learning" with slop=2
zilliz collection search --collection-name tech_articles --vector-field embeddings --vectors '[[0.1,0.2,0.3,0.4,0.5]]' --filter "PHRASE_MATCH(text, 'machine learning', 2)" --limit 10 --output-fields "id,text"
例:slop = 2
この例では、slop を 2 に設定します。これは、"machine" と "learning" の単語間に最大 2 つの余分なトークン(または逆順の用語)が許容されることを意味します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Example: Filter documents containing "machine learning" with slop=2
filter_slop2 = "PHRASE_MATCH(text, 'machine learning', 2)"

result_slop2 = client.search(
    collection_name=COLLECTION_NAME,
    anns_field="embeddings",             # Vector field name
    data=[[0.1, 0.2, 0.3, 0.4, 0.5]],                 # Query vector
    filter=filter_slop2,                 # Filter expression
    search_params={},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)

print("Slop 2 result: ", result_slop2)

# Expected output:
# Slop 2 result:  data: [[{'id': 461366973343948097, 'distance': 0.9999999403953552, 'entity': {'text': 'Machine learning is a subset of artificial intelligence that focuses on algorithms.', 'id': 461366973343948097}}, {'id': 461366973343948098, 'distance': 0.9949367046356201, 'entity': {'text': 'Deep learning machine algorithms require large datasets for training.', 'id': 461366973343948098}}, {'id': 461366973343948099, 'distance': 0.9864400029182434, 'entity': {'text': 'The machine learning model showed excellent performance on the test set.', 'id': 461366973343948099}}, {'id': 461366973343948100, 'distance': 0.9782319068908691, 'entity': {'text': 'Natural language processing and machine learning go hand in hand.', 'id': 461366973343948100}}, {'id': 461366973343948101, 'distance': 0.9710607528686523, 'entity': {'text': 'This article discusses various learning machine techniques and applications.', 'id': 461366973343948101}}]]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Arrays;
import java.util.Collections;

// Example: Filter documents containing "machine learning" with slop=2
String filter_slop2 = "PHRASE_MATCH(text, 'machine learning', 2)";
SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")
        .data(Collections.singletonList(new FloatVec(new float[]{0.1f, 0.2f, 0.3f, 0.4f, 0.5f})))
        .filter(filter_slop2)
        .searchParams(Collections.singletonMap("nprobe", "10"))
        .limit(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "machine learning" with slop=2
filter := "PHRASE_MATCH(text, 'machine learning', 2)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit, maximum results to return
    []entity.Vector{entity.FloatVector(queryVector)}, // query vector
).WithANNSField("embeddings"). // vector field name
    WithFilter(filter).        // filter expression
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Example: Filter documents containing "machine learning" with slop=2
let filter = "PHRASE_MATCH(text, 'machine learning', 2)";

let result = client
    .search(
        SearchRequest::builder()
            .collection_name("tech_articles")
            .vector_field("embeddings")
            .vectors(SearchVectors::Float(vec![vec![0.1f32, 0.2, 0.3, 0.4, 0.5]]))
            .filter(filter)
            .output_fields(["id", "text"])
            .limit(10)
            .build()?,
    )
    .await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <vector>

const auto filter = R"(PHRASE_MATCH(text, 'machine learning', 2))";

std::vector<float> query_vector = {0.1, 0.2, 0.3, 0.4, 0.5};
auto request = milvus::SearchRequest()
                   .WithCollectionName(collection_name)
                   .WithAnnsField("embeddings")
                   .WithFilter(filter)
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const COLLECTION_NAME = "tech_articles";
const filter_slop2 = "PHRASE_MATCH(text, 'learning machine', 2)";

const result_slop2 = await client.search({
  collection_name: COLLECTION_NAME,
  anns_field: "embeddings",
  data: [0.1, 0.2, 0.3, 0.4, 0.5],
  filter: filter_slop2,
  limit: 10,
  output_fields: ["id", "text"],
});
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// Example: Filter documents containing "machine learning" with slop=2
string filter = "PHRASE_MATCH(text, 'machine learning', 2)";

SearchResp result = await client.SearchAsync(new SearchReq
{
    CollectionName = "tech_articles",
    VectorFieldName = "embeddings",
    Vectors = [new[] { 0.1f, 0.2f, 0.3f, 0.4f, 0.5f }],
    Limit = 10,
    Parameters = new SearchParameters
    {
        Expression = filter,
        OutputFields = { "id", "text" }
    }
});
#restful
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/entities/search" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${AUTH_TOKEN}" \
  -H "Request-Timeout: 10" \
  -d "{
    \"collectionName\": \"${COLLECTION_NAME}\",
    \"annsField\": \"embeddings\",
    \"data\": [[0.1, 0.2, 0.3, 0.4, 0.5]],
    \"filter\": \"PHRASE_MATCH(text, 'machine learning', 2)\",
    \"searchParams\": {},
    \"limit\": 10,
    \"outputFields\": [\"id\", \"text\"]
  }"
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Search documents containing "machine learning" with slop=3
zilliz collection search --collection-name tech_articles --vector-field embeddings --vectors '[[0.1,0.2,0.3,0.4,0.5]]' --filter "PHRASE_MATCH(text, 'machine learning', 3)" --limit 10 --output-fields "id,text"
例:slop = 3
この例では、slop を 3 に設定してさらに柔軟性を高めます。フィルターは、単語間に最大 3 つのトークン位置を許容して "machine learning" を検索します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
- Zilliz CLI
# Example: Filter documents containing "machine learning" with slop=3
filter_slop3 = "PHRASE_MATCH(text, 'machine learning', 3)"

result_slop3 = client.search(
    collection_name=COLLECTION_NAME,
    anns_field="embeddings",             # Vector field name
    data=[[0.1, 0.2, 0.3, 0.4, 0.5]],                 # Query vector
    filter=filter_slop3,                 # Filter expression
    search_params={},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)

print("Slop 3 result: ", result_slop3)

# Expected output:
# Slop 3 result:  data: [[{'id': 461366973343948097, 'distance': 0.9999999403953552, 'entity': {'text': 'Machine learning is a subset of artificial intelligence that focuses on algorithms.', 'id': 461366973343948097}}, {'id': 461366973343948098, 'distance': 0.9949367046356201, 'entity': {'text': 'Deep learning machine algorithms require large datasets for training.', 'id': 461366973343948098}}, {'id': 461366973343948099, 'distance': 0.9864400029182434, 'entity': {'text': 'The machine learning model showed excellent performance on the test set.', 'id': 461366973343948099}}, {'id': 461366973343948100, 'distance': 0.9782319068908691, 'entity': {'text': 'Natural language processing and machine learning go hand in hand.', 'id': 461366973343948100}}, {'id': 461366973343948101, 'distance': 0.9710607528686523, 'entity': {'text': 'This article discusses various learning machine techniques and applications.', 'id': 461366973343948101}}]]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Arrays;
import java.util.Collections;

// Example: Filter documents containing "machine learning" with slop=3
String filter_slop3 = "PHRASE_MATCH(text, 'machine learning', 3)";
SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")
        .data(Collections.singletonList(new FloatVec(new float[]{0.1f, 0.2f, 0.3f, 0.4f, 0.5f})))
        .filter(filter_slop3)
        .searchParams(Collections.singletonMap("nprobe", "10"))
        .limit(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "machine learning" with slop=3
filter := "PHRASE_MATCH(text, 'machine learning', 3)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit, maximum results to return
    []entity.Vector{entity.FloatVector(queryVector)}, // query vector
).WithANNSField("embeddings"). // vector field name
    WithFilter(filter).        // filter expression
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Example: Filter documents containing "machine learning" with slop=3
let filter = "PHRASE_MATCH(text, 'machine learning', 3)";

let result = client
    .search(
        SearchRequest::builder()
            .collection_name("tech_articles")
            .vector_field("embeddings")
            .vectors(SearchVectors::Float(vec![vec![0.1f32, 0.2, 0.3, 0.4, 0.5]]))
            .filter(filter)
            .output_fields(["id", "text"])
            .limit(10)
            .build()?,
    )
    .await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <vector>

const auto filter = R"(PHRASE_MATCH(text, 'machine learning', 3))";

std::vector<float> query_vector = {0.1, 0.2, 0.3, 0.4, 0.5};
auto request = milvus::SearchRequest()
                   .WithCollectionName(collection_name)
                   .WithAnnsField("embeddings")
                   .WithFilter(filter)
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text")
                   .AddFloatVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const COLLECTION_NAME = "tech_articles";
const filter_slop3 = "PHRASE_MATCH(text, 'learning machine', 3)";

const result_slop3 = await client.search({
  collection_name: COLLECTION_NAME,
  anns_field: "embeddings",
  data: [0.1, 0.2, 0.3, 0.4, 0.5],
  filter: filter_slop3,
  limit: 10,
  output_fields: ["id", "text"],
});
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// Example: Filter documents containing "machine learning" with slop=3
string filter = "PHRASE_MATCH(text, 'machine learning', 3)";

SearchResp result = await client.SearchAsync(new SearchReq
{
    CollectionName = "tech_articles",
    VectorFieldName = "embeddings",
    Vectors = [new[] { 0.1f, 0.2f, 0.3f, 0.4f, 0.5f }],
    Limit = 10,
    Parameters = new SearchParameters
    {
        Expression = filter,
        OutputFields = { "id", "text" }
    }
});
# restful
curl -X POST "http://${MILVUS_HOST}/v2/vectordb/entities/search" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${AUTH_TOKEN}" \
  -H "Request-Timeout: 10" \
  -d "{
    \"collectionName\": \"${COLLECTION_NAME}\",
    \"annsField\": \"embeddings\",
    \"data\": [[0.1, 0.2, 0.3, 0.4, 0.5]],
    \"filter\": \"PHRASE_MATCH(text, 'machine learning', 3)\",
    \"searchParams\": {},
    \"limit\": 10,
    \"outputFields\": [\"id\", \"text\"]
  }"
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Search documents containing "machine learning" with slop=3
zilliz collection search --collection-name tech_articles --vector-field embeddings --vectors '[[0.1,0.2,0.3,0.4,0.5]]' --filter "PHRASE_MATCH(text, 'machine learning', 3)" --limit 10 --output-fields "id,text"
考慮事項
-
フィールドのフレーズマッチングを有効にすると転置インデックスが作成され、ストレージリソースが消費されます。この機能を有効にするかどうかを決定する際は、テキストサイズ、一意のトークン、および使用するアナライザーによってストレージへの影響が異なることを考慮してください。
-
スキーマでアナライザーを定義すると、その設定はそのコレクションに対して永続的になります。別のアナライザーの方がニーズに適していると判断した場合は、既存のコレクションを削除し、目的のアナライザー構成で新しいコレクションを作成することを検討してください。
-
フレーズマッチのパフォーマンスは、テキストがどのようにトークン化されるかによって異なります。アナライザーをコレクション全体に適用する前に、
run_analyzerメソッドを使用してトークン化の出力を確認してください。詳細は、Analyzer Overview を参照してください。 -
filter式のエスケープルール:-
式内の二重引用符または一重引用符で囲まれた文字は、文字列定数として解釈されます。文字列定数にエスケープ文字が含まれる場合、エスケープ文字はエスケープシーケンスで表す必要があります。たとえば、
\を表すには\\、タブ\tを表すには\\t、改行を表すには\\nを使用します。 -
文字列定数が一重引用符で囲まれている場合、定数内の一重引用符は
\\'で表す必要がありますが、二重引用符は"または\\"のいずれかで表すことができます。例:'It\\'s milvus'。 -
文字列定数が二重引用符で囲まれている場合、定数内の二重引用符は
\\"で表す必要がありますが、一重引用符は'または\\'のいずれかで表すことができます。例:"He said \\"Hi\\""。
-