範囲検索
範囲検索は、返されるエンティティの distance または score を特定の範囲内に制限することで、検索結果の関連性を向上させます。このページでは、範囲検索とは何か、および範囲検索を実行する手順について説明します。
概要
範囲検索リクエストを実行するとき、Zilliz Cloud は ANN Search の結果からクエリ vector に最も類似した vectors を中心として使用し、Search リクエストで指定された radius を外側の円の半径、range_filter を内側の円の半径として、2 つの同心円を描きます。これら 2 つの同心円によって形成される環状領域内に similarity score が収まるすべての vectors が返されます。ここで、range_filter は 0 に設定することもでき、その場合は指定された similarity score(radius)内のすべてのエンティティが返されます。
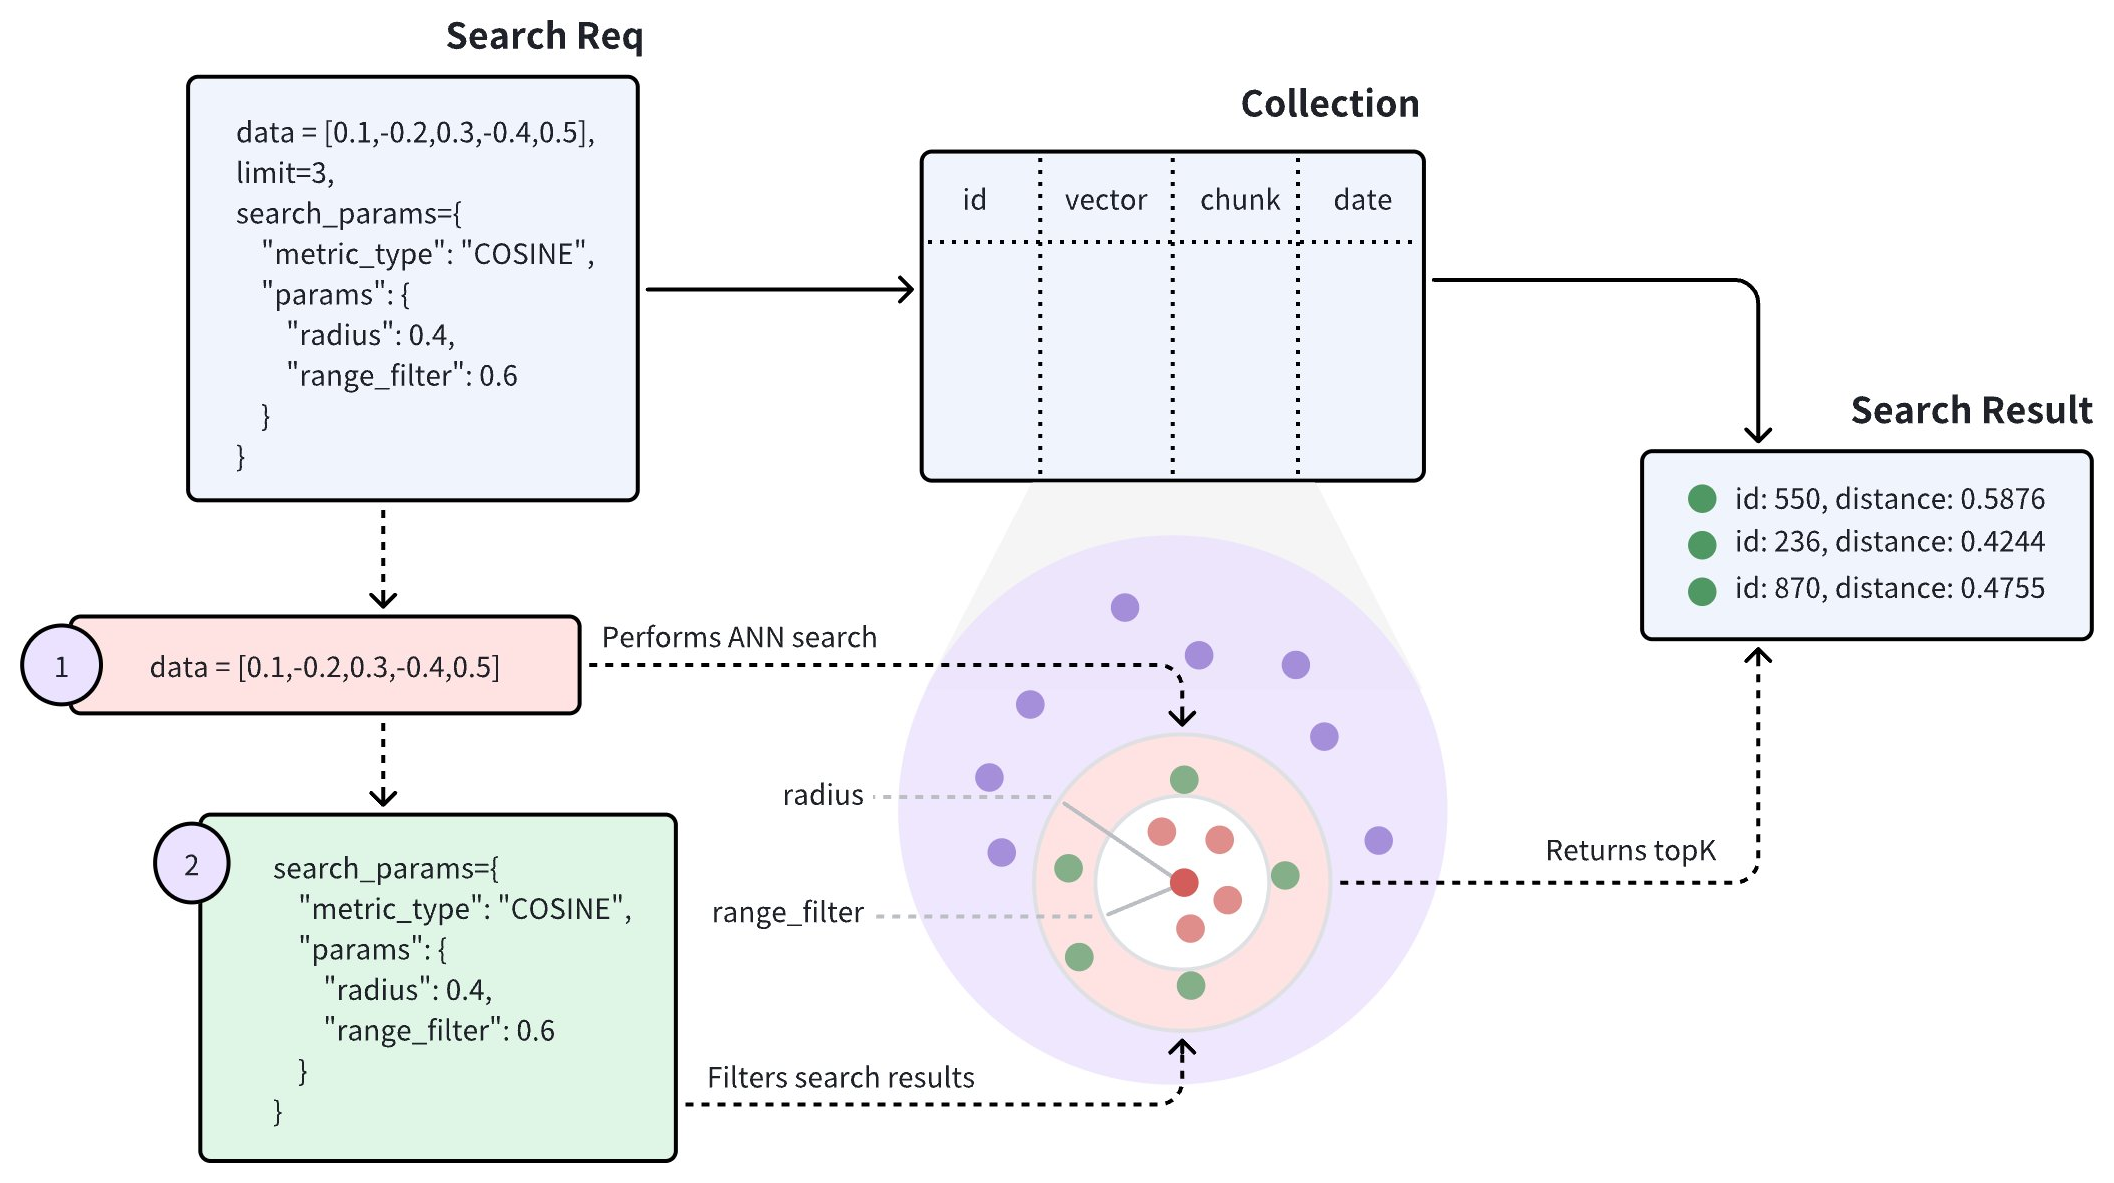
上の図が示すように、範囲検索リクエストには 2 つのパラメータ radius と range_filter が含まれます。範囲検索リクエストを受け取ると、Zilliz Cloud は次の処理を行います。
-
指定された metric type(COSINE)を使用して、クエリ vector に最も類似したすべての vector embeddings を見つけます。
-
クエリ vector に対する distances または scores が、radius および range_filter パラメータで指定された範囲内に収まる vector embeddings をフィルタリングします。
-
フィルタリングされたものの中から top-K エンティティを返します。
radius と range_filter の設定方法は、検索の metric type によって異なります。次の表は、異なる metric types でこれら 2 つのパラメータを設定する際の要件を示しています。
| Metric Type | 表記 | radius と range_filter の設定要件 |
|---|---|---|
L2 | L2 distance が小さいほど similarity が高いことを示します。 | 最も類似した vector embeddings を無視するには、range_filter <= distance < radius を満たしてください |
IP | IP distance が大きいほど similarity が高いことを示します。 | 最も類似した vector embeddings を無視するには、radius < distance <= range_filter を満たしてください |
COSINE | COSINE distance が大きいほど similarity が高いことを示します。 | 最も類似した vector embeddings を無視するには、radius < distance <= range_filter を満たしてください |
JACCARD | Jaccard distance が小さいほど similarity が高いことを示します。 | 最も類似した vector embeddings を無視するには、range_filter <= distance < radius を満たしてください |
HAMMING | Hamming distance が小さいほど similarity が高いことを示します。 | 最も類似した vector embeddings を無視するには、range_filter <= distance < radius を満たしてください |
例
このセクションでは、範囲検索の実行方法を示します。以下のコードスニペット内の検索リクエストには metric type が含まれていないため、デフォルトの metric type である COSINE が適用されます。この場合、radius の値が range_filter の値より小さくなるようにしてください。
次のコードスニペットでは、radius を 0.4、range_filter を 0.6 に設定しているため、Zilliz Cloud はクエリ vector に対する distances または scores が 0.4 から 0.6 の範囲に収まるすべてのエンティティを返します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    limit=3,
    search_params={
        "params": {
            "radius": 0.4,
            "range_filter": 0.6
        }
    }
)

for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
 io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f});
Map<String,Object> extraParams = new HashMap<>();
extraParams.put("radius", 0.4);
extraParams.put("range_filter", 0.6);
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .searchParams(extraParams)
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={}, score=0.5975797, id=4)
// SearchResp.SearchResult(entity={}, score=0.46704385, id=5)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

annParam := index.NewCustomAnnParam()
annParam.WithRadius(0.4)
annParam.WithRangeFilter(0.6)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithConsistencyLevel(entity.ClStrong).
    WithANNSField("vector").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "YOUR_CLUSTER_ENDPOINT";
const token = "YOUR_CLUSTER_TOKEN";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    params: {
        "radius": 0.4,
        "range_filter": 0.6
    }
})
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "searchParams": {
        "params": {
            "radius": 0.4,
            "range_filter": 0.6
        }
    }
}'
# {"code":0,"cost":0,"data":[]}
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

std::vector<float> query_vector = {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithRadius(0.4)
                   .WithRangeFilter(0.6);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
クエリ vectors がすでに対象の collection に存在する場合は、検索前にそれらを取得する代わりに ids を使用することを検討してください。詳細については、Primary-Key Search を参照してください。