RRF Ranker
Reciprocal Rank Fusion(RRF)Ranker は、Zilliz Cloud のハイブリッド検索において、複数のベクトル検索パスの結果を、生の類似度スコアではなくランキング位置に基づいて均衡させるリランキング戦略です。選手の個々の統計ではなくランキングを考慮するスポーツのトーナメントのように、RRF Ranker は各アイテムが異なる検索パスでどれだけ上位にランクされているかに基づいて検索結果を統合し、公平で均衡の取れた最終ランキングを作成します。
RRF Ranker を使用する場合
RRF Ranker は、明示的な重要度の重みを割り当てずに、複数のベクトル検索パスの結果を均衡させたいハイブリッド検索のシナリオ向けに特別に設計されています。特に次のような場合に効果的です。
ユースケース | 例 | RRF Ranker が適している理由 |
|---|---|---|
同等の重要度を持つマルチモーダル検索 | 両方のモダリティが同等に重要な画像テキスト検索 | 任意の重みを割り当てることなく結果を均衡させます |
アンサンブルベクトル検索 | 異なる埋め込みモデルの結果を統合する | 特定のモデルのスコア分布を優遇せず、ランキングを民主的に統合します |
クロスリンガル検索 | 複数の言語にまたがるドキュメント検索 | 言語固有の埋め込み特性に関係なく、結果を公平にランク付けします |
専門家の推薦 | 複数の専門家システムからの推薦を統合する | 異なるシステムが比較できないスコアリング手法を使用する場合に、合意に基づくランキングを作成します |
ハイブリッド検索アプリケーションで、明示的な重みを割り当てずに複数の検索パスを民主的に均衡させる必要がある場合、RRF Ranker が理想的な選択肢です。
RRF Ranker の仕組み
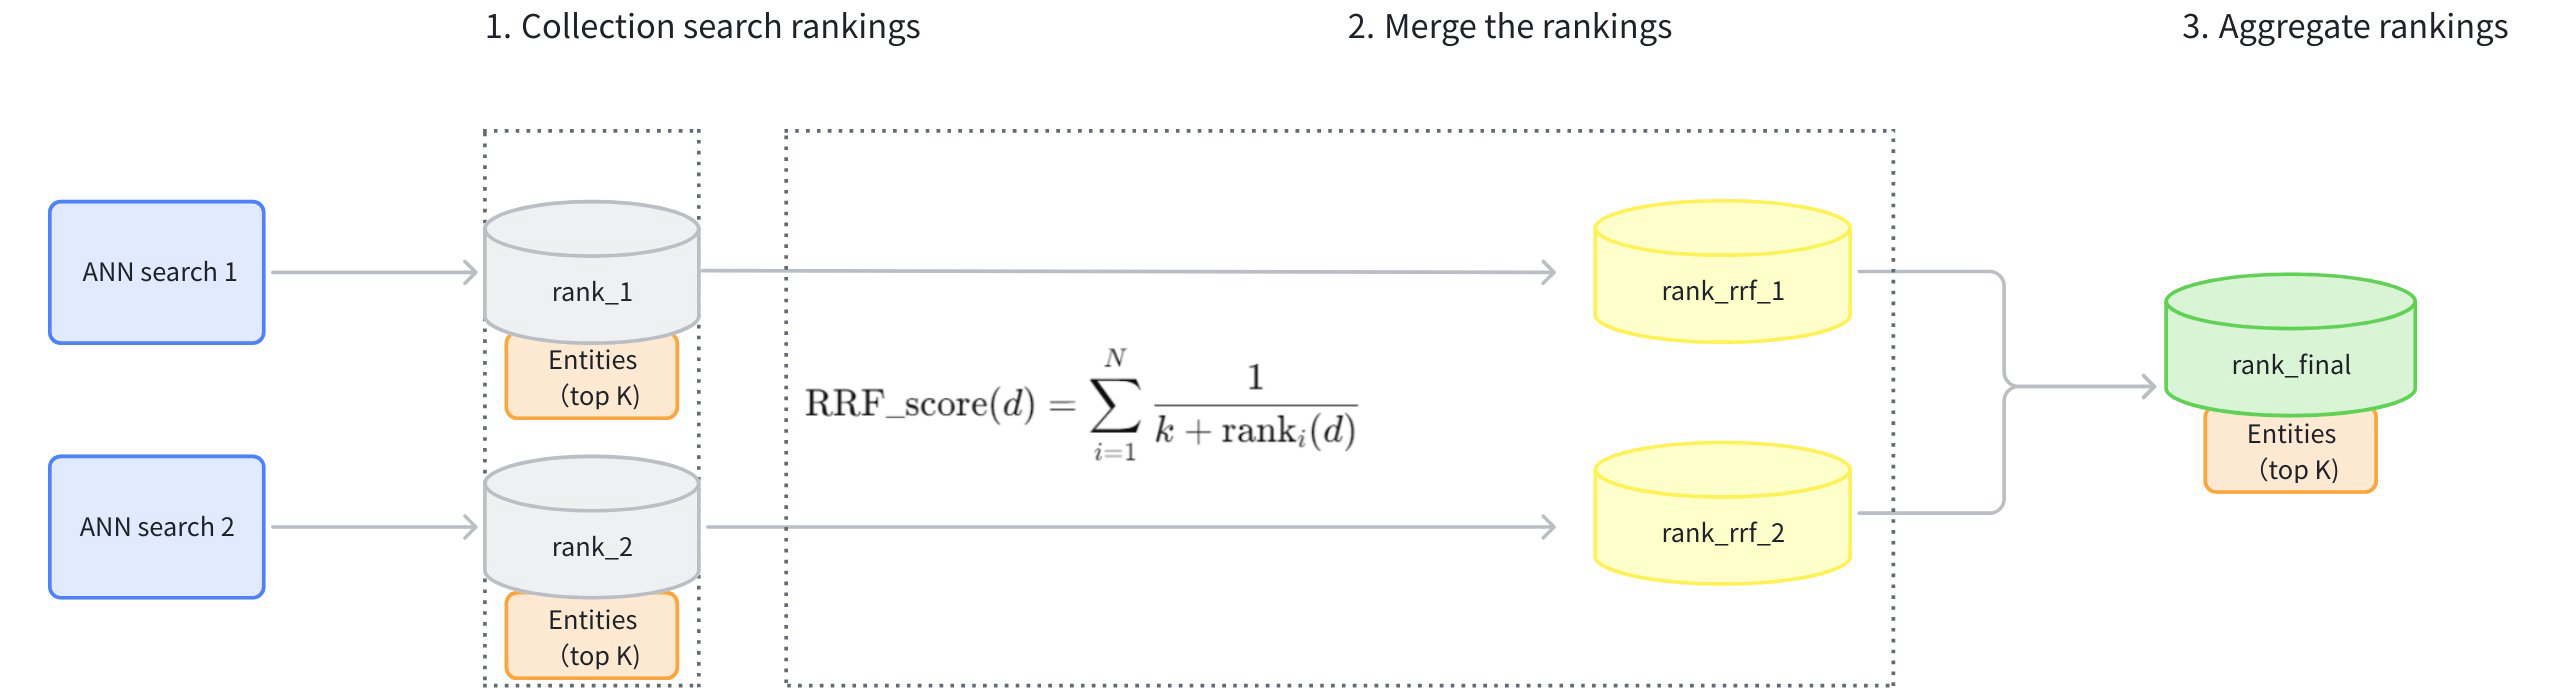
RRFRanker 戦略の主なワークフローは以下の通りです。
-
検索ランキングを収集する: ベクトル検索の各パスから結果のランキング(rank_1、rank_2)を収集します。
-
ランキングを統合する: 各パスからのランキング(rank_rrf_1、rank_rrf_2)を式に従って変換します。
計算式には、取得回数を表す N が含まれます。ranki(d) は、i(th) 番目のレトリーバーによって生成されたドキュメント d のランキング位置です。k は通常 60 に設定されるスムージングパラメーターです。
-
ランキングを集計する: 統合されたランキングに基づいて検索結果を再ランク付けし、最終結果を生成します。
RRF Ranker の例
この例では、スパース・デンスベクトルに対するハイブリッド検索(topK=5)を実演し、RRFRanker 戦略が 2 つの ANN 検索の結果をどのように再ランク付けするかを示します。
-
テキストのスパースベクトルに対する ANN 検索の結果(topK=5):
ID
ランク(スパース)
101
1
203
2
150
3
198
4
175
5
-
テキストのデンスベクトルに対する ANN 検索の結果(topK=5):
ID
ランク(デンス)
198
1
101
2
110
3
175
4
250
5
-
RRF を使用して、2 セットの検索結果のランキングを再配置します。スムージングパラメーター
kが 60 に設定されていると仮定します。ID
スコア(スパース)
スコア(デンス)
最終スコア
101
1
2
1/(60+1)+1/(60+2) = 0.03252247
198
4
1
1/(60+4)+1/(60+1) = 0.03201844
175
5
4
1/(60+5)+1/(60+4) = 0.03100962
203
2
N/A
1/(60+2) = 0.01612903
150
3
N/A
1/(60+3) = 0.01587302
110
N/A
3
1/(60+3) = 0.01587302
250
N/A
5
1/(60+5) = 0.01538462
-
再ランク付け後の最終結果(topK=5):
ランク
ID
最終スコア
1
101
0.03252247
2
198
0.03201844
3
175
0.03100962
4
203
0.01612903
5
150
0.01587302
5
110
0.01587302
RRF Ranker の使用方法
RRF リランキング戦略を使用する場合、パラメーター k を設定する必要があります。これは、全文検索とベクトル検索の相対的な重みを効果的に変更できるスムージングパラメーターです。このパラメーターのデフォルト値は 60 で、(0, 16384) の範囲で調整できます。値は浮動小数点数である必要があります。推奨値は [10, 100] の範囲です。k=60 は一般的な選択肢ですが、最適な k の値は特定のアプリケーションやデータセットによって異なる場合があります。最高のパフォーマンスを実現するには、特定のユースケースに基づいてこのパラメーターをテストおよび調整することをお勧めします。
RRF Ranker を作成する
コレクションに複数のベクトルフィールドが設定されたら、適切なスムージングパラメーターを使用して RRF Ranker を作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import Function, FunctionType

ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.Function rerank = CreateCollectionReq.Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build();
import "github.com/milvus-io/milvus/client/v3/milvusclient"

rerank := milvusclient.NewRRFReranker().WithK(100)
use milvus::v2::prelude::*;

let rerank = Function::new()
    .name("rrf")
    .function_type(FunctionType::Rerank)
    .param("reranker", "rrf")
    .param("k", "100");
#include <memory>
#include "milvus/MilvusClientV2.h"

auto rerank = std::make_shared<milvus::Function>("rrf", milvus::FunctionType::RERANK);
rerank->AddParam("reranker", "rrf");
rerank->AddParam("k", "100");
import { FunctionType } from "@zilliz/milvus2-sdk-node";

const ranker = {
  name: "rrf",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "rrf",
    k: 100,
  },
};
using Milvus.Client.V2.Types;

var rerank = new RrfReranker(100);
functions='[
  {
    "name": "rrf",
    "type": "RERANK",
    "inputFieldNames": [],
    "params": {
      "reranker": "rrf",
      "k": 100
    }
  }
]'
パラメーター | 必須? | 説明 | Value/Example |
|---|---|---|---|
| はい | この Function の一意の識別子 |
|
| はい | 関数を適用するベクトルフィールドのリスト(RRF Ranker の場合は空にする必要があります) | [] |
| はい | 呼び出す Function のタイプ。リランキング戦略を指定するには |
|
| はい | 使用するリランキング手法を指定します。 RRF Ranker を使用するには |
|
| いいえ | ドキュメントのランクの影響を制御するスムージングパラメーターです。 詳細は、RRF Ranker の仕組み を参照してください。 |
|
ハイブリッド検索に適用する
RRF Ranker は、複数のベクトルフィールドを組み合わせるハイブリッド検索操作のために特別に設計されています。ハイブリッド検索で使用する方法は次の通りです。
この例では、text_vector 用のテキスト埋め込み関数を備えた既存のコレクションと、image_vector の次元に一致する準備済みの画像埋め込みがあることを前提としています。コレクション名と画像埋め込みは、ご自身の値に置き換えてください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient, AnnSearchRequest, RRFRanker

# Connect to Zilliz Cloud server
milvus_client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# Assume you have a collection setup

# Define text vector search request
text_search = AnnSearchRequest(
    data=["modern dining table"],
    anns_field="text_vector",
    param={},
    limit=10
)

# Define image vector search request
image_search = AnnSearchRequest(
    data=[image_embedding],  # Image embedding vector
    anns_field="image_vector",
    param={},
    limit=10
)

# Create an RRF ranker with smoothing parameter k
ranker = RRFRanker(k=100)

# Apply RRF Ranker to product hybrid search
# The smoothing parameter k controls the balance
hybrid_results = milvus_client.hybrid_search(
    collection_name,
    [text_search, image_search],  # Multiple search requests
    ranker=ranker,  # Apply the RRF ranker
    limit=10,
    output_fields=["product_name", "price", "category"]
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.ranker.RRFRanker;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_vector")
        .vectors(Collections.singletonList(new EmbeddedText("modern dining table")))
        .limit(10)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_vector")
        .vectors(Collections.singletonList(new FloatVec(imageEmbedding)))
        .limit(10)
        .build());

RRFRanker ranker = RRFRanker.builder()
                .k(100)
                .build();

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
                .collectionName(COLLECTION_NAME)
                .searchRequests(searchRequests)
                .ranker(ranker)
                .limit(10)
                .outFields(Arrays.asList("product_name", "price", "category"))
                .build();
SearchResp searchResp = client.hybridSearch(hybridSearchReq);
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey: "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    panic(err)
}
defer client.Close(ctx)

// Define text vector search request
textSearch := milvusclient.NewAnnRequest("text_vector", 10, entity.Text("modern dining table"))

// Define image vector search request
imageSearch := milvusclient.NewAnnRequest("image_vector", 10, entity.FloatVector(imageEmbedding))

// Apply RRF Ranker to product hybrid search
rerank := milvusclient.NewRRFReranker().WithK(100)
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    collectionName, 10, textSearch, imageSearch,
).WithReranker(rerank).WithOutputFields("product_name", "price", "category"))
if err != nil {
    panic(err)
}
fmt.Println(resultSets)
use milvus::v2::prelude::*;

let config = ConnectConfig::new()
    .uri("YOUR_CLUSTER_ENDPOINT")
    .token("YOUR_CLUSTER_TOKEN");
let client = ClientV2::new(&config).await?;

// Define text vector search request
let text_search = SubSearchRequest::builder()
    .vector_field("text_vector")
    .vectors(SearchVectors::EmbeddedText(vec!["modern dining table".to_string()]))
    .limit(10)
    .build()?;

// Define image vector search request
let image_search = SubSearchRequest::builder()
    .vector_field("image_vector")
    .vectors(SearchVectors::Float(vec![image_embedding]))
    .limit(10)
    .build()?;

// Apply RRF Ranker to product hybrid search
let hybrid_results = client
    .hybrid_search(
        HybridSearchRequest::builder()
            .collection_name(collection_name)
            .sub_requests(vec![text_search, image_search])
            .rerank(RRFRerank::new().k(100))
            .limit(10)
            .output_fields(["product_name", "price", "category"])
            .build()?,
    )
    .await?;
#include <iostream>
#include <memory>
#include <utility>
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();
auto connect_status = client->Connect(milvus::ConnectParam{
    "YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"});
if (!connect_status.IsOk()) {
    std::cout << connect_status.Message() << std::endl;
    return;
}

auto text_search = milvus::SubSearchRequest()
                    .WithLimit(10)
                    .WithAnnsField("text_vector")
                    .AddEmbeddedText("modern dining table");

auto image_search = milvus::SubSearchRequest()
                    .WithLimit(10)
                    .WithAnnsField("image_vector")
                    .AddFloatVector(image_embedding);

auto request = milvus::HybridSearchRequest()
                    .WithCollectionName(collection_name)
                    .WithLimit(10)
                    .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(text_search)))
                    .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(image_search)))
                    .WithRerank(rerank)
                    .AddOutputField("product_name")
                    .AddOutputField("price")
                    .AddOutputField("category");

milvus::SearchResponse response;
auto status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient, FunctionType } from "@zilliz/milvus2-sdk-node";

const milvusClient = new MilvusClient({
  address: "YOUR_CLUSTER_ENDPOINT",
  token: "YOUR_CLUSTER_TOKEN",
});

const text_search = {
    data: ["modern dining table"],
    anns_field: "text_vector",
    params: {},
    limit: 10,
};

const image_search = {
  data: [image_embedding],
  anns_field: "image_vector",
  params: {},
  limit: 10,
};

const ranker = {
  name: "rrf",
  input_field_names: [],
  type: FunctionType.RERANK,
  params: {
    reranker: "rrf",
    k: 100,
  },
};

const search = await milvusClient.search({
  collection_name: collection_name,
  data: [text_search, image_search],
  output_fields: ["product_name", "price", "category"],
  limit: 10,
  rerank: ranker,
});
using Milvus.Client.V2;
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// Connect to Zilliz Cloud server
var config = new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    ApiKey = "YOUR_CLUSTER_TOKEN"
};
using var client = new MilvusClientV2(config);
await client.ConnectAsync();

// Assume you have a collection setup

// Define text vector search request
var textSearch = new AnnSearchReq
{
    VectorFieldName = "text_vector",
    Texts = ["modern dining table"],
    Limit = 10
};

// Define image vector search request
var imageSearch = new AnnSearchReq
{
    VectorFieldName = "image_vector",
    Vectors = [imageEmbedding], // Image embedding vector
    Limit = 10
};

var rerank = new RrfReranker(100);

// Apply RRF Ranker to product hybrid search
// The smoothing parameter k controls the balance
SearchResp hybridResults = await client.HybridSearchAsync(new HybridSearchReq
{
    CollectionName = collectionName,
    SearchRequests = [textSearch, imageSearch], // Multiple search requests
    Reranker = rerank, // Apply the RRF ranker
    Limit = 10,
    Parameters = new SearchParameters
    {
        OutputFields = { "product_name", "price", "category" }
    }
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

# Set IMAGE_EMBEDDING to your image vector as a JSON array before running this request.
: "${IMAGE_EMBEDDING:?Set IMAGE_EMBEDDING to a JSON array of embedding values}"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data-binary @- <<EOF
{
    "collectionName": "collection_name",
    "search": [
        {
            "data": ["modern dining table"],
            "annsField": "text_vector",
            "limit": 10
        },
        {
            "data": [${IMAGE_EMBEDDING}],
            "annsField": "image_vector",
            "limit": 10
        }
    ],
    "rerank": {
        "strategy": "rrf",
        "params": {
            "k": 100
        }
    },
    "limit": 10,
    "outputFields": ["product_name", "price", "category"]
}
EOF
ハイブリッド検索の詳細については、マルチベクトルハイブリッド検索 を参照してください。