検索向けデータモデル設計
情報検索システムは検索エンジンとも呼ばれ、Retrieval-augmented generation(RAG)、画像検索、商品レコメンデーションなど、さまざまな AI アプリケーションに欠かせないものです。こうしたシステムの中核にあるのは、情報を整理し、インデックスを作成して取得するために慎重に設計されたデータモデルです。
Zilliz Cloud では、コレクションスキーマを通じて検索データモデルを指定できます。これにより、非構造化データ、その密ベクトルまたは疎ベクトル表現、および構造化メタデータを整理できます。テキスト、画像、その他のデータ型を扱う場合でも、このハンズオンガイドは、主要なスキーマの概念を理解し、実際に検索データモデルを設計するのに役立ちます。
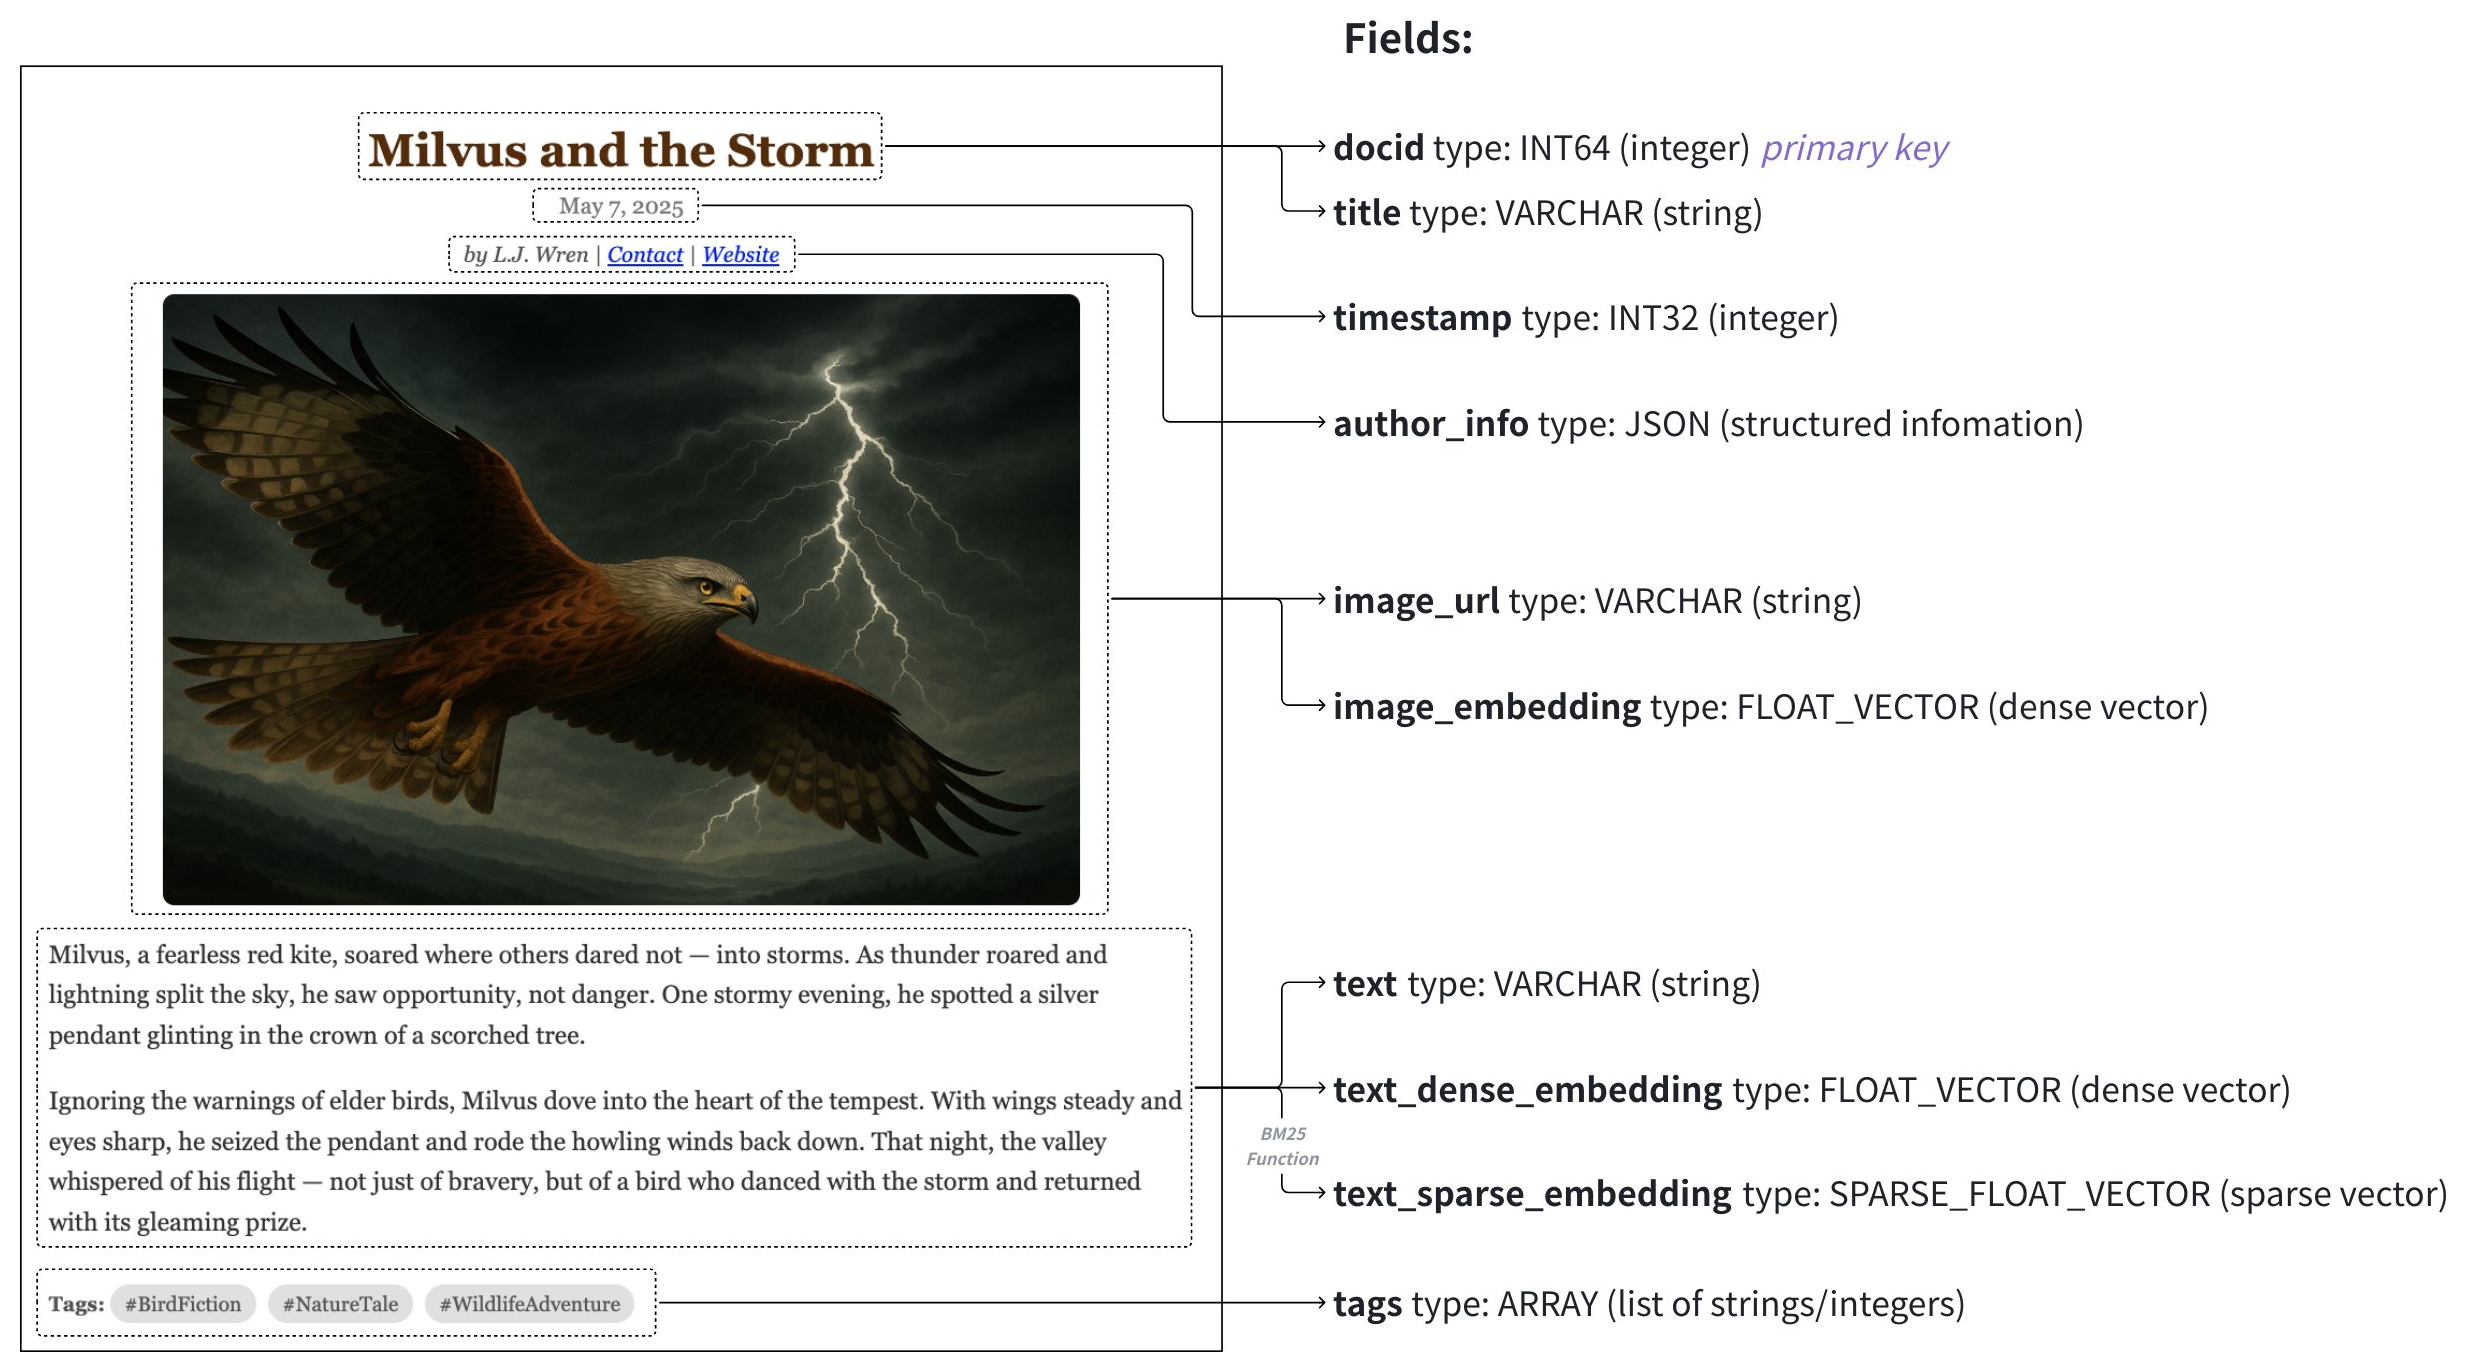
データモデル
検索システムのデータモデル設計では、ビジネスニーズを分析し、情報をスキーマで表現されたデータモデルに抽象化します。適切に定義されたスキーマは、データモデルをビジネス目標に合わせ、データの一貫性とサービス品質を確保するうえで重要です。また、適切なデータ型とインデックスを選択することは、ビジネス目標を経済的に達成するうえで重要です。
ビジネスニーズの分析
ビジネスニーズに効果的に対応するには、まずユーザーが実行するクエリの種類を分析し、最適な検索方法を決定します。
-
ユーザークエリ: ユーザーが実行すると想定されるクエリの種類を特定します。これにより、スキーマが実際のユースケースをサポートし、検索パフォーマンスを最適化できるようになります。クエリには次のものが含まれます。
-
自然言語クエリに一致するドキュメントを取得します。
-
参照画像に類似する画像、またはテキストの説明に一致する画像を検索します。
-
名前、カテゴリ、ブランドなどの属性で商品を検索します。
-
構造化メタデータ(公開日、タグ、評価など)に基づいてアイテムをフィルタリングします。
-
ハイブリッドクエリで複数の条件を組み合わせます(例:画像検索で、画像とそのキャプションの両方の意味的類似性を考慮します)。
-
-
検索方法: ユーザーが実行するクエリの種類に合った検索手法を選択します。方法ごとに目的が異なり、多くの場合、組み合わせることでより強力な結果を得られます。
-
セマンティック検索: 密ベクトルの類似性を使用して、意味が類似するアイテムを見つけます。テキストや画像などの非構造化データに適しています。
-
全文検索: キーワードマッチングでセマンティック検索を補完します。全文検索では字句解析を利用して、長い単語が断片化されたトークンに分割されるのを防ぎ、取得時に特殊な用語を捉えることができます。
-
メタデータフィルタリング: ベクトル検索に加えて、日付範囲、カテゴリ、タグなどの制約を適用します。
-
ビジネス要件を検索データモデルに変換する
次のステップでは、情報の主要な構成要素とその検索方法を特定し、ビジネス要件を具体的なデータモデルに変換します。
-
保存する必要があるデータを定義します。たとえば、生のコンテンツ(テキスト、画像、音声)、関連するメタデータ(タイトル、タグ、著者情報)、コンテキスト属性(タイムスタンプ、ユーザー行動など)です。
-
各要素に適したデータ型と形式を決定します。たとえば、次のとおりです。
-
テキストの説明 → string
-
画像またはドキュメントの埋め込み → 密ベクトルまたは疎ベクトル
-
カテゴリ、タグ、フラグ → string、array、bool
-
価格や評価などの数値属性 → integer または float
-
著者情報などの構造化情報 -> json
-
これらの要素を明確に定義することで、データの一貫性、正確な検索結果、および下流のアプリケーションロジックとの統合の容易さが確保されます。
スキーマ設計
Zilliz Cloud では、データモデルはコレクションスキーマで表現されます。コレクションスキーマ内の適切なフィールドを設計することが、効果的な取得を可能にする鍵です。各フィールドはコレクションに保存される特定の種類のデータを定義し、検索プロセスにおいてそれぞれ異なる役割を果たします。大まかに言うと、Zilliz Cloud は ベクトルフィールドとスカラーフィールドという 2 つの主要なフィールドタイプをサポートしています。
ここでは、ベクトルおよび補助的なスカラーフィールドを含むフィールドのスキーマにデータモデルをマッピングできます。各フィールドがデータモデルの属性と対応していることを確認し、特にベクトル型(密または疎)とその次元に注意してください。
ベクトルフィールド
ベクトルフィールドには、テキスト、画像、音声などの非構造化データ型の埋め込みが保存されます。これらの埋め込みは、データ型と使用する取得方法に応じて、密、疎、またはバイナリになります。通常、密ベクトルはセマンティック検索に使用され、疎ベクトルは全文検索や字句マッチングに適しています。バイナリベクトルは、ストレージと計算リソースが限られている場合に有用です。コレクションには、マルチモーダルまたはハイブリッド検索戦略を可能にするために、複数のベクトルフィールドを含めることができます。このトピックの詳細なガイドについては、Multi-ベクトル Hybrid Search を参照してください。
Zilliz Cloud は、Dense ベクトル 用の FLOAT_VECTOR、Sparse ベクトル 用の SPARSE_FLOAT_VECTOR、Binary ベクトル 用の BINARY_VECTOR というベクトルデータ型をサポートしています。
スカラーフィールドと複合フィールド
スカラーフィールドには、数値、文字列、日付などのプリミティブで構造化された値(一般にメタデータと呼ばれます)が保存されます。これらの値はベクトル検索結果とともに返すことができ、フィルタリングと並べ替えに不可欠です。特定の属性に基づいて検索結果を絞り込むことができ、たとえば、ドキュメントを特定のカテゴリや定義された期間に限定できます。
Zilliz Cloud は、非ベクトルデータの保存とフィルタリングのために、BOOL、INT8/16/32/64、FLOAT、DOUBLE、VARCHAR などのスカラー型に加えて、JSON や ARRAY などの複合型をサポートしています。これらの型は、検索操作の精度とカスタマイズ性を向上させます。
スキーマ設計で高度な機能を活用する
スキーマを設計する際、サポートされているデータ型を使用してデータをフィールドにマッピングするだけでは不十分です。フィールド間の関係と、構成に利用できる戦略を十分に理解することが重要です。設計段階で主要な機能を意識しておけば、スキーマは当面のデータ処理要件を満たすだけでなく、将来のニーズに対して拡張性と適応性を備えたものになります。これらの機能を慎重に統合することで、Zilliz Cloud の機能を最大限に活用し、より広範なデータ戦略と目標をサポートする強固なデータアーキテクチャを構築できます。コレクションスキーマを作成する主要な機能の概要は次のとおりです。
主キー
主キーフィールドは、コレクション内の各エンティティを一意に識別するため、スキーマの基本的な構成要素です。主キーの定義は必須です。主キーは整数型または文字列型のスカラーフィールドであり、is_primary=True としてマークする必要があります。必要に応じて、主キーに対して auto_id を有効にできます。この場合、コレクションに取り込まれるデータが増えるにつれて単調に増加する整数値が自動的に割り当てられます。
詳細については、Primary Field & AutoID を参照してください。
パーティショニング
検索を高速化するために、必要に応じてパーティショニングを有効にできます。パーティショニング用に特定のスカラーフィールドを指定し、検索時にこのフィールドに基づくフィルタリング条件を指定すると、検索範囲を関連するパーティションのみに効果的に限定できます。この方法は検索対象を減らすことで、取得操作の効率を大幅に向上させます。
詳細については、Use Partition Key を参照してください。
アナライザー
アナライザーは、テキストデータを処理および変換するための不可欠なツールです。主な機能は、生のテキストをトークンに変換し、インデックス作成と取得のために構造化することです。これは、文字列をトークン化し、ストップワードを削除し、個々の単語をステミングしてトークンにすることで行います。
詳細については、Analyzer Overview を参照してください。
関数
Zilliz Cloud では、スキーマの一部として組み込み関数を定義し、特定のフィールドを自動的に導出できます。たとえば、VARCHAR フィールドから疎ベクトルを生成して全文検索をサポートする組み込みの BM25 関数を追加できます。関数によって導出されるフィールドは前処理を簡素化し、コレクションが自己完結してクエリ可能な状態を維持できるようにします。
詳細については、Full Text Search を参照してください。
実践的な例
このセクションでは、上の図に示すマルチメディアドキュメント検索アプリケーションのスキーマ設計とコード例について説明します。このスキーマは、次のフィールドにマッピングされたデータを含む記事のデータセットを管理するように設計されています。
| フィールド | データソース | 使用する検索方法 | 主キー | パーティションキー | アナライザー | 関数の Input/Output |
|---|---|---|---|---|---|---|
article_id (INT64) | auto_id を有効にして自動生成 | Query using Get | Y | N | N | N |
title (VARCHAR) | 記事のタイトル | Text Match | N | N | Y | N |
timestamp (INT32) | 公開日 | Filter by Partition Key | N | Y | N | N |
text (VARCHAR) | 記事の生テキスト | Multi-Vector Hybrid Search | N | N | Y | input |
text_dense_vector (FLOAT_VECTOR) | テキスト埋め込みモデルによって生成された密ベクトル | Basic Vector Search | N | N | N | N |
text_sparse_vector (SPARSE_FLOAT_VECTOR) | 組み込みの BM25 関数によって自動生成された疎ベクトル | Full Text Search | N | N | N | output |
スキーマの詳細と、さまざまな種類のフィールドを追加する方法の詳しいガイダンスについては、スキーマ Explained を参照してください。
ステップ 1: スキーマを初期化する
まず、空のスキーマを作成する必要があります。このステップでは、データモデルを定義するための基盤となる構造を確立します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient, DataType, Function, FunctionType

schema = MilvusClient.create_schema()
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;
import java.util.*;

// 1. Connect to Milvus server
ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();

MilvusClientV2 client = new MilvusClientV2(connectConfig);

// 2. Create an empty schema
CreateCollectionReq.CollectionSchema schema = client.createSchema();
import (
    "github.com/milvus-io/milvus/client/v3/entity"
)

schema := entity.NewSchema()
use milvus::v2::prelude::*;

let schema = CollectionSchema::new();
#include <iostream>
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

//Skip this step using JavaScript
using Milvus.Client.V2.Types;

CollectionSchema schema = new();
# Skip this step using cURL
ステップ 2: フィールドを追加する
スキーマを作成したら、次にデータを構成するフィールドを指定します。各フィールドは、それぞれのデータ型と属性に関連付けられています。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
schema.add_field(field_name="article_id", datatype=DataType.INT64, is_primary=True, auto_id=True, description="article id")
schema.add_field(field_name="title", datatype=DataType.VARCHAR, enable_analyzer=True, enable_match=True, max_length=200, description="article title")
schema.add_field(field_name="timestamp", datatype=DataType.INT32, description="publish date")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=2000, enable_analyzer=True, description="article text content")
schema.add_field(field_name="text_dense_vector", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense vector")
schema.add_field(field_name="text_sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse vector")
schema.addField(AddFieldReq.builder()
        .fieldName("article_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("timestamp")
        .dataType(DataType.Int32)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(2000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text_dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse_vector")
        .dataType(DataType.SparseFloatVector)
        .build());
schema.WithField(entity.NewField().
    WithName("article_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithDescription("article id"),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(200).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithDescription("article title"),
).WithField(entity.NewField().
    WithName("timestamp").
    WithDataType(entity.FieldTypeInt32).
    WithDescription("publish date"),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(2000).
    WithEnableAnalyzer(true).
    WithDescription("article text content"),
).WithField(entity.NewField().
    WithName("text_dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768).
    WithDescription("text dense vector"),
).WithField(entity.NewField().
    WithName("text_sparse_vector").
    WithDataType(entity.FieldTypeSparseVector).
    WithDescription("text sparse vector"),
)
let schema = schema
    .add_field(FieldSchema::new()
        .name("article_id")
        .data_type(DataType::Int64)
        .primary_key(true)
        .auto_id(true)
        .description("article id"))
    .add_field(FieldSchema::new()
        .name("title")
        .data_type(DataType::VarChar)
        .max_length(200)
        .enable_analyzer(true)
        .enable_match(true)
        .description("article title"))
    .add_field(FieldSchema::new()
        .name("timestamp")
        .data_type(DataType::Int32)
        .description("publish date"))
    .add_field(FieldSchema::new()
        .name("text")
        .data_type(DataType::VarChar)
        .max_length(2000)
        .enable_analyzer(true)
        .description("article text content"))
    .add_field(FieldSchema::new()
        .name("text_dense_vector")
        .data_type(DataType::FloatVector)
        .dimension(768)
        .description("text dense vector"))
    .add_field(FieldSchema::new()
        .name("text_sparse_vector")
        .data_type(DataType::SparseFloatVector)
        .description("text sparse vector"));
schema->AddField({"article_id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("title", milvus::DataType::VARCHAR)
                    .WithMaxLength(200).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("timestamp", milvus::DataType::INT32));
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)
                    .WithMaxLength(2000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense_vector", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField(milvus::FieldSchema("text_sparse_vector", milvus::DataType::SPARSE_FLOAT_VECTOR));
const fields = [
    {
        name: "article_id",
        data_type: DataType.Int64,
        is_primary_key: true,
        autoID: true
    },
    {
        name: "title",
        data_type: DataType.VarChar,
        max_length: 200,
        enable_analyzer: true,
        enable_match: true
    },
    {
        name: "timestamp",
        data_type: DataType.Int32
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 2000,
        enable_analyzer: true
    },
    {
        name: "text_dense_vector",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse_vector",
        data_type: DataType.SparseFloatVector
    }
]
schema.Fields.Add(new FieldSchema("article_id", DataType.Int64, isPrimaryKey: true, autoId: true, description: "article id"));
schema.Fields.Add(FieldSchema.CreateVarchar("title", 200, description: "article title", enableAnalyzer: true, enableMatch: true));
schema.Fields.Add(new FieldSchema("timestamp", DataType.Int32, description: "publish date"));
schema.Fields.Add(FieldSchema.CreateVarchar("text", 2000, description: "article text content", enableAnalyzer: true));
schema.Fields.Add(new FieldSchema("text_dense_vector", DataType.FloatVector, description: "text dense vector") { Dimension = 768 });
schema.Fields.Add(new FieldSchema("text_sparse_vector", DataType.SparseFloatVector, description: "text sparse vector"));
export fields='[
    {
        "fieldName": "article_id",
        "dataType": "Int64",
        "isPrimary": true
    },
    {
        "fieldName": "title",
        "dataType": "VarChar",
        "elementTypeParams": {
            "max_length": 200,
            "enable_analyzer": true,
            "enable_match": true
        }
    },
    {
        "fieldName": "timestamp",
        "dataType": "Int32"
    },
    {
       "fieldName": "text",
       "dataType": "VarChar",
       "elementTypeParams": {
            "max_length": 2000,
            "enable_analyzer": true
        }
    },
    {
       "fieldName": "text_dense_vector",
       "dataType": "FloatVector",
       "elementTypeParams": {
            "dim": 768
        }
    },
    {
       "fieldName": "text_sparse_vector",
       "dataType": "SparseFloatVector"
    }
]'

export schema="{
    \"autoID\": true,
    \"fields\": $fields
}"
この例では、フィールドに次の属性が指定されています。
-
主キー:
article_idを主キーとして使用し、受信するエンティティに主キーを自動的に割り当てます。 -
パーティションキー:
timestampをパーティションキーとして割り当て、パーティションによるフィルタリングを可能にします。 -
テキストアナライザー: 2 つの文字列フィールド
titleとtextにテキストアナライザーを適用し、それぞれテキストマッチングと全文検索をサポートします。
ステップ 3:(オプション)関数を追加する
データクエリ機能を強化するために、関数をスキーマに組み込むことができます。たとえば、特定のフィールドに関連する処理を行う関数を作成できます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
bm25_function = Function(
    name="text_bm25",
    input_field_names=["text"],
    output_field_names=["text_sparse_vector"],
    function_type=FunctionType.BM25,
)

schema.add_function(bm25_function)
schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse_vector"))
        .build());
function := entity.NewFunction().
    WithName("text_bm25").
    WithInputFields("text").
    WithOutputFields("text_sparse_vector").
    WithType(entity.FunctionTypeBM25)
schema.WithFunction(function)
let schema = schema.add_function(
    Function::new()
        .name("text_bm25")
        .function_type(FunctionType::Bm25)
        .input_fields(["text"])
        .output_fields(["text_sparse_vector"]),
);
milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25", milvus::FunctionType::BM25);
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse_vector");
schema->AddFunction(function);
const functions = [
    {
      name: 'text_bm25',
      description: 'bm25 function',
      type: FunctionType.BM25,
      input_field_names: ['text'],
      output_field_names: ['text_sparse_vector'],
      params: {},
    },
];
FunctionSchema bm25Function = FunctionSchema.CreateBm25("text_bm25", "text", "text_sparse_vector", "bm25 function");
schema.Functions.Add(bm25Function);
export myFunctions='[
    {
        "name": "text_bm25",
        "type": "BM25",
        "inputFieldNames": ["text"],
        "outputFieldNames": ["text_sparse_vector"],
        "params": {}
    }
]'

export schema="{
    \"autoID\": true,
    \"fields\": $fields,
    \"functions\": $myFunctions
}"
この例では、スキーマに組み込みの BM25 関数を追加し、text フィールドを入力として使用して、生成された疎ベクトルを text_sparse_vector フィールドに保存します。