Search Aggregation
買い物客が「毎日のトレーニング用の黒いランニングシューズ」を検索すると、近似最近傍(ANN)検索はベクトル類似度に基づいて商品をランク付けし、フラットな Top-K リストを返します。結果は関連性が高いこともありますが、重複が生じます。以下の例では、最初の 6 件のうち 4 件がブランド A の商品で、ブランド B とブランド C はそれぞれ 1 件ずつしか出現しません。
フラットなリストでは、バケット単位のサマリーを直接提供できません。アプリケーションによっては、保持された候補数や平均価格でブランドを比較したり、各ブランドから少数の代表的な商品を確認したり、結果を複数のバケット階層に整理したりする必要があります。
Search Aggregation は、保持された ANN 候補を、選択したスカラーフィールドに基づいてバケットに整理します。この例では、各ブランドが個別のバケットになります。Zilliz Cloud は、各バケットの統計を計算し、バケットを並べ替え、代表的な商品を添付できます。アプリケーションは、このバケット優先のレスポンスを result.agg_buckets を通じて受け取ります。
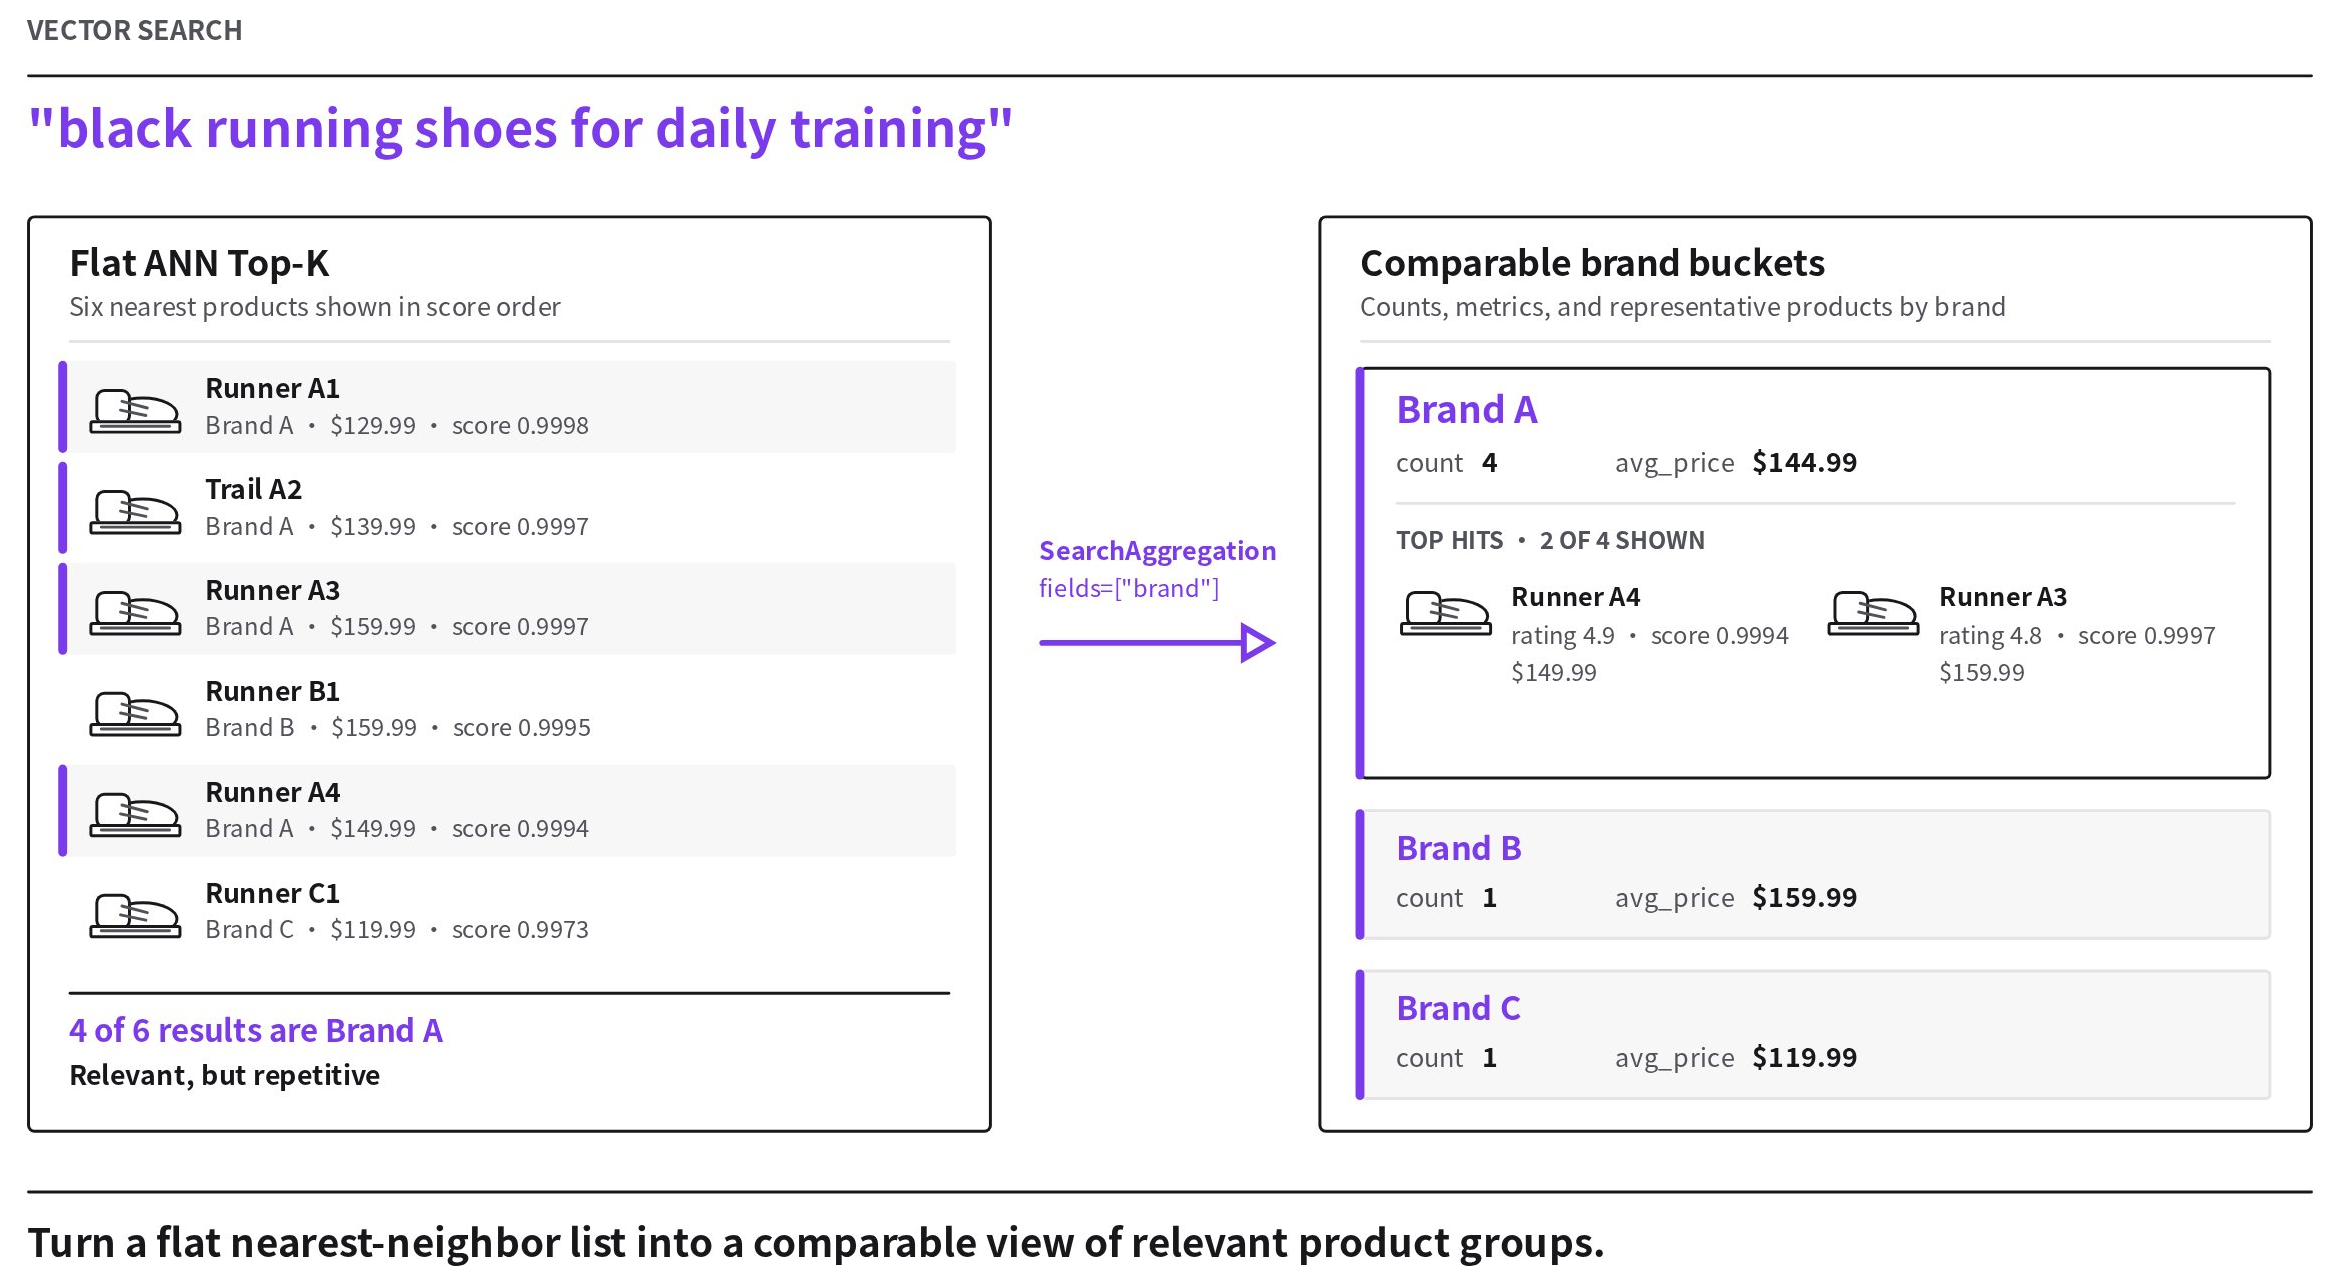
Search Aggregation は、コレクション全体を対象とした厳密な集計を実行しません。バケットの存在、件数、メトリクス、順序、および代表ヒットは、ANN ステージとグループ化ステージで保持された候補に依存します。
仕組み
-
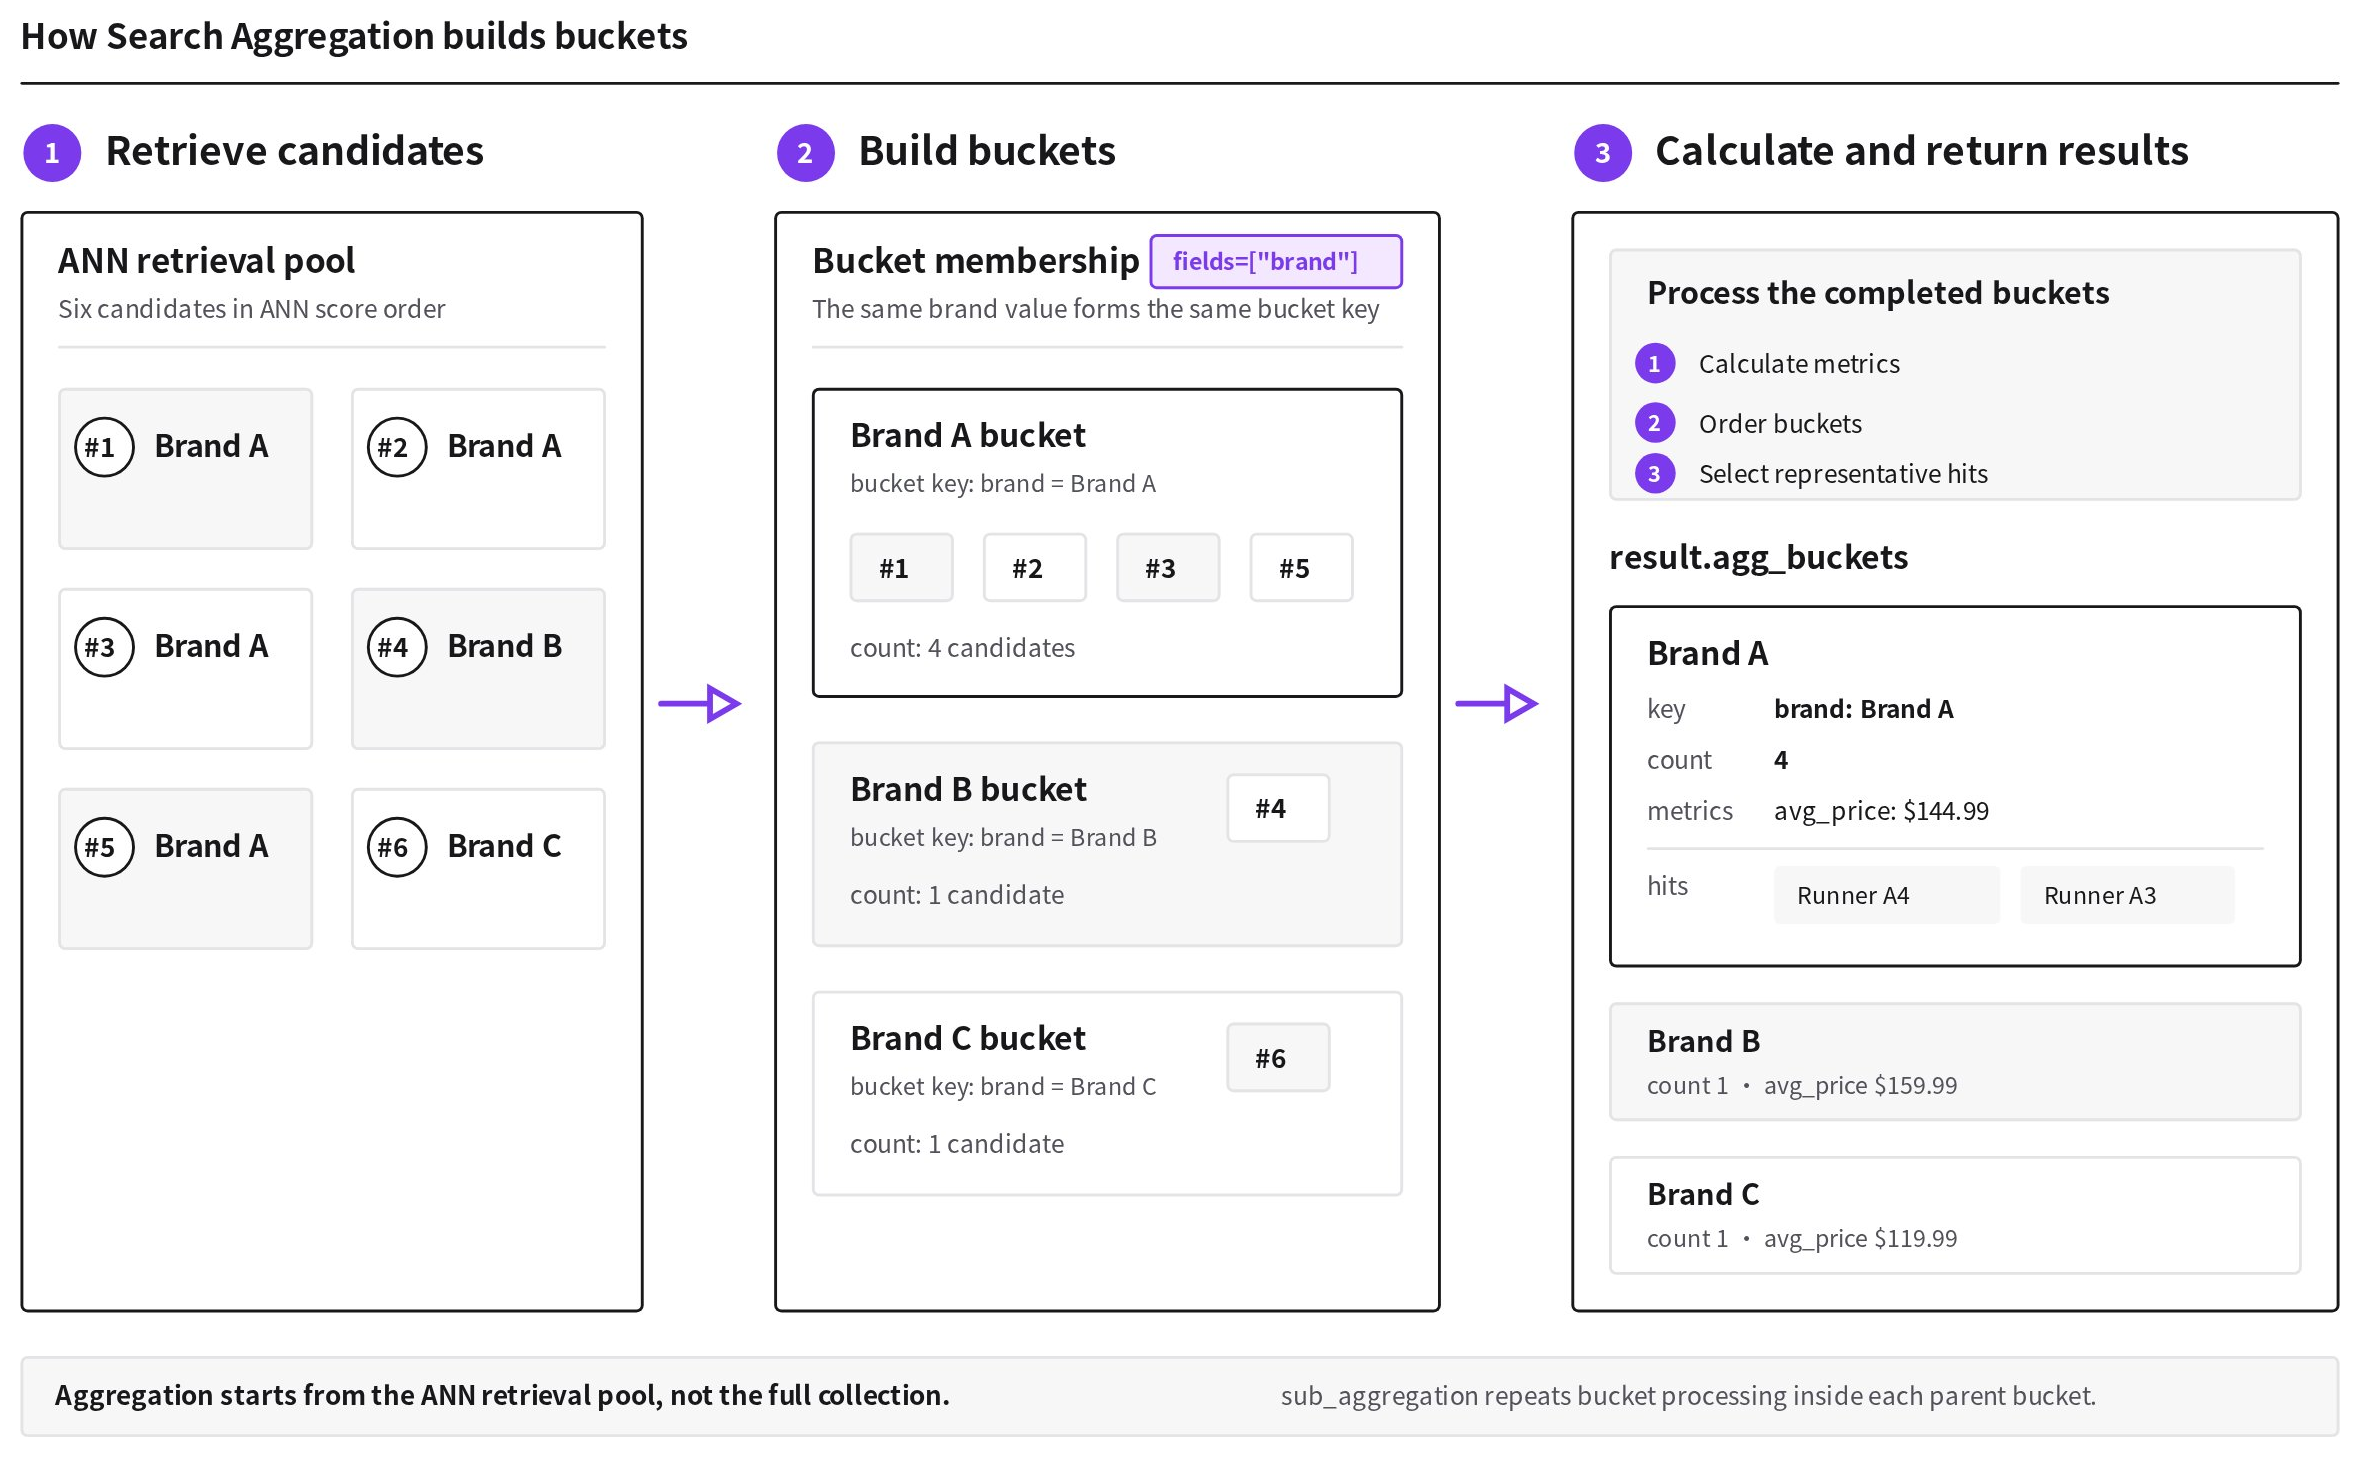
候補の取得。 Zilliz Cloud は ANN 検索を実行し、クエリベクトルに最も近いエンティティを検索します。次に、グループ化ステージが完全な複合キーごとに一定数の候補を保持します。このキーごとの候補バジェットは、集計ツリー内のどこかで最大の
TopHits.sizeであるか、どのレベルでもtop_hitsを設定しない場合は1です。 -
バケットの構築。
SearchAggregation.fieldsパラメーターがバケットキーを定義します。フィールド値の一意の組み合わせごとに個別のキーが作成されます。図では、fields=["brand"]によって(Brand A)、(Brand B)、(Brand C)のバケットキーが作成されます。同じキーを持つ保持候補は同じバケットに属し、そのcountに寄与します。SearchAggregation.sizeは、Zilliz Cloud が返すバケット数を制限します。 -
結果の計算と返却。 返される各バケットには、そのキーと保持された候補数が含まれます。Zilliz Cloud は、設定されたメトリクスの計算、バケットの並べ替え、代表エンティティの返却、子バケットの構築も実行できます。
result.agg_buckets内の各AggregationBucketは、key、count、metrics、hits、sub_groupsを公開します。Search Aggregation が有効な場合、通常の検索ヒットリストは空になります。
図では、TopHits.size=4 がキーごとの候補バジェットを 4 に設定するため、保持された 4 件のブランド A 候補から count: 4 が生成されます。完成したブランド A カードには、図を簡潔に保つため、返された 4 件の代表ヒットのうち 2 件のみが表示されています。
sub_aggregation を使用すると、Zilliz Cloud は各親バケット内でステップ 2 と 3 を繰り返します。ANN の再現率やキーごとの候補バジェットが変化すると、バケットの件数、メトリクス、順序、ヒット、およびネストされた結果が変化する可能性があります。
制限事項
Search Aggregation を使用する前に、以下の制限事項に注意してください。
-
ネストされた集計: 1 つのリクエストには、1 つのルート
SearchAggregationと最大 3 レベルのネストされたsub_aggregationを含めることができ、合計で最大 4 レベルになります。すべてのレベルを通じて、バケットキーの作成に使用できるフィールドは最大 10 個です。 -
バケットキーの作成に使用するフィールド。
SearchAggregation.fieldsパラメーターは、Boolean、整数、VARCHAR、TIMESTAMPTZフィールドをサポートします。FLOAT、DOUBLE、ARRAY、JSON、GEOMETRY、TEXT、ベクトル、動的フィールドはサポートしません。 -
メトリクスフィールド。
count操作は"*"または任意の非JSONかつ非動的フィールドを受け入れ、フィールドを指定した場合はNULL値をスキップします。sumとavgは整数および浮動小数点フィールドを受け入れます。minとmaxは、さらに文字列およびTIMESTAMPTZフィールドを受け入れます。 -
Top Hits のソートフィールド。
TopHits.sortパラメーターは、比較可能な Boolean、整数、浮動小数点、文字列、TIMESTAMPTZフィールドに加えて_scoreを受け入れます。ARRAY、JSON、GEOMETRY、ベクトル、動的フィールドはサポートしません。 -
候補バジェット: 集計ツリー内のどこかで最大の
TopHits.sizeは、完全な複合キーごとに保持される候補数でもあります。どのレベルでもtop_hitsを設定しない場合、Zilliz Cloud はキーごとに 1 件の候補を保持します。バケットのcountとメトリクスはこれらの保持された候補から計算されるため、TopHits.sizeを変更するとそれらも変わる可能性があります。 -
null 許容のバケットフィールド:
NULL値は独自のバケットキーを形成します。null バケットを除外するには、検索リクエストにbrand is not nullなどのフィルターを追加します。 -
重複するフィールド: 同じフィールドを複数の
SearchAggregation.fieldsリストに含めることはできません。例えば、ルート集計でfields=["category"]を使用する場合、ネストされたsub_aggregationでもfields=["category"]を使用することはできません。 -
サポートされない組み合わせ: Search Aggregation は、ゼロ以外の
offset、Search Iterators、Hybrid Search、Highlighter、Grouping Search と組み合わせることはできません。トップレベルのoffset値が0の場合は、パラメーターを省略した場合と同じです。REST v2 プロトコルレベルでは、searchAggregationとidsを同時に指定することはできません。 -
返されるエントリ数。 計算される結果エントリの最大数を 10,000 以下に保ってください。サーバーはこの最大値を
number of query vectors × product of the effective search_size at every aggregation level × largest TopHits.size at any levelとして計算します。どのレベルでも
TopHitsを設定しない場合は、最後の係数に1を使用します。例えば、1 つのクエリベクトル、10 個のルートバケット、ルートバケットあたり 5 個の子バケット、子バケットあたり 2 件のヒットの場合、計算される最大値は1 × 10 × 5 × 2 = 100です。
Search Aggregation の使用
達成したい内容に基づいて例を選択してください。
| 移動先 | 説明 | 主な設定 |
|---|---|---|
| バケットの比較と並べ替え | バケットごとの統計を計算してバケットを比較し、返されたバケットをメトリクス、件数、またはキーで並べ替えます。 | fields、size、metrics、order |
| 各バケットから代表的な結果を表示 | 各バケットから限られた数のエンティティを返し、それらのエンティティをスカラーフィールドまたはベクトルスコアで個別に並べ替えます。 | top_hits、TopHits.size、TopHits.sort |
| 複数レベルでの結果のグループ化 | 結果を親バケットと子バケットのレベルに整理し、複数のディメンションを順番に分析します。 | sub_aggregation |
以下の例では、brand、category、color、price、rating の各フィールドを持つ商品コレクションを使用します。すべてのブランド名、商品名、価格、評価、検索結果は合成されたサンプルデータです。次のセクションを展開して、コレクションを作成し、共通の検索変数を定義してください。
サンプルコレクションのセットアップ
- Python
- Java
- NodeJS
- Go
- cURL
from pymilvus import DataType, MilvusClient, SearchAggregation, TopHits

client = MilvusClient(
    uri="YOUR_CLUSTER_OR_PROJECT_ENDPOINT",
    token="YOUR_AUTHORIZED_TOKEN",
)

collection_name = "product_search_aggregation"

if client.has_collection(collection_name):
    client.drop_collection(collection_name)

schema = client.create_schema(auto_id=False, enable_dynamic_field=False)
schema.add_field("id", DataType.INT64, is_primary=True)
schema.add_field("embedding", DataType.FLOAT_VECTOR, dim=5)
schema.add_field("name", DataType.VARCHAR, max_length=200)
schema.add_field("brand", DataType.VARCHAR, max_length=100)
schema.add_field("category", DataType.VARCHAR, max_length=100)
schema.add_field("color", DataType.VARCHAR, max_length=50)
schema.add_field("price", DataType.DOUBLE)
schema.add_field("rating", DataType.DOUBLE)
schema.add_field("in_stock", DataType.BOOL)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE",
)

client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params,
    # Make preceding writes visible to searches from this client.
    consistency_level="Session",
)

client.insert(
    collection_name=collection_name,
    data=[
        {
            "id": 1,
            "embedding": [0.12, 0.42, 0.18, 0.66, 0.31],
            "name": "Runner A1",
            "brand": "Brand A",
            "category": "running_shoes",
            "color": "black",
            "price": 129.99,
            "rating": 4.7,
            "in_stock": True,
        },
        {
            "id": 2,
            "embedding": [0.10, 0.39, 0.20, 0.61, 0.29],
            "name": "Trail A2",
            "brand": "Brand A",
            "category": "running_shoes",
            "color": "blue",
            "price": 139.99,
            "rating": 4.6,
            "in_stock": True,
        },
        {
            "id": 3,
            "embedding": [0.14, 0.44, 0.19, 0.68, 0.33],
            "name": "Runner B1",
            "brand": "Brand B",
            "category": "running_shoes",
            "color": "white",
            "price": 159.99,
            "rating": 4.8,
            "in_stock": True,
        },
        {
            "id": 4,
            "embedding": [0.16, 0.41, 0.22, 0.62, 0.30],
            "name": "Runner C1",
            "brand": "Brand C",
            "category": "running_shoes",
            "color": "red",
            "price": 119.99,
            "rating": 4.4,
            "in_stock": False,
        },
        {
            "id": 5,
            "embedding": [0.48, 0.20, 0.59, 0.15, 0.71],
            "name": "Jacket A1",
            "brand": "Brand A",
            "category": "jackets",
            "color": "black",
            "price": 99.99,
            "rating": 4.5,
            "in_stock": True,
        },
        {
            "id": 6,
            "embedding": [0.45, 0.18, 0.55, 0.17, 0.69],
            "name": "Jacket B1",
            "brand": "Brand B",
            "category": "jackets",
            "color": "blue",
            "price": 89.99,
            "rating": 4.3,
            "in_stock": True,
        },
        {
            "id": 7,
            "embedding": [0.09, 0.38, 0.17, 0.60, 0.27],
            "name": "Runner A3",
            "brand": "Brand A",
            "category": "running_shoes",
            "color": "black",
            "price": 159.99,
            "rating": 4.8,
            "in_stock": True,
        },
        {
            "id": 8,
            "embedding": [0.13, 0.43, 0.21, 0.65, 0.32],
            "name": "Runner A4",
            "brand": "Brand A",
            "category": "running_shoes",
            "color": "black",
            "price": 149.99,
            "rating": 4.9,
            "in_stock": True,
        },
    ],
)

client.load_collection(collection_name)

query_vector = [0.11, 0.40, 0.19, 0.64, 0.30]
search_params = {
    "metric_type": "COSINE",
    "params": {},
}
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.vector.request.InsertReq;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN").build());
String collectionName = "product_search_aggregation";

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder().build();
schema.addField(AddFieldReq.builder().fieldName("id").dataType(DataType.Int64).isPrimaryKey(true).autoID(false).build());
schema.addField(AddFieldReq.builder().fieldName("embedding").dataType(DataType.FloatVector).dimension(5).build());
schema.addField(AddFieldReq.builder().fieldName("name").dataType(DataType.VarChar).maxLength(200).build());
schema.addField(AddFieldReq.builder().fieldName("brand").dataType(DataType.VarChar).maxLength(100).build());
schema.addField(AddFieldReq.builder().fieldName("category").dataType(DataType.VarChar).maxLength(100).build());
schema.addField(AddFieldReq.builder().fieldName("color").dataType(DataType.VarChar).maxLength(50).build());
schema.addField(AddFieldReq.builder().fieldName("price").dataType(DataType.Double).build());
schema.addField(AddFieldReq.builder().fieldName("rating").dataType(DataType.Double).build());
schema.addField(AddFieldReq.builder().fieldName("in_stock").dataType(DataType.Bool).build());

client.createCollection(CreateCollectionReq.builder().collectionName(collectionName).collectionSchema(schema)
        .indexParams(Collections.singletonList(IndexParam.builder().fieldName("embedding")
                .indexType(IndexParam.IndexType.AUTOINDEX).metricType(IndexParam.MetricType.COSINE).build()))
        .build());

List<JsonObject> data = Arrays.asList(
        product(1, new float[]{0.12f, 0.42f, 0.18f, 0.66f, 0.31f}, "Runner A1", "Brand A", "running_shoes", "black", 129.99, 4.7, true),
        product(2, new float[]{0.10f, 0.39f, 0.20f, 0.61f, 0.29f}, "Trail A2", "Brand A", "running_shoes", "blue", 139.99, 4.6, true),
        product(3, new float[]{0.14f, 0.44f, 0.19f, 0.68f, 0.33f}, "Runner B1", "Brand B", "running_shoes", "white", 159.99, 4.8, true),
        product(4, new float[]{0.16f, 0.41f, 0.22f, 0.62f, 0.30f}, "Runner C1", "Brand C", "running_shoes", "red", 119.99, 4.4, false),
        product(5, new float[]{0.48f, 0.20f, 0.59f, 0.15f, 0.71f}, "Jacket A1", "Brand A", "jackets", "black", 99.99, 4.5, true),
        product(6, new float[]{0.45f, 0.18f, 0.55f, 0.17f, 0.69f}, "Jacket B1", "Brand B", "jackets", "blue", 89.99, 4.3, true),
        product(7, new float[]{0.09f, 0.38f, 0.17f, 0.60f, 0.27f}, "Runner A3", "Brand A", "running_shoes", "black", 159.99, 4.8, true),
        product(8, new float[]{0.13f, 0.43f, 0.21f, 0.65f, 0.32f}, "Runner A4", "Brand A", "running_shoes", "black", 149.99, 4.9, true));
client.insert(InsertReq.builder().collectionName(collectionName).data(data).build());

List<Float> queryVector = Arrays.asList(0.11f, 0.40f, 0.19f, 0.64f, 0.30f);

private static JsonObject product(long id, float[] embedding, String name, String brand,
                                  String category, String color, double price, double rating,
                                  boolean inStock) {
    JsonObject row = new JsonObject();
    row.addProperty("id", id);
    row.add("embedding", new Gson().toJsonTree(embedding));
    row.addProperty("name", name);
    row.addProperty("brand", brand);
    row.addProperty("category", category);
    row.addProperty("color", color);
    row.addProperty("price", price);
    row.addProperty("rating", rating);
    row.addProperty("in_stock", inStock);
    return row;
}
const { DataType, MilvusClient } = require('@zilliz/milvus2-sdk-node');

const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT', username: 'root', password: 'Milvus',
});
const collectionName = 'product_search_aggregation';

if ((await client.hasCollection({ collection_name: collectionName })).value) {
  await client.dropCollection({ collection_name: collectionName });
}
await client.createCollection({
  collection_name: collectionName,
  consistency_level: 'Session',
  fields: [
    { name: 'id', data_type: DataType.Int64, is_primary_key: true, autoID: false },
    { name: 'embedding', data_type: DataType.FloatVector, dim: 5 },
    { name: 'name', data_type: DataType.VarChar, max_length: 200 },
    { name: 'brand', data_type: DataType.VarChar, max_length: 100 },
    { name: 'category', data_type: DataType.VarChar, max_length: 100 },
    { name: 'color', data_type: DataType.VarChar, max_length: 50 },
    { name: 'price', data_type: DataType.Double },
    { name: 'rating', data_type: DataType.Double },
    { name: 'in_stock', data_type: DataType.Bool },
  ],
});

const data = [
  { id: 1, embedding: [0.12, 0.42, 0.18, 0.66, 0.31], name: 'Runner A1', brand: 'Brand A', category: 'running_shoes', color: 'black', price: 129.99, rating: 4.7, in_stock: true },
  { id: 2, embedding: [0.10, 0.39, 0.20, 0.61, 0.29], name: 'Trail A2', brand: 'Brand A', category: 'running_shoes', color: 'blue', price: 139.99, rating: 4.6, in_stock: true },
  { id: 3, embedding: [0.14, 0.44, 0.19, 0.68, 0.33], name: 'Runner B1', brand: 'Brand B', category: 'running_shoes', color: 'white', price: 159.99, rating: 4.8, in_stock: true },
  { id: 4, embedding: [0.16, 0.41, 0.22, 0.62, 0.30], name: 'Runner C1', brand: 'Brand C', category: 'running_shoes', color: 'red', price: 119.99, rating: 4.4, in_stock: false },
  { id: 5, embedding: [0.48, 0.20, 0.59, 0.15, 0.71], name: 'Jacket A1', brand: 'Brand A', category: 'jackets', color: 'black', price: 99.99, rating: 4.5, in_stock: true },
  { id: 6, embedding: [0.45, 0.18, 0.55, 0.17, 0.69], name: 'Jacket B1', brand: 'Brand B', category: 'jackets', color: 'blue', price: 89.99, rating: 4.3, in_stock: true },
  { id: 7, embedding: [0.09, 0.38, 0.17, 0.60, 0.27], name: 'Runner A3', brand: 'Brand A', category: 'running_shoes', color: 'black', price: 159.99, rating: 4.8, in_stock: true },
  { id: 8, embedding: [0.13, 0.43, 0.21, 0.65, 0.32], name: 'Runner A4', brand: 'Brand A', category: 'running_shoes', color: 'black', price: 149.99, rating: 4.9, in_stock: true },
];
await client.insert({ collection_name: collectionName, data });
await client.createIndex({ collection_name: collectionName, field_name: 'embedding', index_type: 'AUTOINDEX', metric_type: 'COSINE' });
await client.loadCollectionSync({ collection_name: collectionName });

const queryVector = [0.11, 0.40, 0.19, 0.64, 0.30];
const searchParams = { metric_type: 'COSINE', params: {} };
// TBD: Search Aggregation is not yet available in the released Go SDK.
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"
export COLLECTION_NAME="product_search_aggregation"
search() {
  curl --request POST \
    --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
    --header "Authorization: Bearer ${TOKEN}" \
    --header "Content-Type: application/json" \
    --data "$1"
}
schema='{"autoID":false,"enableDynamicField":false,"fields":[{"fieldName":"id","dataType":"Int64","isPrimary":true},{"fieldName":"embedding","dataType":"FloatVector","elementTypeParams":{"dim":5}},{"fieldName":"name","dataType":"VarChar","elementTypeParams":{"max_length":200}},{"fieldName":"brand","dataType":"VarChar","elementTypeParams":{"max_length":100}},{"fieldName":"category","dataType":"VarChar","elementTypeParams":{"max_length":100}},{"fieldName":"color","dataType":"VarChar","elementTypeParams":{"max_length":50}},{"fieldName":"price","dataType":"Double"},{"fieldName":"rating","dataType":"Double"},{"fieldName":"in_stock","dataType":"Bool"}]}'
indexParams='[{"fieldName":"embedding","indexType":"AUTOINDEX","metricType":"COSINE"}]'
data='[{"id":1,"embedding":[0.12,0.42,0.18,0.66,0.31],"name":"Runner A1","brand":"Brand A","category":"running_shoes","color":"black","price":129.99,"rating":4.7,"in_stock":true},{"id":2,"embedding":[0.10,0.39,0.20,0.61,0.29],"name":"Trail A2","brand":"Brand A","category":"running_shoes","color":"blue","price":139.99,"rating":4.6,"in_stock":true},{"id":3,"embedding":[0.14,0.44,0.19,0.68,0.33],"name":"Runner B1","brand":"Brand B","category":"running_shoes","color":"white","price":159.99,"rating":4.8,"in_stock":true},{"id":4,"embedding":[0.16,0.41,0.22,0.62,0.30],"name":"Runner C1","brand":"Brand C","category":"running_shoes","color":"red","price":119.99,"rating":4.4,"in_stock":false},{"id":5,"embedding":[0.48,0.20,0.59,0.15,0.71],"name":"Jacket A1","brand":"Brand A","category":"jackets","color":"black","price":99.99,"rating":4.5,"in_stock":true},{"id":6,"embedding":[0.45,0.18,0.55,0.17,0.69],"name":"Jacket B1","brand":"Brand B","category":"jackets","color":"blue","price":89.99,"rating":4.3,"in_stock":true},{"id":7,"embedding":[0.09,0.38,0.17,0.60,0.27],"name":"Runner A3","brand":"Brand A","category":"running_shoes","color":"black","price":159.99,"rating":4.8,"in_stock":true},{"id":8,"embedding":[0.13,0.43,0.21,0.65,0.32],"name":"Runner A4","brand":"Brand A","category":"running_shoes","color":"black","price":149.99,"rating":4.9,"in_stock":true}]'
curl --request POST --url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" --header "Authorization: Bearer ${TOKEN}" --header "Content-Type: application/json" --data "{\"collectionName\":\"${COLLECTION_NAME}\",\"schema\":${schema},\"indexParams\":${indexParams}}"
curl --request POST --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" --header "Authorization: Bearer ${TOKEN}" --header "Content-Type: application/json" --data "{\"collectionName\":\"${COLLECTION_NAME}\",\"data\":${data}}"
curl --request POST --url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/load" --header "Authorization: Bearer ${TOKEN}" --header "Content-Type: application/json" --data "{\"collectionName\":\"${COLLECTION_NAME}\"}"
上記のセットアップでは、ベクトルインデックスと検索パラメーターの両方に COSINE を設定します。そのため、以降の例では {"_score": "desc"} を使用して、コサイン類似度が高いものを先に配置します。L2 などの距離メトリクスの場合は、{"_score": "asc"} を使用します。
バケットの比較と並べ替え
計算された統計を使用して取得したエンティティのグループを比較し、バケットが返される順序を制御する必要がある場合は、このパターンを使用します。この例では、Zilliz Cloud は取得した商品を brand でグループ化し、各ブランドバケットの価格メトリクスを計算し、バケットを平均価格で並べ替えます。
フィールド値ごとに 1 つ以上のエンティティを返して結果の多様性を高めることだけが目的の場合は、代わりに Grouping Search を使用してください。
次の設定では、最大 3 つのブランドバケットを作成し、各バケットのメトリクスを計算し、バケットを平均価格で並べ替えます。
- Python
- Java
- NodeJS
- Go
- cURL
aggregation = SearchAggregation(
    # Form one bucket for each distinct brand value.
    fields=["brand"],
    # Return up to three buckets at this aggregation level.
    size=3,
    # Calculate named metrics for every selected bucket.
    metrics={
        "product_count": {"count": "*"},
        "avg_price": {"avg": "price"},
        "min_price": {"min": "price"},
    },
    # Sort buckets by average price, highest first.
    order=[
        {"avg_price": "desc"},
        # If average prices are equal, sort by bucket key in ascending order.
        {"_key": "asc"},
    ],
)
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.MetricOps;
import io.milvus.v2.service.vector.request.aggregation.MetricSpec;
import io.milvus.v2.service.vector.request.aggregation.OrderSpec;
import io.milvus.v2.service.vector.request.aggregation.SearchAggregation;
import io.milvus.v2.service.vector.request.aggregation.SortSpec;
import io.milvus.v2.service.vector.request.aggregation.TopHitsSpec;
import java.util.Collections;

SearchAggregation aggregation = SearchAggregation.builder()
        .fields(Collections.singletonList("brand"))
        .size(3)
        .addMetric("product_count", MetricSpec.builder().op(MetricOps.COUNT).fieldName("*").build())
        .addMetric("avg_price", MetricSpec.builder().op(MetricOps.AVG).fieldName("price").build())
        .addMetric("min_price", MetricSpec.builder().op(MetricOps.MIN).fieldName("price").build())
        .addOrder(OrderSpec.builder().key("avg_price").direction(AggDirection.DESC).build())
        .addOrder(OrderSpec.builder().key("_key").direction(AggDirection.ASC).build())
        .build();
const aggregation = {
  fields: ['brand'],
  size: 3,
  metrics: {
    product_count: { op: 'count', field_name: '*' },
    avg_price: { op: 'avg', field_name: 'price' },
    min_price: { op: 'min', field_name: 'price' },
  },
  order: [
    { key: 'avg_price', direction: 'desc' },
    { key: '_key', direction: 'asc' },
  ],
};
// TBD: Search Aggregation is not yet available in the released Go SDK.
payload='{
  "collectionName": "product_search_aggregation",
  "data": [[0.11, 0.40, 0.19, 0.64, 0.30]],
  "annsField": "embedding", "limit": 10,
  "searchParams": {"metric_type": "COSINE", "params": {}},
  "searchAggregation": {
    "fields": ["brand"], "size": 3,
    "metrics": {"product_count": {"op": "count", "fieldName": "*"}, "avg_price": {"op": "avg", "fieldName": "price"}, "min_price": {"op": "min", "fieldName": "price"}},
    "order": [{"key": "avg_price", "direction": "desc"}, {"key": "_key", "direction": "asc"}]
  }
}'
search "$payload"
このオブジェクトを MilvusClient.search() の search_aggregation パラメーターに渡します。
- Python
- Java
- NodeJS
- Go
- cURL
result = client.search(
    collection_name=collection_name,
    data=[query_vector],
    anns_field="embedding",
    search_params=search_params,
    output_fields=[
        "name",
        "brand",
        "category",
        "color",
        "price",
        "rating",
        "in_stock",
    ],
    search_aggregation=aggregation,
)
SearchResp result = client.search(SearchReq.builder()
        .collectionName(collectionName)
        .data(Collections.singletonList(new FloatVec(queryVector)))
        .annsField("embedding")
        .limit(10)
        .searchParams(Collections.singletonMap("metric_type", "COSINE"))
        .outputFields(Arrays.asList("name", "brand", "category", "color", "price", "rating", "in_stock"))
        .searchAggregation(aggregation)
        .build());

List<AggregationBucket> buckets = result.getAggregationBuckets().get(0);
const result = await client.search({
  collection_name: collectionName,
  data: queryVector,
  anns_field: 'embedding',
  limit: 10,
  ...searchParams,
  output_fields: ['name', 'brand', 'category', 'color', 'price', 'rating', 'in_stock'],
  search_aggregation: aggregation,
});

const buckets = result.agg_buckets;
// TBD: Search Aggregation is not yet available in the released Go SDK.
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_search_aggregation",
    "data": [[0.11, 0.40, 0.19, 0.64, 0.30]],
    "annsField": "embedding",
    "limit": 10,
    "outputFields": ["name", "brand", "category", "color", "price", "rating", "in_stock"],
    "searchParams": {"metric_type": "COSINE", "params": {}},
    "searchAggregation": {
      "fields": ["brand"], "size": 3,
      "metrics": {"product_count": {"op": "count", "fieldName": "*"}, "avg_price": {"op": "avg", "fieldName": "price"}, "min_price": {"op": "min", "fieldName": "price"}},
      "order": [{"key": "avg_price", "direction": "desc"}, {"key": "_key", "direction": "asc"}]
    }
  }'
search_aggregation が設定されている場合、PyMilvus は result[0] に通常のエンティティヒットを返しません。代わりに、result.agg_buckets[0] からバケットレスポンスを読み取ります。output_fields パラメーターは、返される各 AggregationHit.fields マッピングに含めるスカラーフィールドを制御します。Zilliz Cloud は、output_fields にリストされていないメトリクスソースフィールドとソートフィールドを引き続き使用できます。
サンプルのバケット出力を表示
次の出力は、上記のリクエストから取得し、読みやすさのために JSON としてシリアル化したものです。PyMilvus は JSON ではなく AggregationBucket オブジェクトを返します。key の値は、fields に 1 つのフィールドしか含まれていない場合でも、常にキーコンポーネントの順序付きリストです。これにより、複合キーのフィールド順序が保持されます。
[
  {
    "key": [
      {
        "field_id": 103,
        "field_name": "brand",
        "value": "Brand B"
      }
    ],
    "count": 1,
    "metrics": {
      "product_count": 1,
      "avg_price": 159.99,
      "min_price": 159.99
    },
    "hits": [],
    "sub_groups": []
  },
  {
    "key": [
      {
        "field_id": 103,
        "field_name": "brand",
        "value": "Brand A"
      }
    ],
    "count": 1,
    "metrics": {
      "product_count": 1,
      "avg_price": 129.99,
      "min_price": 129.99
    },
    "hits": [],
    "sub_groups": []
  },
  {
    "key": [
      {
        "field_id": 103,
        "field_name": "brand",
        "value": "Brand C"
      }
    ],
    "count": 1,
    "metrics": {
      "product_count": 1,
      "avg_price": 119.99,
      "min_price": 119.99
    },
    "hits": [],
    "sub_groups": []
  }
]
このガイドの単一のクエリベクトルについては、返されたトップレベルのバケットを result.agg_buckets[0] から読み取ります。各バケットは、順序付けられたキーコンポーネント、保持された候補の count、計算された metrics、代表的な hits、および sub_groups 内のネストされたバケットを公開します。
設定は次のように読み取ります。
| 設定 | 制御する内容 | この例では |
|---|---|---|
fields | Zilliz Cloud がバケットキーを作成する方法 | 個別の brand 値ごとに 1 つのバケットを作成します。 |
size | 返されるバケットの最大数 | 最大 3 つのブランドバケットを返します。 |
metrics | 各バケットに対して計算される統計 | 商品数、平均価格、最低価格を計算します。 |
order | Zilliz Cloud が返されたバケットを並べ替える方法 | 平均価格で並べ替え、次にバケットキーで同順位を解決します。 |
Zilliz Cloud は、search_aggregation が設定されている場合、limit を無視します。トップレベルのバケット数を制御するには、ルートの SearchAggregation.size 値を使用します。
これらの設定では、Zilliz Cloud は Brand B、Brand A、Brand C のバケットを avg_price の降順で返します。_key 基準は、バケットの平均価格が同じ場合にのみ適用されます。この設定では top_hits を定義していないため、すべてのバケットの hits リストは空になり、キーごとの候補バジェットは 1 になります。したがって、表示される件数とメトリクスは、ブランドごとに保持された 1 件の候補を表します。集計でより広いキーごとのメトリクスウィンドウが必要な場合は、より大きな TopHits.size で top_hits を設定してください。
メトリクスと並べ替えのルール
各 SearchAggregation.metrics エントリは、ユーザー定義のエイリアスを操作とそのソースにマッピングします。
| ソース | サポートされる操作 | 動作 |
|---|---|---|
任意の非 JSON かつ非動的フィールド | count | ソースフィールドが NULL でない保持候補をカウントします。 |
| 整数または浮動小数点フィールド | sum、avg、min、max | null でない保持値に対して計算します。 |
文字列または TIMESTAMPTZ フィールド | min、max | null でない保持値の最小値または最大値を選択します。 |
"*" | count | バケット内のすべての保持候補をカウントします。結果は bucket.count と一致します。 |
_score | sum、avg、min、max | 保持候補の ANN 類似度または距離の値を集計します。 |
SearchAggregation.order は次のキーを受け入れます。
| 順序キー | 意味 |
|---|---|
| メトリクスエイリアス | 同じ集計レベルの metrics で計算された値(avg_price など)で並べ替えます。 |
_count | 各バケット内の保持候補の数で並べ替えます。 |
_key | _key という名前のコレクションフィールドではなく、バケットキーで並べ替えます。 |
各 order エントリは、キーを "asc" または "desc" にマッピングします。Zilliz Cloud は複数のエントリを最初から最後まで評価します。order を省略した場合、Zilliz Cloud は保持された候補セットからのバケット検出順序を維持します。
ベクトルの一致品質でバケットを並べ替えるには、まず _score からバケットレベルのメトリクスを計算し、次にそのメトリクスエイリアスを order で使用します。各バケットには複数のエンティティスコアを含めることができるため、_score をバケットの順序キーとして直接使用することはできません。例えば、COSINE または IP の場合は次のようになります。
- Python
- Java
- NodeJS
- Go
- cURL
aggregation = SearchAggregation(
    fields=["brand"],
    size=3,
    metrics={"max_score": {"max": "_score"}},
    order=[{"max_score": "desc"}],
)
SearchAggregation aggregation = SearchAggregation.builder()
        .fields(Collections.singletonList("brand"))
        .size(3)
        .addMetric("max_score", MetricSpec.builder().op(MetricOps.MAX).fieldName("_score").build())
        .addOrder(OrderSpec.builder().key("max_score").direction(AggDirection.DESC).build())
        .build();
const aggregation = {
  fields: ['brand'],
  size: 3,
  metrics: { max_score: { op: 'max', field_name: '_score' } },
  order: [{ key: 'max_score', direction: 'desc' }],
};
// TBD: Search Aggregation is not yet available in the released Go SDK.
payload='{
  "collectionName": "product_search_aggregation",
  "data": [[0.11, 0.40, 0.19, 0.64, 0.30]], "annsField": "embedding", "limit": 10,
  "searchParams": {"metric_type": "COSINE", "params": {}},
  "searchAggregation": {"fields": ["brand"], "size": 3, "metrics": {"max_score": {"op": "max", "fieldName": "_score"}}, "order": [{"key": "max_score", "direction": "desc"}]}
}'
search "$payload"
L2 の場合は、_score の最小値を計算し、メトリクスエイリアスを昇順に並べ替えて、距離が最も小さいバケットが先に来るようにします。
複合バケットキーの作成
複合バケットキーを作成するには、同じリストに複数のフィールド名を渡します。
- Python
- Java
- NodeJS
- Go
- cURL
aggregation = SearchAggregation(
    # Combine brand and color to form a composite bucket key.
    fields=["brand", "color"],
    size=6,
)
SearchAggregation aggregation = SearchAggregation.builder()
        .fields(Arrays.asList("brand", "color"))
        .size(6)
        .build();
const aggregation = {
  fields: ['brand', 'color'],
  size: 6,
};
// TBD: Search Aggregation is not yet available in the released Go SDK.
payload='{
  "collectionName": "product_search_aggregation",
  "data": [[0.11, 0.40, 0.19, 0.64, 0.30]], "annsField": "embedding", "limit": 10,
  "searchParams": {"metric_type": "COSINE", "params": {}},
  "searchAggregation": {"fields": ["brand", "color"], "size": 6}
}'
search "$payload"
この設定では、(Brand A, black)、(Brand A, blue)、(Brand B, white) などのキーが生成される可能性があります。2 つのエンティティが同じバケットを共有するのは、両方の値が一致する場合だけです。Zilliz Cloud はリストの順序を保持するため、brand が最初のキーコンポーネントで、color が 2 番目になります。order で _key を使用すると、Zilliz Cloud は複合キーコンポーネントを同じ順序で比較します。1 つのフラットなリストに複数の文字列を渡します。ネストされたリストはサポートされていません。
size=6 は、この集計レベルで返される複合バケットの最大数です。サンプルデータには 5 つの異なるブランドと色の組み合わせが含まれるため、5 つすべてを返すことができます。返されるエントリ数の制限では、このリクエストは 1 query vector × 6 buckets × 1 = 6 の設定済み結果エントリに寄与します。
1 つの SearchAggregation.fields リスト内の複数のフィールドは、その集計レベルで複合バケットキーを作成します。親子のバケット階層を作成するには、ネストされた集計を使用します。
以降の例では aggregation を再定義します。更新されたオブジェクトを同じ search_aggregation パラメーターに渡し、検索呼び出しを再実行します。
各バケットから代表的な結果を表示
アプリケーションで各バケットから実際の商品を表示する必要がある場合は、代表的なエンティティを含めます。この例では、Zilliz Cloud は各ブランドバケットから最大 2 つの商品を、評価、次にベクトルスコアの順で返します。
TopHits を次のように設定します。
- Python
- Java
- NodeJS
- Go
- cURL
aggregation = SearchAggregation(
    fields=["brand"],
    size=3,
    # Return and sort representative entities for each selected bucket.
    top_hits=TopHits(
        # Return up to two entities per bucket.
        size=2,
        # Apply sort criteria in list order.
        sort=[
            {"rating": "desc"},
            {"_score": "desc"},
        ],
    ),
)
SearchAggregation aggregation = SearchAggregation.builder().fields(Collections.singletonList("brand")).size(3)
        .topHits(TopHitsSpec.builder().size(2)
                .addSort(SortSpec.builder().fieldName("rating").direction(AggDirection.DESC).build())
                .addSort(SortSpec.builder().fieldName("_score").direction(AggDirection.DESC).build()).build())
        .build();
const aggregation = {
  fields: ['brand'],
  size: 3,
  top_hits: {
    size: 2,
    sort: [
      { field_name: 'rating', direction: 'desc' },
      { field_name: '_score', direction: 'desc' },
    ],
  },
};
// TBD: Search Aggregation is not yet available in the released Go SDK.
payload='{
  "collectionName": "product_search_aggregation",
  "data": [[0.11, 0.40, 0.19, 0.64, 0.30]], "annsField": "embedding", "limit": 10,
  "searchParams": {"metric_type": "COSINE", "params": {}},
  "searchAggregation": {"fields": ["brand"], "size": 3, "topHits": {"size": 2, "sort": [{"fieldName": "rating", "direction": "desc"}, {"fieldName": "_score", "direction": "desc"}]}}
}'
search "$payload"
代表的なヒットを含むバケットを表示
次の Brand A バケットは、上記のリクエストから取得し、読みやすさのために JSON としてシリアル化したものです。
{
  "key": [
    {
      "field_id": 103,
      "field_name": "brand",
      "value": "Brand A"
    }
  ],
  "count": 2,
  "metrics": {},
  "hits": [
    {
      "pk": 1,
      "score": 0.99976646900177,
      "fields": {
        "brand": "Brand A",
        "category": "running_shoes",
        "color": "black",
        "in_stock": true,
        "name": "Runner A1",
        "price": 129.99,
        "rating": 4.7
      }
    },
    {
      "pk": 2,
      "score": 0.9997048377990723,
      "fields": {
        "brand": "Brand A",
        "category": "running_shoes",
        "color": "blue",
        "in_stock": true,
        "name": "Trail A2",
        "price": 139.99,
        "rating": 4.6
      }
    }
  ],
  "sub_groups": []
}
| パラメーター | 目的 |
|---|---|
top_hits | 省略可能。この集計レベルの代表エンティティを設定します。省略した場合、bucket.hits は空になり、キーごとの候補バジェットはデフォルトの 1 になります。 |
TopHits.size | 選択された各バケットから最大 2 件の代表エンティティを返し、集計ツリー全体のキーごとの候補バジェットを 2 に設定します。 |
TopHits.sort | リストされた基準を使用して、各バケット内のエンティティを並べ替えます。 |
アプリケーションで代表的なエンティティが必要な場合、または件数とメトリクスにより広いキーごとの候補ウィンドウが必要な場合は、top_hits を設定します。TopHits.size を大きくすると、候補バジェットと、制限事項で説明する返されるエントリの最大数の計算の両方が増加します。
SearchAggregation.order はバケットを並べ替え、TopHits.sort は各バケット内に保持されたエンティティを並べ替えます。並べ替え順序は、count とメトリクス用に保持された候補を変更しません。TopHits.sort は、サポートされている比較可能なスカラーフィールド名と、ANN の類似度または距離を表す組み込みの _score フィールドを受け入れます。Zilliz Cloud は sort エントリを最初から最後まで評価します。この例では、商品を rating の高い順に並べ、2 つの評価が等しい場合にのみ _score を使用します。セットアップでは COSINE を使用しているため、_score の降順で、より類似した商品が先に来ます。
metrics または TopHits.sort で使用されるフィールドは、output_fields に含める必要はありません。Zilliz Cloud はこれらのフィールドを内部的に取得しますが、返される各ヒットの fields マッピングに含まれるのは、output_fields に明示的にリストされたフィールドだけです。プライマリキーとベクトルスコアは、AggregationHit.pk と AggregationHit.score を通じて引き続き利用できます。
返される各 AggregationHit は、プライマリキーを pk で、ベクトルスコアを score で、要求された出力フィールドを fields で公開します。
複数レベルでの結果のグループ化
あるレベルのバケットを別のレベルの中に入れる必要がある場合は、ネストされた集計を使用します。この例では、Zilliz Cloud は最初に category バケットを作成し、次に各 category 内に brand バケットを作成します。
子集計は、その親バケットに割り当てられたエンティティのみを受け取ります。fields は各集計レベルのバケットキーを制御し、sub_aggregation は親子階層を作成します。
次の設定では、キーが (running_shoes) の category バケットを作成します。その親バケット内で、子集計は (Brand A)、(Brand B)、(Brand C) などのキーを持つ個別の brand バケットを作成します。
Parent bucket key:
(running_shoes)

Child bucket keys:
├── (Brand A)
├── (Brand B)
└── (Brand C)
各レベルは独立して複数のフィールドを使用できます。例えば、子集計で fields=["brand", "color"] を使用すると、(Brand A, black) などの複合子キーが作成されます。
次の設定はこの階層を実装します。
- Python
- Java
- NodeJS
- Go
- cURL
aggregation = SearchAggregation(
    fields=["category"],
    size=2,
    metrics={
        "product_count": {"count": "*"},
        "avg_price": {"avg": "price"},
    },
    order=[{"product_count": "desc"}],
    # For each category bucket, group only its entities by brand.
    sub_aggregation=SearchAggregation(
        fields=["brand"],
        size=3,
        metrics={
            "brand_count": {"count": "*"},
            "avg_rating": {"avg": "rating"},
        },
        order=[{"avg_rating": "desc"}],
        top_hits=TopHits(
            size=2,
            sort=[{"rating": "desc"}],
        ),
    ),
)
SearchAggregation aggregation = SearchAggregation.builder().fields(Collections.singletonList("category")).size(2)
        .addMetric("product_count", MetricSpec.builder().op(MetricOps.COUNT).fieldName("*").build())
        .addMetric("avg_price", MetricSpec.builder().op(MetricOps.AVG).fieldName("price").build())
        .addOrder(OrderSpec.builder().key("product_count").direction(AggDirection.DESC).build())
        .subAggregation(SearchAggregation.builder().fields(Collections.singletonList("brand")).size(3)
                .addMetric("brand_count", MetricSpec.builder().op(MetricOps.COUNT).fieldName("*").build())
                .addMetric("avg_rating", MetricSpec.builder().op(MetricOps.AVG).fieldName("rating").build())
                .addOrder(OrderSpec.builder().key("avg_rating").direction(AggDirection.DESC).build())
                .topHits(TopHitsSpec.builder().size(2).addSort(SortSpec.builder().fieldName("rating").direction(AggDirection.DESC).build()).build()).build())
        .build();
const aggregation = {
  fields: ['category'],
  size: 2,
  metrics: {
    product_count: { op: 'count', field_name: '*' },
    avg_price: { op: 'avg', field_name: 'price' },
  },
  order: [{ key: 'product_count', direction: 'desc' }],
  sub_aggregation: {
    fields: ['brand'],
    size: 3,
    metrics: {
      brand_count: { op: 'count', field_name: '*' },
      avg_rating: { op: 'avg', field_name: 'rating' },
    },
    order: [{ key: 'avg_rating', direction: 'desc' }],
    top_hits: {
      size: 2,
      sort: [{ field_name: 'rating', direction: 'desc' }],
    },
  },
};
// TBD: Search Aggregation is not yet available in the released Go SDK.
payload='{
  "collectionName": "product_search_aggregation",
  "data": [[0.11, 0.40, 0.19, 0.64, 0.30]], "annsField": "embedding", "limit": 10,
  "searchParams": {"metric_type": "COSINE", "params": {}},
  "searchAggregation": {
    "fields": ["category"], "size": 2,
    "metrics": {"product_count": {"op": "count", "fieldName": "*"}, "avg_price": {"op": "avg", "fieldName": "price"}},
    "order": [{"key": "product_count", "direction": "desc"}],
    "subAggregation": {"fields": ["brand"], "size": 3, "metrics": {"brand_count": {"op": "count", "fieldName": "*"}, "avg_rating": {"op": "avg", "fieldName": "rating"}}, "order": [{"key": "avg_rating", "direction": "desc"}], "topHits": {"size": 2, "sort": [{"fieldName": "rating", "direction": "desc"}]}}
  }
}'
search "$payload"
ネストされたバケット結果を表示
次のシリアル化された抜粋は、running_shoes 親バケットとその Brand B 子バケットを示しています。簡潔にするため、Brand A と Brand C の子バケットは省略しています。
{
  "key": [
    {
      "field_id": 104,
      "field_name": "category",
      "value": "running_shoes"
    }
  ],
  "count": 4,
  "metrics": {
    "avg_price": 137.49,
    "product_count": 4
  },
  "hits": [],
  "sub_groups": [
    {
      "key": [
        {
          "field_id": 103,
          "field_name": "brand",
          "value": "Brand B"
        }
      ],
      "count": 1,
      "metrics": {
        "avg_rating": 4.8,
        "brand_count": 1
      },
      "hits": [
        {
          "pk": 3,
          "score": 0.9994542598724365,
          "fields": {
            "brand": "Brand B",
            "category": "running_shoes",
            "color": "white",
            "in_stock": true,
            "name": "Runner B1",
            "price": 159.99,
            "rating": 4.8
          }
        }
      ],
      "sub_groups": []
    }
  ]
}
表示される結果は、単一の複合バケットキー (running_shoes, Brand B) ではなく、バケットパス (running_shoes) → (Brand B) を表します。
Zilliz Cloud は最初に、product_count で並べ替えて最大 2 つの category バケットを選択します。次に、選択された各 category 内で sub_aggregation を個別に実行し、avg_rating で並べ替えて最大 3 つの brand バケットを返します。
上記の出力では次のようになります。
-
ルートの
running_shoesバケットには、子の複合キー全体で 4 件の保持候補が含まれます。そのmetricsには、ルートレベルのavg_priceとproduct_countの値が含まれます。 -
ルートバケットの
sub_groupsリストには、子の brand バケットが含まれます。表示されている Brand B バケットには、1 件の保持候補と、それ自体のavg_ratingおよびbrand_countの値が含まれます。 -
ルート集計は
top_hitsを設定していないため、ルートバケットのhitsリストは空です。top_hitsがsub_aggregationで設定されているため、Brand B の子には代表的なヒットが含まれます。
FAQ
バケットの件数とメトリクスはどの程度正確ですか?
Search Aggregation は、保持された ANN 候補を要約します。コレクション全体の集計は実行しません。
候補の保持には 2 つの近似段階があります。ANN 検索は関連するコレクションエンティティを省略する可能性があり、グループ化ステージは完全な複合キーごとに最大で最も大きな TopHits.size の候補を保持します。どのレベルでも top_hits を設定しない場合、このキーごとの制限は 1 です。
例えば、コレクションに 5,000 件の Brand A 商品が含まれ、その多くがベクトルクエリに関連しているとします。集計で TopHits(size=4) を使用する場合、Brand A バケットは完全な複合キーごとに最大 4 件の候補を保持できます。その count とメトリクスは、保持されたこれらの候補を表すものであり、関連するすべての Brand A 商品や 5,000 件のコレクションエンティティすべてを表すものではありません。
近似は、order がメトリクスエイリアスを使用する場合に最も重要になります。検索の再現率が変化するとメトリクス値が変化し、その結果、SearchAggregation.size 内に収まるバケットが変わる可能性があります。ネストされた集計では、各子レベルが親バケットで使用可能なエンティティに対して動作するため、この影響が増幅される可能性があります。
一致するすべてのエンティティに対する正確な統計が必要な場合は、Search Aggregation ではなく、正確なクエリ集計ワークフローを使用してください。
Search Aggregation と Grouping Search の違いは何ですか?
アプリケーションの主要な結果の形に基づいて選択してください。
| 主なニーズ | 推奨 | 使用するレスポンス |
|---|---|---|
| グループ化フィールド内の値の重複を減らして、標準的なランク付けされたエンティティリストを返す | Grouping Search | 各クエリベクトルのフラットな検索ヒット |
| キー、件数、メトリクス、順序、代表ヒット、子バケットを使用して、グループをバケットとして検査または比較する | Search Aggregation | result.agg_buckets 内の AggregationBucket オブジェクト |
Search Aggregation が top_hits を設定している場合でも、その主要なレスポンスはバケットツリーのままです。Grouping Search は、アプリケーションが通常の検索ヒットをすでに処理しており、主に結果の多様性を求めている場合に引き続き役立ちます。
これらの API は相互に排他的です。PyMilvus は、同じリクエストで search_aggregation を group_by_field または group_by_fields と組み合わせると ParamError を発生させます。