スイッチオーバーとフェイルオーバー
この機能は、Business Critical (SaaS) および BYOC デプロイメントでのみ利用できます。
この機能はすべての AWS リージョンと、以下の Google Cloud リージョンで利用できます: gcp-us-central1 および gcp-us-east4。Microsoft Azure では利用できません。
Zilliz Cloud のグローバルクラスターは、どのリージョンがプライマリクラスターをホストするかを変更する 2 つの操作をサポートしています。
-
スイッチオーバー: 同期済みのセカンダリクラスターをプライマリに昇格させる、計画的でデータ損失ゼロの操作です。
-
フェイルオーバー: プライマリリージョンで障害が発生した後、セカンダリクラスターをプライマリに昇格させる緊急復旧操作です。
このページでは、各操作をいつ使用するか、実行方法、実行中および実行後に何が起こるかを説明します。
概要
スイッチオーバーとフェイルオーバーの比較
以下の表は、この 2 つの操作を比較したものです。
スイッチオーバー | フェイルオーバー | |
|---|---|---|
使用するタイミング | 計画された操作: リージョンの切り替え、コンプライアンス要件、データレジデンシーの変更。 | プライマリリージョンでの想定外の停止または障害。 |
トリガー | すべてのプライマリおよびセカンダリクラスターが実行中のときに手動で開始します。 | プライマリクラスターが異常状態になったときに、復旧アクションとして手動で開始します |
データ損失 (RPO) | 0 — データ損失はありません。昇格は完全なデータ同期後にのみ行われます。 | フェイルオーバー時点の同期遅延に等しくなります。 |
ダウンタイム (RTO) | ほぼゼロです。グローバルエンドポイントが自動的に再ルーティングします。 | 通常は数分程度です。 |
前提条件 |
|
|
旧プライマリクラスターの扱い | セカンダリクラスターに降格されます。 | 破棄され、ごみ箱 に移動されます。新しいセカンダリが自動的に作成されます。 |
アプリケーションの変更 | グローバルエンドポイントを使用している場合は不要です。ルーティングは自動的に更新されます。詳細は グローバルクラスターへの接続 を参照してください | グローバルエンドポイントを使用している場合は不要です。ルーティングは自動的に更新されます。詳細は グローバルクラスターへの接続 を参照してください |
クラスターステータスの遷移
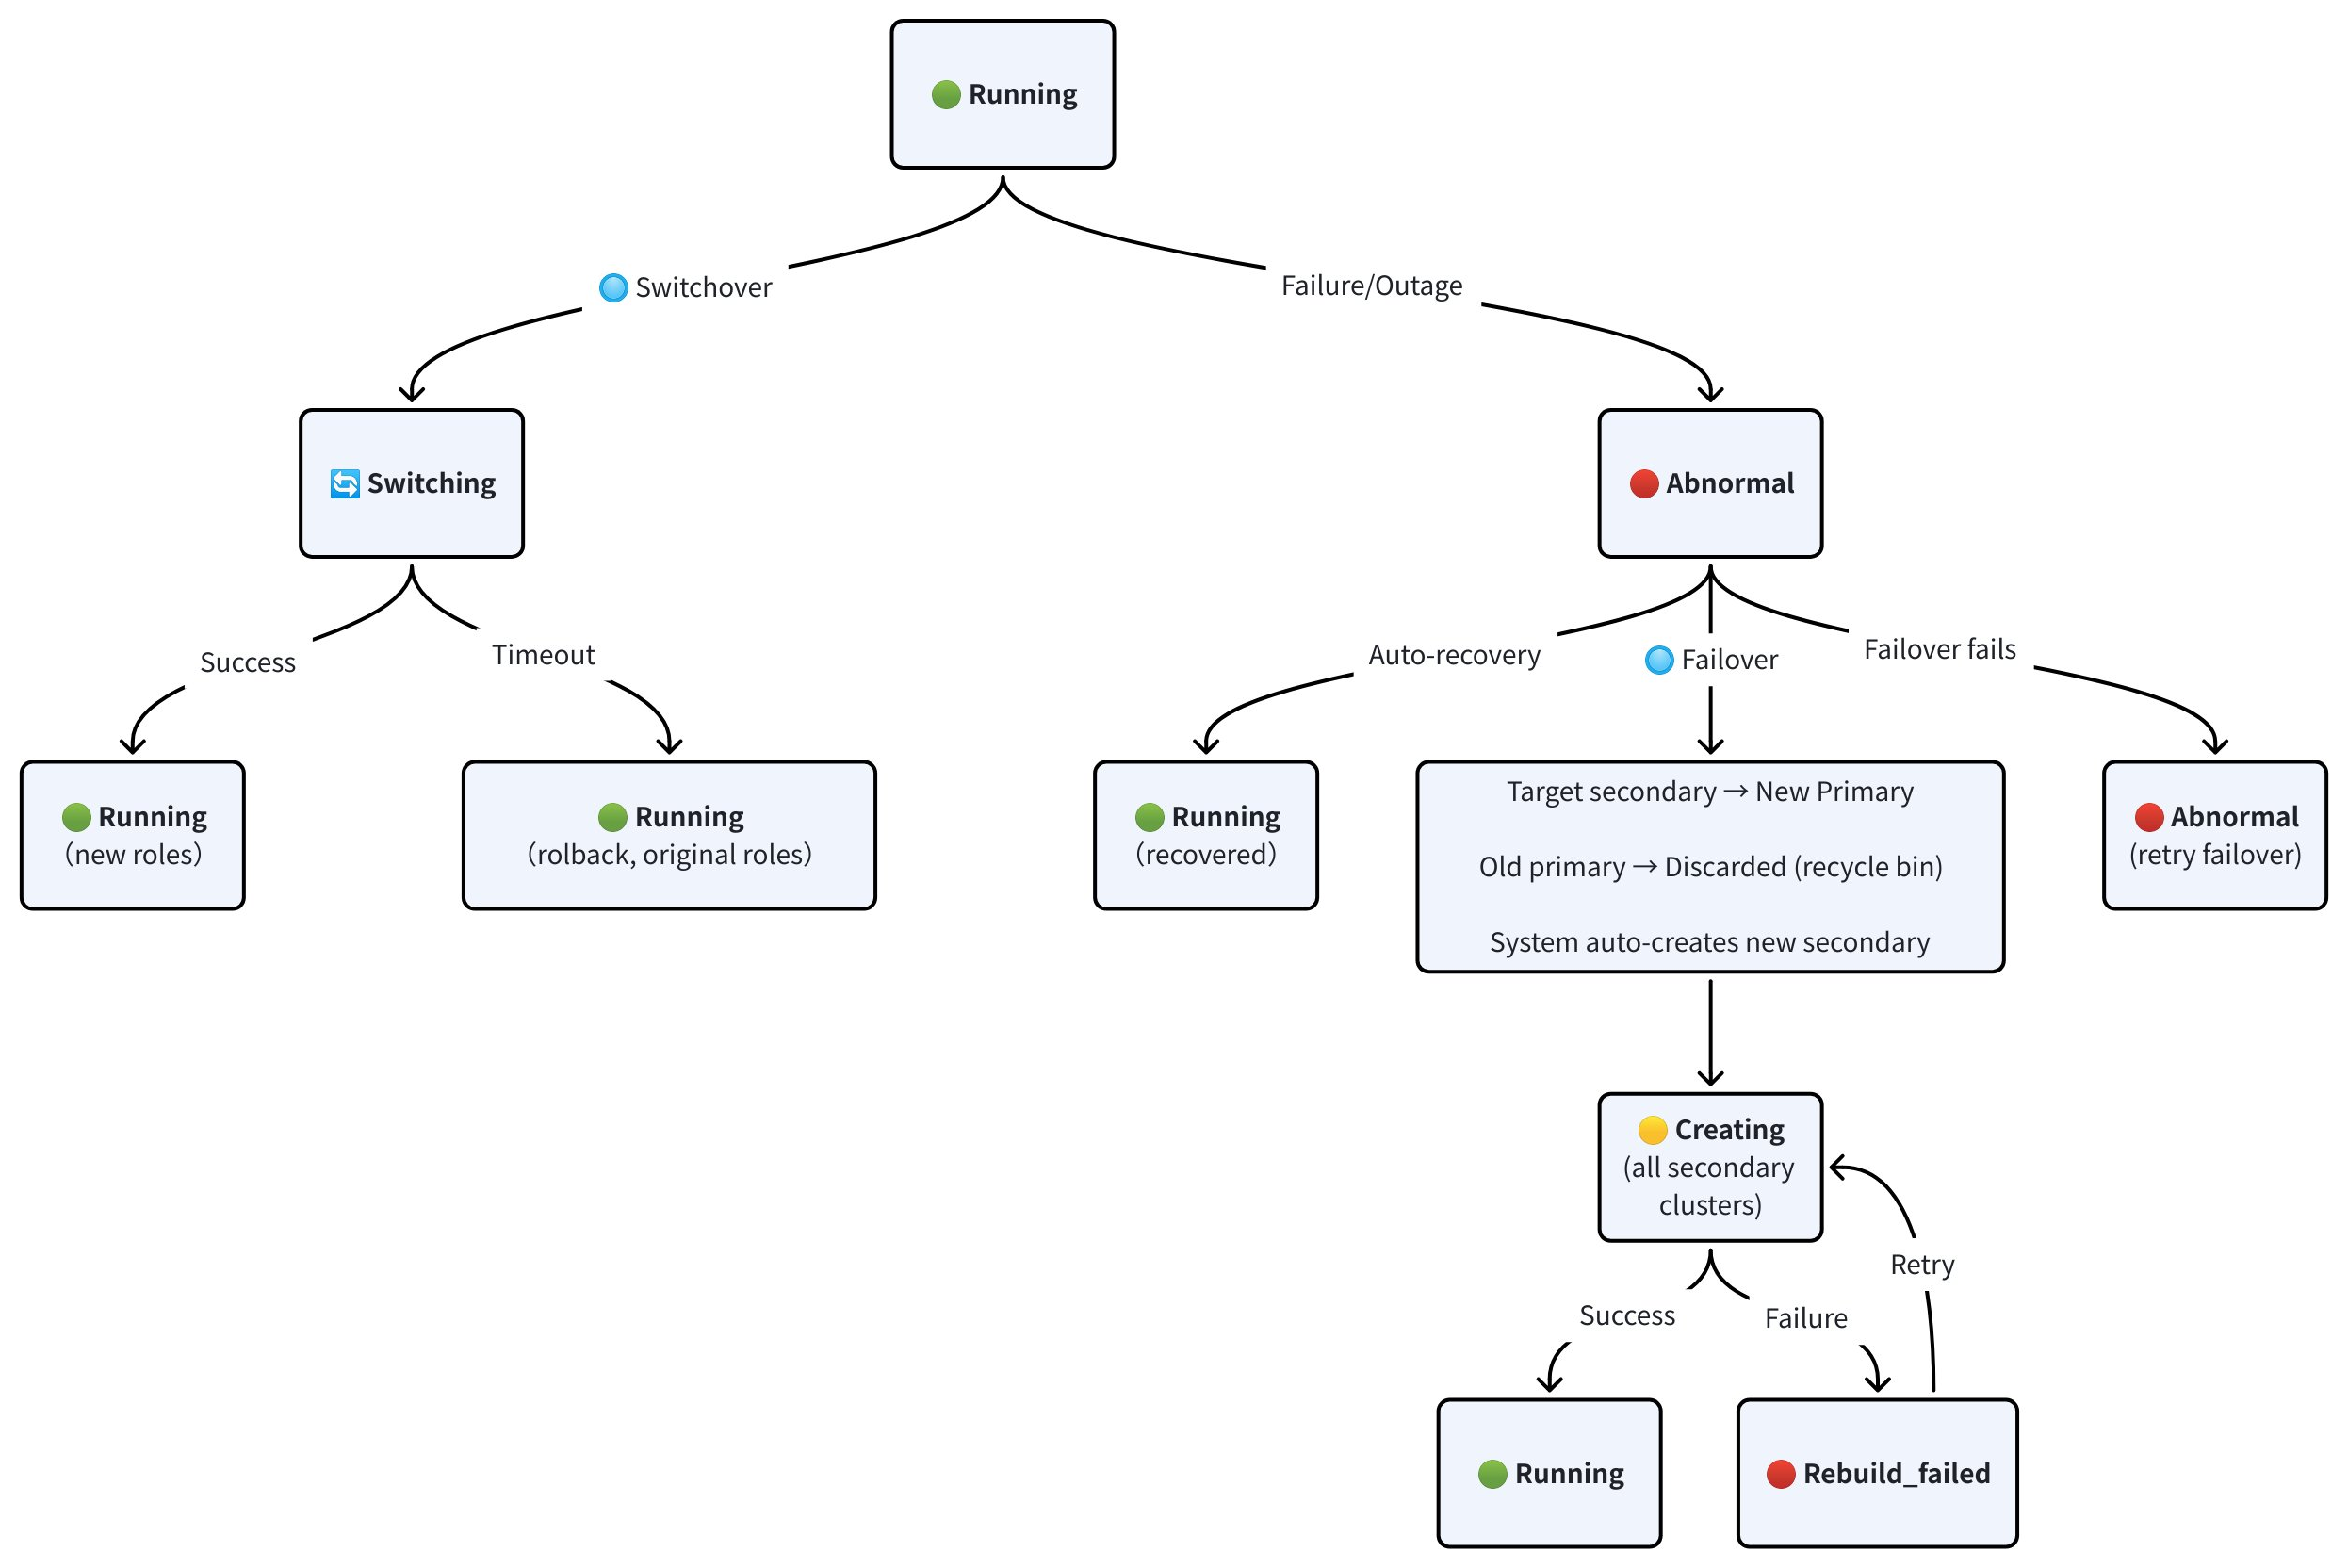
以下の図は、スイッチオーバー、フェイルオーバー、および自動復旧の各操作中にクラスターのステータスがどのように変化するかを示しています。
-
スイッチオーバー:
-
スイッチオーバーでは、対象のセカンダリが現在のプライマリと同期する間、クラスターは RUNNING から SWITCHING に遷移します。同期が完了すると、対象のセカンダリが新しいプライマリに昇格し、元のプライマリはセカンダリに降格されます。両方のクラスターは新しい役割で RUNNING に戻ります。
-
タイムアウト期間内に同期が完了しない場合、スイッチオーバーはロールバックされます。両方のクラスターは元の役割を維持したまま RUNNING に戻ります。
-
-
フェイルオーバー:
-
障害または停止によりプライマリクラスターが ABNORMAL ステータスになった場合、フェイルオーバーをトリガーできます。対象のセカンダリは新しいプライマリに昇格し、古いプライマリは破棄されてごみ箱に移動されます。
-
フェイルオーバーが完了すると、Zilliz Cloud は完全なトポロジーを復元するために新しいセカンダリクラスターを自動的に作成します。新しいセカンダリと残りのすべてのセカンダリクラスターは CREATING ステータスで開始し、プロビジョニングとデータ同期が完了すると RUNNING に遷移します。作成に失敗した場合、クラスターは REBUILD_FAILED ステータスになります。再構築を再試行するか、サポートが必要な場合は お問い合わせ ください。
-
フェイルオーバー自体が失敗した場合、クラスターは ABNORMAL ステータスのままになります。フェイルオーバーを再試行するか、サポートが必要な場合は お問い合わせ ください。
-
-
自動復旧:
プライマリクラスターの問題が自然に解消した場合、手動操作なしでクラスターは ABNORMAL から RUNNING に戻ります。この場合、フェイルオーバーは不要です。
スイッチオーバーの実行
計画的なリージョン切り替えでは、スイッチオーバーを実行してセカンダリクラスターをプライマリの役割に昇格できます。
開始する前に
-
グローバルクラスター内のすべてのクラスターが RUNNING ステータスである必要があります。
-
同期遅延は 30 秒以下である必要があります。このしきい値を超える場合、スイッチオーバーは拒否されます。遅延は Global Topology タブで確認してください。
-
Query CU または Replica の スケーリング 操作が進行中であってはなりません。
手順
-
Web コンソールから
次のデモは、スイッチオーバーの実行方法を示しています。
1Global Cluster ページに移動します。
2Switchover or Failover をクリックします。
3昇格する対象のセカンダリクラスターを選択します。
4Switchover を選択します。
5ダイアログで操作を確認します。
スイッチオーバーを開始すると、Zilliz Cloud は対象のセカンダリが現在のプライマリと完全に同期するのを待ってから、新しいプライマリに昇格させます。
-
RESTful API から
次の例は、クラスター
in01-secondaryが新しいプライマリクラスターになるようにスイッチオーバーを実行します。API の詳細については、Switchover Global Cluster を参照してください。bashcurl --request POST \--url "${BASE_URL}/v2/globalClusters/${globalClusterId}/switchover" \--header "Authorization: Bearer ${TOKEN}" \--header "Content-Type: application/json" \-d '{"newPrimaryClusterId": "in01-secondary"}'以下は出力例です。
bash{"code": 0,"data": {"globalClusterId": "glo-xxxxxxxxxxxxxxxx","oldPrimaryClusterId": "in01-primary","newPrimaryClusterId": "in01-secondary","jobId": "job-xxxxxxxxxxxxxxxx"}}
スイッチオーバー後
-
元のプライマリはセカンダリクラスターになり、新しいプライマリからのレプリケートデータの受信を開始します。
-
グローバルエンドポイントのルーティングは自動的に更新され、書き込みが新しいプライマリに送られるようになります。
-
新しい Global Topology ビューで確認できます。すべてのクラスターは RUNNING ステータスに戻っているはずです。
-
新しいプライマリクラスターでバックアップポリシーを再設定してください。バックアップポリシーは新しいプライマリに自動的には引き継がれません。
フェイルオーバーの実行
プライマリリージョンで障害が発生し、プライマリクラスターが ABNORMAL ステータスになっている場合はフェイルオーバーを使用します。
フェイルオーバーは緊急操作です。スイッチオーバーとは異なり、完全なデータ同期を待ちません。プライマリでコミット済みでも、対象のセカンダリにまだレプリケートされていない書き込みは失われます。データ損失量はフェイルオーバー時点の同期遅延に等しくなります。
開始する前に
-
プライマリクラスターが到達不能であり、ABNORMAL ステータスであることを確認してください。
-
昇格するセカンダリクラスターを特定します。複数のセカンダリが利用可能な場合は、同期遅延が最も小さいもの(プライマリの最新状態に最も近いもの)を選択してください。
手順
-
Web コンソールから
次のデモは、フェイルオーバーの実行方法を示しています。
1Global Cluster ページに移動します。
2Switchover or Failover をクリックします。
3昇格する対象のセカンダリクラスターを選択します。
4Failover を選択します。
5ダイアログで操作を確認します。
📘注意フェイルオーバーが失敗した場合、クラスターは ABNORMAL ステータスのままになります。フェイルオーバー操作を再試行するか、サポートチケットを作成してください。
-
RESTful API から
次の例は、クラスター
in01-secondaryが強制的にプライマリに昇格されるようにフェイルオーバーを実行します。API の詳細については、Failover Global Cluster を参照してください。bashcurl --request POST \--url "https://api.cloud.zilliz.com/v2/globalClusters/glo-xxxxxxxxxxxxxxxx/failover" \--header "Authorization: Bearer ${API_KEY}" \--header "Accept: application/json" \--header "Content-Type: application/json" \--data-raw '{"newPrimaryClusterId": "in01-secondary"}'以下は出力例です。
bash{"code": 0,"data": {"globalClusterId": "glo-xxxxxxxxxxxxxxxx","oldPrimaryClusterId": "in01-primary","newPrimaryClusterId": "in01-secondary","jobId": "job-xxxxxxxxxxxxxxxx"}}
フェイルオーバー後
-
元のプライマリは破棄され、ごみ箱に移動されます。Global Topology ビューには表示されなくなります。
-
完全なグローバルトポロジーを復元するために、新しいセカンダリクラスターが自動的に作成されます。新しいセカンダリのプロビジョニング中は、グローバルトポロジーからは見えません。代わりに、グローバルクラスターのページに次のバナーが表示されます: "A new secondary cluster will be created and become available shortly."
-
残りのセカンダリクラスターも再構築のために CREATING ステータスに遷移し、再構築完了後に RUNNING になります。
-
グローバルエンドポイントは更新され、書き込みを新しいプライマリに送るようになります。
-
新しいプライマリクラスターでバックアップポリシーを再設定してください。バックアップポリシーは新しいプライマリに自動的には引き継がれません。
ルーティング動作
以下の表は、各操作の実行中および完了後に、グローバルエンドポイントとパブリックエンドポイントがどのように動作するかをまとめたものです。
エンドポイントの種類 | スイッチオーバー中 | フェイルオーバー中 | 完了後 |
|---|---|---|---|
グローバルエンドポイント |
|
|
|
パブリックエンドポイント |
|
|
|
進行中のタスクへの影響
以下の表は、進行中のタスクがスイッチオーバーおよびフェイルオーバー中にどのように処理されるかをまとめたものです。
| タスク | スイッチオーバー中 | フェイルオーバー中 |
|---|---|---|
| バックアップ | タスクは失敗します。スイッチオーバー完了後に新しいプライマリで自動的に再試行されます。 | タスクは失敗します。フェイルオーバー完了後に新しいプライマリで自動的に再試行されます。 |
| Query CU スケーリング | スケーリングの進行中はスイッチオーバーはブロックされます。 | タスクは失敗します。フェイルオーバー完了後に再試行されます。 |
| Replica スケーリング | スケーリングの進行中はスイッチオーバーはブロックされます。 | タスクは失敗します。フェイルオーバー完了後に再試行されます。 |