テキストマッチ
Zilliz Cloud のテキストマッチを使用すると、特定の用語に基づいてドキュメントを正確に取得できます。この機能は主に、特定の条件を満たすためのフィルタリング検索に使用され、スカラーフィルタリングを組み合わせてクエリ結果を絞り込むことで、スカラー条件を満たすベクトル内での類似検索を可能にします。
TEXT_MATCH は分析済みの用語との完全一致を検出します。一方、TEXT_MATCH_FUZZY はクエリトークンとインデックス付きトークン間の小さな編集距離を許容できます。どちらもブールフィルタリング操作であり、一致したドキュメントの関連性はスコアリングしません。クエリ用語の意味や重要度に基づいて最も関連性の高いドキュメントを取得する場合は、全文検索 の使用をお勧めします。
Zilliz Cloud では、プログラムまたは Web コンソールからテキストマッチを有効にできます。このページでは、プログラムからテキストマッチを有効にする方法について説明します。Web コンソールでの操作の詳細については、コレクションの管理(コンソール) を参照してください。
概要
Zilliz Cloud は Tantivy を統合し、基盤となる転置インデックスと用語ベースのテキスト検索を実現しています。Zilliz Cloud は、各テキストエントリを次の手順でインデックス化します。
-
アナライザー: アナライザーは、入力テキストを個々の単語(トークン)に分割し、必要に応じてフィルターを適用することで処理します。これにより、Zilliz Cloud はこれらのトークンに基づいてインデックスを構築できます。
-
インデックス作成: テキスト分析の後、Zilliz Cloud は各一意のトークンを、そのトークンを含むドキュメントに対応付ける転置インデックスを作成します。
ユーザーがテキストマッチを実行すると、転置インデックスを使用して、用語を含むすべてのドキュメントをすばやく取得します。これは、各ドキュメントを個別にスキャンするよりもはるかに高速です。
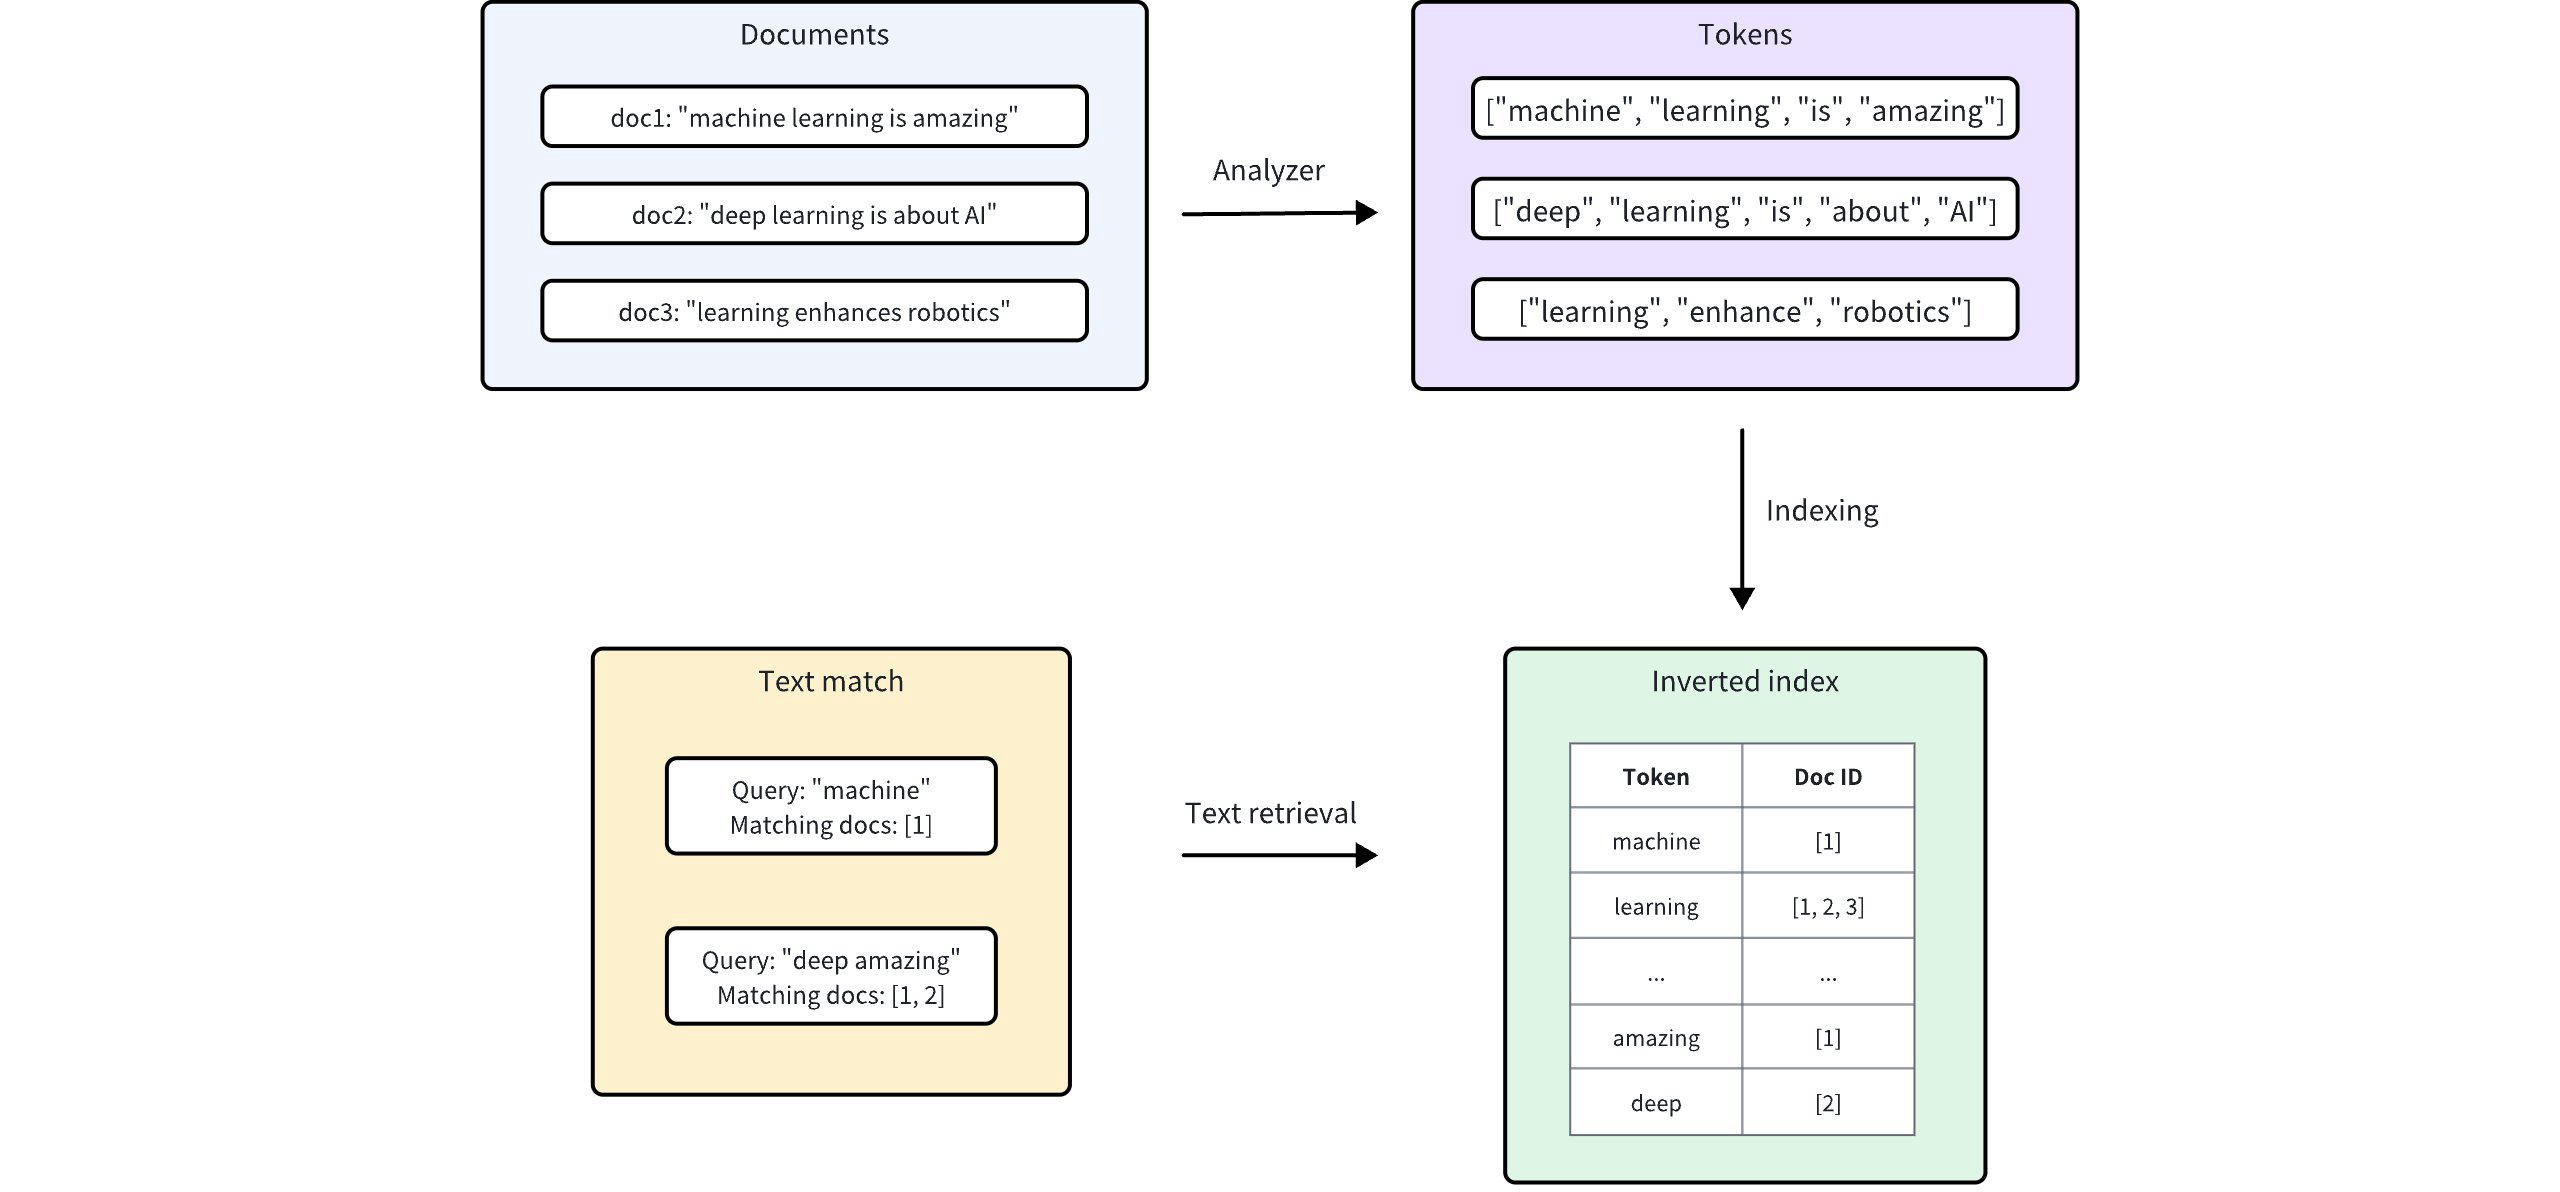
テキストマッチを有効にする
テキストマッチは、Zilliz Cloud の文字列データ型に相当する VARCHAR フィールド型で動作します。テキストマッチを有効にするには、コレクションスキーマを定義するときに enable_analyzer と enable_match の両方を True に設定したうえで、必要に応じてテキスト分析用のアナライザーを構成します。
enable_analyzer と enable_match を設定する
特定の VARCHAR フィールドでテキストマッチを有効にするには、フィールドスキーマを定義する際に enable_analyzer と enable_match の両方のパラメーターを True に設定します。これにより、Zilliz Cloud はテキストをトークン化し、指定したフィールドの転置インデックスを作成するため、高速で効率的なテキストマッチが可能になります。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
use milvus::v2::prelude::*;

let schema = CollectionSchema::new()
    .enable_dynamic_field(false)
    .add_field(
        FieldSchema::new()
            .name("id")
            .data_type(DataType::Int64)
            .primary_key(true)
            .auto_id(true),
    )
    .add_field(
        FieldSchema::new()
            .name("text")
            .data_type(DataType::VarChar)
            .max_length(1000)
            .enable_analyzer(true) // Whether to enable text analysis for this field
            .enable_match(true), // Whether to enable text match
    )
    .add_field(
        FieldSchema::new()
            .name("embeddings")
            .data_type(DataType::FloatVector)
            .dimension(5),
    );
milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(false);
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Create a collection with a VARCHAR field configured for text matching
zilliz collection create --collection-name my_collection --schema '{
  "autoId": true,
  "enabledDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "text",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": 1000,
        "enable_analyzer": true,
        "enable_match": true
      }
    },
    {
      "fieldName": "embeddings",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": 5
      }
    }
  ]
}'
オプション: アナライザーを構成する
キーワードマッチングのパフォーマンスと精度は、選択したアナライザーによって異なります。アナライザーは言語やテキスト構造に合わせてそれぞれ設計されているため、適切なものを選択することが、特定のユースケースにおける検索結果に大きく影響します。
デフォルトでは、Zilliz Cloud は standard アナライザーを使用します。このアナライザーは、空白と句読点に基づいてテキストをトークン化し、40 文字を超えるトークンを削除し、テキストを小文字に変換します。このデフォルト設定を適用するために追加のパラメーターは必要ありません。詳細については、Standard を参照してください。
別のアナライザーが必要な場合は、analyzer_params パラメーターを使用して構成できます。たとえば、英語テキストを処理するために english アナライザーを適用するには、次のようにします。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
use milvus::v2::prelude::*;

let analyzer_params = serde_json::json!({"type": "english"});

let schema = CollectionSchema::new()
    .enable_dynamic_field(false)
    .add_field(
        FieldSchema::new()
            .name("id")
            .data_type(DataType::Int64)
            .primary_key(true)
            .auto_id(true),
    )
    .add_field(
        FieldSchema::new()
            .name("text")
            .data_type(DataType::VarChar)
            .max_length(200)
            .enable_analyzer(true)
            .analyzer_params(analyzer_params)
            .enable_match(true),
    )
    .add_field(
        FieldSchema::new()
            .name("embeddings")
            .data_type(DataType::FloatVector)
            .dimension(5),
    );
nlohmann::json analyzer_params = {{"type", "english"}};
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(200).EnableAnalyzer(true).WithAnalyzerParams(analyzer_params).EnableMatch(true));
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Create a collection with English analyzer for text matching
zilliz collection create --collection-name my_collection --schema '{
  "autoId": true,
  "enabledDynamicField": false,
  "fields": [
    {
      "fieldName": "id",
      "dataType": "Int64",
      "isPrimary": true
    },
    {
      "fieldName": "text",
      "dataType": "VarChar",
      "elementTypeParams": {
        "max_length": 1000,
        "enable_analyzer": true,
        "enable_match": true,
        "analyzer_params": {
          "type": "english"
        }
      }
    },
    {
      "fieldName": "embeddings",
      "dataType": "FloatVector",
      "elementTypeParams": {
        "dim": 5
      }
    }
  ]
}'
Zilliz Cloud では、さまざまな言語やシナリオに適したその他のアナライザーも提供しています。詳細については、Analyzer Overview を参照してください。
テキストマッチを使用する
コレクションスキーマで VARCHAR または TEXT フィールドのテキストマッチを有効にすると、TEXT_MATCH 式を使用してテキストマッチを実行できます。
TEXT_MATCH 式の構文
TEXT_MATCH 式は、検索対象のフィールドと用語を指定するために使用します。その構文は次のとおりです。
TEXT_MATCH(field_name, text)
std::string filter = "TEXT_MATCH(field_name, text)";
export filter="\"TEXT_MATCH(field_name, text)\""
-
field_name: 検索対象の、マッチングが有効なVARCHARまたはTEXTフィールドの名前。 -
text: 検索する用語。複数の用語は、言語と構成したアナライザーに応じて、スペースまたはその他の適切な区切り文字で区切ることができます。
デフォルトでは、TEXT_MATCH は OR マッチングロジックを使用します。つまり、指定した用語のいずれかを含むドキュメントを返します。たとえば、text フィールドに machine または deep という用語を含むドキュメントを検索するには、次の式を使用します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
let filter = "TEXT_MATCH(text, 'machine deep')";
std::string filter = "TEXT_MATCH(text, 'machine deep')";
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents containing "keyword1" or "keyword2"
zilliz collection query --collection-name my_collection --filter "TEXT_MATCH(text, 'keyword1 keyword2')" --output-fields "id,text"
論理演算子を使用して複数の TEXT_MATCH 式を組み合わせ、AND マッチングを実行することもできます。
textフィールドにmachineとdeepの両方を含むドキュメントを検索するには、次の式を使用します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"
String filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";
filter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"
let filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";
std::string filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";
const filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"
export filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents containing both "machine" and "deep"
zilliz collection query --collection-name my_collection --filter "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')" --output-fields "id,text"
textフィールドにmachineとlearningの両方を含み、deepを含まないドキュメントを検索するには、次の式を使用します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"
String filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
filter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"
let filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
std::string filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
const filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
export filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents containing "machine" and "learning" but not "deep"
zilliz collection query --collection-name my_collection --filter "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')" --output-fields "id,text"
TEXT_MATCH_FUZZY 式の構文
Public PreviewTEXT_MATCH_FUZZY を使用すると、クエリトークンとインデックス付きトークン間のスペル差異を許容できます。Zilliz Cloud はフィールドのアナライザーでクエリテキストを分析し、得られた各トークンにファジーマッチングを適用します。クエリで複数のトークンが生成された場合、いずれかのトークンが設定された編集距離を満たすと、式はエンティティに一致します。
構文は次のとおりです。
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
std::string filter = "TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)\""
-
field_name: 検索対象の、マッチングが有効なVARCHARまたはTEXTフィールドの名前。 -
text: 分析してインデックス付きトークンと照合するクエリテキスト。 -
max_edit_distance: 各クエリトークンに許可される最大編集距離。オプション名は厳密にmax_edit_distanceである必要があり、その値は0、1、または2である必要があります。値0は完全なトークンマッチングを実行し、TEXT_MATCHと同等です。
たとえば、次の式は machne から 1 回の編集距離以内にあるトークン(machine を含む)に一致します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
let filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
std::string filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Query documents with fuzzy matching (tolerates spelling differences)
zilliz collection query --collection-name my_collection --filter "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)" --output-fields "id,text"
TEXT_MATCH_FUZZY はフィルター式の構文の一部であるため、クライアント SDK に専用のファジーマッチメソッドは必要ありません。検索操作またはクエリ操作で TEXT_MATCH に使用する同じ filter パラメーターに式を渡します。
テキストマッチを使用して検索する
テキストマッチは、ベクトル類似検索と組み合わせて検索範囲を絞り込み、検索パフォーマンスを向上させるために使用できます。ベクトル類似検索の前にテキストマッチでコレクションをフィルタリングすると、検索する必要があるドキュメントの数を減らすことができ、クエリ時間を短縮できます。
この例では、filter 式によって検索結果を、指定した用語 keyword1 または keyword2 に一致するドキュメントのみに絞り込みます。その後、このフィルタリングされたドキュメントのサブセットに対してベクトル類似検索を実行します。
テキストハイライターを構成すると、検索結果内の一致した用語をハイライトできます。詳細については、テキストハイライター を参照してください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
- Zilliz CLI
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.Arrays;
import java.util.Collections;

String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Match entities with `keyword1` or `keyword2`
let filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
let query_vector = vec![0.19886812562848388f32, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104];

let result = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection") // Your collection name
            .vector_field("embeddings") // Vector field name
            .vectors(SearchVectors::Float(vec![query_vector])) // Query vector
            .filter(filter)
            .output_fields(["id", "text"]) // Fields to return
            .limit(10) // Max. number of results to return
            .build()?,
    )
    .await?;
// Match entities with `keyword1` or `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("embeddings")
                   .AddFloatVector(query_vector)
                   .WithFilter(filter)
                   .AddExtraParam("nprobe", "10")
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search({
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
});
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
# Zilliz CLI
# Prerequisite: run zilliz login and select your cluster with zilliz context set.

# Search documents containing "machine deep" with vector similarity
zilliz collection search --collection-name my_collection --vector-field embeddings --vectors '[[0.1,0.2,0.3,0.4,0.5]]' --filter "TEXT_MATCH(text, 'machine deep')" --limit 10 --output-fields "id,text"
テキストマッチを使用してクエリする
テキストマッチは、クエリ操作でのスカラーフィルタリングにも使用できます。query() メソッドの expr パラメーターに TEXT_MATCH 式を指定すると、指定した用語に一致するドキュメントを取得できます。
次の例では、text フィールドに keyword1 と keyword2 の両方の用語を含むドキュメントを取得します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
import io.milvus.v2.service.vector.request.QueryReq;
import io.milvus.v2.service.vector.response.QueryResp;
import java.util.Arrays;

String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

let uri = "YOUR_CLUSTER_ENDPOINT";
let token = "YOUR_CLUSTER_TOKEN";

let client = ClientV2::new(
    &ConnectConfig::new().uri(uri).token(token),
)
.await?;

// Match entities with both `keyword1` and `keyword2`
let filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

let result = client
    .query(
        QueryRequest::builder()
            .collection_name("my_collection")
            .filter(filter)
            .output_fields(["id", "text"])
            .build()?,
    )
    .await?;
// Match entities with both `keyword1` and `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

auto request = milvus::QueryRequest()
                   .WithCollectionName("my_collection")
                   .WithFilter(filter)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::QueryResponse response;
auto status = client->Query(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query({
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
})
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
考慮事項
-
フィールドの用語マッチングを有効にすると、転置インデックスが作成され、ストレージリソースを消費します。この機能を有効にするかどうかを決定する際は、テキストサイズ、一意のトークン数、使用するアナライザーによってストレージへの影響が異なるため、ストレージへの影響を考慮してください。
-
スキーマでアナライザーを定義すると、その設定はそのコレクションに対して永続的になります。別のアナライザーの方がニーズに適していると判断した場合は、既存のコレクションを削除し、目的のアナライザー構成で新しいコレクションを作成することを検討してください。
-
filter式のエスケープルール:-
式内の二重引用符または一重引用符で囲まれた文字は、文字列定数として解釈されます。文字列定数にエスケープ文字が含まれる場合、エスケープ文字はエスケープシーケンスで表す必要があります。たとえば、
\を表すには\\、タブ\tを表すには\\t、改行を表すには\\nを使用します。 -
文字列定数が一重引用符で囲まれている場合、定数内の一重引用符は
\\'と表し、二重引用符は"または\\"のいずれかで表すことができます。例:'It\\'s milvus'。 -
文字列定数が二重引用符で囲まれている場合、定数内の二重引用符は
\\"と表し、一重引用符は'または\\'のいずれかで表すことができます。例:"He said \\"Hi\\""。
-