バイナリベクトル
バイナリベクトルは、従来の高次元浮動小数点ベクトルを、0 と 1 のみを含むバイナリベクトルに変換する特殊なデータ表現形式です。この変換では、ベクトルのサイズが圧縮されるだけでなく、意味情報を保持しながらストレージコストと計算コストも削減されます。重要でない特徴量に厳密な精度が必要ない場合、バイナリベクトルは元の浮動小数点ベクトルの完全性と有用性の大部分を効果的に維持できます。
バイナリベクトルは幅広い用途があり、特に計算効率とストレージの最適化が重要な状況で役立ちます。検索エンジンやレコメンデーションシステムなどの大規模な AI システムでは、大量のデータをリアルタイムで処理することが鍵となります。ベクトルのサイズを削減することで、バイナリベクトルは精度を大きく犠牲にすることなく、レイテンシと計算コストの削減に役立ちます。また、バイナリベクトルは、メモリと処理能力が限られているモバイルデバイスや組み込みシステムなど、リソースに制約のある環境でも有用です。バイナリベクトルを使用することで、こうした制約のある環境でも高いパフォーマンスを維持しながら複雑な AI 機能を実装できます。
概要
バイナリベクトルは、複雑なオブジェクト(画像、テキスト、音声など)を固定長のバイナリ値にエンコードする方法です。Zilliz Cloud クラスターでは、バイナリベクトルは通常、ビット配列またはバイト配列として表現されます。たとえば、8 次元のバイナリベクトルは [1, 0, 1, 1, 0, 0, 1, 0] のように表現できます。
以下の図は、バイナリベクトルがテキストコンテンツ内のキーワードの存在をどのように表すかを示しています。この例では、10 次元のバイナリベクトルを使用して 2 つの異なるテキスト(Text 1 と Text 2)を表現しており、各次元は語彙内の単語に対応します。1 はその単語がテキスト内に存在することを示し、0 は存在しないことを示します。
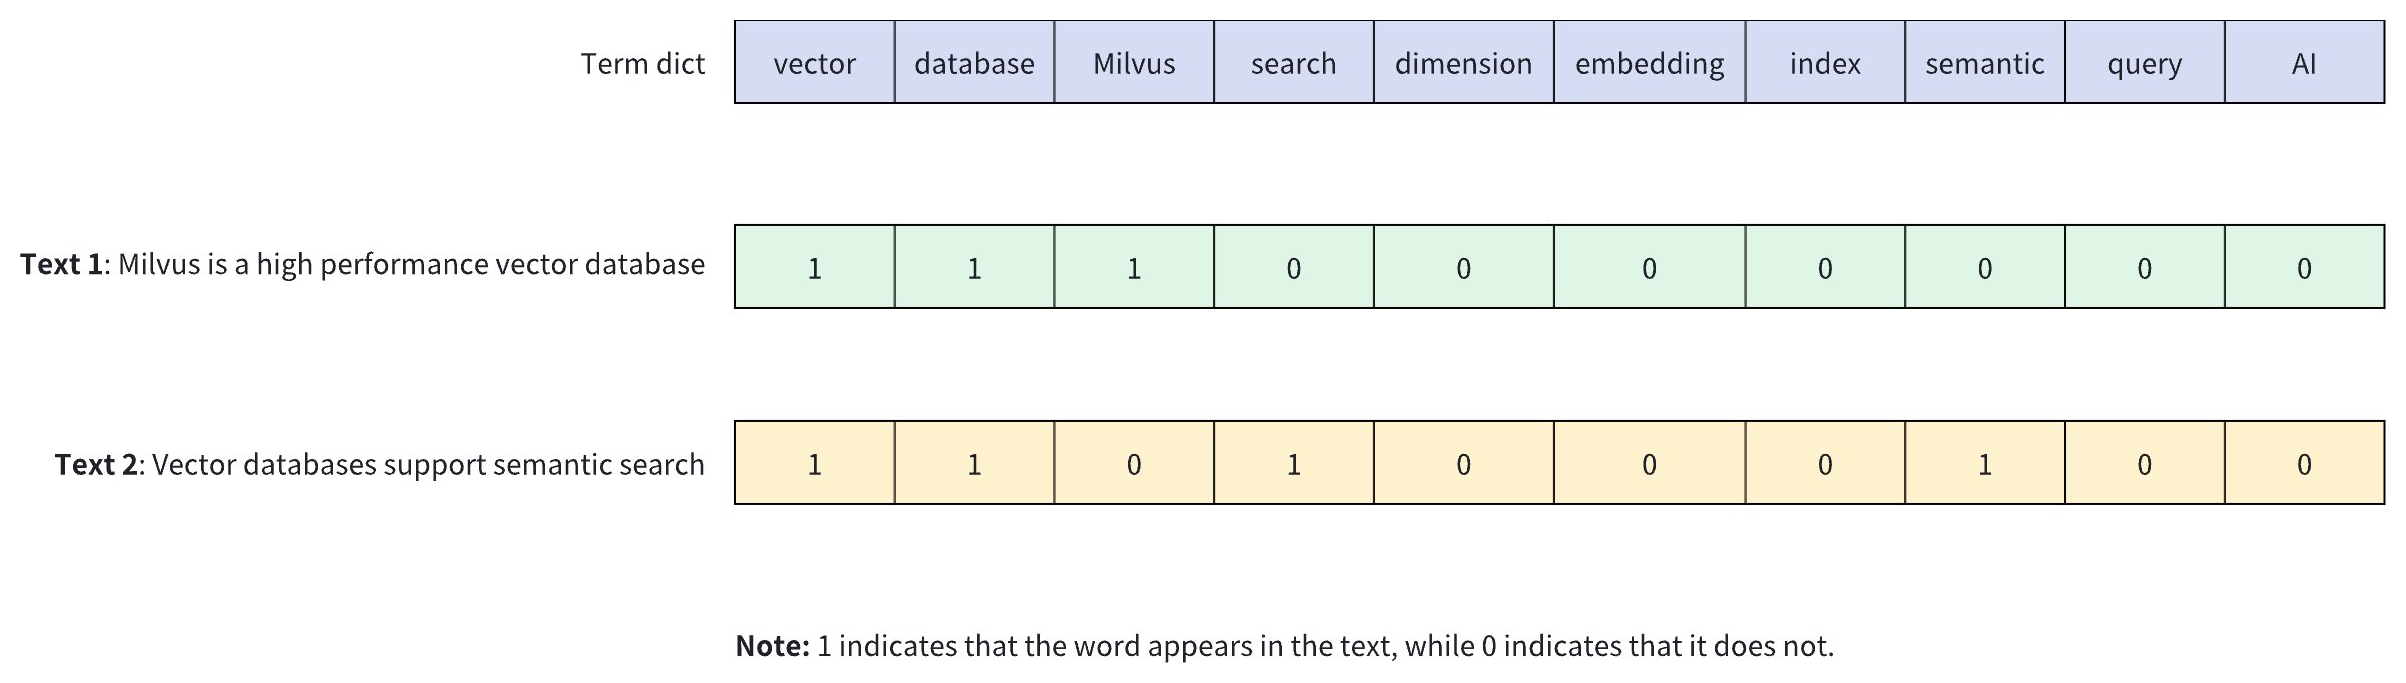
バイナリベクトルには次の特徴があります。
-
効率的なストレージ: 各次元に必要なストレージはわずか 1 ビットであり、ストレージ容量を大幅に削減します。
-
高速な計算: ベクトル間の類似度は、XOR などのビット演算を使用して高速に計算できます。
-
固定長: 元のテキストの長さに関係なくベクトルの長さは一定であるため、インデックス作成と取得が容易になります。
-
シンプルで直感的: キーワードの存在を直接反映するため、特定の専門的な取得タスクに適しています。
バイナリベクトルはさまざまな方法で生成できます。テキスト処理では、事前定義された語彙を使用し、単語の有無に基づいて対応するビットを設定できます。画像処理では、知覚ハッシュアルゴリズム(pHash など)によって画像のバイナリ特徴を生成できます。機械学習アプリケーションでは、モデルの出力を二値化してバイナリベクトル表現を取得できます。
バイナリベクトル化後、データは管理とベクトル検索のために Zilliz Cloud クラスターに保存できます。以下の図は基本的な流れを示しています。
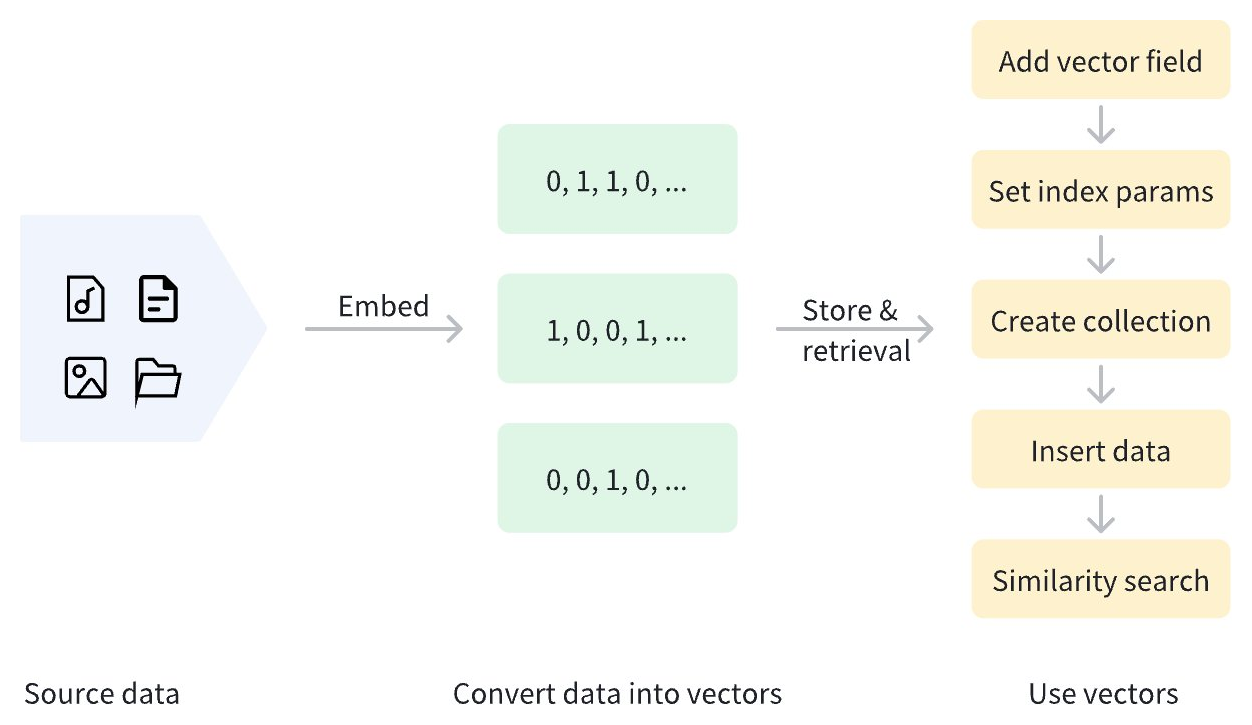
Although binary ベクトル excel in specific scenarios, they have limitations in their expressive capability, making it difficult to capture complex semantic relationships. Therefore, in real-world scenarios, binary ベクトル are often used alongside other ベクトル types to balance efficiency and expressiveness. For more information, refer to Dense ベクトル and Sparse Vector.
バイナリベクトルを使用する
ベクトルフィールドを追加する
Zilliz Cloud クラスターでバイナリベクトルを使用するには、まずコレクションを作成するときにバイナリベクトルを保存するためのベクトルフィールドを定義します。このプロセスには以下が含まれます。
-
datatypeを、サポートされているバイナリベクトルのデータ型(BINARY_VECTOR)に設定します。 -
dimパラメータを使用してベクトルの次元数を指定します。バイナリベクトルは挿入時にバイト配列に変換する必要があるため、dimは 8 の倍数でなければならない点に注意してください。8 個の boolean 値(0 または 1)ごとに 1 バイトにパックされます。たとえば、dim=128の場合、挿入には 16 バイトの配列が必要です。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=128)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

CreateCollectionReq.CollectionSchema schema = MilvusClientV2.CreateSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("binary_vector")
        .dataType(DataType.BinaryVector)
        .dimension(128)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    milvusclient "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema().WithDynamicFieldEnabled(true).
    WithField(entity.NewField().
        WithName("pk").
        WithDataType(entity.FieldTypeVarChar).
        WithIsAutoID(true).
        WithIsPrimaryKey(true).
        WithMaxLength(100),
    ).WithField(entity.NewField().
        WithName("binary_vector").
        WithDataType(entity.FieldTypeBinaryVector).
        WithDim(128),
    )
use milvus::v2::prelude::*;

let client = ClientV2::new(
    &ConnectConfig::new()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN"),
)
.await?;

let mut schema = CollectionSchema::new().enable_dynamic_field(true);
schema = schema
    .add_field(
        FieldSchema::new()
            .name("pk")
            .data_type(DataType::VarChar)
            .primary_key(true)
            .auto_id(true)
            .max_length(100),
    )
    .add_field(
        FieldSchema::new()
            .name("binary_vector")
            .data_type(DataType::BinaryVector)
            .dimension(128),
    );
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(true);
schema->AddField(milvus::FieldSchema("pk", milvus::DataType::VARCHAR, "", true, true).WithMaxLength(100));
schema->AddField(milvus::FieldSchema("binary_vector", milvus::DataType::BINARY_VECTOR).WithDimension(128));
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
  address: "YOUR_CLUSTER_ENDPOINT",
});

const schema = [
  {
    name: "pk",
    data_type: DataType.VarChar,
    is_primary_key: true,
    autoID: true,
    max_length: 100,
  },
  {
    name: "binary_vector",
    data_type: DataType.BinaryVector,
    dim: 128,
  },
];
using Milvus.Client.V2;
using Milvus.Client.V2.Types;

var config = new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    Username = "root",
    Password = "Milvus"
};
using var client = new MilvusClientV2(config);
await client.ConnectAsync();

var schema = new CollectionSchema
{
    EnableDynamicFields = true,
    Fields =
    {
        new FieldSchema("pk", DataType.VarChar, isPrimaryKey: true, autoId: true) { MaxLength = 100 },
        new FieldSchema("binary_vector", DataType.BinaryVector) { Dimension = 128 }
    }
};
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "binary_vector",
    "dataType": "BinaryVector",
    "elementTypeParams": {
        "dim": 128
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ],
    \"enableDynamicField\": true
}"
この例では、バイナリベクトルを保存するための binary_vector という名前のベクトルフィールドが追加されます。このフィールドのデータ型は BINARY_VECTOR で、次元数は 128 です。
ベクトルフィールドのインデックスパラメータを設定する
検索を高速化するには、バイナリベクトルフィールドにインデックスを作成する必要があります。インデックスを作成すると、大規模なベクトルデータの取得効率を大幅に向上できます。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_name="binary_vector_index",
    index_type="AUTOINDEX",
    metric_type="HAMMING"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexParams = new ArrayList<>();

indexParams.add(IndexParam.builder()
        .fieldName("binary_vector")
        .indexName("binary_vector_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.HAMMING)
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

idx := index.NewAutoIndex(entity.HAMMING)
indexOption := milvusclient.NewCreateIndexOption("my_collection", "binary_vector", idx)
use milvus::v2::prelude::*;

let index_params = vec![IndexParam::new()
    .field_name("binary_vector")
    .index_name("binary_vector_index")
    .index_type(IndexType::AutoIndex)
    .metric_type(MetricType::Hamming)];
std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("binary_vector", "binary_vector_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::HAMMING)
};
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = [{
  index_name: "binary_vector_index",
  field_name: "binary_vector",
  metric_type: MetricType.HAMMING,
  index_type: IndexType.AUTOINDEX
}];
using Milvus.Client.V2.Types;

var indexParam = new IndexParam(
    fieldName: "binary_vector",
    indexName: "binary_vector_index",
    indexType: IndexType.AutoIndex,
    metricType: MetricType.Hamming);
export indexParams='[
        {
            "fieldName": "binary_vector",
            "metricType": "HAMMING",
            "indexName": "binary_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
上記の例では、AUTOINDEX インデックスタイプを使用して、binary_vector フィールドに binary_vector_index という名前のインデックスが作成されます。metric_type は HAMMING に設定されており、類似度の測定にハミング距離が使用されることを示します。
さらに、Zilliz Cloud はバイナリベクトル用の他の類似度メトリクスもサポートしています。詳細については、Metric Types を参照してください。
コレクションを作成する
バイナリベクトルとインデックスの設定が完了したら、バイナリベクトルを含むコレクションを作成します。以下の例では、create_collection メソッドを使用して my_collection という名前のコレクションを作成します。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(requestCreate);
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

loadTask, err := client.LoadCollection(ctx, milvusclient.NewLoadCollectionOption("my_collection"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
if err = loadTask.Await(ctx); err != nil {
    fmt.Println(err.Error())
    // handle error
}
use milvus::v2::prelude::*;

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("my_collection")
            .schema(schema)
            .index_params(index_params)
            .build()?,
    )
    .await?;
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                        .WithCollectionName("my_collection")
                                        .WithIndexes(std::move(indexes))
                                        .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
using Milvus.Client.V2.Requests.Collection;

await client.CreateCollectionAsync(new CreateCollectionReq
{
    CollectionName = "my_collection",
    Schema = schema,
    Indexes = [indexParam]
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
データを挿入する
コレクションを作成したら、insert メソッドを使用してバイナリベクトルを含むデータを追加します。バイナリベクトルはバイト配列の形式で指定する必要があり、各バイトは 8 個の boolean 値を表すことに注意してください。
たとえば、128 次元のバイナリベクトルには 16 バイトの配列が必要です(128 ビット ÷ 8 ビット/byte = 16 バイト)。以下はデータを挿入するためのコード例です。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
def convert_bool_list_to_bytes(bool_list):
    if len(bool_list) % 8 != 0:
        raise ValueError("The length of a boolean list must be a multiple of 8")

    byte_array = bytearray(len(bool_list) // 8)
    for i, bit in enumerate(bool_list):
        if bit == 1:
            index = i // 8
            shift = i % 8
            byte_array[index] |= (1 << shift)
    return bytes(byte_array)

bool_vectors = [
    [1, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 0] + [0] * 112,
    [0, 1, 0, 1, 0, 1, 0, 0, 1, 1, 0, 0, 1, 1, 0, 1] + [0] * 112,
]

data = [{"binary_vector": convert_bool_list_to_bytes(bool_vector)} for bool_vector in bool_vectors]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;
import java.nio.ByteBuffer;

// Binary vectors (128 bits = 16 bytes)
// vector1: [1,0,0,1,1,0,1,1, 0,1,0,1,0,1,0,0] + [0]*112
byte[] vector1 = new byte[16];
vector1[0] = (byte) 0xD9;
vector1[1] = 0x2A;

// vector2: [0,1,0,1,0,1,0,0, 1,1,0,0,1,1,0,1] + [0]*112
byte[] vector2 = new byte[16];
vector2[0] = 0x2A;
vector2[1] = (byte) 0xB3;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();

JsonObject row1 = new JsonObject();
row1.add("binary_vector", gson.toJsonTree(vector1));
rows.add(row1);

JsonObject row2 = new JsonObject();
row2.add("binary_vector", gson.toJsonTree(vector2));
rows.add(row2);

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithBinaryVectorColumn("binary_vector", 128, [][]byte{
        {0b11011001, 0b00101010, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0},
        {0b00101010, 0b10110011, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
use milvus::v2::prelude::*;

// Binary vectors (128 bits = 16 bytes)
let binary_vectors: Vec<Vec<u8>> = vec![
    vec![0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    vec![0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
];

client
    .insert(
        InsertRequest::builder()
            .collection_name("my_collection")
            .columns(vec![FieldData::binary_vector(
                "binary_vector",
                binary_vectors,
            )])
            .build()?,
    )
    .await?;
// Binary vectors (128 bits = 16 bytes)
std::vector<uint8_t> vector1 = {0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};
std::vector<uint8_t> vector2 = {0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};

milvus::EntityRows data = {
    {{"binary_vector", vector1}},
    {{"binary_vector", vector2}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const data = [
  { binary_vector: [1,0,0,1,1,0,1,1,0,1,0,1,0,1,0,0] },
  { binary_vector: [0,1,0,1,0,1,0,0,1,1,0,0,1,1,0,1] },
];

await client.insert({
  collection_name: "my_collection",
  data: data,
});
using Milvus.Client.V2.Requests.Dml;
using Milvus.Client.V2.Types;

// Binary vectors (128 bits = 16 bytes)
// vector1: [1,0,0,1,1,0,1,1, 0,1,0,1,0,1,0,0] + [0]*112
byte[] vector1 = { 0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0 };

// vector2: [0,1,0,1,0,1,0,0, 1,1,0,0,1,1,0,1] + [0]*112
byte[] vector2 = { 0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0 };

await client.InsertAsync(new InsertReq
{
    CollectionName = "my_collection",
    ColumnsData =
    [
        new BinaryVectorFieldData("binary_vector", new ReadOnlyMemory<byte>[]
        {
            vector1,
            vector2
        })
    ]
});
export data='[
    {"binary_vector": "2SoAAAAAAAAAAAAAAAAAAA=="},
    {"binary_vector": "KrMAAAAAAAAAAAAAAAAAAA=="}
]'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"data\": $data,
    \"collectionName\": \"my_collection\"
}"
類似検索を実行する
類似検索は Zilliz Cloud クラスターの中核機能の 1 つであり、ベクトル間の距離に基づいて、クエリベクトルに最も類似するデータをすばやく見つけることができます。バイナリベクトルを使用して類似検索を実行するには、クエリベクトルと検索パラメータを準備し、search メソッドを呼び出します。
検索操作中も、バイナリベクトルはバイト配列の形式で指定する必要があります。クエリベクトルの次元数が dim の定義時に指定した次元と一致していること、および 8 個の boolean 値ごとに 1 バイトに変換されていることを確認してください。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
search_params = {
    "params": {"nprobe": 10}
}

query_bool_list = [1, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 0] + [0] * 112
query_vector = convert_bool_list_to_bytes(query_bool_list)

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="binary_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172268', 'distance': 10.0, 'entity': {'pk': '453718927992172268'}}]"]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.nio.ByteBuffer;

// query vector = vector1
byte[] queryBytes = new byte[16];
queryBytes[0] = (byte) 0xD9;
queryBytes[1] = 0x2A;
ByteBuffer queryVector = ByteBuffer.wrap(queryBytes);

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new BinaryVec(queryVector)))
        .annsField("binary_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());
import (
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

queryVector := []byte{0b11011001, 0b00101010, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0}

annSearchParams := index.NewCustomAnnParam()
annSearchParams.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.BinaryVector(queryVector)},
).WithANNSField("binary_vector").
    WithOutputFields("pk").
    WithAnnParam(annSearchParams))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
use milvus::v2::prelude::*;

// query vector = vector1
let query_vector: Vec<u8> = vec![0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0];

let results = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection")
            .vector_field("binary_vector")
            .vectors(SearchVectors::Binary(vec![query_vector]))
            .limit(5)
            .output_fields(vec!["pk"])
            .metric_type(MetricType::Hamming)
            .build()?,
    )
    .await?;
println!("{:?}", results.results());
// query vector = vector1
std::vector<uint8_t> query_vector = {0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};

auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("binary_vector")
                   .WithLimit(5)
                   .AddOutputField("pk")
                   .AddBinaryVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
const query_vector = [1,0,0,1,1,0,1,1,0,1,0,1,0,1,0,0];

await client.search({
    collection_name: 'my_collection',
    data: query_vector,
    anns_field: 'binary_vector',
    limit: 5,
    output_fields: ['pk'],
    params: { nprobe: 10 }
});
using Milvus.Client.V2.Requests.Dql;
using Milvus.Client.V2.Responses.Dql;
using Milvus.Client.V2.Types;

// query vector = vector1
byte[] queryBytes = { 0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0 };

SearchResp res = await client.SearchAsync(new SearchReq
{
    CollectionName = "my_collection",
    BinaryVectors = [new ReadOnlyMemory<byte>(queryBytes)],
    VectorFieldName = "binary_vector",
    MetricType = MetricType.Hamming,
    Limit = 5,
    Parameters = new SearchParameters
    {
        Nprobe = 10,
        OutputFields = { "pk" }
    }
});
Console.WriteLine(res);
export searchParams='{
        "params":{"nprobe":10}
    }'

export data='[
    {"binary_vector": "2SoAAAAAAAAAAAAAAAAAAA=="}
]'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"data\": $data,
    \"annsField\": \"binary_vector\",
    \"limit\": 5,
    \"searchParams\":$searchParams,
    \"outputFields\": [\"pk\"]
}"
類似検索パラメータの詳細については、Basic ANN Search を参照してください。