スパースベクトル
スパースベクトルは、情報検索や自然言語処理において、表層的な用語の一致を捉えるための重要な手法です。密ベクトルは意味理解に優れていますが、スパースベクトルは、特に特殊な用語やテキスト識別子を検索する際に、より予測可能な一致結果をもたらすことがよくあります。
概要
スパースベクトルは、ほとんどの要素がゼロで、非ゼロの値を持つ次元がごくわずかしかない特殊な高次元ベクトルです。以下の図に示すように、密ベクトルは通常、各位置に値を持つ連続配列として表現されます(例: [0.3, 0.8, 0.2, 0.3, 0.1])。これに対して、スパースベクトルは非ゼロの要素とその次元のインデックスのみを格納し、多くの場合 { index: value} のようなキーと値のペアとして表現されます(例: [{2: 0.2}, ..., {9997: 0.5}, {9999: 0.7}])。
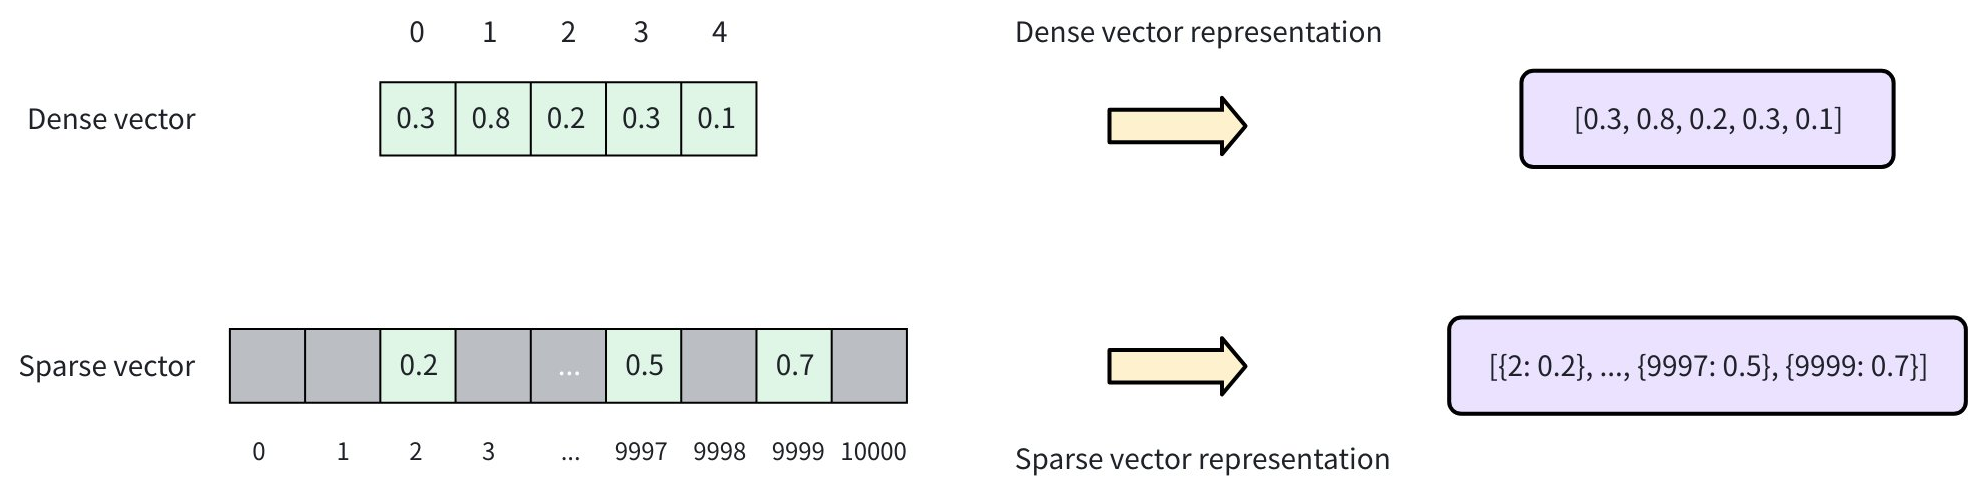
トークン化とスコアリングにより、ドキュメントは bag-of-words ベクトルとして表現でき、各次元は語彙内の特定の単語に対応します。ドキュメント内に存在する単語のみが非ゼロの値を持ち、スパースベクトル表現が作成されます。スパースベクトルは、次の2つのアプローチで生成できます。
-
従来の統計的手法(TF-IDF(Term Frequency-Inverse Document Frequency)や BM25(Best Matching 25)など)は、コーパス全体における頻度と重要度に基づいて単語に重みを割り当てます。これらの手法は、トークンを表す各次元のスコアとして単純な統計量を計算します。Zilliz Cloud は、BM25 方式の組み込み 全文検索 を提供しており、テキストを自動的にスパースベクトルに変換するため、手動での前処理が不要です。このアプローチは、精度と完全一致が重要となるキーワードベースの検索に最適です。詳細は フルテキスト検索 を参照してください。
-
ニューラルスパース埋め込みモデルは、大規模なデータセットで学習することによりスパース表現を生成する学習ベースの手法です。通常は Transformer アーキテクチャを持つディープラーニングモデルであり、意味的なコンテキストに基づいて用語を拡張し、重み付けできます。Zilliz Cloud は、SPLADE のようなモデルによって外部で生成されたスパース埋め込みもサポートしています。詳細は Embeddings を参照してください。
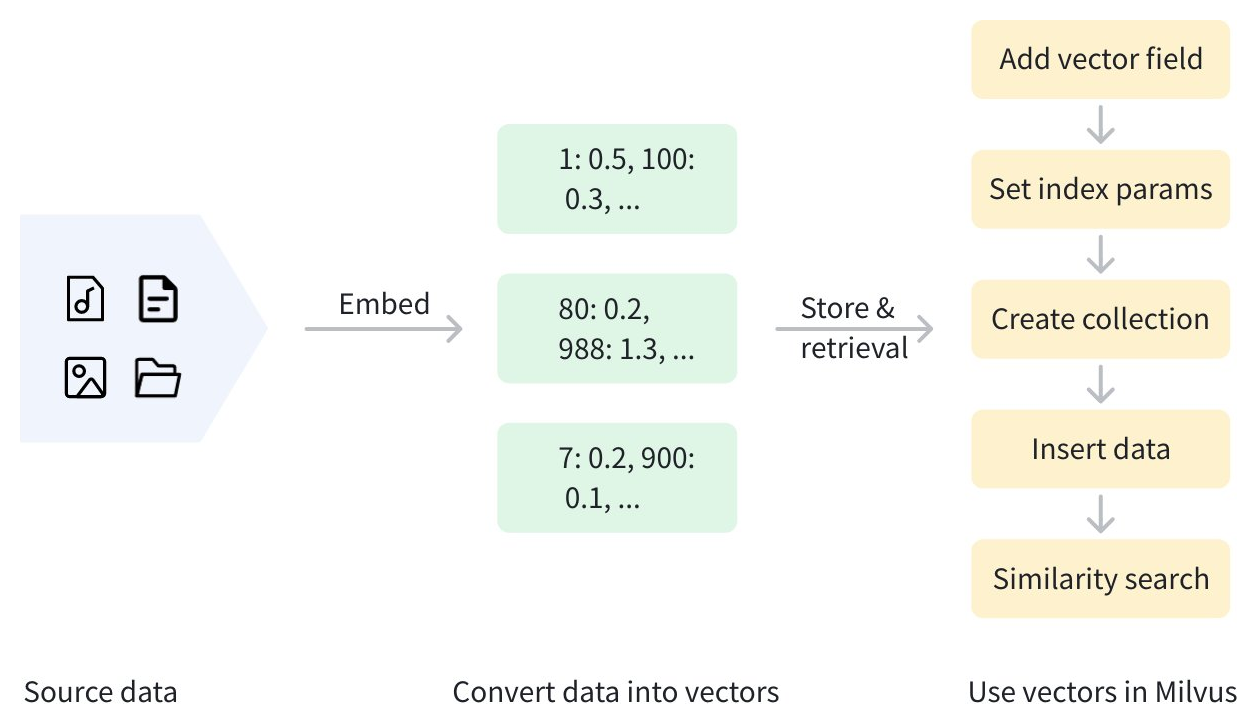
スパースベクトルと元のテキストは、効率的な検索のために Zilliz Cloud に保存できます。以下の図は、全体的なプロセスを示しています。
データ形式
以降のセクションでは、SPLADE のような学習済みスパース埋め込みモデルから得られるベクトルを保存する方法を説明します。密ベクトルベースのセマンティック検索を補完するものを探している場合は、シンプルさの観点から、SPLADE よりも BM25 を使用した フルテキスト検索 を推奨します。品質評価を実施して SPLADE を使用することに決めた場合は、Embeddings を参照して、SPLADE でスパースベクトルを生成する方法を確認してください。
Zilliz Cloud は、次の形式でのスパースベクトル入力をサポートしています。
-
辞書のリスト(
{dimension_index: value, ...}としてフォーマット)python# Represent each sparse vector using a dictionarysparse_vectors = [{27: 0.5, 100: 0.3, 5369: 0.6} , {100: 0.1, 3: 0.8}] -
スパース行列(
scipy.sparseクラスを使用)pythonfrom scipy.sparse import csr_matrix# First vector: indices [27, 100, 5369] with values [0.5, 0.3, 0.6]# Second vector: indices [3, 100] with values [0.8, 0.1]indices = [[27, 100, 5369], [3, 100]]values = [[0.5, 0.3, 0.6], [0.8, 0.1]]sparse_vectors = [csr_matrix((vals, ([0]*len(idx), idx)), shape=(1, 5369+1)) for idx, vals in zip(indices, values)] -
タプルのイテラブルのリスト(例:
[(dimension_index, value)])python# Represent each sparse vector using a list of iterables (e.g. tuples)sparse_vector = [[(27, 0.5), (100, 0.3), (5369, 0.6)],[(100, 0.1), (3, 0.8)]]
コレクションスキーマの定義
コレクションを作成する前に、コレクションスキーマを指定する必要があります。スキーマではフィールドを定義し、オプションでテキストフィールドを対応するスパースベクトル表現に変換する関数も定義します。
フィールドの追加
Zilliz Cloud クラスターでスパースベクトルを使用するには、以下のフィールドを含むスキーマを持つコレクションを作成する必要があります。
-
SPARSE_FLOAT_VECTORフィールドはスパースベクトルを格納するために予約されており、VARCHARフィールドから自動生成するか、入力データで直接指定します。 -
通常、スパースベクトルが表す元のテキストもコレクションに保存されます。元のテキストの格納には
VARCHARフィールドを使用できます。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="sparse_vector", datatype=DataType.SPARSE_FLOAT_VECTOR)
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=65535, enable_analyzer=True)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("sparse_vector")
        .dataType(DataType.SparseFloatVector)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(65535)
        .enableAnalyzer(true)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

const schema = [
  {
    name: "metadata",
    data_type: DataType.JSON,
  },
  {
    name: "pk",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "sparse_vector",
    data_type: DataType.SparseFloatVector,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 65535,
  },
];
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "YOUR_CLUSTER_ENDPOINT"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsAutoID(true).
    WithIsPrimaryKey(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("sparse_vector").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(65535),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "sparse_vector",
    "dataType": "SparseFloatVector"
}'

export textField='{
    "fieldName": "text",
    "dataType": "VarChar",
    "elementTypeParams": {
        "max_length": 65535,
        "enable_analyzer": true
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField,
        $textField
    ]
}"
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField(milvus::FieldSchema("pk", milvus::DataType::VARCHAR, "", true, true).WithMaxLength(100));
schema->AddField(milvus::FieldSchema("sparse_vector", milvus::DataType::SPARSE_FLOAT_VECTOR));
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(65535).EnableAnalyzer(true));
この例では、3つのフィールドを追加します。
-
pk: このフィールドは、VARCHARデータ型を使用して主キーを格納します。主キーは最大長 100 バイトで自動生成されます。 -
sparse_vector: このフィールドは、SPARSE_FLOAT_VECTORデータ型を使用してスパースベクトルを格納します。 -
text: このフィールドは、VARCHARデータ型を使用してテキスト文字列を格納します。最大長は 65535 バイトです。
データ挿入時に、指定したテキストフィールドからスパースベクトル埋め込みを Zilliz Cloud で生成できるようにするには、関数を使用する追加の手順が必要です。詳細は フルテキスト検索 を参照してください。
インデックスパラメーターの設定
スパースベクトルのインデックスを作成するプロセスは 密ベクトル の場合と似ていますが、指定するインデックスタイプ(index_type)、距離メトリクス(metric_type)、インデックスパラメーター(params)が異なります。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
index_params = client.prepare_index_params()
index_params.add_index(
    field_name="sparse_vector",
    index_name="sparse_auto_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("sparse_vector")
        .indexName("sparse_auto_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
const indexParams = await client.createIndex({
    field_name: 'sparse_vector',
    metric_type: MetricType.IP,
    index_name: 'sparse_auto_index',
    index_type: IndexType.AUTOINDEX,
});
idx := index.NewSparseInvertedIndex(entity.IP, 0.2)
indexOption := milvusclient.NewCreateIndexOption("my_collection", "sparse_vector", idx)
export indexParams='[
        {
            "fieldName": "sparse_vector",
            "metricType": "IP",
            "indexName": "sparse_auto_index",
            "indexType": "AUTOINDEX"
        }
    ]'
milvus::IndexDesc sparse_index("sparse_vector", "sparse_auto_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP);
この例では、SPARSE_INVERTED_INDEX インデックスタイプと IP をメトリクスとして使用します。詳細については、以下のリソースを参照してください。
コレクションの作成
スパースベクトルとインデックスの設定が完了したら、スパースベクトルを含むコレクションを作成できます。以下の例では、create_collection メソッドを使用して my_collection という名前のコレクションを作成します。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                        .WithCollectionName("my_collection")
                                        .AddIndex(std::move(sparse_index))
                                        .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
データの挿入
コレクション作成時に定義したすべてのフィールドに対してデータを指定する必要があります。ただし、自動生成されるフィールド(auto_id が有効な主キーなど)は除きます。組み込みの BM25 関数を使用してスパースベクトルを自動生成する場合は、データ挿入時にスパースベクトルフィールドも省略してください。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
data = [
    {
        "text": "information retrieval is a field of study.",
        "sparse_vector": {1: 0.5, 100: 0.3, 500: 0.8}
    },
    {
        "text": "information retrieval focuses on finding relevant information in large datasets.",
        "sparse_vector": {10: 0.1, 200: 0.7, 1000: 0.9}
    }
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

import java.util.ArrayList;
import java.util.List;
import java.util.SortedMap;
import java.util.TreeMap;

Gson gson = new Gson();
List<JsonObject> rows = new ArrayList<>();

{
    JsonObject row = new JsonObject();
    row.addProperty("text", "information retrieval is a field of study.");

    SortedMap<Long, Float> sparse = new TreeMap<>();
    sparse.put(1L, 0.5f);
    sparse.put(100L, 0.3f);
    sparse.put(500L, 0.8f);
    row.add("sparse_vector", gson.toJsonTree(sparse));
    rows.add(row);
}
{
    JsonObject row = new JsonObject();
    row.addProperty("text", "information retrieval focuses on finding relevant information in large datasets.");

    SortedMap<Long, Float> sparse = new TreeMap<>();
    sparse.put(10L, 0.1f);
    sparse.put(200L, 0.7f);
    sparse.put(1000L, 0.9f);
    row.add("sparse_vector", gson.toJsonTree(sparse));
    rows.add(row);
}

InsertResp insertResp = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
    {
        text: 'information retrieval is a field of study.',
        sparse_vector: {1: 0.5, 100: 0.3, 500: 0.8}
    {
        text: 'information retrieval focuses on finding relevant information in large datasets.',
        sparse_vector: {10: 0.1, 200: 0.7, 1000: 0.9}
    },
];

client.insert({
    collection_name: "my_collection",
    data: data
});
texts := []string{
    "information retrieval is a field of study.",
    "information retrieval focuses on finding relevant information in large datasets.",
}
textColumn := entity.NewColumnVarChar("text", texts)

// Prepare sparse vectors
sparseVectors := make([]entity.SparseEmbedding, 0, 2)
sparseVector1, _ := entity.NewSliceSparseEmbedding([]uint32{1, 100, 500}, []float32{0.5, 0.3, 0.8})
sparseVectors = append(sparseVectors, sparseVector1)
sparseVector2, _ := entity.NewSliceSparseEmbedding([]uint32{10, 200, 1000}, []float32{0.1, 0.7, 0.9})
sparseVectors = append(sparseVectors, sparseVector2)
sparseVectorColumn := entity.NewColumnSparseVectors("sparse_vector", sparseVectors)

_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithColumns(
        sparseVectorColumn,
        textColumn

    ))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {
            "text": "information retrieval is a field of study.",
            "sparse_vector": {"1": 0.5, "100": 0.3, "500": 0.8}
        },
        {
            "text": "information retrieval focuses on finding relevant information in large datasets.",
            "sparse_vector": {"10": 0.1, "200": 0.7, "1000": 0.9}
        }
    ],
    "collectionName": "my_collection"
}'
milvus::EntityRows data = {{"text", "information retrieval is a field of study.", {"sparse_vector", {{"1", 0.5}, {"100", 0.3}, {"500", 0.8}}}},
                           {{"text", "information retrieval focuses on finding relevant information in large datasets."}, {"sparse_vector", {{"10", 0.1}, {"200", 0.7}, {"1000", 0.9}}}}};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
類似度検索の実行
スパースベクトルを使用して類似度検索を実行するには、クエリデータと検索パラメーターの両方を準備します。
- Python
- Java
- Go
- NodeJS
- cURL
- C++
# Prepare search parameters
search_params = {
    "params": {"drop_ratio_search": 0.2},  # A tunable drop ratio parameter with a valid range between 0 and 1
}

# Query with sparse vector
query_data = [{1: 0.2, 50: 0.4, 1000: 0.7}]
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;

// Prepare search parameters
Map<String,Object> searchParams = new HashMap<>();
searchParams.put("drop_ratio_search", 0.2);

// Query with the sparse vector
SortedMap<Long, Float> sparse = new TreeMap<>();
sparse.put(1L, 0.2f);
sparse.put(50L, 0.4f);
sparse.put(1000L, 0.7f);
SparseFloatVec queryData = new SparseFloatVec(sparse);
// Prepare search parameters
annSearchParams := index.NewCustomAnnParam()
annSearchParams.WithExtraParam("drop_ratio_search", 0.2)

// Query with the sparse vector
queryData, _ := entity.NewSliceSparseEmbedding([]uint32{1, 50, 1000}, []float32{0.2, 0.4, 0.7})
// Prepare search parameters
const searchParams = {drop_ratio_search: 0.2}

// Query with the sparse vector
const queryData = [{1: 0.2, 50: 0.4, 1000: 0.7}]
# Prepare search parameters
export queryData='["What is information retrieval?"]'

# Query with the sparse vector
export queryData='[{1: 0.2, 50: 0.4, 1000: 0.7}]'
nlohmann::json query_vector = {{"1", 0.2}, {"50", 0.4}, {"1000", 0.7}};
次に、search メソッドを使用して類似度検索を実行します。
- Python
- Java
- NodeJS
- Go
- cURL
- C++
res = client.search(
    collection_name="my_collection",
    data=query_data,
    limit=3,
    output_fields=["pk"],
    search_params=search_params,
    consistency_level="Strong"
)

print(res)

# Output
# data: ["[{'id': '453718927992172266', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172266'}}, {'id': '453718927992172265', 'distance': 0.10000000149011612, 'entity': {'pk': '453718927992172265'}}]"]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

SparseFloatVec queryVector = new SparseFloatVec(sparse);

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryData))
        .annsField("sparse_vector")
        .searchParams(searchParams)
        .consistencyLevel(ConsistencyLevel.STRONG)
        .topK(3)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=457270974427187729}, score=0.63, id=457270974427187729), SearchResp.SearchResult(entity={pk=457270974427187728}, score=0.1, id=457270974427187728)]]
await client.search({
    collection_name: 'my_collection',
    data: queryData,
    limit: 3,
    output_fields: ['pk'],
    params: searchParams,
    consistency_level: "Strong"
});
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection",
    3, // limit
    []entity.Vector{queryData},
).WithANNSField("sparse_vector").
    WithOutputFields("pk").
    WithAnnParam(annSearchParams))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}

// Results:
//   IDs:  string_data:{data:"457270974427187705"  data:"457270974427187704"}
//   Scores:  [0.63 0.1]
//   Pks:  string_data:{data:"457270974427187705"  data:"457270974427187704"}
export params='{
    "consistencyLevel": "Strong"
}'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": $queryData,
    "annsField": "sparse_vector",
    "limit": 3,
    "searchParams": $searchParams,
    "outputFields": ["pk"],
    "params": $params
}'

## {"code":0,"cost":0,"data":[{"distance":0.63,"id":"453577185629572535","pk":"453577185629572535"},{"distance":0.1,"id":"453577185629572534","pk":"453577185629572534"}]}
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("sparse_vector")
                   .WithLimit(3)
                   .AddExtraParam("drop_ratio_search", "0.2")
                   .AddOutputField("pk")
                   .AddSparseVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
類似度検索のパラメーターの詳細については、基本的なベクトル検索 を参照してください。